

Extinderea rețelei Amazon Web Services constă în 69 de zone din întreaga lume, în 22 de regiuni: SUA, Europa, Asia, Africa și Australia. În fiecare zonă se află până la 8 centre de date (CDP). În fiecare CDP sunt mii sau sute de mii de servere. Rețeaua este construită astfel încât toate scenariile improbabile de întrerupere să fie luate în considerare. De exemplu, toate regiunile sunt izolate una de cealaltă, iar zonele de disponibilitate sunt dispuse la distanțe de câțiva kilometri. Chiar dacă un cablu este rupt, sistemul va comuta pe canale de rezervă, iar pierderile de informații vor fi de câteva pachete de date. Despre ce alte principii fundamentează rețeaua și cum este aceasta organizată, va povesti Vasili Pantyuhin.
Vasili Pantyuhin a început ca administrator Unix în companii .ru, a lucrat timp de 6 ani cu echipamente mari de la Sun Microsystem, iar timp de 11 ani a promovat centralizarea datelor în EMC. A evoluat natural către soluții de cloud privat, apoi a trecut la cele publice. Acum, în calitate de arhitect pentru Amazon Web Services, oferă sfaturi tehnice pentru a trăi și a se dezvolta în cloud-ul AWS.
În partea anterioară a trilogiei despre structura AWS, Vasili a aprofundat tema serverelor fizice și scalarea bazelor de date. Cardurile Nitro, hipervizorul personalizat bazat pe KVM, baza de date Amazon Aurora — toate acestea sunt discutate în materialul „”. Citiți pentru a vă familiariza cu contextul sau vizionați a prezentării.
În această parte se va vorbi despre scalarea rețelei — unul dintre cele mai complexe sisteme din AWS. Evoluția de la o rețea plată la Virtual Private Cloud și structura acesteia, serviciile interne Blackfoot și HyperPlane, problema vecinului zgomotos, iar la final — amploarea rețelei, backbone-ul și cablurile fizice. Toate acestea sunt discutate mai jos.
Declinarea responsabilității: tot ceea ce urmează este o opinie personală a lui Vasili și poate să nu coincidă cu poziția Amazon Web Services.
Scalarea rețelei
Cloud-ul AWS a fost lansat în 2006. Rețeaua sa era destul de primitivă — cu o structură plată. Domeniul adreselor private era comun pentru toți chiriașii cloud-ului. La lansarea unei noi mașini virtuale, primeai accidental o adresă IP disponibilă din acest domeniu.
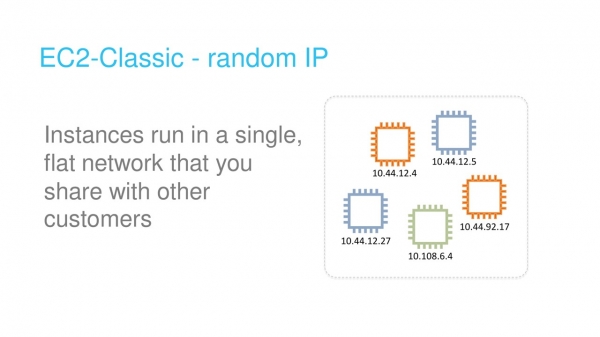
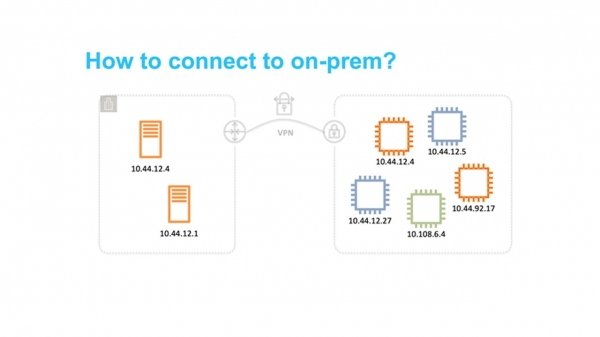
Această abordare era simplă în implementare, dar limita fundamental utilizarea cloud-ului. În special, era destul de dificil să dezvolți soluții hibride care combinau rețele private de la sol cu cele din AWS. Cea mai frecventă problemă era intersectarea domeniilor de adrese IP.
Cloud Privat Virtual
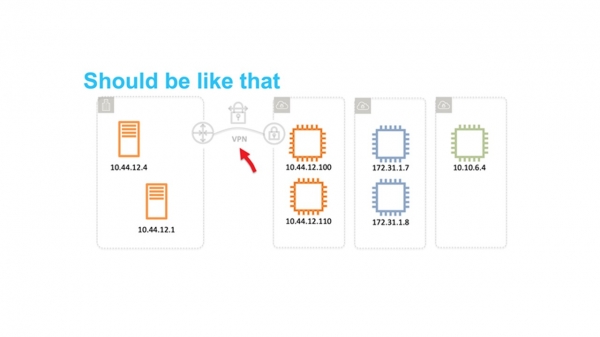
Cloud-ul a devenit foarte cerut. A sosit momentul să ne gândim la scalabilitate și la posibilitatea utilizării acestuia de către zeci de milioane de chiriași. Rețeaua plată a devenit principalul obstacol. De aceea, ne-am gândit cum să izolăm utilizatorii unii de alții la nivel de rețea, astfel încât ei să poată alege singuri intervalele IP.
Ce vă vine primul în minte când vă gândiți la izolarea rețelei? Desigur VLAN și VRF — Rutare Virtuală și Înaintare.
Din păcate, acest lucru nu a funcționat. VLAN ID este de doar 12 biți, ceea ce ne oferă doar 4096 de segmente izolate. Chiar și în cele mai mari switch-uri pot fi utilizate maximum 1-2 mii VRF. Utilizarea comună a VRF și VLAN ne oferă doar câteva milioane de subrețele. Acest lucru este cu siguranță insuficient pentru zeci de milioane de chiriași, fiecare dintre ei având nevoie să utilizeze mai multe subrețele.
De asemenea, pur și simplu nu ne putem permite să cumpărăm cantitatea necesară de echipamente mari, de exemplu, de la Cisco sau Juniper. Există două motive: este extrem de scump și nu dorim să depindem de politica lor de dezvoltare și patching.
Concluzia este una – să ne creăm propria soluție.
În 2009 am anunțat VPC — Cloud Privat Virtual. Numele a prins și acum mulți furnizori de cloud îl folosesc.
VPC este o rețea virtuală SDN (Rețea Definita prin Software). Am decis să nu inventăm protocoale speciale la nivelurile L2 și L3. Rețeaua funcționează pe Ethernet standard și IP. Pentru a transmite date prin rețea, traficul mașinilor virtuale este încapsulat într-un wrapper al propriului nostru protocol. În acesta se specifică ID-ul care aparține chiriașului VPC.
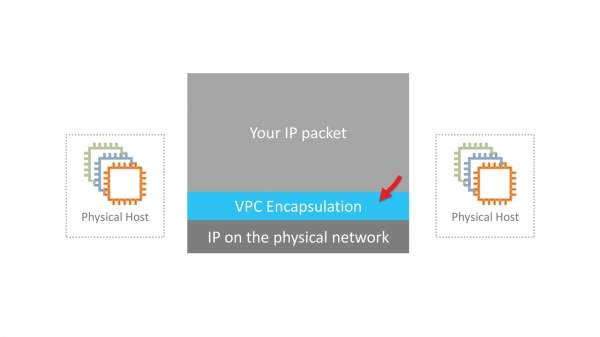
Pare simplu. Cu toate acestea, trebuie să rezolvăm câteva probleme tehnice serioase. De exemplu, unde și cum să stocăm datele despre asocierea adreselor MAC/IP virtuale, VPC ID și MAC/IP fizice corespunzătoare. La scală AWS, aceasta este o tabelă enormă, care trebuie să funcționeze cu întârzieri minime la accesare. Pentru aceasta răspunde serviciul de mapare, care este răspândit subțire pe întreaga rețea.
În mașinile de nouă generație, încapsularea se realizează prin plăcile Nitro la nivel hardware. În instanțele mai vechi, încapsularea și decapsularea sunt realizate software.
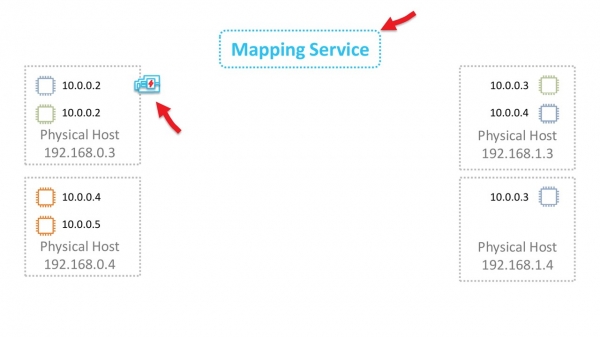
Să înțelegem cum funcționează acest lucru în linii mari. Să începem cu nivelul L2. Să presupunem că avem o mașină virtuală cu IP 10.0.0.2 pe un server fizic 192.168.0.3. Aceasta trimite date unei mașini virtuale 10.0.0.3, care se află pe 192.168.1.4. Se formează o solicitare ARP, care ajunge pe placa de rețea Nitro. Pentru simplitate, să considerăm că ambele mașini virtuale se află în același VPC "albastru".
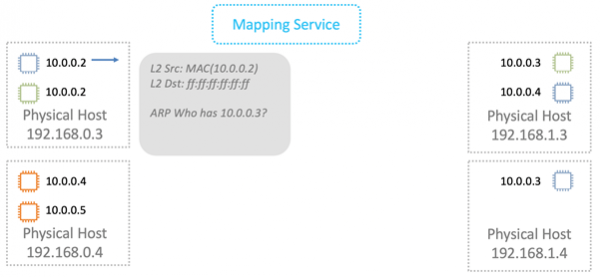
Placa înlocuiește adresa sursă cu a sa și retransmite cadrul ARP către serviciul de mapare.
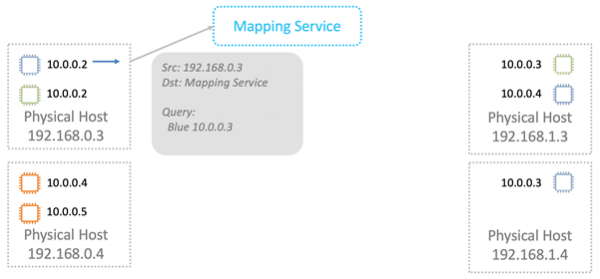
Serviciul de mapare returnează informațiile necesare pentru transmiterea prin rețeaua fizică L2.
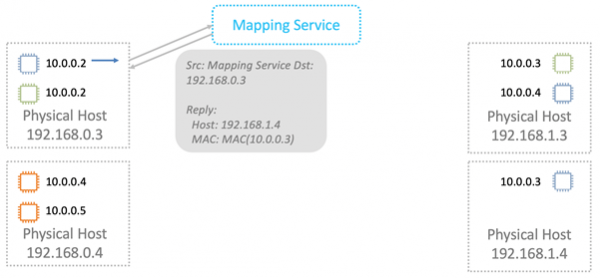
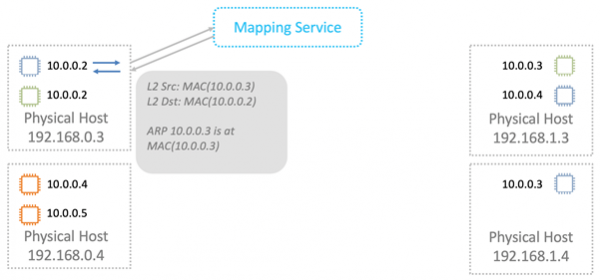
Placa Nitro în răspunsul ARP înlocuiește MAC-ul din rețeaua fizică cu adresa din VPC.
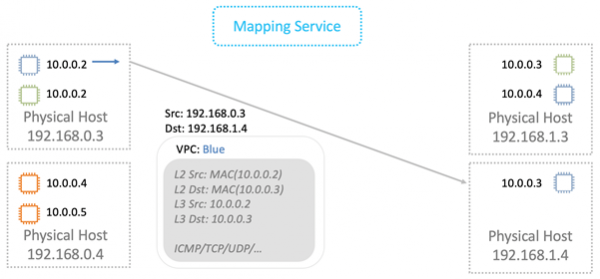
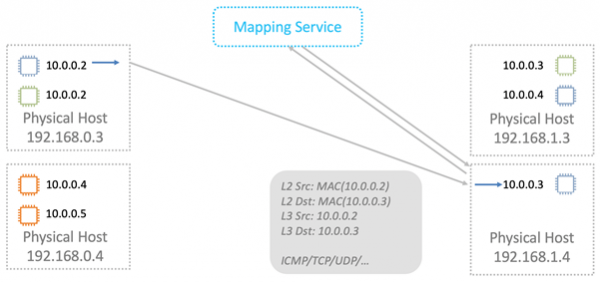
Atunci când transmitem date, împachetăm MAC-urile și IP-urile logice în un ambalaj VPC. Toate acestea sunt transmise prin rețeaua fizică folosind IP-urile corespunzătoare ale plăcilor Nitro de sursă și destinație.
Mașina fizică care primește pachetul efectuează o verificare. Aceasta este necesară pentru a preveni posibilitatea falsificării adreselor. Mașina trimite o solicitare specială către serviciul de mapare și întreabă: "De pe mașina fizică 192.168.0.3 am primit un pachet destinat lui 10.0.0.3 în VPC-ul "albastru". Este acesta legitim?"
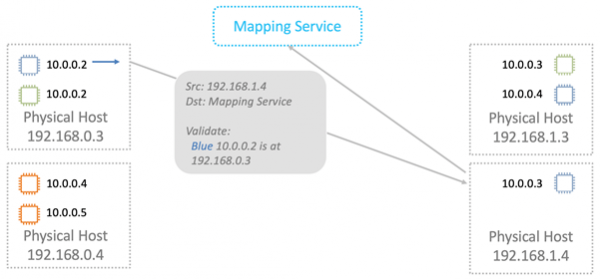
Serviciul de mapare verifică în tabela sa de alocare a resurselor și permite sau interzice trecerea pachetului. În toate noile instanțe, o validare suplimentară este integrată în plăcile Nitro. Aceasta nu poate fi ocolită nici măcar teoretic. De aceea, falsificarea pe resurse din alt VPC nu va funcționa.
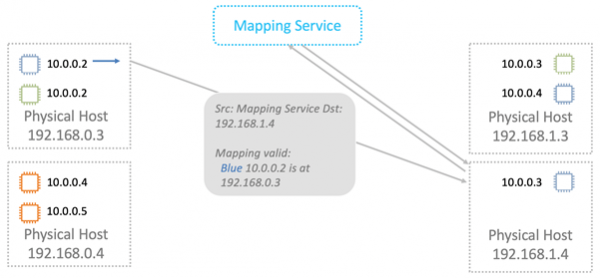
Apoi, datele sunt trimise mașinii virtuale pentru care sunt destinate.
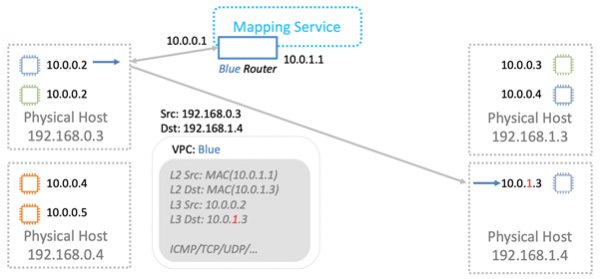
Serviciul de mapare funcționează și ca un router logic pentru transmiterea datelor între mașinile virtuale din subrețele diferite. Din punct de vedere conceptual, totul este simplu, nu voi analiza detaliat.
Rezultă că, la transmiterea fiecărui pachet, serverele fac apel la serviciul de mapare. Cum putem combate întârzierile inevitabile? Prin cache., desigur.
Toată frumusețea constă în faptul că nu este nevoie să se cacheze toată imensa tabelă. Pe serverul fizic trăiesc mașini virtuale dintr-un număr relativ mic de VPC-uri. Informația trebuie să fie cache-uită doar despre aceste VPC-uri. Transmiterea datelor în alte VPC-uri, în configurația "implicită", nu este niciodată legitimă. Dacă se folosește o funcționalitate precum VPC-peering, atunci în cache se încarcă suplimentar informațiile despre VPC-urile corespunzătoare.
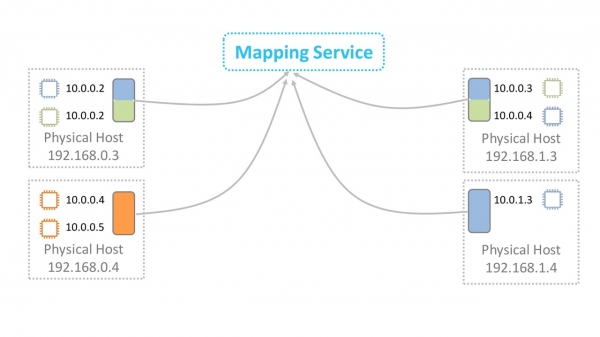
Am înțeles cum funcționează transmiterea datelor în VPC.
Blackfoot
Ce să facem în cazul în care traficul trebuie transmis în exterior, de exemplu în Internet sau prin VPN pe pământ? Aici ne ajută Blackfoot — un serviciu intern AWS. A fost dezvoltat de echipa noastră din Africa de Sud. De aceea serviciul este numit după un pinguin care trăiește în Africa de Sud.
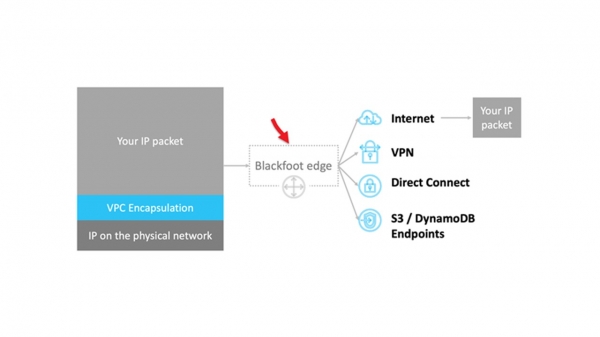
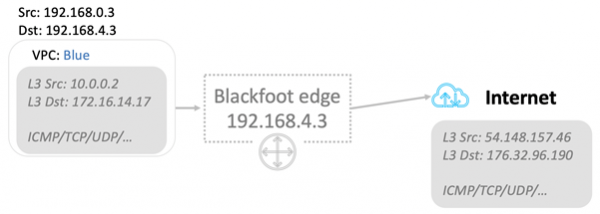
Blackfoot decapsulează traficul și face cu el ce trebuie. Datele sunt trimise în Internet așa cum sunt.
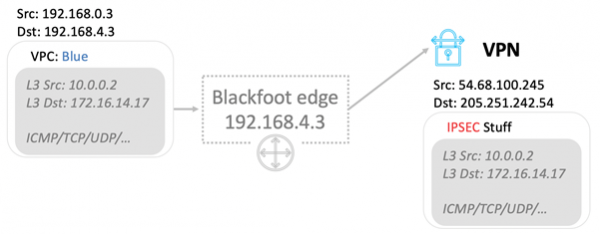
Datele sunt decapsulate și din nou învelite într-un ambalaj IPsec atunci când se folosește VPN.
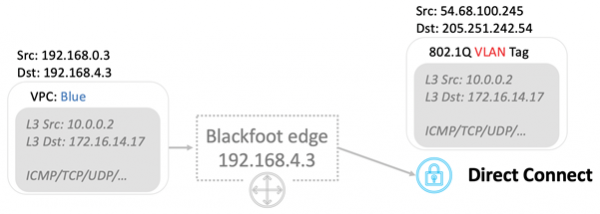
Când se utilizează Direct Connect, traficul este etichetat și trimis în VLAN-ul corespunzător.
HyperPlane
Acesta este un serviciu intern de control al fluxului. Multe servicii de rețea necesită controlul stării fluxului de date. De exemplu, atunci când se utilizează NAT, controlul fluxului trebuie să garanteze că fiecărei perechi „IP: port de destinație” îi corespunde un port de ieșire unic. În cazul unui echilibrator de încărcare NLB — Network Load Balancer, fluxul de date trebuie să fie întotdeauna direcționat către aceeași mașină virtuală țintă. Security Groups sunt un firewall cu păstrarea stării. Acesta monitorizează traficul de intrare și deschide implicit porturile pentru fluxul de ieșire al pachetelor.
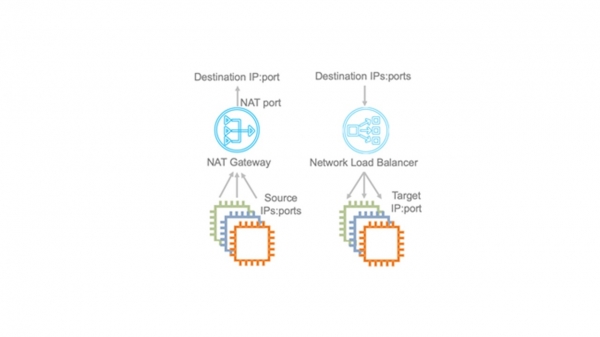
În cloud-ul AWS, cerințele pentru întârzierile de transfer sunt extrem de mari. De aceea HyperPlane este critic pentru funcționarea întregii rețele.
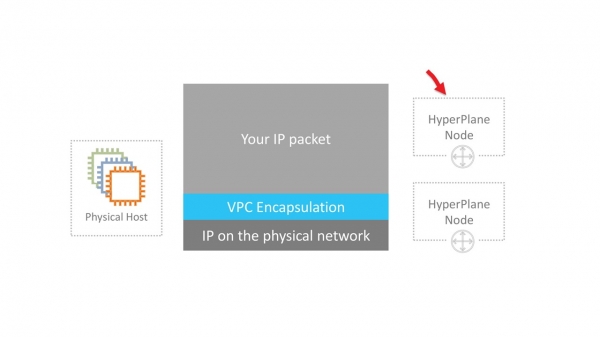
Hyperplane este construit pe mașini virtuale EC2. Aici nu există magie, doar trucuri. Trucul este acela că aceste mașini virtuale au mult RAM. Operațiile sunt tranzacționale și se efectuează exclusiv în memorie. Aceasta permite obținerea întârzierilor de doar câteva microsecunde. Lucrul cu discul ar distruge întreaga performanță.
Hyperplane este un sistem distribuit format dintr-un număr enorm de astfel de mașini EC2. Fiecare mașină virtuală are o lățime de bandă de 5 GB/s. La nivelul întregii rețele regionale, acest lucru oferă o capacitate nebunească de terabiți și permite preluarea milionelor de conexiuni pe secundă.
HyperPlane funcționează doar cu fluxuri. Incapsularea pachetelor VPC este complet transparentă pentru el. O vulnerabilitate potențială în acest serviciu intern nu va permite totuși să fie spartă izolarea VPC. Securitatea este responsabilitatea nivelurilor inferioare.
vecin zgomotos
Există și o altă problemă a vecinului zgomotos — vecin zgomotos. Să presupunem că avem 8 noduri. Aceste noduri gestionează fluxurile tuturor utilizatorilor din cloud. Totul pare bine, iar sarcina ar trebui să fie distribuită uniform între toate nodurile. Nodurile sunt foarte puternice și este greu să le supraîncărcăm.
Dar noi ne construim arhitectura având în vedere chiar și scenariile puțin probabile.
O probabilitate scăzută nu înseamnă imposibilitate.
Ne putem imagina o situație în care unul sau mai mulți utilizatori generează o încărcătură prea mare. Toate nodurile HyperPlane sunt implicate în gestionarea acestei încărcături, iar ceilalți utilizatori ar putea simți o oarecare scădere a performanței. Aceasta distruge conceptul de cloud, în care chiriașii nu au posibilitatea de a influența unul pe altul.
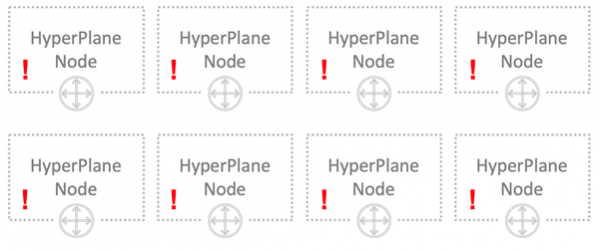
Cum rezolvăm problema „vecinului zgomotos”? Primul lucru care îmi vine în minte este shardingul. Cele 8 noduri sunt împărțite logic în 4 sharduri, câte 2 noduri în fiecare. Acum vecinul zgomotos va deranja doar un sfert dintre toți utilizatorii, dar impactul său va fi semnificativ.
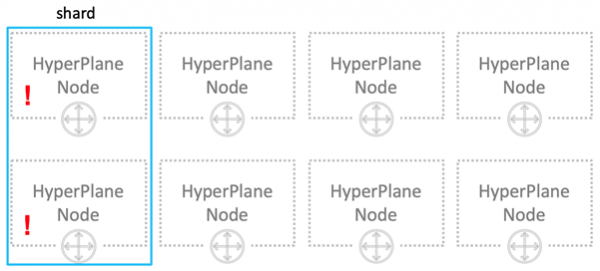
Hai să facem altfel. Fiecare utilizator va fi alocat câte 3 noduri.
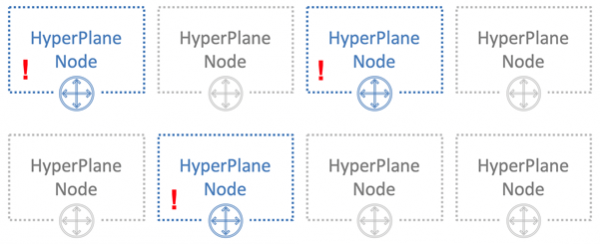
Trucul constă în a atribui nodurile utilizatorilor diferit, aleatoriu. În imaginea de mai jos, utilizatorul albastru se intersectează cu nodurile unuia dintre ceilalți doi utilizatori — verde și portocaliu.
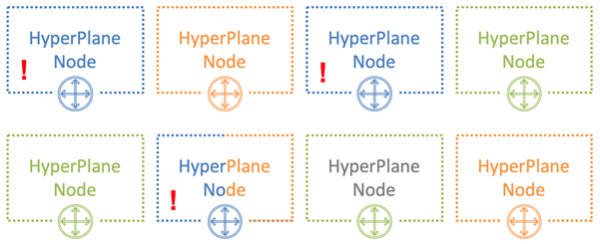
Cu 8 noduri și 3 utilizatori, probabilitatea ca vecinul zgomotos să se intersecteze cu unul dintre utilizatori este de 54%. Aceasta este probabilitatea cu care utilizatorul albastru va influența ceilalți chiriași. În același timp, aceasta se va întâmpla doar cu o parte a sarcinii sale. În exemplul nostru, acest impact va fi vizibil nu tuturor, ci doar unei treimi dintre utilizatori. Acesta este un rezultat bun.
Numărul de utilizatori care se vor intersecta
Probabilitatea în procente
0
18%
1
54%
2
26%
3
2%
Să aproximez situația la una reală — să luăm 100 de noduri și 5 utilizatori pe 5 noduri. În acest caz, niciunul dintre noduri nu se va intersecta cu o probabilitate de 77%.
Numărul de utilizatori care se vor intersecta
Probabilitatea în procente
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
Într-o situație reală, având o cantitate enormă de noduri și utilizatori HyperPlane, influența potențială a vecinului zgomotos asupra altor utilizatori este minimă. Acest metod se numește sharding de amestecare — shuffle sharding. El minimizează efectul negativ al defecțiunilor nodurilor.
Pe baza HyperPlane sunt construite numeroase servicii: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Magnitudinea rețelei
Acum să vorbim despre amploarea rețelei. În octombrie 2019, AWS își oferă serviciile în 22 regiuni, iar alte 9 sunt planificate.
- Fiecare regiune conține mai multe zone de disponibilitate - Availability Zone. În total, există 69 în întreaga lume.
- Fiecare AZ este formată din Centre de Date. Numărul acestora nu depășește 8.
- În Centrele de Date se află un număr uriaș de servere, iar în unele până la 300.000.
Acum să calculăm media, să înmulțim și să obținem o cifră impresionantă care ilustrează amploarea cloudului Amazon.
Între zonele de disponibilitate și Centrele de Date există multe conexiuni optice. Într-o dintre cele mai mari regiuni ale noastre, doar pentru a conecta AZ între ele și centrele de comunicare cu alte regiuni (Transit Centers) sunt instalate 388 de canale. În total, aceasta oferă un uriaș 5000 Tbps.
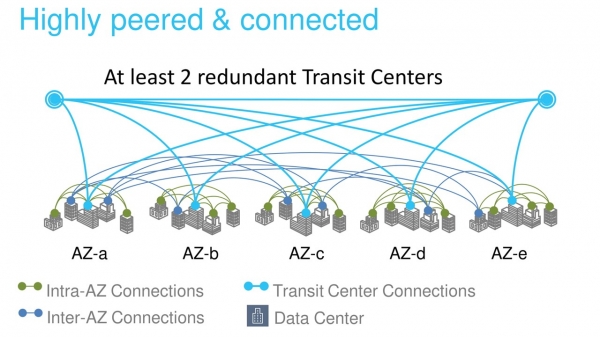
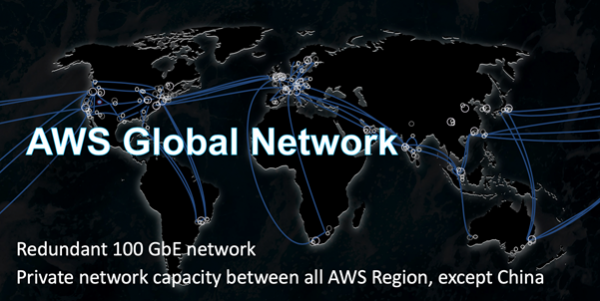
Backbone-ul AWS este construit special pentru cloud și optimizat pentru a lucra cu acesta. Îl construim pe canale de 100 Gbps. Le controlăm complet, cu excepția regiunilor din China. Traficul nu este împărțit cu încărcările altor companii.
Desigur, nu suntem singurul furnizor de cloud cu o rețea backbone privată. Tot mai multe companii mari urmează această cale. Acest lucru este susținut de cercetători independenți, de exemplu, de la .
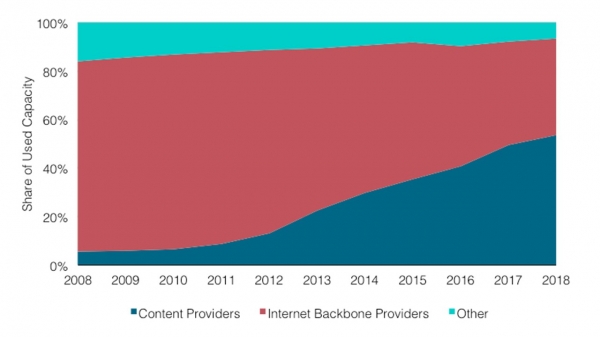
În grafic se poate observa că cota furnizorilor de conținut și a furnizorilor de cloud crește. Din cauza aceasta, cota de trafic Internet a furnizorilor backbone scade constant.
Voi explica de ce se întâmplă acest lucru. În trecut, majoritatea serviciilor web erau accesibile și consumate direct din Internet. Acum, tot mai multe servere sunt situate în cloud și sunt accesibile prin CDN — Content Distribution Network. Pentru a accesa resursa, utilizatorul trece prin Internet doar până la cel mai apropiat PoP CDN - Point of Presence. Cel mai adesea, acesta se află în apropiere. Apoi, părăsește Internetul public și, printr-o backbone privată, călătorește, de exemplu, peste Atlantic, ajungând direct la resursă.
Este interesant cum se va schimba Internetul în 10 ani dacă această tendință va continua?
Canale fizice
Deocamdată, oamenii de știință nu au găsit o modalitate de a crește viteza luminii în Univers, dar au progresat semnificativ în metodele de transfer al acesteia prin fibră optică. Acum folosim cabluri cu 6912 fibre. Acest lucru ajută la optimizarea semnificativă a costurilor de instalare.
În unele regiuni, suntem nevoiți să folosim cabluri speciale. De exemplu, în regiunea Sydney, folosim cabluri cu un strat special împotriva termitelor.
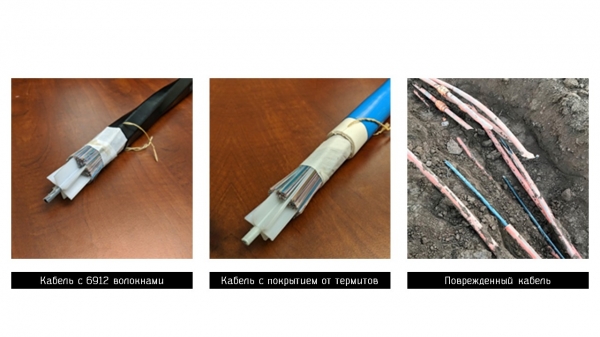
Nimeni nu este protejat de neplăceri, iar uneori canalele noastre suferă daune. În fotografia de mai sus, cablurile de fibră optică din una dintre regiunile americane au fost rupte de muncitori. Ca urmare a accidentului, au fost pierdute doar 13 pachete de date, ceea ce este uimitor. Încă o dată – doar 13! Sistemul s-a comutat practic instantaneu pe canalele de rezervă — scala funcționează.
Am trecut rapid prin câteva servicii și tehnologii ale cloud-ului Amazon. Sper că acum aveți o idee despre amploarea problemelor cu care se confruntă inginerii noștri. Personal, mă entuziasmează foarte mult acest domeniu.
Aceasta este partea finală a trilogiei lui Vasily Pantyukhin despre arhitectura AWS. În parte sunt descrise optimizarea serverelor și scalarea bazei de date, iar în cea de-a doua — funcțiile serverless și Firecracker.
Pe În noiembrie, Vasily Pantyukhin va împărtăși noi detalii despre arhitectura Amazon. El despre cauzele defecțiunilor și proiectarea sistemelor distribuite în Amazon. Pe 24 octombrie, mai puteți un bilet la un preț bun, iar plata poate fi efectuată mai târziu. Vă așteptăm la HighLoad++, veniți — să discutăm!
Sursa: habr.com
