

Salut, Habr!
Astăzi vreau să vă povestesc despre experiența noastră în automatizarea copiilor de siguranță a stocării de date mari Nextcloud în diferite configurații. Lucrez ca CTO la "Molnia AK", unde ne ocupăm cu managementul configurărilor sistemelor IT, folosind Nextcloud pentru stocarea datelor. Acesta include, de asemenea, o structură distribuită, cu rezervare.
Problemele care decurg din particularitățile instalărilor sunt că sunt multe date. Versiunile pe care le oferă Nextcloud, rezervarea, motivele subiective și altele creează multe duplicate.
Povestea
În administrarea Nextcloud, apare cu acuitate problema organizării unei copii de siguranță eficiente, care trebuie obligatoriu criptată, deoarece datele sunt valoroase.
Oferim opțiuni de stocare a copiilor de siguranță fie la noi, fie la client pe mașini separate de Nextcloud, ceea ce necesită un abord flexibil automatizat în administrare.
Avem mulți clienți, toți cu configurații diferite, și fiecare pe propriile platforme și cu particularitățile lor. Metodologia standard, când toată platforma îți aparține, și copiile de siguranță sunt făcute din cron, se potrivește slab.
Pentru început, să ne uităm la datele introductive. Avem nevoie de:
- Scalabilitate în ceea ce privește o nodă sau mai multe. Pentru instalări mari, folosim minio ca stocare.
- Aflăm despre problemele cu executarea copiilor de siguranță.
- Trebuie să stocăm copia de siguranță la clienți și/sau la noi.
- Să putem rezolva rapid și ușor problemele.
- Clienții și instalațiile diferă semnificativ unul de altul - uniformitatea nu poate fi obținută.
- Viteza de recuperare trebuie să fie minimă în două scenarii: recuperare completă (catastrofă), un director - șters din greșeală.
- Funcția de deduplicare este obligatorie.
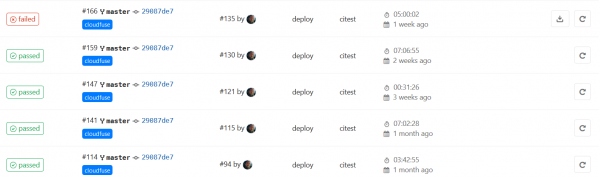
Pentru a rezolva problema gestionării copiilor de siguranță, am integrat GitLab. Detalii în continuare.
Desigur, nu suntem primii care rezolvăm o astfel de problemă, dar ni se pare că experiența noastră practică și îndelungată poate fi interesantă și suntem gata să o împărtășim.
Deoarece în compania noastră este adoptată politica open-source, soluția căutată a fost cu cod sursă deschis. La rândul nostru, împărtășim dezvoltările noastre și le publicăm. De exemplu, pe GitHub există , pe care îl instalăm clienților, care întărește siguranța datelor în cazul ștergerii accidentale sau intenționate.
Mijloace de copiere de siguranță
Am început căutarea metodelor de soluționare alegând un instrument pentru crearea copiilor de siguranță.
Tar și gzip funcționează prost — datele sunt duplicate. Incrementul conține adesea foarte puține modificări, iar cea mai mare parte a datelor dintr-un singur fișier se repetă.
Există o altă problemă — redundanța stocării distribuite a datelor. Folosim minio și datele sale sunt în principiu redundante. Fie trebuia să facem backup prin minio însuși – să-l solicităm și să folosim toate intermedierele între sistemul de fișiere, iar nu mai puțin important, există riscul de a uita o parte din bucket-uri și metainformații. Fie să utilizăm deduplicarea.
Există instrumente de backup cu deduplicare în open source (au fost pe Habră ) și finaliștii noștri au fost și . Despre comparația noastră între cele două aplicații mai jos, dar între timp să vorbim despre cum am organizat întreaga schemă.
Gestionarea creării copiilor de siguranță
Borg și Restic sunt bune, dar niciunul dintre aceste produse nu are un mecanism centralizat de gestionare. Pentru scopul gestionării și controlului, am ales un instrument pe care deja îl avem implementat, fără de care nu ne putem imagina munca noastră, inclusiv în ceea ce privește automatizarea – este binecunoscutul CI/CD – GitLab.
Ideea este următoarea: pe fiecare nod care stochează date Nextcloud se instalează gitlab-runner. Runnerul rulează conform unui program un script care monitorizează procesul de backup, iar acesta lansează Borg sau Restic.
Ce am obținut? Feedback din execuție, control convenabil asupra modificărilor, detalii în caz de eroare.
Iată am publicat exemple de script pentru diferite sarcini, iar noi l-am integrat în backupul nu doar pentru Nextcloud, ci și pentru multe alte servicii. Acolo se găsește și planificatorul, dacă nu vrei să-l configurezi manual (iar nouă nu ne place) și .gitlab-ci.yml
În API-ul GitLab-ului nu există încă posibilitatea de a modifica timeout-ul CI/CD, iar el este destul de mic. Trebuie să-l creștem, de exemplu, la 1d.
GitLab din fericire poate rula nu doar la commit, ci și conform unui program, exact ceea ce ne trebuie.
Acum despre scriptul-wrapper.
Am stabilit următoarele condiții pentru acest script:
- Trebuie să fie rulat atât de runner, cât și manual din consolă cu aceeași funcționalitate.
- Trebuie să existe neapărat gestionari de erori:
- cod de returnare.
- căutarea unui șir în log. De exemplu, pentru noi, o eroare poate fi un mesaj pe care programul nu-l consideră fatal.
- Timeout-ul de procesare. Timpul de execuție trebuie să fie rezonabil.
- Avem nevoie de un jurnal detaliat. Dar doar în cazul unei erori.
- De asemenea, se efectuează o serie de teste înainte de începere.
- Câteva mici facilități pentru confort, pe care le-am găsit utile în procesul de suport:
- Pornirea și încetarea sunt înregistrate în log-ul local al mașinii. Acest lucru ajută la corelarea erorilor sistemului și a funcționării de backup.
- O parte din log-ul de erori, atunci când există, este afișată în stdout, întreaga înregistrare este scrisă într-un fișier separat. Convenabil să arunci o privire în CI și să evaluezi eroarea dacă este trivială.
- Moduri pentru depanare.
Log-ul complet este salvat ca un artefact în GitLab; dacă nu există erori, log-ul este șters. Scriptul este scris în bash.
Orice sugestii și observații privind open-source-ul vor fi binevenite — welcome.
Cum funcționează
Pe nodul de backup se lansează un runner cu executor bash. În planificator, într-un repository special, se lansează un job CI/CD. Runner-ul rulează un script wrapper universal pentru astfel de sarcini, în care se efectuează verificări de validitate pentru repository-ul de backup, punctele de montare și tot ce dorim, apoi se execută backup-ul și curățarea celor vechi. Backup-ul final preparat este trimis pe S3.
Folosim o schemă de acest fel — este un furnizor extern AWS sau un echivalent rusesc (este mai rapid și datele nu părăsesc RF). Sau, pentru client, instalăm un cluster minio separat pe site-ul său pentru aceste scopuri. De obicei, facem asta din motive de securitate, când clientul nu dorește ca datele să părăsească conturul său.
Nu am utilizat funcția de trimitere a backup-ului prin ssh. Asta nu adaugă securitate, iar capacitățile de rețea ale furnizorului S3 sunt mult mai mari decât ale unei singure mașini ssh.
Pentru a ne proteja de un hacker pe mașina locală — deoarece acesta poate șterge datele de pe S3, trebuie să activăm cu siguranță versiunea.
Backup-erul criptază întotdeauna backup-ul.
Borg are un mod fără criptare. none, dar nu recomandăm cu vehemență activarea acestuia. În acest mod nu va exista nu doar criptare, ci nu se va calcula nici suma de control pentru ceea ce este scris, ceea ce înseamnă că integritatea poate fi verificată doar indirect, pe baza indexurilor.
Printr-un programator separat se efectuează verificarea backup-urilor pentru integritatea indexurilor și a conținutului. Verificarea se desfășoară lent și îndelungat, așa că o lansăm separat o dată pe lună. Poate dura câteva zile.
Readme în română
Funcții principale
preparepregătiretestcheckverificare a disponibilitățiimaincommandcomanda principalăforcepostscriptfuncția care se execută la final sau în caz de eroare. O folosim pentru a demonta partiția.
Funcții de serviciu
cleanupnotăm erorile sau ștergem fișierul de log.checkloganalizăm log-ul pentru a găsi un șir cu o eroare.rethandler de ieșire.checktimeoutverificarea timeout-ului.
Mediu
VERBOSE=1afișăm erorile pe ecran imediat (stdout).SAVELOGSONSUCCES=1salvăm log-ul în cazul succesului.INIT_REPO_IF_NOT_EXIST=1Creăm un depozit, dacă nu exista. În mod implicit, este dezactivat.TIMEOUTtimpul maxim pentru operația principală. Poți seta 'm', 'h' sau 'd' la final.
Modul de păstrare a copiilor vechi. În mod implicit:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variabile în script
ERROR_STRING— șir pentru verificarea în log pentru eroare.EXTRACT_ERROR_STRING— expresie pentru a afișa șirul în cazul unei erori.KILL_TIMEOUT_SIGNAL— semnal pentru a opri în cazul timeout-ului.TAIL— câte șiruri cu erori pe ecran.COLORMSG— culoarea mesajului (default galben).
Scriptul numit WordPress este denumit așa, iar caracteristica sa este că face backup la baza de date MySQL. Asta înseamnă că poate fi utilizat pentru instalările unice Nexcloud, unde poți de asemenea să faci backup la baza de date. Avantajul nu este doar că totul este într-un singur loc, dar și conținutul bazei de date este apropiat de conținutul fișierelor, deoarece diferența de timp este minimă.
Restic vs Borg
Comparațiile între Borg și Restic există, de asemenea, , și nu ne-a fost scopul să creăm doar încă unul, ci al nostru. A fost important pentru noi cum va arăta pe datele noastre, cu specificitatea noastră. Le aducem.
Criteriile noastre de selecție, pe lângă cele menționate anterior (deduplicare, recuperare rapidă etc.):
- Reziliența la activitatea nefinalizată. Verificarea pentru kill -9.
- Dimensiunea pe disc.
- Cerințele de resurse (CPU, memorie).
- Dimensiunea blob-urilor păstrate.
- Lucrul cu S3.
- Verificarea integrității.
Pentru testare, am luat un client cu date reale și o dimensiune totală de 1,6TB.
Condiții.
Borg nu poate lucra direct cu S3, iar noi am montat ca disc fuse, prin . Restic trimitea în S3 el însuși.
Goofys funcționează foarte repede și bine, și are , care accelerează și mai mult procesul. Este în stadiu beta, și, să recunosc, ne-a căzut cu pierderi de date la teste (alte). Dar avantajul este că procedura de backup necesită puțin citire, mai mult scriere, astfel încât cache-ul îl folosim doar în timpul verificării integrității.
Pentru a reduce influența rețelei, am folosit un provider local - Yandex Cloud.
Rezultatele testării comparativului.
- Kill -9 cu o repornire ulterioară, ambele au avut succes.
- Dimensiunea pe disc. Borg poate comprima, așadar rezultatele sunt așteptate.
Backuper
Dimensiune
Borg
562Gb
Restic
628Gb
- Referitor la CPU
Borg consumă puțin în sine, cu compresia implicită, dar trebuie evaluat împreună cu procesul goofys. În total, sunt comparabile și utilizează aproximativ 1,2 nuclee pe aceeași mașină virtuală de test. - Memorie. Restic aproximativ 0,5Gb, Borg aproximativ 200Mb. Dar acestea sunt neglijabile în comparație cu memoria cache a sistemului. Așadar, este de preferat să se aloce mai multă memorie.
- Diferența în dimensiunea bloburilor s-a dovedit a fi spectaculoasă.
Backuper
Dimensiune
Borg
aproximativ 500Mb
Restic
aproximativ 5Mb
- Lucrul cu S3 de la Restic este excelent. Funcționarea Borg prin goofys nu ridică întrebări, dar s-a observat că este recomandabil să se facă umount la finalizarea backup-ului pentru a reseta complet cache-ul. O caracteristică a funcționării S3 este că bucățile neterminate nu vor fi niciodată trimise în bucket, ceea ce înseamnă că datele incomplete conduc la daune mari.
- Verificarea integrității funcționează bine în ambele cazuri, dar viteza diferă semnificativ.
Restic – 3,5 ore.
Borg, cu un cache de fișiere de 100Gb SSD – 5 ore. Un rezultat aproximativ similar în viteză dacă datele sunt stocate pe un disc local.
Borg citește direct de la S3 fără cache 33 de ore. Îngrozitor de lung.
În concluzie, Borg poate comprima și are bloburi mai mari — ceea ce face stocarea și operațiunile GET/PUT în S3 mai ieftine. Dar pentru aceasta se plătește printr-o verificare mai complexă și mai lentă. În ceea ce privește viteza de recuperare, nu am observat diferențe. Backup-urile ulterioare (după primul) restic durează puțin mai mult, dar nu semnificativ.
Dimensiunea comunității a jucat de asemenea un rol important în alegere.
Și am ales borg.
Câteva cuvinte despre compresie
Borg are în arsenal un nou algoritm de compresie excelent — zstd. În ceea ce privește calitatea compresiei, nu este mai rău decât gzip, dar semnificativ mai rapid. Și comparabil în viteză cu lz4 implicit.
De exemplu, un dump al bazei de date MySQL se comprima de două ori mai bine decât lz4 la aceeași viteză. Totuși, experiența pe date reale arată că există o diferență foarte mică în gradul de compresie al nodului Nextcloud.
În Borg există un mod de compresie bonus — dacă fișierul are o entropie mare, compresia nu este aplicată deloc, ceea ce crește viteza de operare. Se activează printr-o opțiune la crearea sa
-C auto,zstd
pentru algoritmul zstd
Așadar, cu această opțiune, comparativ cu compresia implicită, am obținut
560Gb și 562Gb, respectiv. Datele din exemplul de mai sus, reamintesc, fără compresie, rezultatul este 628Gb. Rezultatul cu o diferență de 2Gb ne-a surprins puțin, dar am decis să alegem totuși auto,zstd.
Metodologia de verificare a backup-ului
Prin scheduler se lansează o mașină virtuală direct la furnizor sau la client, ceea ce reduce semnificativ încărcătura rețelei. Cel puțin, este mai ieftin decât să ridici la tine și să generezi trafic.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https:\/\/storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
După aceeași schemă, verificăm fișierele cu antivirusul (postfactum). Deoarece utilizatorii încarcă diverse în Nextcloud și nu toți au antivirus. Verificarea în momentul încărcării durează prea mult timp și împiedică afacerea.
Scalabilitatea este obținută prin lansarea runner-ilor pe noduri diferite cu etichete diferite.
În monitorizarea noastră, statusurile backup-urilor sunt colectate prin API-ul GitLab într-o singură fereastră, iar problemele pot fi observate cu ușurință, fiind de asemenea ușor de localizat.
Concluzie
În concluzie, știm cu siguranță că facem backup-uri, că backup-urile noastre sunt valide, problemele care apar cu acestea durează puțin timp și se rezolvă la nivel de administrator de serviciu. Backup-urile ocupă într-adevăr foarte puțin spațiu în comparație cu tar.gz sau Bacula.
Sursa: habr.com
