

În acest articol, vom discuta despre cum și de ce am dezvoltat – un mecanism care transmite informația între aplicațiile client și serverele 1C:Enterprise – de la formularea cerințelor până la elaborarea arhitecturii și detaliilor de implementare.
Sistemul de Interacțiune (denumit în continuare – SI) este un sistem distribuit de schimb de mesaje cu livrare garantată, tolerant la erori. SI este proiectat ca un serviciu cu încărcare ridicată și scalabilitate mare, fiind disponibil atât ca serviciu online (oferit de firma 1C), cât și ca produs de licență, care poate fi implementat pe serverele proprii.
SI utilizează un stocare distribuită și un sistem de căutare . De asemenea, vom vorbi despre Java și despre cum scalăm orizontal PostgreSQL.
Formularea problemei
Pentru a înțelege de ce am creat Sistemul de Interacțiune, voi vorbi puțin despre cum sunt dezvoltate aplicațiile de afaceri în 1C.
La început – câteva lucruri despre noi pentru cei care nu știu încă ce facem :) Creăm platforma tehnologică „1C:Enterprise”. Platforma include un instrument de dezvoltare a aplicațiilor de afaceri, precum și un runtime care permite aplicațiilor de afaceri să funcționeze în medii cross-platform.
Paradigma de dezvoltare client-server
Aplicațiile de afaceri realizate pe „1C:Enterprise” funcționează într-o arhitectură de trei niveluri, sistem „SGBD – server de aplicații – client”. Codul aplicației scris în , poate fi executat pe serverul de aplicații sau pe client. Toată interacțiunea cu obiectele aplicației (referințe, documente etc.), precum și citirea și scrierea bazei de date se realizează exclusiv pe server. Funcționalitatea formularelor și a interfeței de comandă este de asemenea realizată pe server. Pe client se realizează obținerea, deschiderea și afișarea formularelor, „comunicarea” cu utilizatorul (avertizări, întrebări…), calcule simple în formulare care necesită reacție rapidă (de exemplu, înmulțirea prețului cu cantitatea), lucrul cu fișiere locale, lucrul cu echipamentele.
În codul aplicației, în anteturile procedurilor și funcțiilor, trebuie să se indice clar unde va fi executat codul – folosind directivele &PeClient / &PeServer (&AtClient / &AtServer în varianta în limba engleză). Dezvoltatorii de la 1C mă vor corecta acum, spunând că directivele, de fapt, , dar pentru noi aceasta nu este acum semnificativ.
Din codul clientului se poate apela codul serverului, dar din codul serverului nu se poate apela codul clientului. Aceasta este o restricție fundamentală pe care am impus-o din mai multe motive. În special deoarece codul serverului trebuie scris astfel încât să poată fi executat în mod uniform, indiferent de unde este apelat – de la client sau de la server. Și în cazul apelării codului serverului dintr-un alt cod server, clientul, ca atare, lipsește. De asemenea, deoarece în timpul executării codului serverului, clientul care l-a apelat ar putea să se închidă, să părăsească aplicația, iar serverul nu va mai avea pe cine să apeleze.

Codul care procesează apăsarea butonului: apelul procedurii serverului din client va funcționa, apelul procedurii clientului din server – nu.
Aceasta înseamnă că, dacă dorim să transmitem un mesaj aplicației client de pe server, de exemplu, că s-a terminat generarea unui raport „pe termen lung” și că raportul poate fi vizualizat – nu avem o astfel de metodă. Suntem nevoiți să recurgem la tot felul de artifice, de exemplu, să interogăm periodic serverul din codul clientului. Dar această abordare încarcă sistemul cu apeluri inutile și, în general, arată destul de neceremonios.
Și mai este necesitatea, de exemplu, de a notifica aplicația client despre un apel telefonic - în scopul de a informa aplicația client că, pe numărul apelant, aceasta să găsească informațiile în baza de date a partenerilor și să afișeze utilizatorului informațiile despre partenerul apelant. Sau, de exemplu, la primirea unei comenzi la depozit, să notifice aplicația client a clientului. În general, sunt multe cazuri în care un astfel de mecanism ar fi util.
Să spunem că este necesar
Să creăm un mecanism de schimb de mesaje. Rapid, fiabil, cu livrare garantată, cu posibilități de căutare flexibilă a mesajelor. Pe baza acestui mecanism, să implementăm un messenger (mesaje, apeluri video) care să funcționeze în interiorul aplicațiilor 1C.
Să proiectăm un sistem scalabil orizontal. Sarcina în creștere trebuie să fie suportată prin creșterea numărului de noduri.
Implementarea
Am decis să nu încorporăm partea de server a SV direct în platforma 1C:Enterprise, ci să o dezvoltăm ca produs separat, API-ul căruia poate fi apelat din codul soluțiilor aplicațiilor 1C. Acest lucru a fost realizat din mai multe motive, principalul fiind dorința de a permite schimbul de mesaje între diferitele aplicații 1C (de exemplu, între Managementul Comercial și Contabilitate). Diferitele aplicații 1C pot funcționa pe versiuni diferite ale platformei 1C:Enterprise, pot fi situate pe servere diferite etc. În aceste condiții, implementarea SV ca produs separat, situat „în afara” instalațiilor 1C este soluția optimă.
Prin urmare, am decis să facem SV ca produs separat. Recomandăm companiilor mici să utilizeze serverul SV pe care l-am instalat în cloud-ul nostru (wss://1cdialog.com) pentru a evita cheltuielile asociate cu instalarea și configurarea locală a serverului. În schimb, clienții mari ar putea considera oportună instalarea propriului server SV pe resursele lor. Am folosit un abordare similară în produsul nostru SaaS din cloud. – este lansat ca produs de tip tiraj pentru instalare la clienți și de asemenea este disponibil în cloud-ul nostru. .
Aplicație
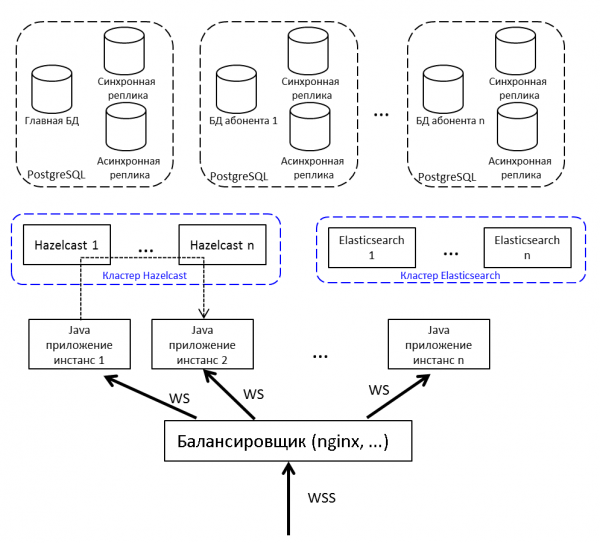
Pentru distribuirea încărcăturii și asigurarea rezilienței, vom desfășura nu un singur aplicație Java, ci mai multe, plasând un echilibror de încărcare în fața lor. Dacă este necesar să transmitem un mesaj de la un nod la altul – folosim publish/subscribe în Hazelcast.
Comunicarea clientului cu serverul se face prin websocket. Acesta este foarte potrivit pentru sistemele în timp real.
Cache distribuit
Am ales între Redis, Hazelcast și Ehcache. Ani sunt 2015. Redis abia au lansat un nou cluster (prea nou, descurajant), există Sentinel cu multe limitări. Ehcache nu poate fi configurat în cluster (acest funcționalitate a apărut mai târziu). Am decis să încercăm Hazelcast 3.4.
Hazelcast se configurează în cluster „din cutie”. În modul unei singure noduri nu este foarte util și poate fi folosit doar ca memorie cache – nu poate salva datele pe disc, pierdem nodul unic – am pierdut datele. Noi desfășurăm mai multe instanțe de Hazelcast, între care facem backup datelor critice. Memoria cache nu este backup-uită – nu ne pasă.
Pentru noi, Hazelcast este:
- Un depozit al sesiunilor utilizatorilor. A merge de fiecare dată pentru sesiune în baza de date este lent, așa că toate sesiunile le stocăm în Hazelcast.
- Cache. Cauti profilul utilizatorului – verifică în cache. Ai scris un mesaj nou – pune-l în cache.
- Topicuri pentru comunicarea instanțelor aplicației. Nodul generează un eveniment și îl plasează în topicul Hazelcast. Alte noduri ale aplicației, abonate la acest topic, primesc și procesează evenimentul.
- Blocări de cluster. De exemplu, creăm o discuție pe o cheie unică (discuție-singinon în cadrul bazei 1C):
conversationKeyChecker.check("BENZINĂRIE");

      doInClusterLock("BENZINĂRIE", () -> {

          conversationKeyChecker.check("BENZINĂRIE");

          createChannel("BENZINĂRIE");
      });
Am verificat că nu există canalul. Am obținut blocajul, am verificat din nou, am creat. Dacă după obținerea blocajului nu verifici, există șansa ca un alt fir să fi verificat în acel moment și acum să încerce să creeze aceeași discuție – iar aceasta deja există. Nu se poate face blocaj prin synchronized sau Lock obișnuit în Java. Prin baza de date – încet, iar baza este prețioasă, prin Hazelcast – exact ceea ce avem nevoie.
Alegem SGBD-ul
Avem o experiență mare și de succes cu PostgreSQL și colaborăm cu dezvoltatorii acestei baze de date.
Cu clusterul, PostgreSQL nu este simplu – există , , , dar, în general, nu este noSQL, care se scala din cutie. Nu am considerat noSQL ca depozit principal, a fost suficient să luăm Hazelcast, cu care nu am lucrat înainte.
Dacă trebuie să scalăm o bază de date relațională – înseamnă că . După cum știți, în timpul sharding-ului, împărțim baza de date în părți separate astfel încât fiecare dintre ele să poată fi mutată pe un server separat.
Prima variantă a sharding-ului nostru presupunea posibilitatea de a distribui fiecare dintre tabelele aplicației noastre pe servere diferite în proporții diferite. Multe mesaje pe serverul A – foarte bine, să mutăm o parte din această tabelă pe serverul B. Această soluție striga de prea mult timp de optimizare prematură, așa că am decis să ne limităm la abordarea multi-tenant.
Despre multi-tenant poți citi, de exemplu, pe site-ul .
În SV există conceptele de aplicație și abonat. Aplicația este o instalare specifică a unei aplicații de afaceri, cum ar fi ERP sau contabilitate, cu utilizatorii și datele sale de afaceri. Abonatul este organizația sau persoana fizică în numele căreia se face înregistrarea aplicației pe serverul SV. Un abonat poate avea înregistrate mai multe aplicații, iar aceste aplicații pot schimba mesaje între ele. Abonatul devine astfel locatar (tenant) în sistemul nostru. Mesajele mai multor abonați pot fi stocate într-o singură bază de date fizică; dacă observăm că un anumit abonat generează mult trafic, îl mutăm într-o bază de date fizică separată (sau chiar pe un server de baze de date separat).
Avem o bază de date principală unde este stocat un tabel de rutare cu informații despre locația tuturor bazelor de date ale abonaților.
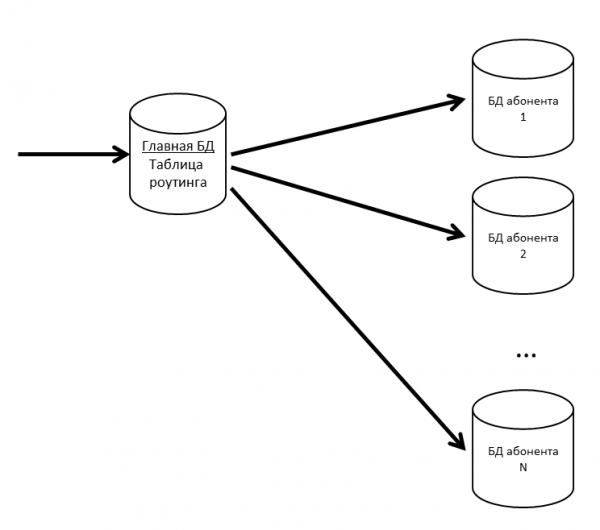
Pentru a preveni ca baza de date principală să devină un punct de blocaj, păstrăm tabelul de rutare (și alte date frecvent solicitate) în cache.
Dacă baza de date a abonatului începe să fie lentă, vom realiza partiționări interne. În alte proiecte, pentru partiționarea tabelelor mari, folosim .
. Deoarece pierderea mesajelor utilizatorilor este inacceptabilă, menținem bazele noastre de date cu replici. Combinarea replicilorSincrone și Asincrone ne permite să ne protejăm în caz de pierdere a bazei de date principale. Pierderea mesajului va avea loc doar în cazul unei defecțiuni simultane a bazei de date principale și a replicii sale sincrone.
Dacă replica sincronă se pierde, replica asincronă devine sincronă.
Dacă baza de date principală se pierde, replica sincrona devine baza de date principală, iar replica asincronă devine replica sincrona.
Elasticsearch pentru căutare
Deoarece, printre altele, SV este și un messenger, avem nevoie de o căutare rapidă, convenabilă și flexibilă, care să țină cont de morfologie și de potriviri inexacte. Am decis să nu reinventăm roata și să folosim sistemul de căutare gratuit Elasticsearch, creat pe baza bibliotecii . De asemenea, desfășurăm Elasticsearch într-un cluster (master – data – data) pentru a evita problemele în cazul în care nodurile aplicației se defectează.
Pe github am găsit pentru Elasticsearch și îl folosim. În indexul Elasticsearch păstrăm rădăcinile cuvintelor (definite de plugin) și N-gramuri. Pe măsură ce utilizatorul introduce text pentru căutare, căutăm textul tastat în N-gramuri. Când este salvat în index, cuvântul „texte” se va împărți în următoarele N-gramuri:
[te, tek, teks, text, texte, ec, eks, ekst, ексты, ks, kst, кст, ст, сты, ты],
De asemenea, va fi salvată rădăcina cuvântului „text”. Această abordare permite căutarea atât de la început, cât și de la mijloc, și de la sfârșitul cuvântului.
Imagine de ansamblu
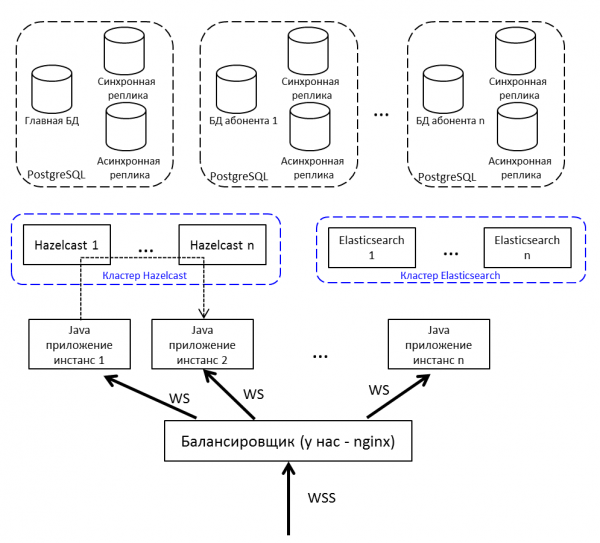
Repetiția imaginii din începutul articolului, dar cu explicații:
- Un balancer, expus pe internet; noi folosim nginx, poate fi oricare.
- Instanțele aplicației Java comunică între ele prin Hazelcast.
- Pentru a lucra cu websocket-ul folosim .
- Aplicația Java este scrisă în Java 8, constând din module . În planuri – migrarea pe Java 10 și trecerea la module.
Dezvoltare și testare
În procesul de dezvoltare și testare a S.V. ne-am confruntat cu o serie de caracteristici interesante ale produselor utilizate de noi.
Testare de stres și scurgeri de memorie
Lansarea fiecărei versiuni S.V. este un test de stres. Acesta se finalizează cu succes atunci când:
- Testul a funcționat câteva zile și nu au fost defecțiuni în serviciu
- Timpul de răspuns pentru operațiunile cheie nu a depășit pragul confortabil
- Degradarea performanței comparativ cu versiunea anterioară este de maximum 10%
Umplem baza de testare cu date – pentru aceasta obținem de pe serverul de producție informații despre cel mai activ abonat, înmulțim cifrele acestuia cu 5 (numărul de mesaje, discuții, utilizatori) și astfel testăm.
Testarea de stres a sistemului de interacțiune o realizăm în trei configurații:
- Test de stres
- Numai conexiuni
- Înregistrarea abonaților
În timpul testului de stres, lansăm câteva sute de fire, care neîncetat suprasolicită sistemul: scriu mesaje, creează discuții, primesc lista de mesaje. Imităm acțiunile utilizatorilor obișnuiți (a primi lista de mesaje necitite, a scrie cuiva) și soluții programatice (a transmite un pachet de altă configurație, a procesa o notificare).
De exemplu, iată cum arată o parte din testul de stres:
- Un utilizator se loghează în sistem
- Cere discuțiile sale necitite
- Cu 50% probabilitate citește mesajele
- Cu 50% probabilitate scrie mesaje
- Apoi utilizatorul:
- Are o probabilitate de 20% de a crea o nouă discuție
- Alege aleatoriu oricare dintre discuțiile sale
- Intră în interior
- Solicită mesaje, profiluri de utilizatori
- Creează cinci mesaje, adresate utilizatorilor aleatori din această discuție
- Iese din discuție
- Repetă de 20 de ori
- Se deconectează, se întoarce la începutul scenariului
- Un chatbot se conectează la sistem (emulează schimbul de mesaje din codurile aplicațiilor)
- Cu o probabilitate de 50% creează un nou canal pentru schimbul de date (o discuție specială)
- Cu o probabilitate de 50% scrie un mesaj în oricare dintre canalele existente
Scenariul «Numai conexiuni» nu a apărut fără motiv. Există situații: utilizatorii au conectat sistemul, dar nu s-au implicat încă. Fiecare utilizator pornește computerul dimineața la 09:00, se conectează la server și tace. Acești utilizatori sunt periculoși, sunt mulți – din pachete au doar PING/PONG, dar mențin conexiunea cu serverul (nu o pot întrerupe - ce-ar fi dacă ar fi un mesaj nou). Testul reproduce situația când, în termen de o jumătate de oră, încearcă să se autentifice un număr mare de astfel de utilizatori. Este similar cu un test de stres, dar focalizarea este tocmai pe această primă conectare - pentru a nu exista refuzuri (o persoană nu folosește sistemul, dar acesta deja pică - greu de imaginat ceva mai rău).
Scenariul de înregistrare a abonaților își are începutul de la prima conectare. Am realizat un test de stres și am fost siguri că în conversație sistemul nu întâmpină probleme. Dar utilizatorii au început să apară și înregistrarea a început să pice din cauza timeout-ului. La înregistrare am folosit , care este legat de entropia sistemului. Serverul nu reușea să acumuleze suficientă entropie și, la cererea unui nou SecureRandom, se bloca zeci de secunde. Există multe soluții pentru această problemă, de exemplu: trecerea la un "/dev/urandom" mai puțin sigur, instalarea unei plăci speciale care generează entropie, generarea de numere aleatoare mai devreme și stocarea în pool. Am închis temporar problema cu un pool, dar de atunci rulăm un test separat pentru înregistrarea noilor abonați.
Ca generator de sarcină, folosim . Nu știe să lucreze cu websocket, este necesar un plugin. Primele rezultate în căutare pentru „jmeter websocket” sunt , în care recomandă .
De la el am decis să începem.
Aproape imediat după începerea testelor serioase, am descoperit că JMeter a început să aibă scurgeri de memorie.
Pluginul este o poveste destul de mare, având 176 de stele și 132 de fork-uri pe github. Autorul nu a mai adus modificări din 2015 (l-am utilizat în 2015, atunci nu a stârnit suspiciuni), existând câteva probleme pe github referitoare la scurgerile de memorie și 7 pull request-uri fără răspuns.
Dacă decideți să efectuați testare de încărcare folosind acest plugin, vă rugăm să acordați atenție următoarelor discuții:
- Într-un mediu multi-threading, a fost folosit un LinkedList obișnuit, ceea ce a dus la în timpul execuției. Poate fi rezolvat fie prin trecerea la ConcurrentLinkedDeque, fie prin blocuri synchronized. Pentru noi, am ales prima opțiune ().
- Scurgere de memorie, informațiile despre conexiune nu sunt șterse la deconectare ().
- În modul streaming (când websocket-ul nu se închide la sfârșitul exemplului, ci este folosit în continuare în plan) pattern-urile de răspuns nu funcționează ().
Acesta este din cele de pe github. Ce am făcut:
- Am luat (@elyrank) – în care au fost rezolvate problemele 1 și 3
- Am rezolvat problema 2
- Am actualizat jetty de la 9.2.14 la 9.3.12
- Am înfășurat SimpleDateFormat în ThreadLocal; SimpleDateFormat nu este thread-safe, ceea ce ducea la NPE în timpul execuției
- Am eliminat încă o scurgere de memorie (conexiunea nu era închisă corect la deconectare)
Și totuși, el scurge!
Memoria a început să se epuizeze nu într-o zi, ci în două. Nu mai avea timp deloc, așa că am decis să rulăm mai puține thread-uri, dar pe patru agenți. Aceasta ar fi trebuit să fie suficientă, cel puțin pentru o săptămână.
Au trecut două zile…
Acum memoria a început să se epuizeze la Hazelcast. În loguri se vedea că, după câteva zile de testare, Hazelcast începe să se plângă de lipsa memoriei, iar după un timp clusterul se destramă, iar nodurile continuă să moară una câte una. Am conectat JVisualVM la hazelcast și am văzut „fuzia în urcare” – acesta apela regulat GC, dar nu putea elibera memoria.
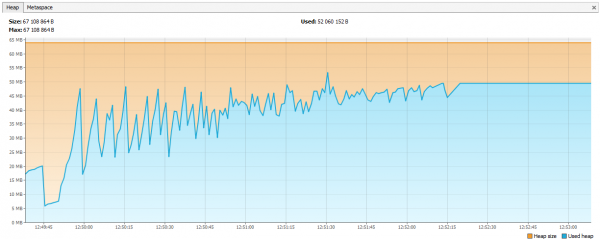
S-a dovedit că în hazelcast 3.4, la ștergerea unui map / multiMap (map.destroy()), memoria nu este eliberată complet:
Problema este acum rezolvată în 3.5, dar pe atunci a fost o problemă. Am creat noi multiMap-uri cu nume dinamice și le-am șters conform logicii noastre. Codul arăta cam așa:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Apel:
service.join(auth1, "NOI_ÎN_SUSCRIPȚIE_UUID1");
service.join(auth2, "NOI_ÎN_SUSCRIPȚIE_UUID1");
multiMap a fost creat pentru fiecare subscriere și a fost șters atunci când nu a mai fost necesar. Am decis să folosim un Map ca key, unde cheia va fi numele subscrierii, iar valorile vor fi identificatorii sesiunilor (pe baza cărora putem obține ulterior identificatorii utilizatorilor, dacă este necesar).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
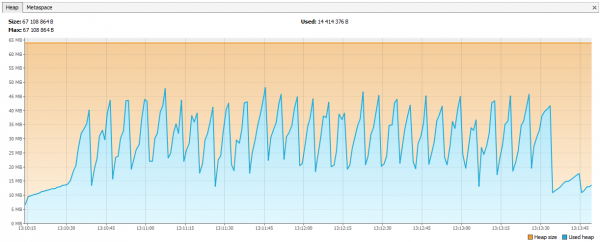
Graficele s-au corectat.
Ce altceva am învățat despre testarea de încărcare
- JSR223 trebuie scris în groovy și trebuie inclus compilation cache – este mult mai rapid. .
- Graficele Jmeter-Plugins sunt mai ușor de înțeles decât cele standard. .
Despre experiența noastră cu Hazelcast
Hazelcast a fost pentru noi un produs nou, am început să lucrăm cu el de la versiunea 3.4.1, acum pe serverul nostru de producție este instalată versiunea 3.9.2 (la momentul scrierii acestui articol, ultima versiune Hazelcast era 3.10).
Generarea ID-urilor
Am început cu identificatori întregi. Să presupunem că avem nevoie de un Long pentru o nouă entitate. Sequence în BD nu se potrivește, tabelele participă la sharding – va rezulta că există un mesaj ID=1 în BD1 și un mesaj ID=1 în BD2, în Elasticsearch nu poți pune un astfel de ID, nici în Hazelcast, dar cel mai grav este că, dacă vrei să aduni datele din două BDs într-una (de exemplu, hotărând că o singură bază este suficientă pentru acești abonați). Poți crea în Hazelcast mai multe AtomicLong și menține un contor acolo, atunci performanța obținerii unui nou ID – incrementAndGet plus timpul pentru cererea în Hazelcast. Dar în Hazelcast există ceva mai optim – FlakeIdGenerator. Fiecărui client îi este dat un interval de ID-uri, de exemplu, primului – de la 1 la 10.000, celui de-al doilea – de la 10.001 la 20.000 și așa mai departe. Acum clientul poate genera noi identificatori singur, până când se termină intervalul acordat. Funcționează rapid, dar la repornirea aplicației (și a clientului Hazelcast) începe o nouă secvență – de aici apar salturile și etc. În plus, dezvoltaților nu le este foarte clar de ce ID-urile sunt întregi, dar sunt așa încurcate. Am cântărit totul și am trecut la UUID-uri.
Apropo, pentru cei care doresc să fie ca Twitter, există o bibliotecă numită Snowcast – aceasta este o implementare Snowflake peste Hazelcast. O puteți vedea aici:
Dar până la ea nu am ajuns încă.
TransactionalMap.replace
Încă o surpriză: TransactionalMap.replace nu funcționează. Iată un test:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Expected : newValue
Actual : oldValue
A trebuit să scriu propriul meu replace, folosind getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Schimbarea valorii într-o hartă tranzacțională");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Schimbarea valorii într-o hartă non-tranzacțională");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testați nu doar structuri de date obișnuite, ci și versiunile lor tranzacționale. Se întâmplă ca IMap să funcționeze, dar TransactionalMap să nu.
Adăugați un nou JAR fără downtime
Inițial, am decis să scriem în Hazelcast obiecte din clasele noastre. De exemplu, avem clasa Application, vrem să o salvăm și să o citim. Salvăm:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Citire:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Totul funcționează. Apoi am decis să construim un index în Hazelcast pentru a căuta după acesta:
map.addIndex("subscriberId", false);Și la salvarea unei noi entități, am început să primim ClassNotFoundException. Hazelcast încerca să completeze indexul, dar nu știa nimic despre clasa noastră și voia să-i fie furnizat un JAR cu această clasă. Așa am făcut, totul a funcționat, dar a apărut o nouă problemă: cum să actualizăm JAR-ul fără a opri complet clusterul? Hazelcast nu preia noul JAR în timpul actualizării pe parcurs. În acel moment, am decis că ne putem descurca fără căutarea pe index. Deoarece, dacă folosim Hazelcast ca o depozitare de tip cheie-valoare, totul va funcționa, nu? Nu tocmai. Aici comportamentul IMap și TransactionalMap diferă din nou. Acolo unde IMap-ului nu-i pasă, TransactionalMap dă o eroare.
IMap. Înregistrăm 5000 de obiecte, le citim. Totul este așa cum ne așteptam.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
Dar în tranzacție nu funcționează, primim ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
În versiunea 3.8 a apărut mecanismul User Class Deployment. Puteți desemna un nod principal și actualiza fișierul JAR pe acesta.
Acum ne-am schimbat complet abordarea: serialize ourselves în JSON și salvăm în Hazelcast. Hazelcast-ului nu trebuie să cunoască structura claselor noastre, iar noi putem face actualizări fără downtime. Versiuniționarea obiectelor de domeniu este gestionată de aplicație. Diferite versiuni ale aplicației pot fi rulate simultan, iar situația se poate ivi când noua aplicație scrie obiecte cu câmpuri noi, iar cea veche nu știe încă despre aceste câmpuri. În același timp, noua aplicație citește obiecte scrise de aplicația veche, care nu conțin câmpuri noi. Astfel de situații sunt gestionate în interiorul aplicației, dar pentru simplificare nu schimbăm și nu ștergem câmpuri, ci extindem clasele prin adăugarea de câmpuri noi.
Cum asigurăm o performanță înaltă
Patru accesări în Hazelcast – bine, două în BD – rău
A lua după date în cache este întotdeauna mai bine decât în Baza de Date, dar nu vrem să păstrăm înregistrări nefolosite. Decizia despre ce să se cacheze o lăsăm pentru ultima etapă a dezvoltării. Când noua funcționalitate este codificată, activăm în PostgreSQL logarea tuturor interogărilor (log_min_duration_statement la 0) și rulăm teste de stres timp de 20 de minute. Din jurnalele colectate, utilitare precum pgFouine și pgBadger pot construi rapoarte analitice. În rapoarte, căutăm în primul rând interogări lente și frecvente. Pentru interogările lente, construim un plan de execuție (EXPLAIN) și evaluăm dacă o astfel de interogare poate fi accelerată. Interogările frecvente cu aceleași date de intrare se potrivesc bine în cache. Încercăm să menținem interogările „plate”, cu o singură tabelă în interogare.
Exploatare
SV ca serviciu online a fost lansat în exploatare în primăvara anului 2017, ca produs separat SV a fost lansat în noiembrie 2017 (pe atunci în statut de versiune beta).
În mai bine de un an de exploatare, nu au existat probleme serioase în funcționarea serviciului online SV. Monitorizăm serviciul online prin , colectăm și desfășurăm din .
Pachetul serverului SV este livrat sub formă de pachete native: RPM, DEB, MSI. În plus, pentru Windows, oferim un installer unic sub formă de EXE, care instalează serverul, Hazelcast și Elasticsearch pe o singură mașină. La început, am numit această versiune de instalare „demonstrativă”, dar acum este clar că aceasta este cea mai populară opțiune de desfășurare.
Sursa: habr.com
