

Trăim într-o vreme uimitoare, când putem conecta rapid și simplu mai multe instrumente deschise, să le configurăm cu un „conștiință dezactivată” după sfaturile de pe stackoverflow, fără a ne implica în „multe litere”, și să le lansăm în exploatare comercială. Iar când va fi nevoie să ne actualizăm/extindem sau când cineva va reporni din greșeală câteva mașini – ne vom da seama că a început un vis urât obsesiv în realitate, totul s-a complicat brusc până la nerecunoaștere, nu mai există cale de întoarcere, viitorul este neclar și mai sigur, în loc de programare, se recomandă creșterea albinelor și fabricarea brânzei.
Nu degeaba, colegii mai experimentați, cu capetele albe presărate de bug-uri, contemplând desfășurarea incredibil de rapidă a pachetelor de „containere” în „cuburi” pe zeci de servere folosind „limbi la modă” cu suport încorporat pentru input/output asincron-neblocant – zâmbesc modest. Și continuă în tăcere să răsfoiască „man ps”, cu ochii sângeriți din cauza surselor „nginx” și scriu-scriu-scriu teste unitare. Colegii știu că cele mai interesante lucruri sunt înainte, când „toate acestea” vor deveni într-o noapte un morman sub bradul de Crăciun. Și îi va ajuta doar o înțelegere profundă a naturii unix, tabela stării TCP/IP învățată pe de rost și algoritmii de bază pentru sortare/căutare. Pentru a readuce sistemul la viață sub bătaia clopotelor.
Ah da, m-am cam abătut, dar sper că am reușit să transmit starea de anticipare.
Astăzi vreau să împărtășesc experiența noastră de desfășurare a unui stack convenabil și ieftin pentru DataLake, care rezolvă majoritatea problemelor analitice din companie pentru diferite structuri organizaționale.
Cu ceva timp în urmă, am ajuns la concluzia că companiile au nevoie din ce în ce mai mult de fructele atât ale analizei de produs, cât și ale celei tehnice (să nu mai vorbim de cireșele de pe tort în formă de machine learning) și pentru a înțelege tendințele și riscurile – este necesar să colectăm și să analizăm din ce în ce mai multe metrici.
Analiza tehnică de bază în „Bitrix24”
Cu câțiva ani în urmă, odată cu lansarea serviciului „Bitrix24”, am investit activ timp și resurse în crearea unei platforme analitice simple și fiabile, care să ne ajute să vedem rapid problemele din infrastructură și să planificăm următorul pas. Desigur, am dorit să folosim instrumente gata făcute, cât mai simple și clare. Ca urmare, am ales Nagios pentru monitorizare și Munin pentru analiză și vizualizare. Acum avem mii de verificări în Nagios, sute de grafice în Munin, iar colegii le folosesc zilnic și cu succes. Metricile sunt clare, graficele sunt informative, sistemul funcționează fiabil de câțiva ani și se adaugă regulat noi teste și grafice: introducem un nou serviciu în exploatare — adăugăm câteva teste și grafice. Drum bun.
Mână pe puls — analiză tehnică extinsă
Dorința de a obține informații despre probleme „cât mai repede posibil” ne-a dus la experimente active cu instrumente simple și clare — Pinba și Xhprof.
Pinba ne trimitea statistici despre viteza de funcționare a părților paginilor web pe PHP în pachete UDP, iar noi puteam vedea online în baza de date MySQL (Pinba are propriul motor MySQL pentru analiză rapidă a evenimentelor) o listă scurtă de probleme și putea reacționa la acestea. Xhprof permitea, în mod automat, să colectăm graficele de execuție ale celor mai lente pagini PHP ale clienților și să analizăm ce ar fi putut duce la aceasta — liniștiți, savurând ceai sau ceva mai puternic.
Cu ceva timp în urmă, instrumentele au fost completate cu un alt motor destul de simplu și clar, bazat pe un algoritm de indexare inversă, excelent implementat în celebra bibliotecă Lucene — Elastic/Kibana. Ideea simplă de a scrie documente în mod multiprocesat în indexul invers Lucene pe baza evenimentelor din loguri și căutarea rapidă în acestea folosind divizarea pe fațete s-a dovedit, într-adevăr, utilă.
În ciuda aspectului tehnic al vizualizărilor din Kibana cu concepte la scară mică de tip „bucket” și un limbaj re-inventat care nu a fost deloc uitat din algebra relațională — instrumentul ne ajută bine în următoarele sarcini:
- Câte erori PHP a avut clientul Bitrix24 pe portalul p1 în ultima oră și de care? Să înțelegem, să iertăm și să corectăm rapid.
- Câte apeluri video au avut loc pe portalurile din Germania în ultimele 24 de ore, cu ce calitate și au existat probleme cu canalul/rețeaua?
- Cât de bine funcționează funcționalitatea sistemului (extensia noastră în C pentru PHP), compilată din surse în ultima actualizare a serviciului și distribuită clienților? Există segfaults?
- Datele clienților sunt stocate în memoria PHP? Există erori de depășire a memoriei alocate proceselor: „out of memory”? Găsiți și remediați.
Iată un exemplu concret. În ciuda testării riguroase și multilaterale, clientul a întâmpinat o eroare jenantă și neașteptată într-un caz foarte neobișnuit, cu date de intrare corupte, alarma a sunat și a început procesul de corectare rapidă:
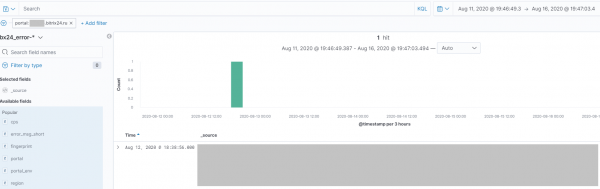
În plus, Kibana permite organizarea de notificări pe baza evenimentelor specificate, iar în scurt timp, instrumentul a început să fie utilizat de zeci de angajați din diferite departamente – de la suport tehnic și dezvoltare la QA.
Activitatea oricărui departament din cadrul companiei a devenit ușor de monitorizat și măsurat – în loc de analiza manuală a jurnalelor pe servere, este suficient să configurezi o dată parserul de jurnale și trimiterea acestora în clusterul Elastic, pentru a te bucura, de exemplu, de vizualizarea în dashboard-ul Kibana a numărului de pisici cu două capete vândute, tipărite pe imprimanta 3D în ultima lună lunară.
Analiza de afaceri de bază
Toată lumea știe că adesea analiza de afaceri în companii începe cu o utilizare extrem de activă, da, da, Excel. Dar, cel mai important, este să nu se încheie acolo. Se mai adaugă puțin combustibil focului cu Google Analytics în cloud – la bine te obișnuiești rapid.
În compania noastră, în continuă dezvoltare armonioasă, au început să apară ici și colo „profeți” ai muncii mai intensive cu date mai mari. S-au făcut frecvent cereri pentru rapoarte mai profunde și mai complexe, iar cu eforturile colegilor din diferite departamente a fost organizată cu ceva timp în urmă o soluție simplă și practică – combinația ClickHouse și PowerBI.
O perioadă destul de lungă, această soluție flexibilă a fost de mare ajutor, dar treptat a apărut conștientizarea că ClickHouse nu este elastic și nu poate fi tratat atât de brutal.
Este important să înțelegem bine că ClickHouse, la fel ca Druid, Vertica și Amazon RedShift (care se bazează pe Postgres), sunt motoare analitice optimizate pentru analize destul de accessible (sumarizări, agregări, minim-maxim pe coloane și câteva join-uri), deoarece sunt organizate pentru stocarea eficientă a coloanelor în tabele relaționale, spre deosebire de binecunoscutul MySQL și alte baze de date (row-oriented).
Practic, ClickHouse este doar o "bază" de date mai capacitară, cu o inserție punctuală nu foarte convenabilă (așa a fost gândită, totul e în regulă), dar cu o experiență analitică plăcută și un set interesant de funcții puternice pentru manipularea datelor. Da, se poate chiar crea un cluster — dar, înțelegeți, să dai cu un ciocan nu este chiar corect, așa că am început să căutăm alte soluții.
Cererea pentru Python și analiști
În compania noastră sunt mulți dezvoltatori care scriu cod aproape în fiecare zi timp de 10-20 de ani în PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. De asemenea, avem mulți administratori de sistem experimentați, care au trecut printr-o adevărată catastrofă incredibilă, care nu se conforma legilor statistice (de exemplu, când majoritatea discurilor dintr-un raid-10 sunt distruse de un fulger puternic). În aceste condiții, mult timp nu a fost clar ce înseamnă „analist pe Python”. Python este ca PHP, doar că numele e puțin mai lung și urmele substanțelor care alterează conștiința în codul sursă al interpretului sunt puțin mai mici. Totuși, pe măsură ce au fost create tot mai multe rapoarte analitice, dezvoltatorii experimentați au început să înțeleagă din ce în ce mai profund importanța specializării înguste în instrumente precum numpy, pandas, matplotlib, seaborn.
Probabil, rolul decisiv l-au jucat leșinurile bruște ale angajaților la combinația de cuvinte „regresie logistică” și demonstrarea construirii eficiente de rapoarte cu date voluminoase folosind, da, pyspark.
Apache Spark, paradigma sa funcțională, care se potrivește perfect cu algebra relațională și capacitățile sale, au impresionat atât de mult dezvoltatorii obișnuiți cu MySQL, încât necesitatea întăririi rândurilor cu analiști experimentați a devenit clară ca ziua.
Încercările ulterioare ale Apache Spark/Hadoop de a decola și ce nu a decurs conform scenariului
Cu toate acestea, a devenit evident că, în mod clar, cu Spark, ceva nu este în regulă sau poate ar trebui doar să ne spălăm mai bine pe mâini. Dacă stiva Hadoop/MapReduce/Lucene a fost realizată de programatori destul de experimentați, ceea ce devine evident dacă privind cu atenție codul sursă Java sau ideile lui Doug Cutting în Lucene, atunci Spark, dintr-o dată, este scris într-un limbaj exotic, foarte contestat din perspectiva practicabilității și care acum nu se dezvoltă, Scala. Iar căderile regulate ale calculelor pe clusterul Spark din cauza gestionării ilogice și destul de opace a memoriei pentru operațiile reduce (sunt trimise multe chei simultan) au creat în jurul său o aureolă a ceva ce are unde să evolueze. În plus, situația era agravată de numărul mare de porturi deschise ciudate, fișiere temporare crescânde în cele mai neclare locuri și miriade de dependențe jar - ceea ce provoca administratorilor de sistem acel sentiment familiar: o ură puternică (poate că trebuia să ne spălăm pe mâini cu săpun).
În urma acestui proces, am „suportat” câteva proiecte analitice interne, care foloseau activ Apache Spark (inclusiv Spark Streaming, Spark SQL) și ecosistemul Hadoop (și multe altele). În ciuda faptului că, în timp, am învățat să „pregătim” destul de bine „aceasta” și să monitorizăm, iar „aceasta” a încetat practic să cadă din cauza schimbării naturii datelor și dezechilibrării hashing-ului uniform RDD, dorința de a lua ceva deja gata, actualizat și administrat undeva în cloud s-a intensificat din ce în ce mai mult. În acel moment, am încercat să folosim o construcție cloud gata făcută de Amazon Web Services - și, ulterior, am încercat să rezolvăm problemele pe această platformă. EMR este varianta Apache Spark pregătită de Amazon cu software suplimentar din ecosistem, asemănător cu construcțiile Cloudera/Hortonworks.
Un stocare de fișiere „elastică” pentru analize - o nevoie urgentă
Experiența „preparării” Hadoop/Spark cu arsuri pe diverse părți ale corpului nu a trecut fără urmări. A devenit din ce în ce mai evidentă necesitatea de a crea un stocare de fișiere unică, ieftină și fiabilă, care să fie rezistentă la defecțiuni hardware și în care să poată fi stocate fișiere în diferite formate din diferite sisteme și să se facă selecții eficiente și realizabile într-un timp rezonabil pentru rapoarte.
De asemenea, aș dori ca actualizarea software-ului acestei platforme să nu devină un coșmar de noapte de Anul Nou, cu citirea unor stack-uri Java de 20 de pagini și analiza unor log-uri kilometrice ale funcționării clustelui folosind Spark History Server și o lupă cu iluminare. Aș fi dorit un instrument simplu și transparent, care să nu necesite o verificare regulată sub capotă, în cazul în care o interogare standard MapReduce a dezvoltatorului nu mai funcționează din cauza unei alegeri nefericite a algoritmului de partiționare a datelor inițiale.
Amazon S3 — candidatul pentru DataLake?
Experiența cu Hadoop/MapReduce m-a învățat că este nevoie de un sistem de fișiere fiabil și scalabil, precum și de lucrători scalabili care „vin” mai aproape de date, pentru a nu transfera datele prin rețea. Lucrătorii trebuie să fie capabili să citească date în diferite formate, dar, de preferat, să nu citească informații suplimentare și să se poată stoca datele în formate convenabile pentru lucrători.
Încă o dată — ideea principală. Nu există dorința de a „încărca” mari cantități de date într-un singur motor analitic de cluster, care oricum va colapsa la un moment dat și va trebui să-l împărțim neplăcut. Aș dori să stochez fișiere, pur și simplu fișiere, într-un format clar și să efectuez pe ele interogări analitice eficiente cu instrumente diferite, dar ușor de înțeles. Iar fișierele în diferite formate vor continua să crească. Este mai bine să împărțim datele originale, decât motorul. Ne trebuie un DataLake extins și universal, am decis noi...
Ce-ar fi să stocăm fișiere în binecunoscuta și utilizată de mulți soluție de stocare Cloud scalabilă Amazon S3, fără să ne ocupăm de propriile noastre preparate din Hadoop?
Este clar, datele personale sunt „interzise”, dar ce se întâmplă cu alte date dacă le ducem acolo și le „fugim eficient”?
Ecosistemul analitic de big data clusterizat Amazon Web Services — foarte pe scurt
Judecând după experiența noastră de lucru cu AWS, Apache Hadoop/MapReduce este folosit de mult timp și activ sub diferite forme în serviciul DataPipeline (invidiez colegii, au învățat cum să-l pregătească corect). Aici am configurat backup-uri din diferite servicii din tabelele DynamoDB:
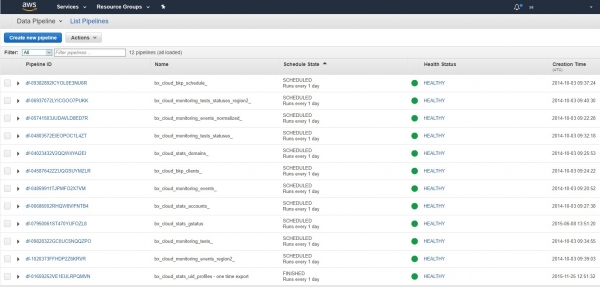
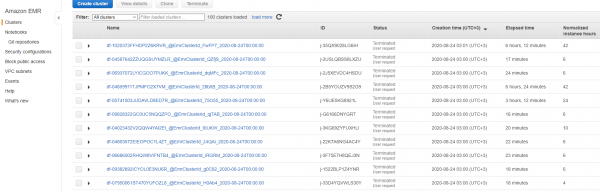
Și acestea se efectuează regulat pe clusterele Hadoop/MapReduce ca un ceas deja de câțiva ani. „Am configurat și am uitat:”
De asemenea, poți să te dedici eficient datascience-ului, ridicând pentru analiști cărți de lucru Jupiter în cloud și folosind AWS SageMaker pentru antrenarea și implementarea modelelor AI. Iată cum arată la noi:
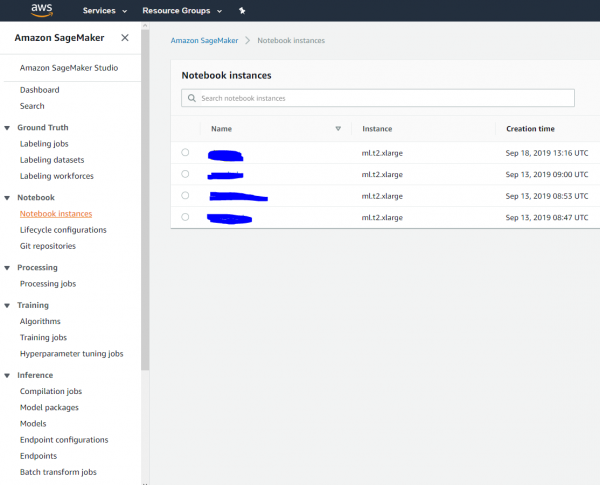
Și da, poți să ridici o carte de lucru în cloud pentru tine sau pentru analist și să o atașezi la un cluster Hadoop/Spark, să efectuezi calcule și apoi să le "finalizezi":
Adevărat, este convenabil pentru proiecte analitice individuale și pentru unele dintre acestea am folosit cu succes serviciul EMR pentru calcule și analize pe scară mare. Dar ce zici de o soluție sistemică pentru DataLake? Va fi posibil? În acel moment eram la limita speranței și disperării și continuăm căutarea.
AWS Glue — un Apache Spark "la superlativ"
S-a dovedit că AWS are o versiune „proprie” a stivei „Hive/Pig/Spark”. Rolul lui Hive, adică catalogul fișierelor și tipurilor acestora în DataLake, este îndeplinit de serviciul „Data catalog”, care nu ascunde compatibilitatea sa cu formatul Apache Hive. La acest serviciu trebuie să adaugi informații despre unde se află fișierele tale și în ce format sunt. Datele pot fi nu doar în s3, ci și în bazele de date, dar despre asta nu este acest post. Iată cum este organizat catalogul de date DataLake la noi:
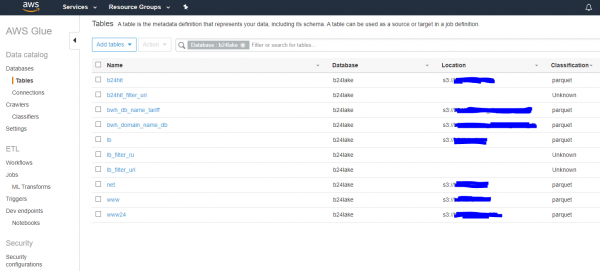
Fișierele sunt înregistrate, excelent. Dacă fișierele s-au actualizat — pornim manual sau conform unui program crawlers care vor actualiza informațiile din lac și le vor salva. Mai departe, datele din lac pot fi procesate, iar rezultatele exportate undeva. În cel mai simplu caz — exportăm de asemenea în s3. Procesarea datelor poate fi realizată oriunde, dar se propune să configurăm procesul de procesare pe un cluster Apache Spark folosind capabilitățile avansate prin API AWS Glue. Practic, poți lua vechiul și familiarul cod pe python folosind bibliotecă pyspark și să îl configurezi să ruleze pe N noduri ale unui cluster de anumită putere cu monitorizare, fără a te ocupa de detaliile Hadoop și fără a transpune containere docker și a rezolva conflicte de dependențe.
Încă o dată — o idee simplă. Nu trebuie să configurezi Apache Spark, trebuie doar să scrii cod pe python pentru pyspark, să-l testezi local pe desktop și apoi să-l lansezi pe un cluster mare în cloud, indicând unde se află datele de bază și unde să pui rezultatul. Uneori este necesar și util, iar iată cum este configurat la noi:
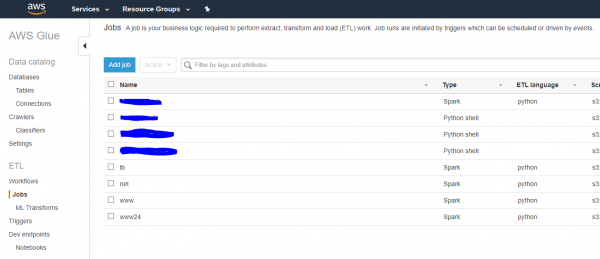
Astfel, dacă trebuie să efectuezi calcule pe un cluster Spark cu date în s3 — scriem cod pe python/pyspark, testăm și plecăm în cloud.
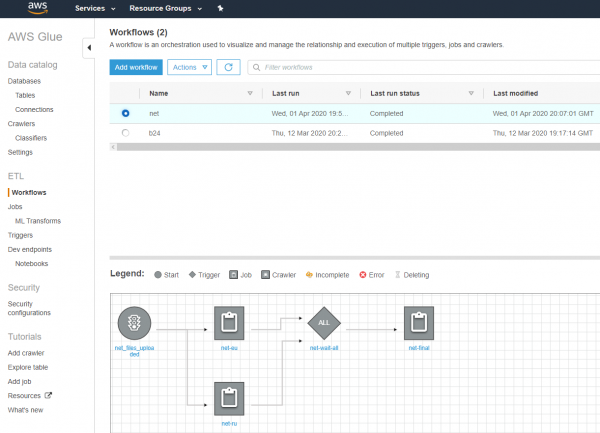
Ce este cu orchestration? Și dacă o sarcină a căzut și s-a pierdut? Da, se propune să facem un pipeline frumos în stilul Apache Pig și chiar le-am încercat, dar am decis să folosim, pentru moment, orchestration-ul nostru profund personalizat pe PHP și JavaScript (înțeleg că apare un disconfort cognitiv, dar funcționează, de ani de zile și fără erori).
Formatul fișierelor stocate în lac este cheia performanței
Este foarte, foarte important să înțelegem încă două aspecte esențiale. Pentru ca cererile de date din fișierele stocate în lac să fie executate cât mai rapid și performanța să nu degradeze în urma adăugării de informații noi, este nevoie de:
- Coloanele fișierelor trebuie păstrate separat (pentru a nu fi necesar să se citească toate liniile pentru a înțelege ce este în coloane). Pentru aceasta, am adoptat formatul parquet cu compresie.
- Este foarte important să shard-uim fișierele în foldere precum: limbă, an, lună, zi, săptămână. Motoarele care înțeleg acest tip de shard-uire vor căuta doar în folderele necesare, fără a analiza toate datele.
Practic, în acest fel, puneți datele originale în cea mai eficientă formă pentru motoarele analitice de deasupra, care pot accesa selective folderele shard-uite și citi doar coloanele necesare din fișiere. Nu trebuie să „încărcați” datele nicăieri (stocarea se va sparge) — pur și simplu puneți-le imediat în sistemul de fișiere în formatul corect. Desigur, trebuie să fie clar că păstrarea unui fișier CSV uriaș în DataLake, care trebuie citit rând cu rând de un cluster pentru a extrage coloanele — nu este foarte eficient. Reflectați asupra celor două puncte de mai sus din nou, dacă încă nu este clar de ce toate acestea.
AWS Athena — „demonul” din cutie
Și aici, creând un lac, am dat, oarecum întâmplător, peste Amazon Athena. A devenit brusc evident că, aranjând cu atenție fișierele noastre uriașe de jurnale după folderele corecte (parquet) în formatul coloanal — putem face selecții extrem de informative foarte repede și să generăm rapoarte FĂRĂ, fără un cluster Apache Spark/Glue.
Motorul Athena, care lucrează cu datele din s3, se bazează pe legendarul — reprezentant al familiei de abordări MPP (procesare paralelel masiv) pentru prelucrarea datelor, care ia datele exact de unde sunt, de la S3 și Hadoop până la Cassandra și fișierele text obișnuite. Trebuie doar să cerem lui Athena să execute o interogare SQL, iar restul „funcționează rapid și de la sine”. Este important de menționat că Athena este „inteligentă”, accesează doar folderele fragmentate necesare și citește doar coloanele necesare din interogare.
Tarifarea interogărilor către Athena este, de asemenea, interesantă. Plătim pentru . Adică, nu pentru numărul de mașini în cluster pe minut, ci... pentru datele realmente scanate pe 100-500 de mașini, doar cele necesare pentru a executa interogarea.
Și, solicitând doar coloanele necesare din folderele corect fragmentate, s-a dovedit că serviciul Athena ne costă zeci de dolari pe lună. Ei bine, este minunat, aproape gratuit, comparativ cu analizele pe clustere!
Iată cum ne fragmentăm datele în S3:
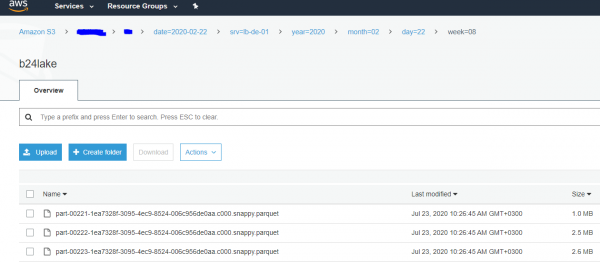
Drept urmare, într-un timp scurt, diferite departamente din companie, de la securitatea informațiilor la analiză, au început să facă interogări active către Athena și să obțină rapid, în câteva secunde, răspunsuri utile din „datele mari” pe perioade relativ extinse: luni, semestre etc.
Dar am mers mai departe și am început să căutăm răspunsuri în cloud : analistul, în consola obișnuită, scrie o interogare SQL, care „pe 100-500 de mașini, pentru un cost mic” scanează datele în S3 și returnează răspunsul de obicei în câteva secunde. Este convenabil. Și rapid. Nici acum nu-mi vine să cred.
În cele din urmă, având în vedere că am decis să stocăm datele în S3, într-un format columnar eficient și cu fragmentarea rezonabilă a datelor pe foldere... am obținut un DataLake și un motor analitic rapid și ieftin — gratuit. Și a devenit foarte popular în companie, deoarece înțelege SQL și funcționează de ordinul magnitudinii mai rapid decât prin lansări/opriri/setări ale clusterelor. „Și dacă rezultatul este același, de ce să plătești mai mult?”
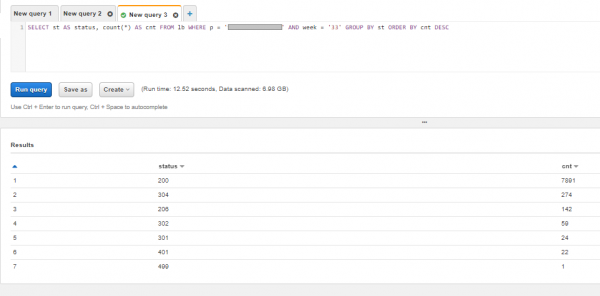
O interogare către Athena arată aproximativ așa. Dacă este necesar, desigur, se poate formula o interogare SQL suficient de , dar ne vom limita la o simplă grupare. Să vedem ce coduri de răspuns a avut clientul acum câteva săptămâni în jurnalele de activitate ale serverului web și să ne asigurăm că nu sunt erori:
Conclusions
După un parcurs care nu a fost lung, dar a fost dureros, evaluând constant riscurile, nivelul de dificultate și costurile de suport, am găsit o soluție pentru DataLake și analitică, care ne bucură atât prin viteză, cât și prin costurile de proprietate.
A devenit clar că este complet realizabil să construiești un DataLake eficient, rapid și cu costuri reduse de operare pentru nevoile diverselor departamente ale companiei, chiar și pentru dezvoltatori experimentați care nu au fost niciodată arhitecți și care nu știu să deseneze pătrățele pe pătrățele cu săgeți, cunoașterea a 50 de termeni din ecosystema Hadoop.
La început, capul îți explodează de la multitudinea de zoo-uri, atât de software liber, cât și închis, și de la conștientizarea responsabilității față de urmași. Începeți să construiți DataLake-ul vostru cu instrumente simple: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3 …, adunând feedback și înțelegând profund fizica proceselor care au loc. Tot ce este complicat și neclar – lăsați-l pe dușmani și pe concurenți.
Dacă nu doriți să utilizați cloudul și vă place să susțineți, să actualizați și să aplicați patch-uri proiectelor open-source, puteți construi o schemă similară cu a noastră local, pe mașini de birou ieftine, folosind Hadoop și Presto deasupra. Principalul este să nu vă opriți și să mergeți înainte, să calculați, să căutați soluții simple și clare, și totul va funcționa! Buna șansă tuturor și pe curând!
Sursa: habr.com
