

Bună, Habr! În ultimele câteva luni, am trăit o situație foarte interesantă și aș dori să împărtășesc povestea noastră despre scalarea infrastructurii. În acest timp, SberMarket a crescut de patru ori în comenzi și a lansat serviciul în 17 orașe noi. Creșterea explozivă a cererii de livrare a produselor a necesitat extinderea infrastructurii. Citește mai departe pentru cele mai interesante și utile concluzii.
Mă numesc Dima Bobylev, sunt directorul tehnic al SberMarket. Deoarece acesta este primul post din blogul nostru, voi spune câteva cuvinte despre mine și despre companie. În toamna trecută, am participat la concursul tinerilor lideri din Runet. Pentru acest concurs, despre cum vedem noi, la SberMarket, cultura internă și abordarea dezvoltării serviciului. Și deși nu am câștigat concursul, am reușit să-mi formulez principii fundamentale pentru dezvoltarea ecosistemului IT.
Atunci când gestionezi o echipă, este important să înțelegi și să găsești un echilibru între ceea ce este necesar pentru afacere și nevoile fiecărui dezvoltator în parte. În prezent, SberMarket crește de 13 ori pe an, iar acest lucru influențează produsul, impunând o creștere constantă a volumului și a ritmului de dezvoltare. Cu toate acestea, alocăm suficient timp dezvoltatorilor pentru analiza preliminară și scrierea de cod de calitate. Abordarea stabilită ajută nu doar la crearea unui produs funcțional, ci și la scalarea și dezvoltarea acestuia în continuare. Ca rezultat al acestei creșteri, SberMarket a devenit deja lider printre serviciile de livrare a produselor: livrăm zilnic aproximativ 18.000 de comenzi pe zi, deși la începutul lunii februarie erau în jur de 3.500.
Odată, un client a cerut curierului SberMarket să-i livreze produsele într-un mod fără contact - direct pe balcon.
Dar să trecem la concret. În ultimele câteva luni, ne-am concentrat activ pe scalarea infrastructurii companiei noastre. Această nevoie a fost determinată atât de factori externi, cât și interni. În același timp cu extinderea bazei de clienți, numărul magazinelor conectate a crescut de la 90 la începutul anului la peste 200 până în mijlocul lunii mai. Sigur, ne-am pregătit, am rezervat infrastructura principală și am calculat posibilitatea scalării verticale și orizontale a tuturor mașinilor virtuale găzduite în cloud-ul Yandex. Totuși, realitatea a demonstrat: „Tot ce poate merge prost, va merge prost”. Astăzi vreau să împărtășesc cele mai interesante situații care au apărut în aceste săptămâni. Sper că experiența noastră va fi utilă pentru voi.
Slave-ul este în plină capacitate operațională
Încă înainte de începerea pandemiei, ne-am confruntat cu o creștere a numărului de solicitări pentru serverele noastre backend. Tendința de a comanda produse cu livrare la domiciliu a început să prindă avânt, iar odată cu introducerea primelor măsuri de autoizolare din cauza COVID-19, încărcarea a crescut dramatic pe parcursul întregii zile. A apărut necesitatea de a decongestiona rapid serverele master ale bazei de date principale și de a transfera parte din solicitările de citire pe serverele replici (slave).
Ne-am pregătit din timp pentru acest pas, iar pentru un astfel de manevră deja fuseseră activate 2 servere slave. Acestea au fost folosite în principal pentru sarcini batch de generare a fluxurilor de informații pentru schimbul de date cu partenerii. Aceste procese generau o încărcare suplimentară și, pe bună dreptate, fuseseră excluse din funcționare cu câteva luni înainte.
Deoarece pe Slave avea loc replicarea, ne-am menținut conceptul că aplicațiile pot lucra cu acestea doar în modul read only. Planul de Recuperare în Caz de Calamitate presupunea că, în cazul unei catastrofe, putem monta pur și simplu Slave-ul în locul Master-ului și vom redirecționa toate solicitările de scriere și citire pe Slave. Cu toate acestea, ne-am dorit de asemenea să folosim replicile pentru nevoile departamentului de analiză, așa că serverele nu au fost complet tranșate în statutul de read only, iar pe fiecare host a existat un set propriu de utilizatori, unii având permisiuni de scriere pentru a salva rezultatele intermediare ale calculelor.
Până la un anumit nivel de încărcare, ne ajungea un master atât pentru scriere, cât și pentru citire în procesarea solicitărilor HTTP. La mijlocul lunii martie, atunci când Sbermarket a decis să treacă complet la munca de la distanță, am început să observăm o creștere exponențială a RPS. Tot mai mulți dintre clienții noștri au început să se izoleze sau să lucreze de acasă, ceea ce a avut un impact asupra indicatorilor de încărcare.
Performanța „master-ului” nu a mai fost suficientă, așa că am început să externalizăm o parte din cele mai intense solicitări de citire către replică. Pentru a direcționa transparent solicitările de scriere către master și citirea către slave, am folosit gem-ul ruby „”. Am creat un utilizator special cu sufixul _readonly fără drepturi de scriere. Dar din cauza unei erori în configurația unuia dintre hosturi, o parte din solicitările de scriere au fost redirecționate către serverul slave în numele unui utilizator care avea drepturi corespunzătoare.
Problema nu s-a manifestat imediat, deoarece încărcarea crescută a dus la întârzierea slavelor. Inconsistența datelor a fost descoperită dimineața, când, după importurile nocturne, slavelor nu au reușit să „ajungă” master-ul. Am pus acest lucru pe seama încărcării mari pe serviciu și a importului legat de lansarea de noi magazine. Totuși, livrarea de date cu o întârziere de câteva ore era inacceptabilă, așa că am transferat procesele pe al doilea slave analitic, deoarece avea bmareurse resurse și nu era încărcat cu solicitări de citire (ceea ce ne-a explicat absența întârzierii replicării).
Când ne-am dat seama de cauzele „dezintegrării” slave-ului principal, cel analitic a ieșit din funcțiune din același motiv. În ciuda existenței a două servere suplimentare, pe care intenționam să transferăm încărcătura în caz de cădere a masterului, dintr-o eroare regretabilă nu am avut niciunul în momentul critic.
Dar, fiindcă nu doar am făcut un dump al bazei de date (restaurarea la acel moment dura aproximativ 5 ore), ci și un snapshot al serverului master, am reușit să lansăm replica în decurs de 2 ore. Cu toate acestea, după aceasta, a fost necesară actualizarea jurnalului de replicare timp îndelungat (deoarece procesul se desfășoară într-un mod unithread, dar aceasta este o altă poveste).
Concluzie: După un astfel de incident, a devenit clar că trebuie să renunțăm la practica restricționării înregistrării pentru utilizatori și să declarăm serverul în mod readonly. Cu o astfel de abordare, nu putem fi decât siguri că replicile vor fi disponibile în momente critice.
Optimizarea chiar și a unei singure interogări intensive poate „readuce la viață” baza de date.
Deși actualizăm constant catalogul de pe site, interogările pe care le-am direcționat către serverele Slave au suferit o întârziere minoră față de Master. Timpul necesar pentru a descoperi și a remedia problema replicilor „care au ieșit brusc de pe traseu” a fost mai mare decât „bariera psihologică” (în acest timp ar fi putut avea loc actualizări de prețuri, iar clienții ar fi văzut date învechite), iar noi am fost nevoiți să comutăm toate interogările pe serverul principal al bazei de date. Ca rezultat, site-ul a funcționat lent… dar mămăligă în sfârșit a funcționat. Și cât timp Slave-ul se recupera, nu ne-a rămas altceva de făcut decât optimizarea.
În timp ce serverele Slave se recuperau, minutele se scurgeau lent, Masterul rămânea supraîncărcat, iar noi ne-am concentrat toate eforturile pe optimizarea sarcinilor active conform „Regulii Pareto”: am selectat CELE MAI IMPORTANTE interogări, care generau cea mai mare parte a încărcării și am început tuningul. Acest lucru a fost realizat direct „în mers”.
Un efect interesant a fost că un MySQL suprasolicitat răspunde chiar și la o îmbunătățire nesemnificativă a proceselor. Optimizația unor interogări care produceau doar 5% din încărcarea totală a arătat deja o reducere notabilă a CPU-ului. Ca urmare, am reușit să asigurăm o rezervă de resurse acceptabilă pentru funcționarea Master-ului cu baza de date și să obținem timpul necesar pentru recuperarea replicilor.
Concluzie: Chiar și o mică optimizare permite „să supraviețuiești” la o supraîncărcare timp de câteva ore. Asta era exact ce ne trebuia pentru timpul de recuperare al serverelor cu replici. Apropo, partea tehnică a optimizării interogărilor o vom discuta într-unul dintre următoarele postări. Așa că abonați-vă la blogul nostru dacă vă poate fi de folos.
Organizați monitorizarea funcționării serviciilor-partener.
Ne ocupăm cu procesarea comenzilor clienților și, prin urmare, serviciile noastre interacționează constant cu API-uri externe – acestea sunt portaluri pentru trimiterea SMS-urilor, platforme de plată, sisteme de rutare, geocodare, serviciul de fiscalitate și multe alte sisteme. Când volumul de muncă a început să crească rapid, am început să ne ciocnim de limitele API-urilor serviciilor noastre partenere, despre care nu ne-am gândit anterior.
Excedarea neașteptată a cotelor serviciilor partenere poate duce la nefuncționarea propriilor servicii. Multe API-uri blochează clienții care depășesc limitele, iar în unele cazuri, un surplus de cereri poate supraîncărca producția partenerului.
De exemplu, în timpul creșterii numărului de livrări, serviciile însoțitoare nu reușeau să facă față sarcinilor de distribuire și determinare a rutelor. Ca rezultat, comenzile erau plasate, iar serviciul care creează ruta nu funcționa. Trebuie spus că logisticienii noștri au realizat aproape imposibilul în aceste condiții, iar colaborarea echipei a ajutat să compenseze defecțiunile temporare ale serviciilor. Dar un volum atât de mare de solicitări nu se poate gestiona constant manual și, după un timp, ne-am fi confruntat cu o prăpastie inacceptabilă între comenzi și execuția lor.
A fost adoptat un întreg set de măsuri organizaționale și munca coordonată a echipei a ajutat să câștigăm timp în timp ce negociam noi condiții și așteptam modernizarea serviciilor din partea unor parteneri. Există și alte API-uri care se remarcă prin rezistența ridicată și tarife sălbatice în cazul unui trafic mare. De exemplu, la început, am folosit un API cartografic cunoscut pentru determinarea adresei punctului de livrare. Dar la sfârșitul lunii, am primit o factură considerabilă de aproape 2 milioane de ruble. După aceea, am decis să-l înlocuim rapid. Nu voi face reclamă, dar voi spune că cheltuielile noastre s-au redus semnificativ.
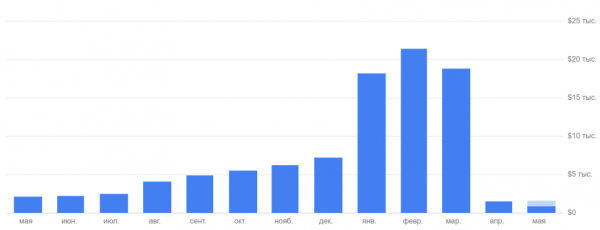
Concluzie: Este esențial să monitorizăm condițiile de funcționare ale tuturor serviciilor partenere și să le avem în vedere. Chiar dacă astăzi pare că au „un mare rezervă”, nu înseamnă că mâine nu vor deveni un obstacol pentru creștere. Și, desigur, este mai bine să negociezi înainte condițiile financiare pentru cererile crescute către serviciu.
Uneori se dovedește că „” (c) nu ajută
Ne-am obișnuit cu "blocajele" în baza de date principală sau pe serverele aplicațiilor, dar la scalare, problemele pot apărea acolo unde nu te aștepți. Pentru căutarea full-text pe site, folosim motorul Apache Solr. Cu creșterea încărcării, am observat o scădere a timpului de răspuns, iar utilizarea procesorului serverului ajungea la 100%. Ce poate fi mai simplu - să oferim containerului cu Solr mai multe resurse.
În loc de creșterea așteptată a performanței, serverul s-a "înghețat". Se încărca imediat la 100% și răspundea și mai lent. Inițial, aveam 2 nuclee și 2 GB RAM. Am decis să facem ceea ce de obicei ajută - am dat serverului 8 nuclee și 32 GB. Totul a devenit mult mai rău (cum anume și de ce - vom povesti într-o postare separată).
În câteva zile, am înțeles subtilitățile acestei probleme și am obținut o performanță optimă la 8 nuclee și 32 GB. Această configurație permite și astăzi continuarea creșterii încărcării, ceea ce este foarte important, deoarece creșterea nu vine doar din numărul de clienți, ci și din numărul de magazine conectate - în 2 luni, numărul acestora s-a dublat.
Concluzie: Metodele standard, cum ar fi „adăugarea mai multor resurse”, nu funcționează întotdeauna. Așadar, la scalarea oricărui serviciu, trebuie să înțelegi bine cum utilizează resursele și să testezi din timp funcționarea acestuia în noi condiții.
Stateless - cheia scalării orizontale simple
În general, echipa noastră aderă la abordarea cunoscută: serviciile nu ar trebui să aibă un stat intern (stateless) și ar trebui să fie independente de mediu. Acest lucru ne-a permis să facem față creșterii încărcării prin scalare orizontală simplă. Dar am avut un serviciu-excepție - un procesator de sarcini de fundal lungi. Se ocupa cu trimiterea de emailuri și SMS-uri, procesarea evenimentelor, generarea de feed-uri, importul de prețuri și stocuri, procesarea imaginilor. Așa s-a întâmplat că depindea de un storage local și era într-un singur exemplar.
Când numărul de sarcini în coada procesorului a crescut (ceea ce s-a întâmplat firesc odată cu creșterea numărului de comenzi), performanța serverului pe care erau găzduite procesorul și stocarea de fișiere a devenit un factor limitativ. Ca urmare, s-a oprit actualizarea stocului și a prețurilor, trimiterea notificărilor utilizatorilor și multe alte funcții critice, blocate în coadă. Echipa Ops a migrat rapid stocarea de fișiere într-o soluție de stocare de tip S3, ceea ce ne-a permis să ridicăm mai multe mașini puternice pentru a scala procesorul de sarcini în fundal.
Concluzie: Regula Stateless trebuie respectată pentru toate componentele, fără excepție, chiar dacă pare „că aici sigur nu ne vom împotmoli”. Mai bine să investești puțin timp în organizarea corectă a funcționării tuturor sistemelor, decât să rescrii codul în grabă și să repari un serviciu care suferă de suprasarcină.
7 principii pentru creștere intensă
În ciuda disponibilității unor capacități suplimentare, în timpul creșterii am dat peste câteva capcane. În această perioadă, numărul comenzilor a crescut de peste 4 ori. Acum livrăm deja mai mult de 17 000 de comenzi pe zi în 62 de orașe și plănuim să ne extindem și mai mult geografic — în prima jumătate a anului 2020, lansarea serviciului la nivel național în Rusia este așteptată. Pentru a face față încărcăturii crescânde, având în vedere experiențele acumulate, am formulat 7 principii fundamentale de lucru în condiții de creștere constantă:
- Managementul incidentelor. Am creat un tablou în Jira, unde fiecare incident este reflectat sub formă de tichet. Aceasta va ajuta efectiv la stabilirea priorităților și realizarea sarcinilor legate de incident. De fapt, nu este înfricoșător să greșești — este înfricoșător să greșești de două ori pe aceeași temă. Pentru cazurile în care incidentele se repetă înainte de a reuși să corectăm cauza, ar trebui să existe o instrucțiune de acțiune pregătită, pentru că, în timpul unei mari încărcări, este important să reacționezi instantaneu.
- Monitorizare este necesară pentru toate elementele infrastructurii, fără excepție. Tocmai datorită lui am putut prognoza creșterea încărcării și alege corect „gâturile de sticlă” pentru prioritizarea remedierii. Cel mai probabil, sub o încărcare mare se va defecta sau va începe să încetinească tot ceea ce nu te-ai gândit. De aceea, cele mai bune alerte sunt cele create imediat după apariția primelor incidente, pentru a le monitoriza și anticipa.
- Alertele corecte sunt pur și simplu necesare în cazul unei creșteri bruște a încărcării. În primul rând, acestea trebuie să raporteze exact ce s-a defectat. În al doilea rând, nu ar trebui să fie multe alerte, deoarece abundența alertelor non-critice duce la ignorarea tuturor notificărilor în general.
- Aplicațiile trebuie să fie stateless. Ne-am asigurat că pentru această regulă nu ar trebui să existe excepții. Este necesară o independență totală față de mediul de execuție. Pentru aceasta, poți stoca date partajate în DB sau, de exemplu, direct în S3. Și mai bine, urmează regulile. În timpul unei creșteri bruște, nu este timp de optimizare a codului, iar gestionarea încărcării va trebui să se facă prin creșterea directă a resurselor computaționale și prin scalarea orizontală.
- Cotele și performanța serviciilor externe. În cazul unei creșteri rapide, problema poate apărea nu doar în infrastructura ta, ci și în serviciul extern. Cel mai frustrant este când acest lucru se întâmplă nu din cauza unei defecțiuni, ci din cauza atingerii cotelor sau limitelor. Așa că serviciile externe trebuie să se scaleze la fel de bine ca și tine.
- Separă procesele și cozile. Acest lucru ajută foarte mult atunci când apare o blocare la unul dintre gateway-uri. Nu ne-am confrunta cu întârzieri în transmiterea datelor, dacă cozile pline de trimitere a SMS-urilor nu ar perturba schimbul de notificări între sistemele informaționale. Și ar fi fost mai ușor să creștem numărul de worker-e, dacă ar fi lucrat separat.
- Realitățile financiare. Când există o creștere explozivă a fluxurilor de date, nu este timp de gândire la tarife și subscripții. Dar trebuie să te gândești la ele, mai ales dacă ești o companie mică. O factură mare poate să apară din partea oricărui API, precum și a furnizorului tău de hosting. Așa că trebuie să citești cu atenție contractele.
Concluzie
Nu fără pierderi, dar am trecut prin această etapă și astăzi ne străduim să ne respectăm toate principiile stabilite, fiecare mașină având capacitatea de a crește performanța de 4 ori pentru a face față unor surprize neprevăzute.
În postările viitoare, ne vom împărtăși experiența în investigarea scăderii performanței în Apache Solr, precum și vom discuta despre optimizarea cererilor și despre cum interacțiunea cu FNS ajută compania să economisească bani. Abonați-vă la blogul nostru pentru a nu rată nimic și povestiți-ne în comentarii dacă ați întâmpinat probleme similare în timpul creșterii traficului.
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Ați întâmpinat vreodată o încetinire/schemă a serviciului în condițiile unei creșteri bruște a încărcării din cauza:
55,6%Imposibilității de a adăuga rapid resurse computaționale10
16,7%Limitelor infrastructurii furnizorului de hosting3
33,3%Limitelor API-urilor terțelor6
27,8%Încălcării principiilor stateless ale aplicațiilor proprii5
88,9%Neoptimizării codului serviciilor proprii16
Au votat 18 utilizatori. S-au abținut 6 utilizatori.
Sursa: habr.com
