

Astăzi, disponibilitatea ridicată a serviciilor este necesară în permanență și pretutindeni, nu doar în proiecte mari și costisitoare. Site-urile temporar inaccesibile, cu mesajul "Ne pare rău, se efectuează întreținere tehnică" mai apar, dar de obicei provoacă doar un zâmbet condescendent. Adăugăm la aceasta viața în cloud, unde pentru a lansa un server suplimentar este nevoie doar de un apel API, fără a mai fi necesară gândirea la exploatarea "hardware-ului". Astfel, nu mai există justificări pentru care un sistem critic să nu fi fost realizat fiabil folosind tehnologii de clustering și redundanță.
Vom povesti despre soluțiile pe care le-am analizat pentru a asigura fiabilitatea bazelor de date în serviciile noastre și la ce am ajuns. Plus o demonstrație cu concluzii de lungă durată.
Legacy în arhitectura asigurării disponibilității ridicate
Acest lucru se observă și mai bine în cadrul evoluției diverselor sisteme opensource. Soluțiile vechi au fost obligate să adauge tehnologii de disponibilitate ridicată pe măsură ce cererea a crescut. Calitatea acestora a fost variabilă. Soluțiile de nouă generație pun disponibilitatea ridicată la baza arhitecturii lor. De exemplu, MongoDB își poziționează clusterul ca principal mod de utilizare. Clusterul se scalază orizontal, ceea ce reprezintă un avantaj competitiv puternic pentru acest SGBD.
Să ne întoarcem la PostgreSQL. Este unul dintre cele mai vechi proiecte opensource populare, prima sa versiune având loc în 1995. Echipa proiectului nu a considerat mult timp că disponibilitatea ridicată este o sarcină ce trebuie rezolvată din partea sistemului. Prin urmare, tehnologia de replicare pentru crearea copiilor de date a fost integrată doar în versiunea 8.2 în 2006, dar a fost o replicare pe bază de fișiere (log shipping). În 2010, în versiunea 9.0 a apărut replicarea în flux, care stă la baza creării celor mai diverse clustere. Aceasta, de fapt, surprinde foarte mult persoanele care descoperă PostgreSQL după Enterprise SQL sau modernele NoSQL — soluția standard din comunitate este pur și simplu un master-replica cu replicare sincronă sau asincronă. În plus, în stoc, comutarea masterului se face manual, iar problema comutării clienților este, de asemenea, propusă a fi rezolvată pe cont propriu.
Cum am decis să facem un PostgreSQL fiabil și ce am ales pentru aceasta
Cu toate acestea, PostgreSQL nu ar fi fost atât de popular dacă nu ar fi existat o mulțime de proiecte și instrumente care ajută la construirea unei soluții rezistente la erori, care nu necesită atenție constantă. În cloud (MCS) încă de la lansarea DBaaS au fost disponibile servere PostgreSQL unice și perechi master-replică cu replicare asincronă.
Desigur, ne-am dorit să le simplificăm tuturor viața și să facem accesibilă o instalație PostgreSQL care să poată servi drept bază pentru servicii cu înaltă disponibilitate, fără a necesita supraveghere constantă și fără a fi nevoie să te trezești noaptea pentru a efectua o comutare. În acest segment există atât soluții vechi, verificate, cât și o nouă generație de utilitare care utilizează cele mai recente descoperiri.
Astăzi, problema înaltăi disponibilități nu se referă atât la rezervare (aceasta este evidentă), ci la consens — algoritmul de alegere a liderului (Leader election). Cele mai frecvente accidente majore nu se întâmplă din cauza lipsei de servere, ci din cauza problemelor de consens: nu s-a ales un nou lider, au apărut doi lideri în centre de date diferite etc. Un exemplu este accidentul din clusterul MySQL de pe Github — ei au scris .
Baza matematică în această problemă este foarte serioasă. Pe de o parte, există , care impune constrângeri teoretice asupra posibilităților de construire a soluțiilor HA, iar pe de altă parte — algoritmi dovediți matematic pentru determinarea consensului, cum ar fi și . Pe această bază există DCS-uri (sisteme de consens descentralizat) destul de populare — Zookeeper, etcd, Consul. Prin urmare, dacă sistemul de luare a deciziilor funcționează pe baza vreunui algoritm propriu, creat de sine stătător, este necesar să se abordeze cu mare prudență. După analiza unui număr considerabil de sisteme, ne-am oprit asupra Patroni — un sistem open-source, dezvoltat în principal de compania Zalando.
Ca o digresiune lirică, trebuie să menționez că am luat în considerare și soluțiile multi-master, adică clustere care pot fi scalate orizontal pentru scriere. Totuși, din două motive principale, am decis să nu implementăm un astfel de cluster. În primul rând, aceste soluții au o complexitate ridicată și, în consecință, mai multe puncte vulnerabile. Va fi dificil de realizat o soluție stabilă pentru toate cazurile. În al doilea rând, în acest caz, PostgreSQL își pierde puritatea (native), unele funcții vor fi indisponibile și pentru unele aplicații pot apărea bug-uri ascunse în timpul funcționării.
Patroni
Deci, cum funcționează Patroni? Dezvoltatorii nu au reinventat roata și au propus să folosească ca bază una dintre soluțiile DCS verificate. Toate întrebările legate de sincronizarea configurațiilor, alegerea liderului și cvorumul sunt lăsate în seama acestuia. Am ales pentru asta etcd.
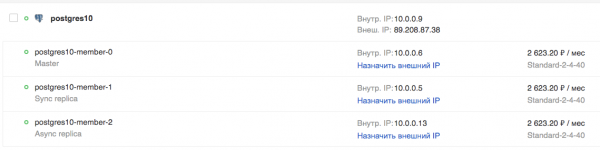
După aceea, Patroni se ocupă de aplicarea corectă a tuturor setărilor pentru PostgreSQL și de configurarea replicării, precum și de execuția comenzilor pentru switchover și failover (adică – comutarea normală și anormală a masterului). Concret, în cloud-ul MCS, se poate crea un cluster format dintr-un master, o replică sincronă și una sau mai multe replici asincrome. Prezența replicii sincrone asigură integritatea datelor pe cel puțin 2 servere, iar această replică va fi principalul „candidat pentru master”.
Având în vedere că etcd se desfășoară pe aceleași servere, se recomandă un număr de 3 sau 5 servere pentru a obține o valoare optimă a cvorumului. Acest cluster este scalabil orizontal pentru citire (am scris mai sus despre scalarea pentru scriere). Totuși, trebuie avut în vedere că replicile asincrome pot avea întârzieri, mai ales în condiții de sarcină ridicată.
Utilizarea acestor replici pentru citire (hot standby) este justificată pentru sarcini de raportare sau analiză și reduce sarcina serverului master.
Dacă doriți să creați un astfel de cluster pe cont propriu, va trebui să:
- pregătiți 3 sau mai multe servere, să configurați adresele IP și regulile firewall între ele;
- să instalați pachetele necesare pentru serviciile etcd, Patroni, PostgreSQL;
- să configurați clusterul etcd;
- să configurați serviciul Patroni pentru a funcționa cu PostgreSQL.
Adică, în total, trebuie să compunem corect o duzină de fișiere de configurare fără a greși. Pentru aceasta, merită să folosim un instrument de gestionare a configurațiilor, cum ar fi Ansible, de exemplu. Cu toate acestea, aici lipsește un balancer TCP de înaltă disponibilitate. Crearea lui este o muncă separată.
Pentru cei care au nevoie de un cluster gata, dar nu doresc să se ocupe de toate detaliile, am încercat să le simplificăm viața și am realizat un cluster gata pe Patroni în cloudul nostru, care poate fi testat gratuit. Pe lângă cluster, am realizat:
- Un balancer TCP; pe diferite porturi, acesta indică întotdeauna către masterul actual, respectiv replica sincronă sau asincronă;
- API pentru comutarea masterului activ Patroni.
Acestea pot fi conectate atât prin API-ul cloudului MCS, cât și prin consola web.
Demo
Pentru a testa capabilitățile clusterului PostgreSQL în cloudul MCS, să vedem cum se va comporta o aplicație activă în cazul unor probleme cu SGBD-ul.
Mai jos este prezentat codul aplicației, care va înregistra evenimente artificiale și va raporta despre acestea pe ecran. În caz de erori, va raporta și va continua să funcționeze în buclă, până când îl oprim cu combinația Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Conexiune deschisă la", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Valoare înregistrată, număr total: {}".format(record[0]))
    except Exception as error:
        print ("Eroare la conectarea la PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Conexiunea a fost închisă")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Eroare prinsă:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("iesire")
Aplicația are nevoie de PostgreSQL pentru a funcționa. Vom crea un cluster în cloudul MCS, folosind API-ul. Într-un terminal obișnuit, unde în variabila OS_TOKEN se află tokenul pentru accesarea API-ului (poate fi obținut cu comanda openstack token issue), vom introduce comenzile:
Creăm clusterul:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
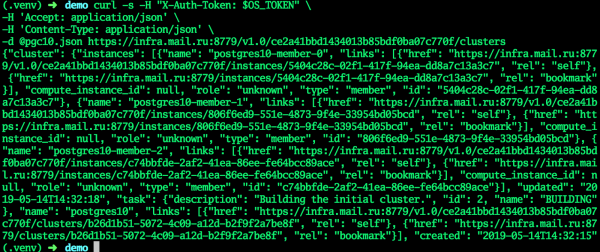
Când clusterul devine activ, toate câmpurile vor primi valorile actuale - clusterul este gata.
În GUI:
Să încercăm să ne conectăm și să creăm un tabel:
psql -h 89.208.87.38 -U admin -d myproddb
Parolă pentru utilizatorul admin:
psql (11.1, server 10.7)
Tip "help" pentru ajutor.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rows)

myproddb=>
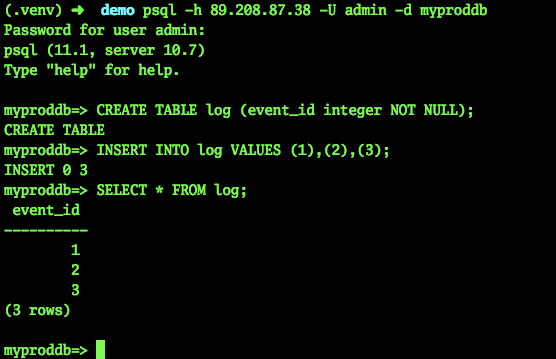
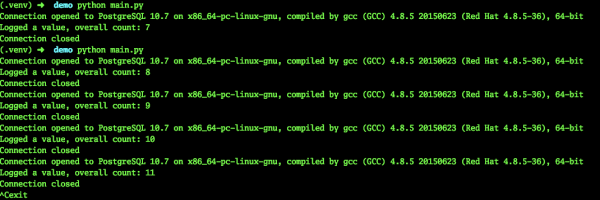
În aplicație, vom specifica setările actuale pentru conectarea la PostgreSQL. Vom indica adresa TCP a balance-ului, eliminând astfel necesitatea de a comuta manual pe adresa principală. Vom lansa aplicația. După cum se vede, evenimentele se înregistrează cu succes în baza de date.
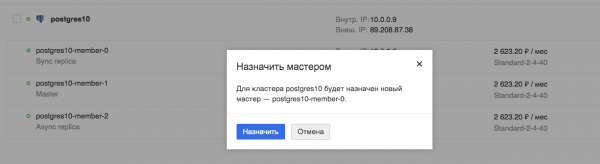
Comutare programată a masterului
Acum să testăm funcționarea aplicației noastre în timpul comutării programate a masterului:
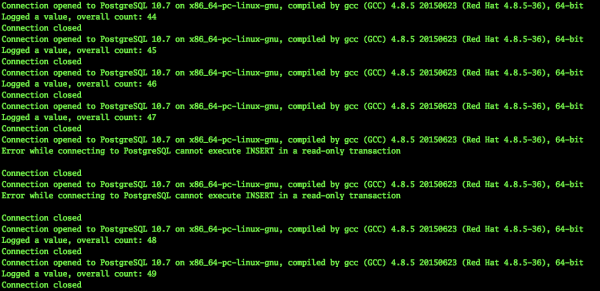
Observăm aplicația. Vedem că funcționarea acesteia este într-adevăr întreruptă, dar durează doar câteva secunde, în acest caz, maxim 9.
Căderea mașinii
Acum să încercăm să simulăm căderea mașinii virtuale, a masterului curent. Am fi putut pur și simplu să o oprim prin interfața Horizon, dar aceasta ar fi fost o oprire normală. Această comutare va fi procesată de toate serviciile, inclusiv Patroni.
Noi avem nevoie de o oprire imprevizibilă. De aceea, am cerut administratorilor noștri să oprească mașina virtuală - masterul curent - într-un mod neprotocolar, în scopuri de testare.
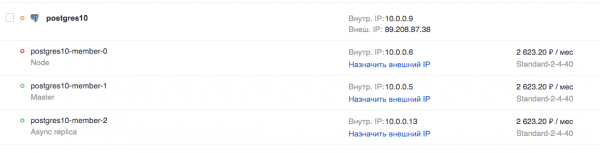
În același timp, aplicația noastră continua să funcționeze. Evident, o astfel de comutare de urgență a masterului nu poate rămâne neobservată.
2019-03-29 10:45:56.071234
Conexiune deschisă la PostgreSQL 10.7 pe x86_64-pc-linux-gnu, compilat de gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
A fost înregistrată o valoare, numărul total: 453
Conexiune închisă
2019-03-29 10:45:59.205463
Conexiune deschisă la PostgreSQL 10.7 pe x86_64-pc-linux-gnu, compilat de gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
A fost înregistrată o valoare, numărul total: 454

Conexiune închisă
2019-03-29 10:46:02.661440
Eroare la conectarea la serverul PostgreSQL, conexiunea a fost închisă neașteptat
        Aceasta probabil înseamnă că serverul a fost terminat anormal
        înainte sau în timp ce procesa cererea.

Eroare prinsă:
 variabila locală 'connection' referită înainte de atribuție
……………………………………………………….. - aici este un anumit număr de erori
2019-03-29 10:46:30.930445
Eroare la conectarea la serverul PostgreSQL, conexiunea a fost închisă neașteptat
        Aceasta probabil înseamnă că serverul a fost terminat anormal
        înainte sau în timp ce procesa cererea.

Eroare prinsă:
 variabila locală 'connection' referită înainte de atribuție
2019-03-29 10:46:31.954399
Conexiune deschisă la PostgreSQL 10.7 pe x86_64-pc-linux-gnu, compilat de gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
A fost înregistrată o valoare, numărul total: 455
Conexiune închisă
2019-03-29 10:46:35.409800
Conexiune deschisă la PostgreSQL 10.7 pe x86_64-pc-linux-gnu, compilat de gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
A fost înregistrată o valoare, numărul total: 456
Conexiune închisă
^Cexit
După cum se poate observa, aplicația a reușit să își continue activitatea în mai puțin de 30 de secunde. Da, un anumit număr de utilizatori ai serviciului vor observa problemele. Cu toate acestea, aceasta este o defecțiune gravă a serverului, care nu se întâmplă frecvent. În plus, un administrator nu ar reuși să reacționeze la fel de rapid, cu excepția cazului în care ar fi stat la consolă pregătit cu un script de comutare.
Ieșire
Din punctul meu de vedere, un astfel de cluster oferă un avantaj uriaș pentru administratori. În esență, defecțiunile grave și opririle serverelor de baze de date nu vor fi vizibile pentru aplicație și, prin urmare, pentru utilizator. Nu va fi necesar să reparăm ceva în grabă și să schimbăm configurații temporare, servere, etc. Iar dacă o astfel de soluție este utilizată sub formă de serviciu gata în cloud, nu va trebui să pierdem timp cu pregătirea ei. Vom putea să ne ocupăm de ceva mai interesant.
Sursa: habr.com
