

Mă numesc Pavel Parchomenko, sunt dezvoltator ML. În acest articol, aș dori să vă povestesc despre structura serviciului Yandex Zen și să împărtășesc îmbunătățirile tehnice implementate, care au crescut calitatea recomandărilor. Din acest post veți învăța cum, în doar câteva milisecunde, să găsiți printre milioane de documente cele mai relevante pentru utilizator; cum să realizați o descompunere continuă a unei matrice mari (formată din milioane de coloane și zeci de milioane de rânduri), astfel încât documentele recente să primească vectorii lor în câteva zeci de minute; cum să reutilizați descompunerea matricei utilizator-articol pentru a obține o bună reprezentare vectorială pentru videoclipuri.
Baza noastră de recomandări conține milioane de documente de diferite formate: articole text create pe platforma noastră și luate de pe site-uri externe, videoclipuri, narațiuni și postări scurte. Dezvoltarea unui astfel de serviciu este asociată cu numeroase provocări tehnice. Iată câteva dintre ele:
- Împărțirea sarcinilor de calcul: toate operațiile grele să fie efectuate offline, iar în timp real să se facă doar aplicarea rapidă a modelului, astfel încât să se răspundă în 100-200 ms.
- Considerarea rapidă a acțiunilor utilizatorului. Pentru aceasta, este necesar ca toate evenimentele să fie livrate instantaneu în recomandator și să influențeze rezultatul modelelor.
- Crearea unui feed care să se adapteze rapid comportamentului utilizatorilor noi. Persoanele care tocmai au intrat în sistem trebuie să simtă că feedback-ul lor influențează recomandările.
- Să înțelegem rapid cui să-i recomandăm un nou articol.
- Să reacționăm eficient la apariția constantă de conținut nou. Zeci de mii de articole sunt publicate în fiecare zi, iar multe dintre ele au un termen de valabilitate limitat (să zicem, știri). Aceasta este diferența lor față de filme, muzică și alte tipuri de conținut durabil și scump de creat.
- Transferarea cunoștințelor dintr-un domeniu de activitate în altul. Dacă în sistemul de recomandări există modele antrenate pentru articole text și adăugăm videoclipuri, putem reutiliza modelele existente pentru a îmbunătăți clasificarea conținutului de tip nou.
Voi explica cum am abordat aceste provocări.
Selecția candidaților
Cum putem reduce în câteva milisecunde numărul documentelor analizate de mii de ori, fără a afecta semnificativ calitatea clasificării?
Să presupunem că am antrenat multe modele ML, am generat caracteristici pe baza lor și am antrenat un alt model care clasifică documentele pentru utilizator. Totul ar fi bine, dar nu putem pur și simplu să calculăm toate caracteristicile pentru toate documentele în timp real, dacă există milioane de aceste documente, iar recomandările trebuie generate în 100-200 ms. Sarcina este de a selecta un subset din milioane, care va fi clasificat pentru utilizator. Această etapă este de obicei denumită selectarea candidaților. Iată câteva cerințe pentru această etapă. În primul rând, selecția trebuie să se desfășoare foarte rapid, astfel încât să rămână cât mai mult timp pentru clasificare. În al doilea rând, prin reducerea semnificativă a numărului de documente pentru clasificare, trebuie să păstrăm cât mai complet documentele relevante pentru utilizator.
Principiul nostru de selecție a candidaților a evoluat treptat și în prezent am ajuns la un sistem în mai multe etape:
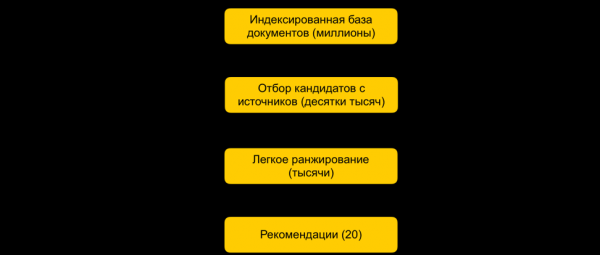
La început, toate documentele sunt împărțite în grupuri și din fiecare grup se aleg cele mai populare documente. Grupurile pot fi site-uri, teme, clustere. Pentru fiecare utilizator, pe baza istoricului său, se aleg grupurile care îi sunt cele mai apropiate și din acestea se aleg cele mai bune documente. De asemenea, folosim un index kNN pentru a selecta în timp real documentele cele mai apropiate utilizatorului. Există mai multe metode de constructie a indexului kNN, iar la noi cel mai bine a funcționat (Grafuri Ierarhice Navigabile de Mică Lume). Aceasta este un model ierarhic care permite găsirea celor mai apropiate N vectori pentru utilizator dintr-o bază de date de milioane. Prealabil, indexăm offline toată baza noastră de documente. Deoarece căutarea în index funcționează destul de rapid, putem crea mai multe indecși (câte unul pentru fiecare embedding) și să ne adresăm fiecăruia dintre ei în timp real.
Avem zeci de mii de documente disponibile pentru fiecare utilizator. Acesta rămâne încă o provocare pentru a calcula toate caracteristicile, așa că în această etapă aplicăm o clasificare ușoară - un model simplificat al unei clasificări grele cu un număr mai mic de caracteristici. Scopul este de a prezice care documente vor ocupa primele poziții în modelul greu. Documentele cu cele mai mari predicții vor fi utilizate în modelul greu, adică în ultima etapă de clasificare. Această abordare permite reducerea în câteva zeci de milisecunde a bazei de documente considerate pentru utilizator de la milioane la mii.
Pasul ALS în timp real
Cum să luăm în considerare feedback-ul utilizatorului imediat după clic?
Un factor important în recomandări este timpul de reacție la feedback-ul utilizatorului. Acest lucru este deosebit de important pentru utilizatorii noi: atunci când o persoană începe să utilizeze sistemul de recomandare, ea primește un feed diversificat de documente. Odată ce face primul clic, este esențial să luăm imediat în considerare acest lucru și să ne adaptăm la interesele sale. Dacă toate factorii sunt calculați offline, reacția rapidă a sistemului va deveni imposibilă din cauza întârzierii. Așadar, este necesar să procesăm în timp real acțiunile utilizatorului. Pentru aceste scopuri, folosim pasul ALS în timp real pentru a construi o reprezentare vectorială a utilizatorului.
Să presupunem că avem o reprezentare vectorială pentru toate documentele. De exemplu, putem construi embedding-uri offline pe baza textului articolului utilizând ELMo, BERT sau alte modele de învățare automată. Cum putem obține o reprezentare vectorială a utilizatorilor în același spațiu pe baza interacțiunii lor cu sistemul?
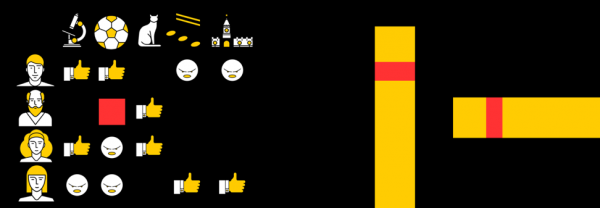
Principiul general de formare și descompunere a matricei utilizator-documentSă presupunem că avem m utilizatori și n documente. Pentru unii utilizatori, se cunoaște relația lor cu anumite documente. Atunci, aceste informații pot fi reprezentate sub formă de matrice m x n: rândurile corespund utilizatorilor, iar coloanele — documentelor. Deoarece majoritatea documentelor nu au fost vizualizate de utilizatori, majoritatea celulelor matricei vor rămâne goale, iar altele vor fi completate. Fiecare eveniment (like, dislike, click) din matrice are un anumit valoare — dar să luăm în considerare un model simplificat, în care un like corespunde cu 1, iar un dislike –1.
Să descompunem matricea în două: P (m x d) și Q (d x n), unde d — dimensionalitatea reprezentării vectoriale (de obicei, un număr mic). Astfel, fiecărui obiect îi va corespunde un vector de dimensiune d (utilizatorului — un rând în matricea P, documentului — o coloană în matricea Q). Aceste vectoare vor fi embedding-urile obiectelor respective. Pentru a prezice dacă utilizatorului îi va plăcea un document, putem pur și simplu să-i înmulțim embedding-urile.
Una dintre metodele posibile de descompunere a matricei este ALS (Alternating Least Squares). Vom optimiza următoarea funcție de pierdere:

Aici rui este interacțiunea utilizatorului u cu documentul i, qi este vectorul documentului i, iar pu este vectorul utilizatorului u.
Atunci, vectorul optim în termeni de eroare pătratică medie al utilizatorului (având vectorii documentelor fixați) se găsește analitic prin rezolvarea regresiei liniare corespunzătoare.
Acesta se numește „pasul ALS”. Iar algoritmul ALS constă în faptul că alternăm între a fixa una dintre matrice (utilizatorii și articolele) și a actualiza cealaltă, găsind soluția optimă.
Din fericire, găsirea reprezentării vectoriale a utilizatorului este o operație destul de rapidă, pe care o putem face în timpul execuției, folosind instrucțiuni vectoriale. Această tehnică permite să luăm imediat în considerare feedback-ul utilizatorului în clasificare. Același embedding poate fi folosit și în indexul kNN pentru a îmbunătăți selecția candidaților.
Filtrare colaborativă distribuită
Cum să facem factorizarea incrementală a matricei distribuite și să găsim rapid reprezentarea vectorială a noilor articole?
Conținutul nu este singura sursă de semnale pentru recomandări. O altă sursă importantă este informația colaborativă. Semnalele bune pentru clasificare pot fi obținute tradițional din descompunerea matricei utilizator-document. Însă, când am încercat să facem această descompunere, ne-am confruntat cu probleme:
1. Avem milioane de documente și zeci de milioane de utilizatori. Matricea nu încap pe o singură mașină și descompunerea va dura foarte mult.
2. La majoritatea conținutului din sistem, timpul de viață este scurt: documentele rămân relevante doar câteva ore. Prin urmare, este necesar să construim cât mai repede o reprezentare vectorială a acestora.
3. Dacă realizăm descompunerea imediat după publicarea documentului, nu va avea suficiente evaluări din partea utilizatorilor. De aceea, reprezentarea sa vectorială va fi, cu mare probabilitate, nu foarte bună.
4. Dacă un utilizator a dat un like sau un dislike, nu vom putea lua imediat acest lucru în considerare în descompunere.
Pentru a rezolva problemele enumerate, am implementat o descompunere distribuită a matricei utilizator-document cu actualizări incrementale frecvente. Cum funcționează aceasta?
Să presupunem că avem un cluster de N mașini (N se contabilizează în sute) și dorim să facem o descompunere distribuită a matricei care nu încap pe o singură mașină. Întrebarea este - cum se poate efectua această descompunere astfel încât, pe de o parte, fiecare mașină să aibă suficiente date și, pe de altă parte, calculele să fie independente?
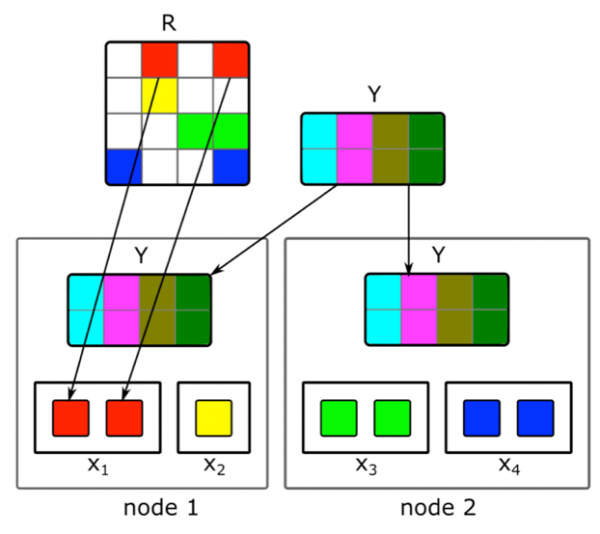
Vom folosi algoritmul de descompunere ALS descris mai sus. Să vedem cum se poate efectua distribuția unui pas ALS - celelalte pași vor fi similare. Să presupunem că avem matricea documentelor fixată și dorim să construim matricea utilizatorilor. Pentru aceasta, vom împărți matricea în N părți pe rânduri, fiecare parte având un număr aproximativ egal de rânduri. Vom trimite către fiecare mașină celulele necompletate corespunzătoare rândurilor, precum și matricea embeddingurilor documentelor (în întregime). Deoarece aceasta nu are o dimensiune foarte mare, iar matricea utilizator-document este de obicei foarte rară, aceste date vor încăpea pe o mașină obișnuită.
Această tehnică poate fi repetată pe parcursul mai multor epoci până la convergența modelului, schimbând alternativ matricea fixată. Dar chiar și atunci, descompunerea matricei poate dura câteva ore. Și acest lucru nu rezolvă problema că trebuie să obținem rapid embedding-uri pentru documentele noi și să actualizăm embedding-urile celor care au avut puține informații în timpul construirii modelului.
Ne-a ajutat implementarea unei actualizări incrementale rapide a modelului. Să presupunem că avem un model antrenat curent. De la antrenarea sa, au apărut articole noi cu care utilizatorii noștri au interacționat, precum și articole care au avut puțină interacțiune în timpul antrenamentului. Pentru a obține rapid embedding-uri pentru aceste articole, folosim embedding-uri de utilizatori obținute în timpul primei antrenări mari a modelului și facem un pas ALS pentru a calcula matricea documentelor cu matricea utilizatorilor fixată. Acest lucru permite obținerea embedding-urilor destul de rapid — în câteva minute după publicarea documentului — și actualizarea frecventă a embedding-urilor documentelor recente.
Pentru ca acțiunile unei persoane să fie luate în considerare imediat în recomandări, în timpul rulării nu folosim embedding-uri de utilizatori obținute în offline. În schimb, facem un pas ALS și obținem vectorul actualizat al utilizatorului.
Transfer pe un alt domeniu
Cum să utilizăm feedback-ul utilizatorului pe articolele text pentru a construi o reprezentare vectorială a videoclipurilor?
Inițial, recomandam doar articole text, așa că multe dintre algoritmii noștri sunt adaptați pentru acest tip de conținut. Dar la adăugarea de conținut de alt tip, ne-am confruntat cu necesitatea adaptării modelelor. Cum am abordat această problemă în cazul videoclipurilor? Una dintre opțiuni este să reantrenăm toate modelele de la zero. Dar aceasta durează mult, iar unele algoritmi sunt pretențioși în ceea ce privește volumul setului de antrenament, care nu există în cantitatea necesară pentru conținutul nou în primele momente ale vieții sale pe serviciu.
Am ales o abordare diferită și am reutilizat modelele de texte pentru video. În crearea reprezentărilor vectoriale ale video-urilor, ne-a ajutat același truc cu ALS. Am luat reprezentarea vectorială a utilizatorilor bazată pe articolele textuale și am făcut un pas ALS, folosind informațiile despre vizionările video. Astfel, am obținut fără dificultate reprezentarea vectorială a video-urilor. Iar în timpul execuției, calculăm pur și simplu apropierea dintre vectorul utilizatorului, obținut pe baza articolelor textuale, și vectorul video.
Concluzie
Dezvoltarea nucleului sistemului de recomandare în timp real este însoțită de multe provocări. Este necesar să procesăm rapid datele și să aplicăm metode ML pentru a utiliza eficient aceste date; să construim sisteme distribuite complexe capabile să proceseze semnalele utilizatorilor și noile unități de conținut în cel mai scurt timp; și multe alte sarcini.
În sistemul actual, a cărui structură o descriu, calitatea recomandărilor pentru utilizator crește odată cu activitatea sa și durata petrecută pe serviciu. Dar, desigur, aceasta este și principala dificultate: sistemul are dificultăți în a înțelege imediat interesele unei persoane care a interacționat puțin cu conținutul. Îmbunătățirea recomandărilor pentru utilizatorii noi este sarcina noastră principală. Vom continua să optimizăm algoritmii, astfel încât conținutul relevant pentru utilizator să ajungă mai repede în feed-ul său, iar cel mai puțin relevant să nu fie afișat.
Sursa: habr.com
