

Mă numesc Anton Baderin. Lucrez la Centrul de Tehnologii Avansate și mă ocup de administrarea sistemelor. Cu o lună în urmă, s-a desfășurat conferința noastră corporate, unde am împărtășit experiența acumulată cu comunitatea IT din orașul nostru. Am vorbit despre monitorizarea aplicațiilor web. Materialul era destinat nivelului junior sau middle, care nu au construit acest proces de la zero.
Piatra de temelie pe care se bazează orice sistem de monitorizare este rezolvarea problemelor de business. Monitorizarea pentru simpla existență a acesteia nu interesează pe nimeni. Ce își dorește business-ul? Ca totul să funcționeze rapid și fără erori. Business-ul vrea proactivitate, să identificăm noi problemele în funcționarea serviciului și să le remediem cât mai repede. Acesta este, de fapt, scopul pe care l-am urmărit tot anul trecut în proiectul unuia dintre clienții noștri.
Despre proiect
Proiectul este unul dintre cele mai mari programe de loialitate din țară. Ajutăm rețelele de retail să crească frecvența vânzărilor prin diferite instrumente de marketing, cum ar fi cardurile de bonus. În total, proiectul cuprinde 14 aplicații, care funcționează pe zece servere.
În procesul de susținere a interviurilor, am observat de multe ori că administratorii nu abordează întotdeauna corect monitorizarea aplicațiilor web: încă multe dintre ei se limitează la metricile sistemului de operare, monitorizând sporadic serviciile.
În cazul meu, în spatele sistemului de monitorizare al clientului se afla Icinga. Aceasta nu rezolva problemele menționate mai sus. Adesea, clientul ne informa despre probleme și nu de puține ori ne lipseau datele pentru a ajunge la cauză.
În plus, era o înțelegere clară a lipsei de perspective pentru dezvoltarea ei ulterioară. Cred că cei care sunt familiarizați cu Icinga mă vor înțelege. Așadar, am decis să reproiectăm complet sistemul de monitorizare a aplicațiilor web în proiect.
Prometheus
Am ales Prometheus bazându-ne pe trei indicatori principali:
- Un număr imens de metrici disponibile. În cazul nostru, sunt 60 de mii. Desigur, trebuie menționat că majoritatea dintre ele nu le utilizăm (aproape 95%). Pe de altă parte, toate sunt relativ ieftine. Pentru noi, aceasta reprezintă o altă extremă, comparativ cu Icinga, pe care o foloseam anterior. În cazul acesteia, adăugarea de metrici era o durere specială: cele existente erau costisitoare (e suficient să ne uităm la sursele oricărui plugin). Orice plugin era un script în Bash sau Python, a căror execuție nu era ieftină din punct de vedere al resurselor consumate.
- Acest sistem consumă relativ puține resurse. Toate metricile noastre necesită 600 MB de memorie RAM, 15% dintr-un nucleu și câteva zeci de IOPS. Desigur, trebuie să rulăm exportatori de metrici, dar toți sunt scriși în Go și nu consumă mult. Nu cred că, în condițiile actuale, aceasta este o problemă.
- Oferă posibilitatea de a trece la Kubernetes. Având în vedere planurile clientului, alegerea este evidentă.
ELK
Anterior nu am colectat și procesat log-uri. Deficiențele sunt clare pentru toți. Am ales ELK deoarece aveam deja experiență cu acest sistem. Acum stocăm doar log-urile aplicațiilor. Criteriile principale de selecție au fost căutarea text complet și viteza acesteia.
Clickhouse
La început, alegerea a fost InfluxDB. Eram conștienți de necesitatea de a colecta log-urile Nginx, statisticile din pg_stat_statements, stocarea datelor istorice în Prometheus. Influx nu ne-a plăcut, deoarece, din când în când, începea să consume multă memorie și se prăbușea. În plus, ne-ar fi plăcut să grupăm cererile după remote_addr, iar gruparea în acest SGBD era posibilă doar după etichete. Etichetele sunt scumpe (memorie), iar numărul lor este condiționat limitat.
Am reînceput căutările. Aveam nevoie de o bază analitică cu un consum minim de resurse, de preferat cu compresie a datelor pe disc.
Clickhouse satisface toate aceste criterii și nu ne-am plâns niciodată de alegere. Nu scriem volume semnificative de date (aproximativ cinci mii de inserții pe minut).
NewRelic
NewRelic a fost istoric cu noi, deoarece a fost alegerea clientului. La noi este folosit ca APM.
Zabbix
Folosim Zabbix exclusiv pentru monitorizarea Black Box a diverselor API-uri.
Definirea abordării de monitorizare
Ne-am dorit să descompunem sarcina și, astfel, să sistematizăm abordarea monitorizării.
Pentru aceasta, am împărțit sistemul nostru în următoarele niveluri:
- «hardware» și VMS;
- sistemul de operare;
- serviciile de sistem, stiva de software;
- aplicația;
- logica de afaceri.
Avantajele acestei abordări:
- știm cine este responsabil pentru funcționarea fiecărui nivel și, în funcție de aceasta, putem trimite alerte;
- putem folosi structura în cazul în care este necesară suprimarea alertelor - ar fi ciudat să trimitem o alertă despre indisponibilitatea bazei de date atunci când întreaga mașină virtuală este indisponibilă.
Având în vedere că sarcina noastră este de a identifica abaterile în funcționarea sistemului, trebuie să definim un set de metrici pentru fiecare nivel, la care să ne concentrăm atunci când scriem reguli de alertare. Mai departe, vom trece prin nivelurile „VMS”, „Sistemul de operare” și „Serviciile de sistem, stiva de software”.
Mașini virtuale
Găzduire ne alocă procesor, disc, memorie și rețea. Și cu primele două am avut probleme. Așadar, metricile sunt:
Timpul de CPU furat - atunci când cumpărați o mașină virtuală pe Amazon (de exemplu, t2.micro), trebuie să înțelegeți că vi se alocă nu un nucleu întreg de procesor, ci doar o cotă din timpul său. Și când o epuizați, procesorul vă va fi furat.
Această metrică permite monitorizarea acestor momente și luarea de decizii. De exemplu, trebuie să treceți la un tarif mai performant sau să separați procesarea sarcinilor de fundal și cererile API în diferite server.
IOPS + timpul de așteptare CPU iowait - dintr-un motiv oarecare, multe servicii de găzduire în cloud nu oferă suficiente IOPS. Mai mult, un grafic cu IOPS scăzute nu este un argument pentru ei. De aceea, este important să colectați și CPU iowait. Cu această pereche de grafice - cu IOPS scăzute și așteptare mare de intrare-ieșire - deja puteți discuta cu furnizorul de găzduire și să rezolvați problema.
Sistem de operare
Metricile sistemului de operare:
- cantitatea de memorie disponibilă în %;
- activitatea utilizării swap: vmstat swapin, swapout;
- numărul de inode-uri disponibile și spațiul liber pe sistemul de fișiere în %
- încărcarea medie;
- numărul de conexiuni în stare tw;
- gradul de utilizare a tabelului conntrack;
- calitatea funcționării rețelei poate fi monitorizată cu ajutorul utilitarului ss, pachetul iproute2 - obținând din ieșirea acestuia indicatorul RTT al conexiunilor și grupând în funcție de destinație-port.
De asemenea, la nivelul sistemului de operare, avem o entitate numită procese. Este important să definim un set de procese în sistem care joacă un rol esențial în funcționarea sa. Dacă, de exemplu, aveți mai multe pgpool, atunci este necesar să colectați informații despre fiecare dintre ele.
Setul de metrici este următorul:
- CPU;
- memoria — în primul rând, residentă;
- IO — preferabil în IOPS;
- FileFd — deschise și limită;
- defecțiuni semnificative ale paginii — astfel veți putea înțelege ce proces se swap.
Întreaga monitorizare este desfășurată în Docker, pentru colectarea datelor despre metrici folosim Сadvisor. Pe celelalte mașini aplicăm process-exporter.
Servicii sistemice, stivă software
Fiecare aplicație are specificul său și este greu să se evidențieze un set anume de metrici.
Setul universal este:
- rata cererilor;
- numărul de erori;
- latența;
- saturație.
Cele mai evidente exemple de monitorizare la acest nivel sunt Nginx și PostgreSQL.
Cel mai solicitat serviciu din sistemul nostru este baza de date. În trecut, aveam destul de des probleme cu descoperirea activității bazei de date.
Am observat o încărcare mare pe discuri, dar logurile de lentitudine nu arătau nimic semnificativ. Această problemă am rezolvat-o cu ajutorul pg_stat_statements, o vedere care colectează statistici despre cereri.
Asta e tot ce trebuie adminului.
Construim grafice de activitate a cererilor pentru citire și scriere:
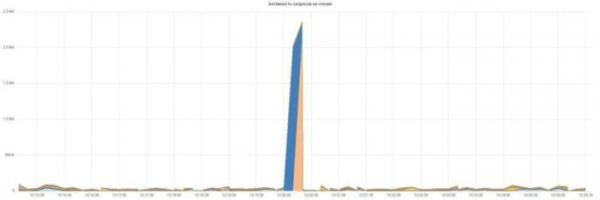
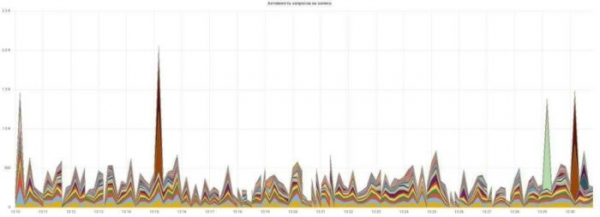
Totul este simplu și clar, fiecare cerere are o culoare proprie.
Un alt exemplu relevant sunt logurile Nginx. Nu este surprinzător că puțini le parsează sau le menționează în lista obligatoare. Formatul standard nu este foarte informativ și trebuie extins.
Personal, am adăugat request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Construim grafice de timp de răspuns și număr de erori:
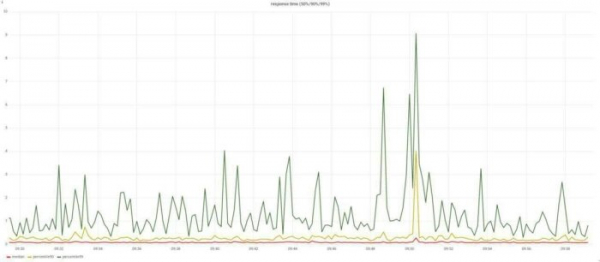
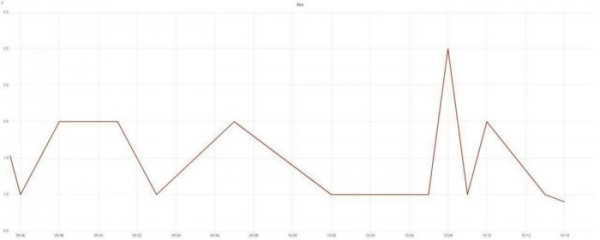
Construim grafice de timp de răspuns și număr de erori. Îți amintești? Am vorbit despre sarcinile business-ului? Să fie rapide și fără erori? Aceste întrebări le-am închis deja cu două grafice. Și după ele, deja putem suna administratorii de serviciu.
Dar a mai rămas o problemă — asigurarea unei remedieri rapide a cauzelor incidentelor.
Remedierea incidentelor
Întregul proces, de la identificarea la soluționarea problemei, poate fi împărțit în mai mulți pași:
- identificarea problemei;
- notificarea administratorului de serviciu;
- reacția la incident;
- remedierea cauzelor.
Este important să facem acest lucru cât mai repede. Și dacă la etapele de identificare a problemei și trimiterea notificării nu putem câștiga mult timp — două minute vor fi necesare în orice caz, etapa următoare este pur și simplu un teritoriu neexplorat pentru îmbunătățiri.
Să presupunem că telefonul de serviciu sună. Ce va face? Va căuta răspunsuri la întrebările — ce s-a defectat, unde s-a defectat, cum să reacționeze? Iată cum răspundem la aceste întrebări:
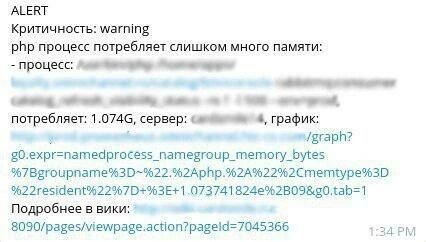
Pur și simplu includem toate aceste informații în textul notificării, oferind un link către pagina wiki care descrie cum să reacționezi la această problemă, cum să o rezolvi și să o escaladezi.
Încă nu am spus nimic despre nivelul aplicației și logica de afaceri. Din păcate, aplicațiile noastre nu au implementat încă colectarea metrice. Singura sursă de informații de la aceste niveluri sunt jurnalele.
Câteva lucruri.
În primul rând, scrieți chei de jurnal structurate. Nu includeți contextul în textul mesajului. Acest lucru îngreunează gruparea și analiza. Logstash necesită mult timp pentru a normaliza totul.
În al doilea rând, folosiți corect nivelurile de severitate. Fiecare limbaj are propriul standard. Personal, evidențiez patru niveluri:
- nu există erori;
- eroare de partea clientului;
- eroare de partea noastră, nu pierdem bani, nu suportăm riscuri;
- eroare de partea noastră, pierdem bani.
În concluzie. Trebuie să ne străduim să construim monitorizarea bazată pe logica de afaceri. Trebuie să ne concentrăm pe monitorizarea aplicației în sine și să operăm cu metrice precum numărul de vânzări, numărul de înregistrări noi de utilizatori, numărul de utilizatori activi în acel moment etc.
Dacă întreaga dvs. afacere este un singur buton în browser, trebuie să monitorizați dacă acesta este apăsat, dacă funcționează corect. Tot restul nu contează.
Dacă nu aveți acest lucru, puteți încerca să recuperați informațiile din jurnalele aplicației, jurnalele Nginx etc., așa cum am făcut noi. Trebuie să fiți cât mai aproape de aplicație.
Metriile sistemului de operare sunt cu siguranță importante, dar nu sunt de interes pentru afaceri, nu suntem plătiți pentru acestea.
Sursa: habr.com
