

În ultimii câțiva ani, bazele de date cu serii temporale (Time-series databases) au evoluat de la un concept rar întâlnit (aplicat în mod special fie în sistemele deschise de monitorizare, legate de soluții specifice, fie în proiectele Big Data) la un „produs de consum de masă”. În Rusia, un mare merit pentru aceasta îl au Yandex și ClickHouse. Până în acel moment, dacă aveai nevoie să stochezi o cantitate mare de date cu serii temporale, trebuia fie să te obișnuiești cu necesitatea de a implementa un stivă Hadoop monstruoasă și de a-i oferi suport, fie să comunici cu protocoale specifice fiecărei sisteme.
Ar putea părea că în 2019, un articol despre ce TSDB ar trebui folosit ar consta doar dintr-o singură propoziție: „folosește pur și simplu ClickHouse”. Dar... există nuanțe.
Într-adevăr, ClickHouse se dezvoltă activ, baza utilizatorilor crește, iar suportul este furnizat cu multă seriozitate, dar oare nu am devenit prizonierii succesului public al ClickHouse-ului, care a eclipsat alte soluții poate mai eficiente/sigure?
La începutul anului trecut, am început să refacem propriul nostru sistem de monitorizare, iar în acest proces a apărut întrebarea alegerii unei baze potrivite pentru stocarea datelor. Despre istoria acestei alegeri vreau să povestesc aici.
Formularea problemei
În primul rând — o introducere necesară. De ce avem nevoie de un sistem de monitorizare propriu și cum era structurat?
Am început să oferim servicii de suport în 2008 și până în 2010 a devenit clar că agregarea datelor despre procesele din infrastructura clienților cu soluțiile existente la momentul respectiv a devenit dificilă (vorbim despre, Dumnezeule, Cacti, Zabbix și Graphite care abia începea să prindă contur).
Principalele noastre cerințe erau:
- suportul (la acel moment — zeci, iar pe viitor — sute) de clienți într-o singură sistemă și totodată existența unui sistem centralizat de gestionare a notificărilor;
- flexibilitatea în gestionarea sistemului de notificări (escaladarea notificărilor între angajați, gestionarea programului, baza de cunoștințe);
- posibilitatea de a detalia profund graficele (Zabbix la acel moment reda graficele sub formă de imagini);
- păstrarea pe termen lung a unei cantități mari de date (un an sau mai mult) și posibilitatea de a le extrage rapid.
În acest articol, ne interesează ultimul punct.
Vorbind despre stocare, cerințele au fost următoarele:
- sistemul trebuie să funcționeze rapid;
- ar fi de dorit ca sistemul să aibă o interfață SQL;
- sistemul trebuie să fie stabil și să aibă o bază de utilizatori activă și suport (odată ne-am confruntat cu necesitatea de a susține astfel de sisteme, cum ar fi MemcacheDB, care a fost abandonată, sau sistemul de stocare distribuit MooseFS, al cărui tracker de erori era în chineză: nu ne-am dorit să repetăm această poveste pentru proiectul nostru);
- respectarea teoremei CAP: Consistență (necesară) - datele trebuie să fie actuale, nu ne dorim ca sistemul de gestionare a alertelor să nu primească date noi și să emită alerte despre lipsa datelor pentru toate proiectele; Toleranță la partiții (necesară) - nu vrem să avem o situație de Separare a Creierului; Disponibilitate (nu critică, în cazul existenței unei replici active) - putem comuta noi înșine pe sistemul de rezervă în caz de urgență, prin cod.
Cumva, la acel moment, soluția ideală pentru noi s-a dovedit a fi MySQL. Structura noastră de date era extrem de simplă: id-ul serverului, id-ul contoarelor, timestamp și valoare; extragerea rapidă a datelor fierbinți era asigurată printr-o dimensiune mare a buffer pool-ului, iar extragerea datelor istorice - prin SSD.
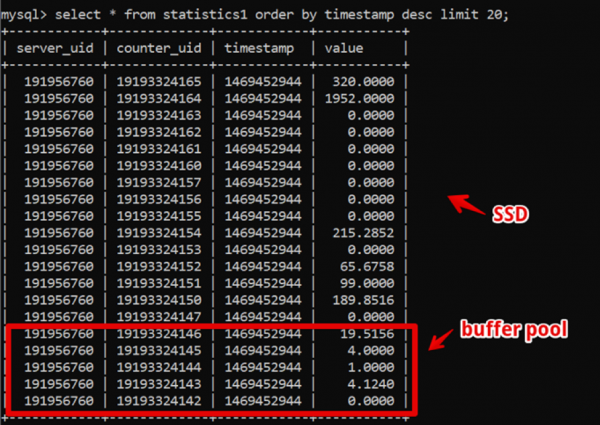
Astfel, am reușit să obținem extragerea datelor proaspete din ultimele două săptămâni, cu detalii până la secundă, în 200 ms înainte de momentul completării extragerii datelor, și am trăit în acest sistem o perioadă destul de lungă.
Între timp, timpul a trecut și volumul de date a crescut. Până în anul 2016, volumul de date a ajuns la zeci de terabiți, ceea ce reprezenta o cheltuială semnificativă în condițiile stocării SSD închiriate.
Până în acel moment, bazele de date coloanelor au câștigat popularitate, la care am început să ne gândim activ: în bazele de date coloanelor, datele sunt stocate, așa cum se poate înțelege, pe coloane, iar dacă ne uităm la datele noastre, putem observa o mare cantitate de duplicări care, în cazul utilizării unei baze de date pe coloane, ar putea fi comprimate.
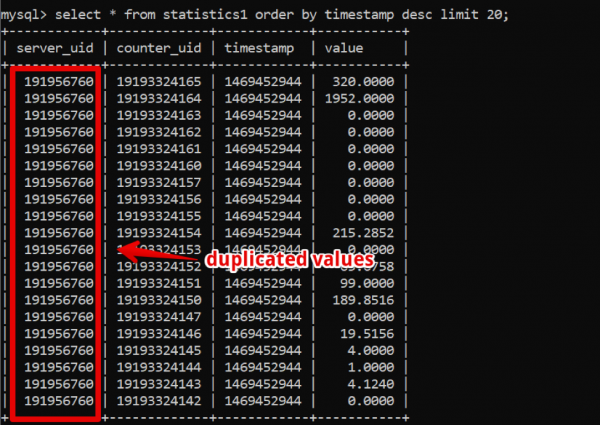
Cu toate acestea, sistemul cheie pentru activitatea companiei a continuat să funcționeze stabil, și nu ne-am dorit să experimentăm cu trecerea la altceva.
În 2017, la conferința Percona Live din San Jose, probabil pentru prima dată, dezvoltatorii Clickhouse s-au făcut remarcați. La prima vedere, sistemul părea să fie pregătit pentru producție (iar Yandex.Metrica este adevăratul mediu de producție), suportul era rapid și simplu, iar, cel mai important, exploatarea era ușoară. Din 2018, am început procesul de tranziție. Dar, până atunci, existau multe sisteme TSDB „mature” și testate în timp, iar noi am decis să dedicăm un timp semnificativ pentru a compara alternativele, pentru a ne asigura că nu există soluții alternative la Clickhouse, conform cerințelor noastre.
Pe lângă cerințele deja menționate, au apărut altele noi:
- noua sistemă ar trebui să ofere, cel puțin, aceeași performanță ca MySQL, pe aceeași configurație hardware;
- stocarea noii sisteme ar trebui să ocupe semnificativ mai puțin spațiu;
- DBMS-ul ar trebui să rămână simplu de gestionat;
- ne-am dorit să modificăm aplicația cât mai puțin posibil la schimbarea DBMS-ului.
Ce sisteme am început să analizăm
Apache Hive/Apache Impala
Un stac Hadoop testat în luptă. Practic, este o interfață SQL construită peste un sistem de stocare în formate proprietare pe HDFS.
Avantaje.
- În cazul unei exploatări stabile, datele sunt foarte ușor de scalat.
- Există soluții columnare pentru stocarea datelor (ocupă mai puțin spațiu).
- Execuția rapidă a sarcinilor paralele în prezența resurselor.
Minusuri.
- Este Hadoop și este complex de exploatat. Dacă nu suntem pregătiți să adoptăm o soluție gata preparată în cloud (și nu suntem din cauza costurilor), întregul stac va trebui să fie asamblat și întreținut manual de către administratori, iar acest lucru nu ne-ar plăcea deloc.
- Datele sunt agregate .
Cu toate acestea:
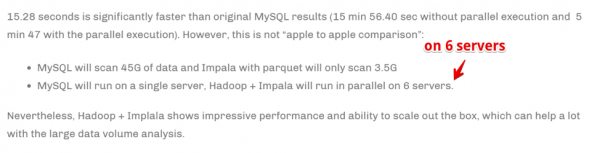
Viteza este atinsă prin scalarea numărului de servere de calcul. Cu alte cuvinte, dacă suntem o companie mare, ne ocupăm de analize și pentru afacerea noastră este critic să agregăm informațiile cât mai rapid posibil (chiar dacă acest lucru necesită utilizarea unei cantități mari de resurse de calcul) — acesta ar putea fi alegerera noastră. Dar nu eram pregătiți să creștem semnificativ parcul de echipamente pentru a spori viteza de execuție a sarcinilor.
Druid/Pinot
Acestea sunt deja mai specifice pentru TSDB, dar din nou — un stac Hadoop.
Există .
Dacă ar fi să spunem pe scurt: Druid/Pinot arată mai bine decât Clickhouse în cazurile când:
- Aveți un caracter heterogen al datelor (în cazul nostru, înregistrăm doar serii temporale ale metricelor serverelor și, practic, aceasta este o singură tabelă. Dar pot exista și alte cazuri: serii temporale de echipamente, serii temporale economice etc. — fiecare cu structura sa, care trebuie agregată și procesată).
- În același timp, aceste date sunt foarte multe.
- Tabelele și datele cu serii temporale apar și dispar (adică un set de date a sosit, a fost analizat și apoi s-a șters).
- Nu există un criteriu clar pe baza căruia datele pot fi partitionate.
În cazurile opuse, ClickHouse își arată mai bine abilitățile, iar acesta este cazul nostru.
ClickHouse
- Similar SQL.
- Ușor de gestionat.
- Oamenii spun că funcționează.
Apare pe lista scurtă de testare.
InfluxDB
O alternativă internațională la ClickHouse. Din dezavantaje: disponibilitatea ridicată este prezentă doar în versiunea comercială, dar trebuie comparat.
Apare pe lista scurtă de testare.
Cassandra
Pe de o parte, știm că este folosit pentru stocarea seriilor temporale de metrici de sisteme de monitorizare, cum ar fi, de exemplu, sau OkMeter. Totuși, există o specificitate.
Cassandra nu este o bază de date colunară în sensul obișnuit al termenului. Arată mai degrabă ca o bază de date pe rânduri, dar în fiecare rând poate exista un număr diferit de coloane, ceea ce facilitează organizarea unei reprezentări pe coloane. În acest sens, este clar că, având o limitare de 2 miliarde de coloane, se pot stoca unele date efectiv în coloane (ca aceleași serii temporale). De exemplu, în MySQL există o limitare de 4096 de coloane și acolo este ușor să te confrunți cu eroarea cu codul 1117, dacă încerci să faci același lucru.
Motorul Cassandra este orientat spre stocarea unor volume mari de date într-un sistem distribuit fără master, iar în teorema CAP menționată anterior, Cassandra tinde spre AP, adică spre disponibilitatea datelor și rezistența la partajarea partitionării. Astfel, acest instrument poate fi excelent pentru situațiile în care trebuie doar să scriem în această bază de date și să citim din ea destul de rar. În acest sens, este logic să folosim Cassandra ca „stocare rece”. Așadar, ca un loc fiabil de stocare pe termen lung pentru mari cantități de date istorice, care sunt necesare rar, dar care pot fi accesate la nevoie. Totuși, pentru a avea o imagine completă, să o testăm și pe ea. Dar, așa cum am menționat anterior, nu există dorința de a rescrie activ codul pentru soluția de bază de date aleasă, așa că o vom testa într-un mod oarecum limitat - fără a adapta structura bazei de date la specificul Cassandra.
Prometheus
În plus, din curiozitate, am decis să testăm performanța stocării Prometheus - pur și simplu pentru a înțelege dacă suntem mai rapizi decât soluțiile curente sau mai lent și în ce măsură.
Metodologia și rezultatele testării
Așadar, am testat 5 baze de date în următoarele 6 configurații: ClickHouse (1 nod), ClickHouse (tabel distribuit pe 3 noduri), InfluxDB, Mysql 8, Cassandra (3 noduri) și Prometheus. Planul de testare este următorul:
- încărcăm date istorice pentru o săptămână (840 milioane valori pe zi; 208 mii metri);
- generăm o sarcină de scriere (am analizat 6 moduri de sarcină, vezi mai jos);
- în paralel cu scrierea, facem periodic interogări, simulând cererile utilizatorului care lucrează cu grafice. Pentru a nu complica prea mult, am ales datele pentru 10 metri (exact câte sunt pe graficul CPU) pentru o săptămână.
Încărcăm, simulând comportamentul agentului nostru de monitorizare, care trimite valori pentru fiecare metrică la fiecare 15 secunde. În acest sens, ne interesează să variem:
- numărul total de metrici în care sunt scrise datele;
- intervalul de trimitere a valorilor către o metrică;
- dimensiunea batch-ului.
Despre dimensiunea batch-ului. Deoarece aproape toate bazele noastre de testare nu sunt recomandate să fie încărcate cu inserții unice, va fi necesar un relay care să colecteze metricile primite, să le grupeze în loturi și să le scrie în baza de date printr-un insert în batch.
De asemenea, pentru a înțelege mai bine cum să interpretăm datele obținute, să ne imaginăm că nu trimitem doar o mulțime de metrici, ci că metricile sunt organizate în servere — câte 125 de metrici pe server. Aici, serverul este pur și simplu o entitate virtuală — doar pentru a înțelege că, de exemplu, 10000 de metrici corespund aproximativ 80 de servere.
Iată, având în vedere toate acestea, cele 6 moduri de încărcare a bazelor de date pentru scriere:
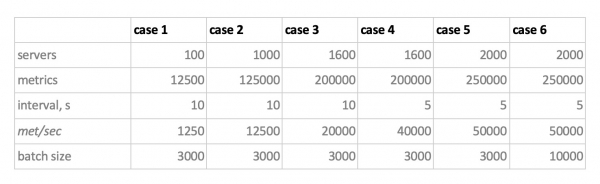
Există două aspecte aici. În primul rând, pentru Cassandra, aceste dimensiuni de batch-uri s-au dovedit a fi prea mari, acolo am folosit valori de 50 sau 100. În al doilea rând, deoarece Prometheus funcționează strict în modul pull, adică el însuși accesează și preia datele din sursele de metrici (iar pushgateway, în ciuda numelui, nu schimbă situația), încărcările corespunzătoare au fost realizate printr-o combinație de configurații statice.
Rezultatele testării sunt următoarele:
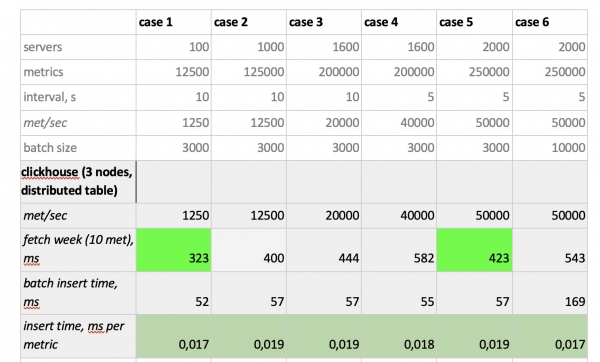
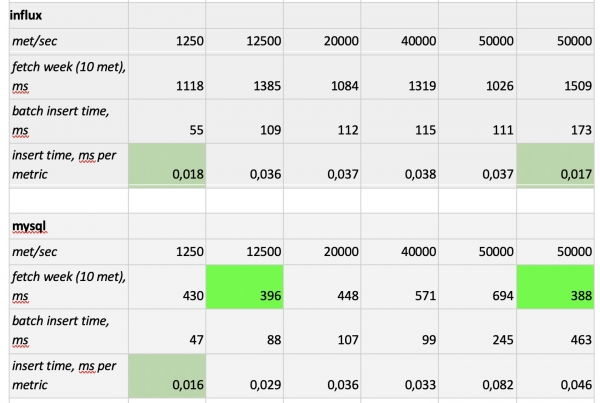
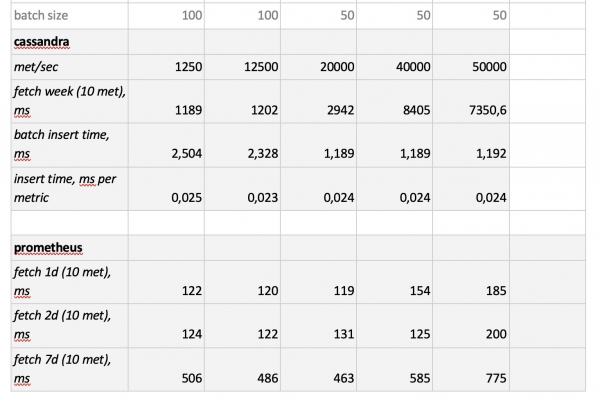
Ce merită menționat: selecții extrem de rapide din Prometheus, selecții exasperant de lente din Cassandra, selecții inacceptabil de lente din InfluxDB; pe viteza de scriere, ClickHouse a câștigat categoric, iar Prometheus nu participă la concurs, deoarece face inserții în interiorul său și nu măsurăm nimic.
În concluzie: ClickHouse și InfluxDB s-au comportat cel mai bine, dar un cluster de Influx poate fi construit doar pe baza versiunii Enterprise, care costă bani, în timp ce ClickHouse nu costă nimic și a fost creat în Rusia. Este logic că în SUA alegerea ar fi în favoarea InfluxDB, iar la noi — în favoarea ClickHouse.
Sursa: habr.com
