

Când munca ta constă în a crea ceva frumos, nu este nevoie să vorbești prea mult despre ea, pentru că rezultatul este vizibil pentru toți. Însă, dacă ștergi inscripții de pe garduri, munca ta nu este observată, decât atunci când gardurile arată bine sau până nu ștergi ceva ce nu ar fi trebuit.
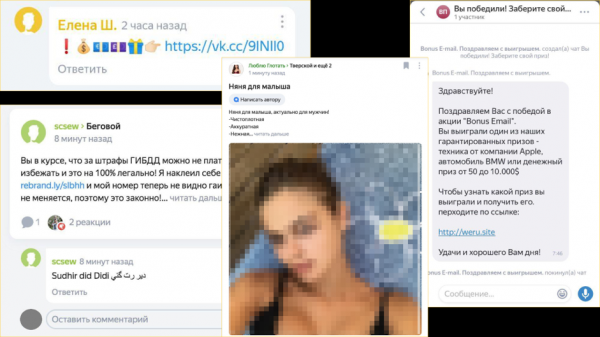
Orice serviciu în care poți lăsa un comentariu, o recenzie, trimite un mesaj sau încârcă imagini, mai devreme sau mai târziu se confruntă cu problema spamului, a fraudei și a limbajului vulgar. Acest lucru nu poate fi evitat, dar trebuie combătut.
Mă numesc Mihail, lucrez în echipa AntiSpam, care protejează utilizatorii serviciilor Yandex de astfel de probleme. Munca noastră este rar vizibilă (și bine!), așa că astăzi voi povesti mai în detaliu despre ea. Vei afla în ce situații moderarea este inutilă și de ce precizia nu este singurul indicator al eficienței acesteia. De asemenea, vom discuta despre obscenități folosind exemple cu pisici și câini și despre motivul pentru care uneori este util să 'gândești ca un obscen'.
În Yandex apar din ce în ce mai multe servicii în care utilizatorii publică conținutul lor. Poți pune o întrebare sau scrie un răspuns în Yandex.Q, discuta despre noutățile din zonă în Yandex.District, sau împărtăși informații despre trafic în conversațiile de pe Yandex.Maps. Dar pe măsură ce audiența serviciului crește, devine atractivă pentru fraude și spam. Aceștia vin și umplu comentariile: oferă câștiguri ușoare, promovează remedii miraculoase și promit plăți sociale. Din cauza spamului, unii utilizatori își pierd banii, iar alții își pierd dorința de a petrece timp pe un serviciu neîngrijit, plin de spam.
Și aceasta nu este singura problemă. Ne străduim să protejăm nu doar utilizatorii de fraude, ci și să creăm o atmosferă confortabilă pentru comunicare. Dacă oamenii se confruntă cu obscenități și insulte în comentarii, este foarte probabil că vor pleca și nu se vor mai întoarce. Asta înseamnă că trebuie să știm cum să combatem și acest aspect.
Web curat
Așa cum ne se întâmplă adesea, primele inițiative au apărut în Căutare, în acea parte care se ocupă de combaterea spamului în rezultatele căutării. Acum aproximativ zece ani, a apărut sarcina de a filtra conținutul pentru adulți pentru căutările destinate familiilor și pentru cererile care nu presupun răspunsuri din categoria 18+. Astfel au apărut primele dicționare de pornografie și vulgaritate, completate manual de analiști. Sarcina principală a fost clasificarea cererilor în cele unde era permis să se afișeze conținut pentru adulți și cele unde nu. Pentru această sarcină s-a colectat marcaj, s-au construit heuristici și s-au antrenat modele. Astfel au apărut primele inițiative pentru filtrarea conținutului nedorit.
În timp, Yandex a început să aibă UGC (conținut generat de utilizatori) — mesaje scrise de utilizatori înșiși, iar Yandex le publică doar. Din motivele descrise mai sus, multe mesaje nu putea fi publicate fără o verificare — era necesară moderarea. Atunci s-a decis să se facă un serviciu care să ofere protecție împotriva spamului și a răufăcătorilor pentru toate produsele UGC ale Yandex și să folosească inițiativele de filtrare a conținutului nedorit din Căutare. Serviciul a fost numit „Web Curat”.
Sarcini noi și ajutor din partea colaboratorilor
Inițial, am avut doar o automatizare simplă: serviciile ne trimiteau texte, iar noi le verificam cu dicționare de vulgaritate, dicționare de pornografie și expresii regulate — analiștii compilau totul manual. Dar, în timp, serviciul a fost aplicat într-un număr tot mai mare de produse Yandex, iar noi am fost nevoiți să învățăm să lucrăm cu probleme noi.
Adesea, utilizatorii publică o succesiune de litere fără sens în loc de recenzii, încercând să-și crească realizările; uneori își promovează compania în recenzii despre compania concurentă, iar alteori pur și simplu confundă organizațiile și în recenzia unei pet shop scriu: „Peștele a fost gătit splendid!”. Poate că, într-o bună zi, inteligența artificială va învăța să înțeleagă perfect sensul oricărui text, dar în prezent, automatizarea uneori se descurcă mai rău decât un om.
A devenit evident că fără etichetare manuală nu putem scăpa, așa că am adăugat o a doua etapă la sistemul nostru - trimiterea pentru verificare manuală de către o persoană. Aici ajungeau acele texte publicate pentru care clasificatorul nu a identificat probleme. Scara acestei sarcini o puteți imagina cu ușurință, așa că nu ne-am bazat doar pe evaluatori, ci am apelat și la „înțelepciunea mulțimii”, adică am cerut ajutorul tolokerilor. Aceștia ne ajută să identificăm ceea ce a ratat mașina, și astfel dau o lecție acesteia.
Cache inteligent și hashing LSH
O altă problemă cu care ne-am confruntat în gestionarea comentariilor a fost spamul, mai precis volumul și viteza de răspândire a acestuia. Când audiența Yandex.District a început să crească rapid, acolo au venit spammeri. Aceștia au învățat să ocolească regex-urile, schimbând ușor textul. Spam-ul, evident, era totuși detectat și șters, dar în dimensiunile Yandex-ului, un mesaj inacceptabil postat chiar și timp de 5 minute putea fi văzut de sute de persoane.
Acest lucru, evident, nu ne-a mulțumit, așa că am dezvoltat un caching inteligent al textelor bazat pe LSH (). Funcționează astfel: normalizăm textul, eliminăm linkurile și îl fragmentăm în n-gramuri (secvențe de n litere). Apoi calculăm hash-urile n-gramurilor și pe baza acestora construim vectorul LSH al documentului. Ideea este că texte asemănătoare, chiar dacă au fost ușor modificate, se transformă în vectori asemănători.
Această soluție a permis reutilizarea verdictelor clasificatorilor și tolokerilor pentru texte similare. În timpul atacurilor spam, de îndată ce primul mesaj trecea de verificare și era stocat în cache cu verdictul „spam”, toate mesajele similare noi, chiar și cele modificate, primeau același verdict și erau șterse automat. Ulterior, am învățat să instruim și să re-instruim automat clasificatorii de spam, dar acest „cache inteligent” a rămas cu noi și ne ajută adesea și astăzi.
Clasificatorul textelor bune
Nefiind timp să ne revenim după lupta cu spamul, ne-am dat seama că 95% din conținutul nostru este moderat manual: clasificatorii răspund doar la abateri, iar majoritatea textelor sunt bune. Angajăm specialiști care, în 95 din 100 de cazuri, oferă evaluarea „Totul OK”. A trebuit să ne ocupăm de o muncă mai puțin obișnuită — să creăm clasificatori pentru conținut de calitate, având în vedere că am acumulat suficientă etichetare în acest timp.
Primul clasificator arăta astfel: lemmatizăm textul (aducem cuvintele la forma lor de bază), eliminăm toate părțile de vorbire funcționale și aplicăm un „dicționar al lemmelor de calitate” pregătit anterior. Dacă toate cuvintele din text sunt „bune”, atunci întreg textul nu conține abateri. Pe diferite servicii, această abordare a dus la o automatizare de 25-35% din etichetarea manuală. Desigur, această abordare nu este perfectă: nu este greu să combinăm câteva cuvinte nevinovate și să obținem o afirmație foarte jignitoare, dar ne-a permis să atingem rapid un nivel bun de automatizare și ne-a dat timp să antrenăm modele mai complexe.
Versiunile următoare ale clasificatorilor de texte de calitate au inclus deja atât modele liniare, cât și arbori de decizie, și combinațiile lor. Pentru etichetarea vulgarităților și insultelor, de exemplu, încercăm rețeaua neuronală BERT. Aici este important să surprinzi semnificația cuvântului în context și relația dintre cuvinte din propoziții diferite, iar BERT se descurcă destul de bine cu acest lucru. (Apropo, recent colegii din știri , cum aplică tehnologia pentru o sarcină neobișnuită — căutarea erorilor în titluri.) În cele din urmă, am reușit să automatizăm până la 90% din flux, în funcție de serviciu.
Precizie, completitudine și viteză
Pentru a ne dezvolta, trebuie să înțelegem ce beneficii aduc diferitele clasificatoare automate, modificările acestora, precum și dacă calitatea verificărilor manuale nu se degradează. Pentru aceasta, aplicăm indicatorii de precizie și completitudine.
Precizia reprezintă proporția verdictelor corecte dintre toate verdicturile referitoare la conținutul inadecvat. Cu cât precizia este mai mare, cu atât mai puține falsuri. Dacă nu ne ocupăm de precizie, teoretic am putea elimina tot spamul și obscenitățile, dar, de asemenea, am elimina jumătate din mesajele bune. Pe de altă parte, dacă ne bazăm doar pe precizie, cea mai bună tehnologie ar fi aceea care nu prinde pe nimeni. Prin urmare, există și un alt indicator, completitudinea: proporția de conținut inadecvat identificat dintre tot volumul de conținut inadecvat. Aceste două metrici se echilibrează reciproc.
Pentru a măsura, luăm mostre din întreg fluxul de intrare pentru fiecare serviciu și oferim mostre de conținut evaluatorilor pentru a le evalua expert și a le compara cu soluțiile automate.
Dar există și un alt indicator important.
Mai sus am menționat că un mesaj inacceptabil poate fi văzut în decurs de 5 minute de sute de oameni. De aceea, numărăm câte ori am reușit să arătăm oamenilor conținut inadecvat înainte de a-l ascunde. Acest lucru este important, deoarece nu este suficient să lucrăm eficient - trebuie să lucrăm și rapid. Și atunci când am construit protecția împotriva obscenităților, am simțit acest lucru pe deplin.
Anti-obscenități pe baza exemplului pisicuțelor și cățeilor
O mică digresiune. Unii ar putea spune că obscenitățile și insultele nu sunt la fel de periculoase ca linkurile dăunătoare și nu sunt la fel de enervante ca spamul. Dar ne străduim să menținem condiții confortabile pentru comunicarea milioanelor de utilizatori, iar oamenii nu revin acolo unde sunt injurați. Nu degeaba, interzicerea obscenităților și insultele sunt stipulate în regulile multor comunități, inclusiv pe Habr. Dar ne-am abătut de la subiect.
Dicționarele obscenităților nu reușesc să surprindă toată bogăția limbii ruse. Chiar dacă există doar patru rădăcini obscene principale, din ele se pot formula nenumărate cuvinte, pe care nu le poți prinde cu expresii regulate. În plus, se poate scrie în transliterare o parte din cuvânt, înlocuind literele cu combinații asemănătoare, schimbând literele între ele, adăugând stele etc. Uneori, fără context, este imposibil să determinăm ce cuvânt obscen a avut în vedere utilizatorul. Respectăm regulile Habr, așa că vom demonstra acest lucru nu cu exemple reale, ci cu pisicuțe și căței.
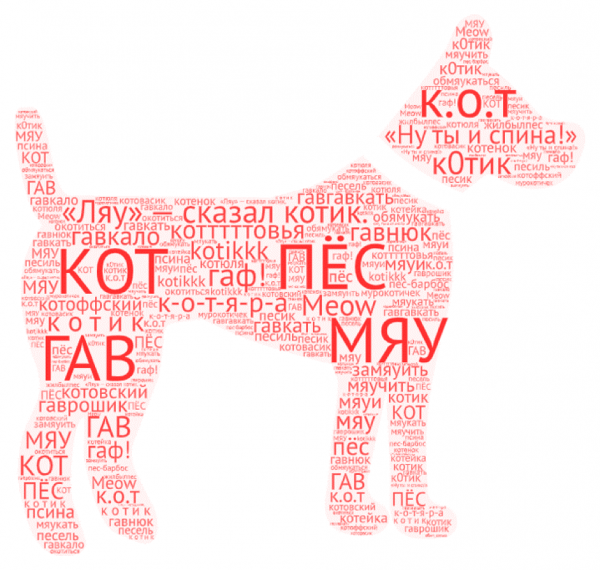
„Meow”, a spus pisicuța. Dar înțelegem că pisicuța a spus un alt cuvânt...
Am început să ne gândim la algoritmii de „potrivire fuzzy” din vocabularul nostru și la un proces de preprocesare mai inteligent: transformam transliterarea, uniuneam spațiile și punctuația, căutam modele și scriam expresii regulate separate pentru acestea. Această abordare a adus rezultate, dar a scăzut adesea precizia, fără a oferi completitudinea dorită.
Atunci am decis să „gândim ca o persoană vulgară”. Am început să introducem zgomot în date: am reorganizat literele, am generat greșeli de tipar, am înlocuit literele cu altele asemănătoare și așa mai departe. Am luat initiala etichetare aplicând dicționare de vulgaritate pe corpuri mari de texte. Dacă luăm o propoziție și o torturăm în mai multe moduri, obținem deja multe propoziții. Astfel putem să creștem setul de date de antrenament de zeci de ori. Rămânea doar să antrenăm pe acest set de date un model mai mult sau mai puțin inteligent care să țină cont de context.
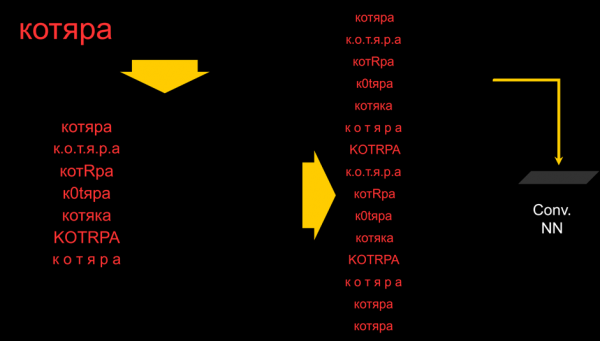
Este prea devreme să vorbim despre soluția finală. Încă experimentăm cu abordările acestei probleme, dar vedem deja că o rețea convoluțională simplă bazată pe caractere din mai multe straturi depășește semnificativ dicționarele și expresiile regulate: se poate crește atât precizia, cât și completitudinea.
Desigur, înțelegem că vor exista întotdeauna modalități de a ocoli chiar și cea mai avansată automatizare, mai ales când este o activitate atât de captivantă: a scrie astfel încât o mașină prostă să nu înțeleagă. Aici, la fel ca în lupta împotriva spamului, nu avem scopul de a eradica posibilitatea de a scrie ceva vulgarn, ci de a face ca jocul să nu merite efortul.
A deschide oportunitatea de a împărtăși opinii, de a comunica și de a comenta nu este greu. Mult mai dificil este să ajungi la condiții sigure, confortabile și la un respect reciproc între oameni. Fără acestea, nu va exista dezvoltare pentru nicio comunitate.
Sursa: habr.com
