

Nota traducătorului.: Vă prezentăm detalii tehnice despre cauzele recentei întreruperi a funcționării serviciului de cloud, administrat de creatorii Grafana. Acesta este un exemplu clasic despre cum o nouă caracteristică, care părea extrem de utilă, destinată să îmbunătățească infrastructura… poate cauza probleme dacă nu se iau în considerare multiplele nuanțe ale utilizării sale în medii de producție. Este minunat când apar materiale care permit învățarea nu doar din propriile greșeli. Detalii — în traducerea acestui text de la vicepreședintele de produs de la Grafana Labs.
Vineri, 19 iulie, serviciul Hosted Prometheus din Grafana Cloud a încetat să funcționeze timp de aproximativ 30 de minute. Ne cerem scuze tuturor clienților afectați de această întrerupere. Sarcina noastră este să furnizăm instrumentele necesare pentru monitorizare și înțelegem că lipsa acestora îngreunează viața dumneavoastră. Luăm acest incident foarte în serios. În această notă explicăm ce s-a întâmplat, cum am reacționat la aceasta și ce facem pentru a evita ca un astfel de incident să se repete.
Povestea
Serviciul Grafana Cloud Hosted Prometheus se bazează pe — proiectul CNCF pentru crearea unui serviciu Prometheus scalabil horizontal, disponibil în mod înalt și multi-tenant. Arhitectura Cortex se compune dintr-un set de microservicii separate, fiecare având propria funcție: replicare, stocare, interogări etc. Cortex este activ dezvoltat, având în mod constant noi caracteristici și îmbunătățiri ale performanței. Implementăm regulat noi versiuni Cortex în clustere, astfel încât clienții să poată beneficia de aceste caracteristici — de altfel, Cortex permite actualizări fără întrerupere.
Pentru actualizări fără întreruperi, serviciul Ingester al Cortexului necesită o replică suplimentară a Ingesterului în timpul procesului de actualizare. (Nota traducătorului.: — componenta de bază a Cortexului. Sarcina sa este de a colecta un flux constant de mostre, de a le grupa în chunk-uri Prometheus și de a le salva în baze de date precum DynamoDB, BigTable sau Cassandra. Aceasta permite vechilor Ingester-i să transmită datele curente noilor Ingester-i. Este de menționat că Ingester-ii sunt pretențioși în ceea ce privește resursele. Pentru funcționarea lor, este necesar să avem câte 4 nuclee și 15 GB de memorie pe pod, adică 25% din puterea de procesare și memorie a mașinii de bază în cazul clusterelor noastre Kubernetes. În general, de obicei avem mult mai multe resurse nefolosite în cluster decât 4 nuclee și 15 GB de memorie, așa că putem rula cu ușurință acești ingesteri suplimentari în timpul actualizărilor.
Totuși, adesea se întâmplă ca, în timpul funcționării normale, să nu fie disponibile aceste 25% din resursele nefolosite pe nicio mașină. Și nici nu dorim asta: CPU-ul și memoria vor fi întotdeauna utile pentru alte procese. Pentru a rezolva această problemă, am decis să folosim . Ideea este de a aloca Ingester-ilor o prioritate mai mare decât celorlalte microservicii (stateless). Când avem nevoie să lansăm un Ingester suplimentar (N+1), în mod temporar, excludem alte pod-uri mai mici. Aceste pod-uri sunt mutați în resursele libere de pe alte mașini, lăsând un „spațiu” suficient de mare pentru a lansa un Ingester suplimentar.
Pe 18 iulie, joi, am desfășurat patru noi niveluri de prioritate în clusterele noastre: critic, unui, mediu și scăzut. Acestea au fost testate în clusterul intern fără trafic de clienți timp de aproximativ o săptămână. În mod implicit, pod-urile fără prioritate specificată primeau mediu prioritate, iar pentru Ingester-i a fost stabilit un clasă cu ridicat prioritate. Critic a fost rezervat pentru monitorizare (Prometheus, Alertmanager, node-exporter, kube-state-metrics etc.). Configurația noastră este deschisă, iar PR-ul poate fi vizualizat .
Dezastru
Pe 19 iulie, vineri, unul dintre ingineri a lansat un nou cluster dedicat Cortex pentru un client mare. Configurația pentru acest cluster nu includea noile priorități ale pod-urilor, așa că tuturor pod-urilor noi le-a fost atribuită prioritatea implicită — mediu.
În clusterul Kubernetes nu au fost suficiente resurse pentru noul cluster Cortex, iar clusterul Cortex de producție existent nu a fost actualizat (Ingester-ii au rămas fără prioritate ). Deoarece Ingester-ii din noul cluster aveau în mod implicit mediu prioritate, iar pod-urile existente în producție nu aveau nicio prioritate, Ingester-ii noului cluster au excluderea Ingester-ii din clusterul Cortex existent de producție.
ReplicaSet pentru Ingesterul exclus din clusterul de producție a detectat un pod exclus și a creat unul nou pentru a menține numărul dorit de copii. Noua pod a primit implicit mediu prioritate, iar vechiul Ingester din producție a rămas fără resurse. Rezultatul a fost un proces în aval, care a dus la excluderea tuturor pod-urilor cu Ingester pentru clusterele de producție ale Cortex-ului.
Ingester-urile sunt stateful și stochează date pentru ultimele 12 ore. Acest lucru ne permite să le comprimăm mai eficient înainte de a le scrie în spațiul de stocare pe termen lung. Pentru aceasta, Cortex realizează shard-urile de date pe serii, folosind o tabelă de dispersie distribuită (Distributed Hash Table, DHT), și replică fiecare serie pe trei Ingester-uri prin coerența de majoritate în stil Dynamo. Cortex nu scrie date în Ingester-urile care sunt oprite. Astfel, când un număr mare de Ingester-uri părăsesc DHT, Cortex nu poate asigura replicarea suficientă a înregistrărilor, iar acestea „cad”.
Detectare și remediere
Noile notificări Prometheus bazate pe «bugetul de erori» (error-budget-based — detalii vor apărea într-un articol viitor) au început să emită alarmă la 4 minute de la începerea opririi. În următoarele aproximativ cinci minute, am realizat diagnostice și am extins clusterul Kubernetes de bază pentru a găzdui atât clusterele de producție noi, cât și pe cele existente.
Încă cinci minute au trecut și vechile Ingester-uri au reușit să își scrie datele, iar noile au fost activate, iar clusterele Cortex au fost din nou disponibile.
Încă 10 minute au fost necesare pentru diagnosticare și remedierea erorilor de tip out-of-memory (OOM) de la serverele proxy de autentificare, situate în fața Cortex. Erorile OOM au fost cauzate de o creștere de zece ori a QPS (așa cum bănuim, din cauza solicitărilor excesiv de agresive de la serverele clientului Prometheus).
Consecințe
Durata totală a opririi a fost de 26 de minute. Datele nu au fost pierdute. Ingester-urile au reușit să încarce toate datele din memorie în spațiul de stocare pe termen lung. În timpul opririi, serverele Prometheus ale clienților au stocat în buffer înregistrările (remote) împreună cu bazat pe WAL (de autoria de la Grafana Labs) și au repetat înregistrările eșuate după cădere.
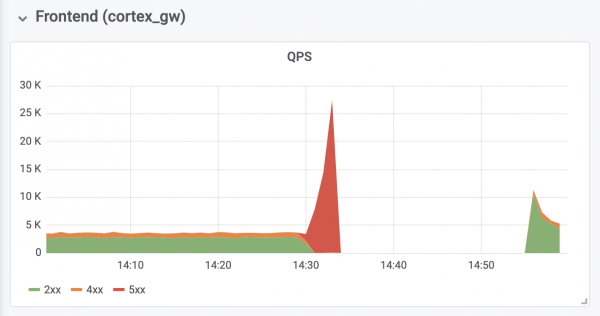
Operațiile de scriere ale clusterului de producție
Conclusions
Este important să extragem învățămintele din acest incident și să luăm măsurile necesare pentru a evita repetarea acestuia.
Privind înapoi, trebuie să recunoaștem că nu ar fi trebuit să stabilim implicit mediu prioritatea, până când toate Ingester-urile din producție au primit unui prioritate. În plus, ar fi trebuit să ne îngrijim în avans de prioritatea lor ridicată. Acum totul este corectat. Sperăm că experiența noastră va ajuta alte organizații care iau în considerare utilizarea priorităților pod-urilor în Kubernetes. Vom adăuga un nivel suplimentar de control asupra desfășurării oricăror obiecte suplimentare, a căror configurații sunt globale pentru cluster. De acum înainte, aceste modificări vor fi evaluate de
mai multă lume. În plus, modificarea care a dus la eșec a fost considerată prea nesemnificativă pentru un document de proiect separat — a fost discutată doar în problema GitHub. De aici înainte, toate aceste modificări de configurație vor fi însoțite de documentația corespunzătoare a proiectului.mareÎn final, vom automatiza redimensionarea serverului proxy de autentificare pentru a preveni OOM în cazul unei suprasarcini, ceea ce am observat, și vom analiza parametrii Prometheus pe care îi configurăm implicit, legate de rollback și scalare, pentru a preveni problemele similare în viitor.
Eșecul experimentat a avut și unele consecințe pozitive: având resursele necesare, Cortex s-a restabilit automat fără intervenție suplimentară. De asemenea, am câștigat experiență valoroasă lucrând cu
Grafana Loki Aventura Kubernetes Dailymotion: construirea infrastructurii în cloud + on-premises
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
