

În acest articol sunt prezentate câteva modele comune care ajută inginerii să lucreze cu servicii la scară mare, la care fac cereri milioane de utilizatori.
Din experiența autorului, aceasta nu este o listă exhaustivă, dar este cu adevărat efectivă sfaturi. Așadar, să început.
Tradus cu sprijinul .
Nivel de bază
Măsurile enumerate mai jos sunt relativ simple de implementat, dar oferă un randament ridicat. Dacă nu le-ați aplicat anterior, veți fi surprins de îmbunătățirile semnificative.
Infrastructure as Code
Prima parte a sfaturilor este să implementați infrastructura ca și cod. Aceasta înseamnă că trebuie să aveți o modalitate programatică de a desfășura întreaga infrastructură. Poate suna complicat, dar de fapt, ne referim la următorul cod:
Desfășurarea a 100 de mașini virtuale
- cu Ubuntu
- 2 GB RAM pe fiecare
- vor avea următorul cod
- cu aceste specificații
Puteți urmări modificările din infrastructură și reveni rapid la ele folosind un sistem de gestionare a versiunilor.
Modernistul din mine spune că putem folosi Kubernetes/Docker pentru a face tot ce este menționat mai sus, și are dreptate.
În plus, asigurarea automatizării se poate face cu ajutorul Chef, Puppet sau Terraform.
Integrarea și livrarea continuă
Pentru a crea un serviciu scalabil, este important să aveți o linie de construire și testare pentru fiecare pull request. Chiar dacă testul este cel mai simplu, garantează cel puțin că codul pe care îl desfășurați se compilează.
De fiecare dată în această etapă, răspundeți la întrebarea: se va compila construcția mea și va trece testele, este validă? Acest lucru poate părea un standard scăzut, dar rezolvă multe probleme.
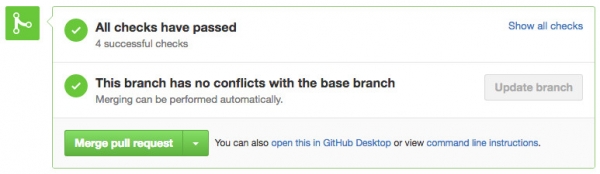
Nu există nimic mai frumos decât să vezi aceste bifări
Pentru această tehnologie, puteți evalua Github, CircleCI sau Jenkins.
Balancerii de încărcare
Așadar, dorim să pornim un balancer de încărcare pentru a redirecționa traficul și a asigura o sarcină egală asupra tuturor nodurilor sau funcționarea serviciului în caz de eșec:
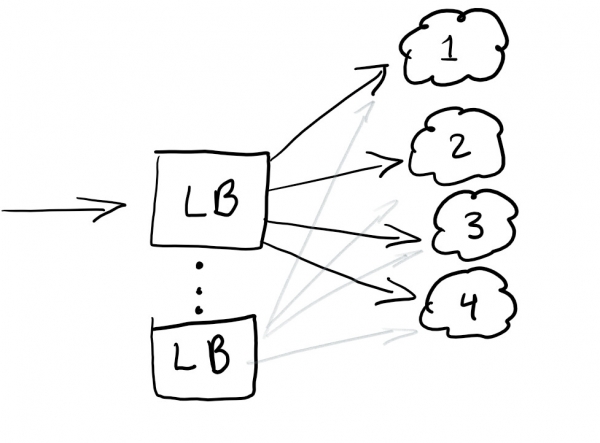
Balancerul de încărcare ajută de obicei la distribuirea traficului. Cea mai bună practică este redundanța balancerilor de încărcare, astfel încât să nu aveți un singur punct de eșec.
De obicei, balancerii de încărcare sunt configurați în acel cloud pe care îl folosiți.
RayID, correlative ID sau UUID pentru cereri
Ați întâlnit vreodată o eroare în aplicație cu un mesaj de genul: „Ceva a mers prost. Salvați acest ID și trimiteți-l către suportul nostru”?
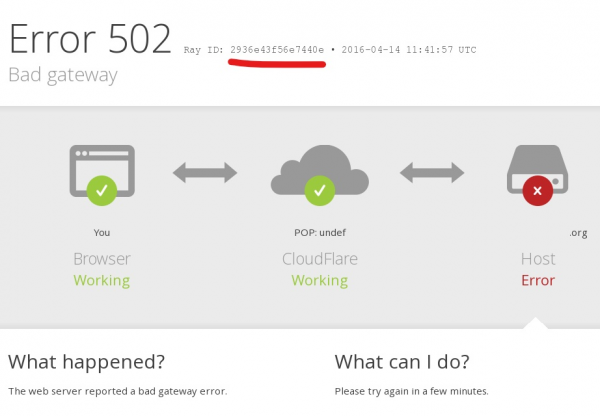
Un identificator unic, correlation ID, RayID sau oricare dintre variante - este un identificator unic care permite urmărirea unei cereri pe parcursul ciclului său de viață. Acest lucru permite urmărirea întregului parcurs al cererii în jurnale.
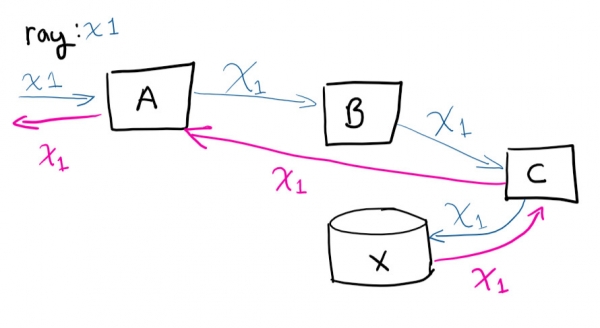
Utilizatorul face o cerere către sistemul A, apoi A se conectează la B, aceasta se conectează la C, salvează în X și apoi cererea revine la A.
Dacă ați fi conectat de la distanță la mașinile virtuale și ați încerca să urmăriți parcursul cererii (și să asociați manual, ce apeluri au loc), ați înnebuni. Existenta unui identificator unic facilitează considerabil viața. Aceasta este una dintre cele mai simple lucruri pe care le puteți face pentru a economisi timp pe măsură ce serviciul crește.
Nivel mediu
Aici, sfaturile sunt mai complexe decât cele anterioare, dar instrumentele corecte facilitează sarcina, asigurând o rentabilitate a investiției chiar și pentru micile și mijlociile companii.
Jurnalizare centralizată
Felicitări! Ați desfășurat 100 de mașini virtuale. A doua zi, directorul general vine și se plânge de o eroare pe care a întâmpinat-o în timpul testării serviciului. El reporta identificatorul relevant despre care am vorbit mai sus, dar va trebui să revizuiți jurnalele a 100 de mașini pentru a găsi cea care a generat eroarea. Și trebuie să o găsiți înainte de prezentarea de mâine.
Deși pare o aventură amuzantă, este mai bine să vă asigurați că aveți opțiunea de a căuta în toate jurnalele dintr-un singur loc. Am rezolvat problema centralizării jurnalelor folosind funcționalitatea încorporată a stivei ELK: aici suportă colectarea jurnalele cu opțiuni de căutare. Acest lucru va ajuta cu adevărat să rezolvați problema cu găsirea jurnalului specific. Ca bonus, puteți crea grafice și alte lucruri distractive.
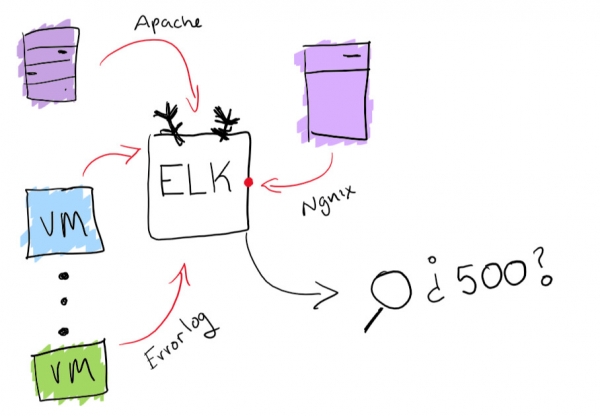
Funcționalitate a stivei ELK
Agenți de monitorizare
Acum că serviciul dumneavoastră este operațional, trebuie să vă asigurați că funcționează fără întreruperi. Cel mai bun mod de a face acest lucru este să rulați câțiva agenți, care funcționează în paralel și verifică că acesta funcționează și că se execută operații de bază.
În acest moment, verificați că o construcție lansată funcționează bine și operează normal.
Pentru proiecte mici și medii, recomand Postman pentru monitorizarea și documentarea API-urilor. Dar, în general, trebuie să te asiguri că ai un mod de a ști când a avut loc o întrerupere și de a primi o notificare în timp util.
Autoscalarea în funcție de încărcare
Este foarte simplu. Dacă ai o mașină virtuală care prelucrează cereri și se apropie de 80% din memorie ocupată, poți fie să îți mărești resursele, fie să adaugi mai multe mașini virtuale în cluster. Automatisarea acestor operațiuni este excelentă pentru adaptarea elastică a puterii în funcție de încărcare. Dar trebuie întotdeauna să fii atent la câți bani cheltuiești și să stabiliți limite rezonabile.
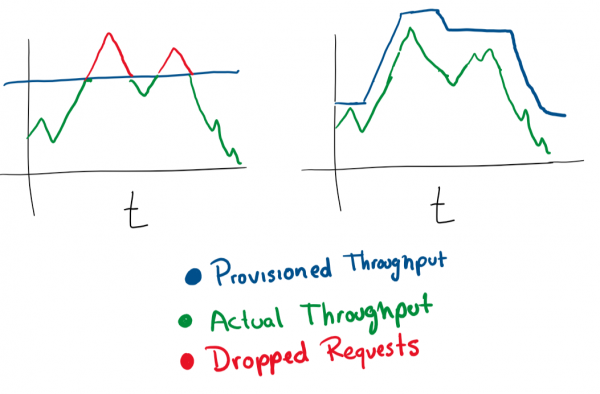
În majoritatea serviciilor cloud, poți configura autoscalarea folosind un număr mai mare de servere sau servere mai puternice.
Sistemul experimentelor
O modalitate bună de a implementa actualizări în siguranță este să ai posibilitatea de a testa ceva pentru 1% din utilizatori timp de o oră. Cu siguranță ai văzut astfel de mecanisme în acțiune. De exemplu, Facebook arată o parte din audiență o altă culoare sau schimbă dimensiunea fontului pentru a vedea cum percep utilizatorii modificările. Aceasta se numește testare A/B.
Chiar și lansarea unei noi funcții poate fi inițiată ca un experiment, iar apoi poți decide cum să o lansezi. De asemenea, ai oportunitatea de a 'retrage' sau modifica configurația în timp real în funcție de o funcție care cauzează degradarea serviciului tău.
Nivel avansat
Aici sunt sfaturi care sunt destul de dificile de implementat. Probabil că vei avea nevoie de puțin mai multe resurse, așa că va fi greu pentru o companie mică sau medie să se descurce cu acestea.
Implementări blue-green
Aceasta este ceea ce numesc o metodă 'Erlang' de implementare. Erlang a devenit popular când au apărut companiile telefonice. Pentru rutarea apelurilor telefonice au fost folosite comutatoare software. Sarcina principală a software-ului acestor comutatoare era să nu întrerupă apelurile în timpul actualizării sistemului. Erlang are un mod excelent de a încărca un nou modul fără a prăbuși precedentul.
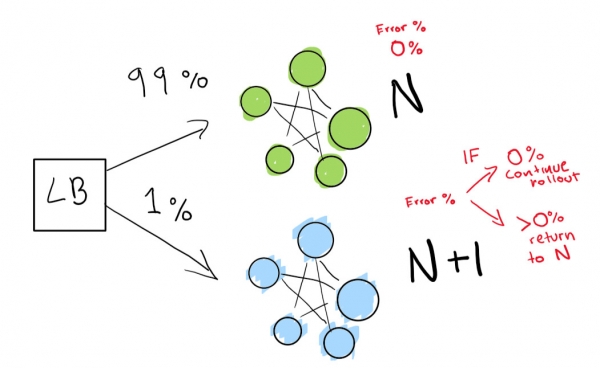
Această etapă depinde de disponibilitatea unui echilibror de încărcare. Să presupunem că aveți versiunea N a software-ului dvs., iar apoi doriți să desfășurați versiunea N+1.
Dumneavoastră ați putea pur și simplu să opriți serviciul și să desfășurați următoarea versiune atunci când considerați că este convenabil pentru utilizatorii dvs. și să obțineți un timp de nefuncționare. Dar să presupunem că aveți cu adevărat condiții riguroase SLA. Așadar, un SLA de 99,99% înseamnă că puteți fi offline doar timp de 52 de minute pe an.
Dacă doriți cu adevărat să atingeți aceste valori, aveți nevoie de două desfășurări simultane:
- cea pe care o aveți în prezent (N);
- următoarea versiune (N+1).
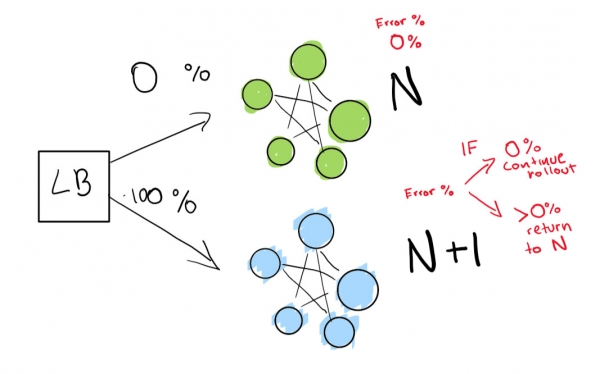
Specifici echilibrorului de încărcare să redirecționeze un procent din trafic către noua versiune (N+1), în timp ce tu monitorizezi activ regresiile.
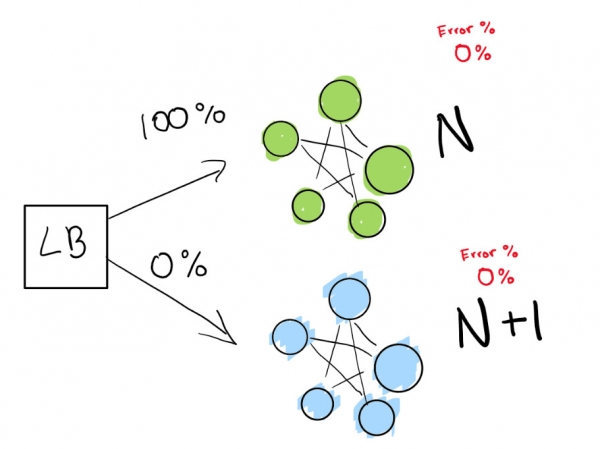
Aici avem desfășurarea verde N, care funcționează normal. Încercăm să trecem la următoarea versiune a acestei desfășurări
Mai întâi, trimitem un test foarte mic pentru a vedea dacă desfășurarea N+1 funcționează cu un volum mic de trafic:
În cele din urmă, avem un set de verificări automate pe care le rulăm până când desfășurarea noastră este completă. Dacă ești foarte, foarte atenționat, poți de asemenea să păstrezi desfășurarea N pentru totdeauna pentru o repornire rapidă în caz de regresie severă:
Dacă vrei să treci la un nivel și mai avansat, poți face ca totul în desfășurarea albastru-verde să fie automatizat.
Detectarea anomaliilor și atenuarea automată a consecințelor
Având în vedere că ai o jurnalizare centralizată și o bună colectare a jurnalelor, poți deja stabili obiective mai ambițioase. De exemplu, să previzionezi proactiv defecțiunile. Funcțiile sunt urmărite pe monitoare și în jurnale și se construiesc diverse diagrame - și se poate prezice din timp ce ar putea să meargă prost:
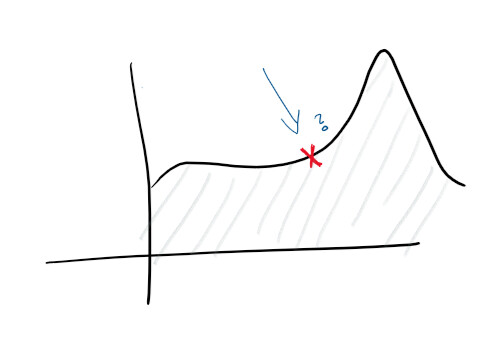
Cu detectarea anomaliilor, începi să studiezi unele indicii pe care ți le oferă serviciul. De exemplu, un vârf de încărcare a CPU-ului poate indica că hard disk-ul este pe cale de a ceda, iar un vârf al numărului de solicitări înseamnă că trebuie să scalezi. Astfel de date statistice permit serviciului să devină proactiv.
Obținând astfel de date analitice, puteți scala în orice dimensiune, modificând proactiv și reactualizând caracteristicile mașinilor, bazelor de date, conexiunilor și altor resurse.
Asta e tot!
Această listă de priorități vă va scuti de multe probleme atunci când gestionați un serviciu cloud.
Autorul articolului original invită cititorii să își lase comentariile și să facă modificări. Articolul este distribuit ca open source, cererile de extragere sunt acceptate de autor .
What else to read on the topic:
Sursa: habr.com
