

Performanța ridicată este una dintre cerințele cheie atunci când lucrăm cu date mari. La Sber, în managementul încărcării datelor, ne ocupăm cu procesarea practic tuturor tranzacțiilor în Cloud-ul nostru de Date bazat pe Hadoop și, prin urmare, avem de-a face cu fluxuri de informații cu adevărat mari. În mod firesc, căutăm constant modalități de a îmbunătăți performanța și acum dorim să vă povestim cum am reușit să patch-uim RegionServer HBase și clientul HDFS, ceea ce a dus la creșterea semnificativă a vitezei de citire.
Cu toate acestea, înainte de a trece la detaliile modificărilor, merită să discutăm despre limitările care sunt în principiu imposibil de ocolit dacă folosim HDD.
De ce HDD-urile și citirea rapidă aleatorie nu sunt compatibile
După cum se știe, HBase și multe alte baze de date stochează datele în blocuri, fiecare având dimensiunea de câteva zeci de kilobyte. În mod implicit, aceasta este de aproximativ 64 Kb. Acum să ne imaginem că dorim să extragem doar 100 de biți și cerem HBase să ne ofere aceste date pe baza unei chei. Din moment ce dimensiunea blocului în HFiles este de 64 Kb, ceea ce vom solicita va fi de 640 de ori mai mult (să avem în vedere acest lucru!) decât avem nevoie.
Apoi, deoarece cererea va trece prin HDFS și mecanismul său de cache pentru metadate ShortCircuitCache (care permite accesul direct la fișiere), aceasta duce la citirea deja a 1 Mb de pe disc. Totuși, acest lucru poate fi reglat prin parametrul dfs.client.read.shortcircuit.buffer.size și, în multe cazuri, are sens să reducem această valoare, de exemplu, la 126 Kb.
Să presupunem că facem acest lucru, dar, în plus, atunci când începem să citim date prin java API, folosind funcții precum FileChannel.read și cerem sistemului de operare să citească volumul specificat de date, acesta va citi "din precauție" de două ori mai mult, adică 256 Kb în cazul nostru. Acest lucru se întâmplă pentru că în java nu există o modalitate simplă de a seta flag-ul FADV_RANDOM, care să prevină acest comportament.
În cele din urmă, pentru a obține cei 100 de biți, în spate se citesc de 2600 de ori mai mult. Părea evident - soluția este simplă, să reducem dimensiunea blocului la un kilobyte, să setăm acel flag menționat și să obținem o accelerare semnificativă. Dar problema este că, reducând dimensiunea blocului la jumătate, diminuează și numărul de biți citiți în unitatea de timp, tot cu o jumătate.
Există unele câștiguri de la activarea flag-ului FADV_RANDOM, dar doar în condiții de multithreading intens și cu dimensiunea blocului de minimum 128 KB, iar acestea reprezintă maximum câteva zeci de procente.
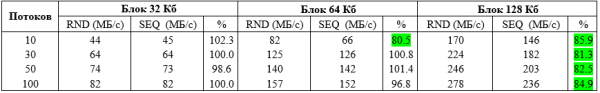
Testele au fost efectuate pe 100 de fișiere, fiecare având dimensiunea de 1 GB și plasate pe 10 discuri HDD.
Să calculăm ce putem aștepta, teoretic, cu o astfel de viteză:
Să presupunem că citim de la 10 discuri cu o viteză de 280 MB/sec, adică 3 milioane de accesări de câte 100 de bytes. Dar, așa cum ne amintim, datele de care avem nevoie apar de 2600 de ori mai rar decât cele citite. Astfel, împărțim 3 milioane la 2600 și obținem 1100 de înregistrări pe secundă.
Deprimant, nu-i așa? Așa este natura Accesului Aleator la date pe HDD — indiferent de dimensiunea blocului. Acesta este limita fizică a accesului aleator, iar nicio bază de date nu va putea obține mai mult în astfel de condiții.
Cum reușesc, totuși, bazele de date să atingă viteze mult mai mari? Pentru a răspunde la această întrebare, să ne uităm la imaginea următoare:
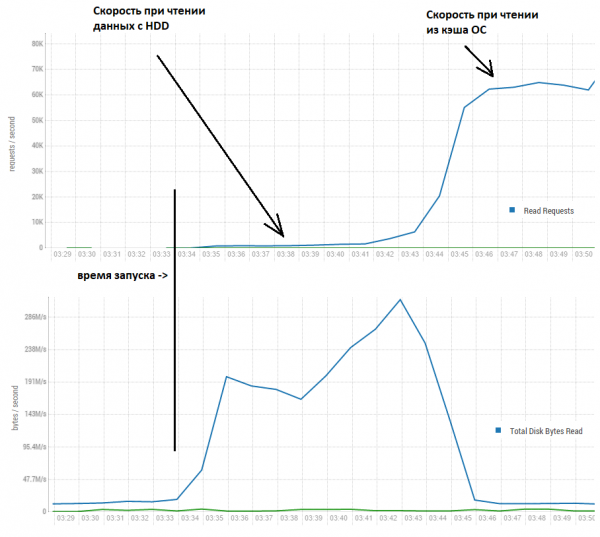
Aici vedem că, în primele câteva minute, viteza este într-adevăr de aproximativ o mie de înregistrări pe secundă. Cu toate acestea, ulterior, datorită faptului că se citesc mult mai multe date decât au fost solicitate, acestea se acumulează în bufferul/cachingul sistemului de operare (Linux) și viteza crește la peste 60.000 pe secundă.
Astfel, în continuare, ne vom concentra pe accelerarea accesului doar la datele care sunt în cache-ul sistemului de operare sau se află în stocări comparabile ca viteză cu SSD/NVMe.
În cazul nostru, vom efectua teste pe un stand format din 4 servere, fiecare configurat astfel:
CPU: Xeon E5-2680 v4 @ 2.40GHz, 64 de fire.
Memorie: 730 GB.
java version: 1.8.0_111
Și iată momentul cheie — volumul de date din tabelele care trebuie citite. Problema este că, dacă datele sunt citite dintr-o tabelă care încap în totalitate în cache-ul HBase, atunci nu se va ajunge deloc la citirea din buffer/cachingul sistemului de operare. Acest lucru se datorează faptului că HBase rezervă în mod implicit 40% din memorie pentru o structură numită BlockCache. Practic, aceasta este un ConcurrentHashMap, unde cheia este numele fișierului + offset-ul blocului, iar valoarea este datele corespunzătoare acestui offset.
Astfel, când citirea se face exclusiv din această structură, noi , aproximativ un milion de cereri pe secundă. Dar să ne imaginăm că nu putem aloca sute de gigabytes de memorie doar pentru nevoile bazei de date, deoarece pe aceste servere rulează și multe alte aplicații utile.
De exemplu, în cazul nostru, volumul BlockCache pe un RS este de aproximativ 12 GB. Am desfășurat două RS pe o singură nodă, deci pentru BlockCache s-au alocat 96 GB pe toate nodurile. Iar datele sunt de câteva ori mai multe, să presupunem că sunt 4 tabele, fiecare cu 130 de regiuni, în care fișierele au dimensiunea de 800 MB, comprimate cu FAST_DIFF, adică în total 410 GB (acestea sunt datele pure, fără a lua în considerare factorul de replicare).
Astfel, BlockCache reprezintă doar aproximativ 23% din volumul total de date și aceasta se apropie mai mult de condițiile reale ale ceea ce numim BigData. Și aici începe partea cea mai interesantă — evident, cu cât sunt mai puține accesări în cache, cu atât performanța este mai slabă. În caz de rată, va fi necesar să facem o mulțime de muncă — adică să coborâm la apelurile funcțiilor sistemului. Totuși, nu putem evita acest lucru, așa că să examinăm un alt aspect — ce se întâmplă cu datele din interiorul cache-ului?
Să simplificăm situația și să presupunem că avem un cache în care poate fi stocat doar 1 obiect. Iată un exemplu despre ce se va întâmpla atunci când încercăm să lucrăm cu un volum de date de 3 ori mai mare decât cache-ul, va trebui să:
1. Să plasăm blocul 1 în cache
2. Să eliminăm blocul 1 din cache
3. Să plasăm blocul 2 în cache
4. Să eliminăm blocul 2 din cache
5. Să plasăm blocul 3 în cache
S-au efectuat 5 acțiuni! Totuși, această situație nu poate fi numită normală, practic forțăm HBase să efectueze o mulțime de muncă complet inutilă. Acesta citește constant date din cache-ul OS, le plasează în BlockCache, pentru a le elimina aproape imediat, deoarece a venit o nouă porțiune de date. Animația de la începutul postului ilustrează esența problemei — Garbage Collector depășește limitele, atmosfera se încălzește, iar micuța Greta din Suedia, departe și călduroasă, este dezamăgită. Iar noi, profesioniști IT, nu ne place deloc când copiii sunt triști, așa că începem să ne gândim ce putem face în legătură cu asta.
Dar ce s-ar întâmpla dacă am plasa în cache nu toate blocurile, ci doar un anumit procent din ele, astfel încât cache-ul să nu se umple? Să adăugăm mai întâi câteva linii de cod în începutul funcției de plasare a datelor în BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Sensul este următorul: offset-ul reprezintă poziția blocului în fișier, iar ultimele cifre sunt distribuite aleatoriu și uniform de la 00 la 99. Prin urmare, vom omite doar acelea care cad în intervalul nostru dorit.
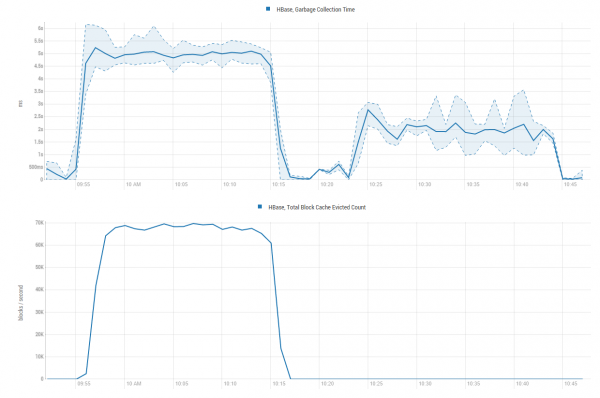
De exemplu, să setăm cacheDataBlockPercent = 20 și să vedem ce se întâmplă:
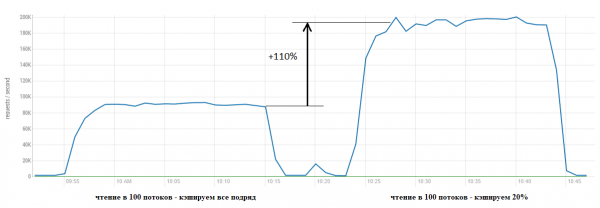
Rezultatul este evident. În graficele de mai jos devine clar de ce a avut loc această accelerare - economisim o mulțime de resurse GC, evitând munca Sisifică de plasare a datelor în cache doar pentru a le elimina imediat.
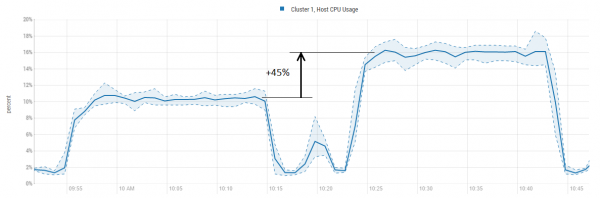
Utilizarea CPU-ului, în acest caz, crește, dar este mult mai mică decât performanța:
Aici merită să menționăm că blocurile care sunt stocate în BlockCache pot fi diferite. Majoritatea, în jur de 95%, sunt efectiv date. Iar restul constă în metadate, cum ar fi filtre Bloom sau LEAF_INDEX și . Aceste date sunt puține, dar foarte utile, deoarece înainte de a apela direct la date, HBase se referă la metadate pentru a înțelege dacă trebuie să caute în continuare și, dacă da, unde se află blocul interesant.
Prin urmare, în cod vedem condiția de verificare buf.getBlockType().isData() și, datorită acestui metadate, vom lăsa în cache în orice caz.
Acum să creștem încărcătura și să optimizăm puțin funcția. În primul test am făcut procentul de tăiere = 20 și BlockCache a fost ușor subîncărcat. Acum să setăm 23% și vom adăuga câte 100 de fire de execuție la fiecare 5 minute, pentru a vedea în ce moment apare saturația:
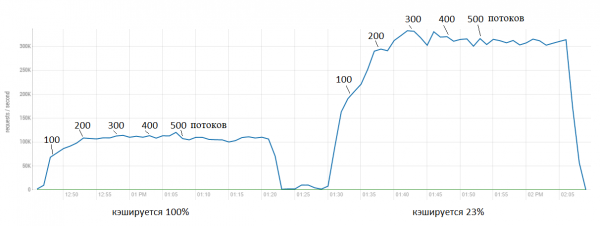
Aici vedem că versiunea inițială se lovește aproape imediat de un plafon de aproximativ 100 de mii de cereri pe secundă. În timp ce patch-ul oferă o accelerare până la 300 de mii. Este evident că accelerarea ulterioară nu este atât de „gratis”, utilizarea CPU-ului crește de asemenea.
Cu toate acestea, aceasta nu este o soluție foarte elegantă, deoarece nu știm dinainte ce procent de blocuri trebuie să fie cache-uite, acest lucru depinde de profilul de încărcare. Prin urmare, a fost implementat un mecanism de ajustare automată a acestui parametru în funcție de activitatea operațiunilor de citire.
Pentru a gestiona acest lucru, au fost adăugate trei parametrii:
hbase.lru.cache.heavy.eviction.count.limit — stabilește de câte ori trebuie să ruleze procesul de evacuare a datelor din cache înainte de a începe utilizarea optimizării (adică de a ocoli blocurile). Prin default, acesta este setat la MAX_INT = 2147483647, ceea ce înseamnă că funcționalitatea nu va începe să funcționeze cu această valoare. Procesul de evacuare se desfășoară la fiecare 5 – 10 secunde (în funcție de încărcare) și 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 de ani. Totuși, putem seta această opțiune la 0 pentru a activa funcționalitatea imediat după pornire.
Cu toate acestea, există și un beneficiu în această opțiune. Dacă profilul nostru de încărcare implică citiri pe termen scurt (să zicem ziua) și citiri pe termen lung (noaptea), atunci putem face ca funcționalitatea să se activeze doar când se desfășoară operațiuni de citire prelungite.
De exemplu, știm că citirile pe termen scurt durează, de obicei, aproximativ 1 minut. În acest caz, nu trebuie să începem să evacuăm blocuri, cache-ul nu va expira în acest timp și putem seta această opțiune, de exemplu, la 10. Aceasta va determina ca optimizarea să înceapă să funcționeze doar atunci când au început citirile active mai lungi, adică după 100 de secunde. Astfel, dacă avem o citire pe termen scurt, toate blocurile vor fi disponibile în cache (cu excepția celor care vor fi evacuate de algoritmul standard). Iar când desfășurăm citiri pe termen lung, funcționalitatea se activează și vom obține o performanță considerabil mai bună.
hbase.lru.cache.heavy.eviction.mb.size.limit — stabilește câte megabytes dorim să încărcăm în cache (și, desigur, să evacuăm) în 10 secunde. Funcționalitatea va încerca să atingă această valoare și să o mențină. Ideea este următoarea: dacă umplem cache-ul cu gigabytes, va trebui să evacuăm și gigabytes, iar aceasta, după cum am văzut mai sus, este destul de costisitoare. Cu toate acestea, nu ar trebui să încercăm să-l setăm prea mic, deoarece acest lucru va conduce la ieșirea prematură din modul de ocolire a blocurilor. Pentru servere puternice (aproximativ 20-40 de nuclee fizice), este optim să setăm între 300-400 MB. Pentru sistemele de clasă medie (~10 nuclee), 200-300 MB. Pentru sistemele slabe (2-5 nuclee) poate fi acceptabil 50-100 MB (testarea pe aceste sisteme nu a fost efectuată).
Să vedem cum funcționează: presupunem că am setat hbase.lru.cache.heavy.eviction.mb.size.limit = 500, există o anumită încărcare (citire) și apoi, la fiecare ~10 secunde, calculăm câți bytes au fost eliberați folosind formula:
Overhead = Suma Bytes Eliberați (MB) * 100 / Limită (MB) — 100;
Dacă în realitate au fost eliberați 2000 MB, atunci Overhead devine:
2000 * 100 / 500 — 100 = 300%
Algoritmii încearcă să mențină un procent de maximum câțiva zeci la sută, astfel că această caracteristică va reduce procentul blocurilor cache-uite, implementând astfel un mecanism de auto-tuning.
Cu toate acestea, dacă încărcarea a scăzut, de exemplu, au fost eliberați doar 200 MB și Overhead a devenit negativ (așa-numitul overshooting):
200 * 100 / 500 — 100 = -60%
Atunci caracteristica, dimpotrivă, va crește procentul blocurilor cache-uite până când Overhead devine pozitiv.
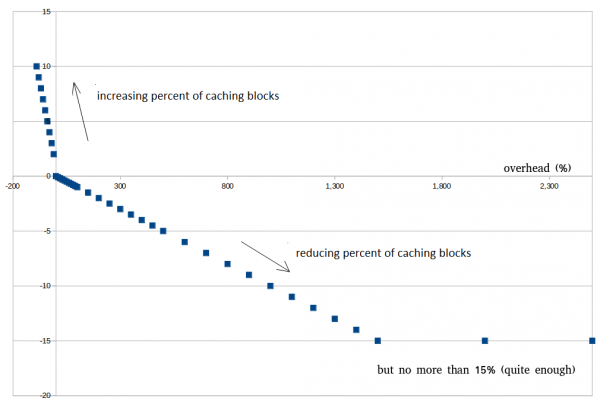
Mai jos va fi un exemplu despre cum arată asta pe date reale. Nu trebuie să încercăm să ajungem la 0%, este imposibil. Este foarte bine când suntem în jur de 30 — 100%, ajută la evitarea ieșirii premature din modul de optimizare în timpuri scurte de vârf.
hbase.lru.cache.heavy.eviction.overhead.coefficient — stabilește cât de repede ne-ar plăcea să obținem rezultatul. Dacă știm cu siguranță că lecturile noastre sunt în principal de lungă durată și nu vrem să așteptăm, putem crește acest coeficient și obține o performanță ridicată mai repede.
De exemplu, am setat acest coeficient = 0.01. Asta înseamnă că Overhead (vezi mai sus) va fi înmulțit cu acest număr în rezultatul obținut și procentul blocurilor cache-uite va fi redus. Presupunem că Overhead = 300%, iar coeficientul = 0.01, atunci procentul blocurilor cache-uite va fi redus cu 3%.
O astfel de logică de «Backpressure» a fost implementată și pentru valorile negative ale Overhead (overshooting). Deoarece există întotdeauna fluctuații pe termen scurt în volumul citirilor-eliberărilor, acest mecanism permite evitarea ieșirii premature din modul de optimizare. Backpressure are o logică inversată: cu cât overshooting-ul este mai mare, cu atât mai multe blocuri sunt cache-uite.
Cod de implementare
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Uneori citim mai multe date decât pot încăpea în BlockCache
        * și aceasta este cauza unei rate mari de evacuări.
        * Aceasta duce la o activitate intensă a Garbage Collector-ului.
        * Așadar, multe blocuri sunt puse în BlockCache, dar nu sunt niciodată citite,
        * cheltuind multe resurse CPU.
        * Aici vom analiza câți bytes au fost eliberați și vom decide
        * dacă a venit momentul să reducem numărul de blocuri cache.
        * Acesta ajută la evitarea introducerii a prea multor blocuri în BlockCache
        * când evict() funcționează foarte activ și salvează CPU pentru alte sarcini.
        * Mai multe detalii: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // În primul rând, trebuie să controlăm cât timp
        // a trecut de la ultima evict() a fost lansată
        // Acesta ar trebui să fie aproximativ același timp (+/- 10s)
        // deoarece obținem volume comparabile de bytes eliberați de fiecare dată.
        // 10s deoarece acesta este perioada implicită pentru a rula evict() (vezi mai sus this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Aici trebuie să calculăm ce situație avem.
          // Avem limita "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // și putem calcula supracostul pe aceasta.
          // Vom folosi aceste informații pentru a decide,
          // cum să schimbăm procentul de blocuri cache.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Acum suntem în situația în care suntem peste limită
            // Dar poate că vrem să ignorăm asta pentru că se va termina destul de curând
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // A durat mult timp și trebuie să reducem numărul de blocuri cache
              // Acum calculăm câte blocuri dorim să sărim.
              // Depinde de:
              // 1. Supracost - dacă supracostul este mare, am putea fi mai agresivi
              // în reducerea numărului de blocuri cache.
              // 2. Cât de rapid dorim să obținem rezultatul. Dacă știm că citirea noastră
              // este grea de mult timp, nu vrem să așteptăm și putem
              // crește coeficientul și să obținem o performanță bună destul de repede.
              // Dar dacă nu suntem siguri, putem face asta încet, ceea ce ar putea preveni
              // ieșirea prematură din acest mod. Așadar, când coeficientul este
              // mai mare, putem obține o performanță mai bună atunci când citirea grea este stabilă.
              // Dar când citirea se schimbă, ne putem ajusta și seta
              // coeficientul la o valoare mai mică.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Dar practica arată că o reducere de 15% este destul de suficient.
              // Nu suntem avari (acest lucru ar putea duce la o ieșire prematură).
              change = Math.min(15, change);
              change = Math.max(0, change); // Cred că nu se va întâmpla niciodată, dar verificăm pentru siguranță
              // Așadar, acesta este punctul cheie, aici reducem % din blocurile cache
              cache.cacheDataBlockPercent -= change;
              // Dacă scădem prea mult, trebuie să ne oprim aici, 1% oricum ar trebui să fie.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Ei bine, am obținut un exces.
            // Poate că este doar o fluctuație pe termen scurt și putem rămâne în acest mod.
            // Acest lucru ajută la evitarea ieșirii premature în timpul fluctuațiilor pe termen scurt.
            // Dacă excesul este mai mic de 90%, vom încerca să creștem procentul de
            // blocuri cache și sperăm că este suficient.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Logică simplă: mai mult exces - mai multe blocuri cache (backpressure)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Dar nu poate fi mai mult de 100%, așadar verificăm.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Se pare că citirea grea s-a terminat.
              // Pur și simplu ieșim din acest mod.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "heavy eviction counter: {}, " +
            "current caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Să analizăm acum toate acestea pe un exemplu real. Avem următorul scenariu de test:
- Începem să facem Scan (25 threads, batch = 100)
- După 5 minute, adăugăm multi-gets (25 threads, batch = 100)
- După 5 minute, oprim multi-gets (rămâne din nou doar scan)
Facem două rulări, mai întâi hbase.lru.cache.heavy.eviction.count.limit = 10000 (ceea ce de fapt dezactivează funcția), apoi setăm limit = 0 (o activează).
În jurnalele de mai jos vedem cum se activează funcția, resetând Overshooting la 14-71%. Din când în când, sarcina scade, ceea ce activează Backpressure și HBase re-cachează mai multe blocuri.
Jurnal RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
evictat (MB): 456, raport 0.17, suprasarcină (%): 128, contor de evicție severă: 27, procent de blocuri de date în cache (curent): 18 < obținerea adăugată (dar tabelul rămâne același)
evictat (MB): 456, raport 0.15, suprasarcină (%): 128, contor de evicție severă: 28, procent de blocuri de date în cache (curent): 17
evictat (MB): 342, raport 0.13, suprasarcină (%): 71, contor de evicție severă: 29, procent de blocuri de date în cache (curent): 17
evictat (MB): 342, raport 0.11, suprasarcină (%): 71, contor de evicție severă: 30, procent de blocuri de date în cache (curent): 17
evictat (MB): 342, raport 0.09, suprasarcină (%): 71, contor de evicție severă: 31, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.08, suprasarcină (%): 14, contor de evicție severă: 32, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.07, suprasarcină (%): 14, contor de evicție severă: 33, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.06, suprasarcină (%): 14, contor de evicție severă: 34, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.05, suprasarcină (%): 14, contor de evicție severă: 35, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.05, suprasarcină (%): 14, contor de evicție severă: 36, procent de blocuri de date în cache (curent): 17
evictat (MB): 228, raport 0.04, suprasarcină (%): 14, contor de evicție severă: 37, procent de blocuri de date în cache (curent): 17
evictat (MB): 109, raport 0.04, suprasarcină (%): -46, contor de evicție severă: 37, procent de blocuri de date în cache (curent): 22 < presiune inversă
evictat (MB): 798, raport 0.24, suprasarcină (%): 299, contor de evicție severă: 38, procent de blocuri de date în cache (curent): 20
evictat (MB): 798, raport 0.29, suprasarcină (%): 299, contor de evicție severă: 39, procent de blocuri de date în cache (curent): 18
evictat (MB): 570, raport 0.27, suprasarcină (%): 185, contor de evicție severă: 40, procent de blocuri de date în cache (curent): 17
evictat (MB): 456, raport 0.22, suprasarcină (%): 128, contor de evicție severă: 41, procent de blocuri de date în cache (curent): 16
evictat (MB): 342, raport 0.16, suprasarcină (%): 71, contor de evicție severă: 42, procent de blocuri de date în cache (curent): 16
evictat (MB): 342, raport 0.11, suprasarcină (%): 71, contor de evicție severă: 43, procent de blocuri de date în cache (curent): 16
evictat (MB): 228, raport 0.09, suprasarcină (%): 14, contor de evicție severă: 44, procent de blocuri de date în cache (curent): 16
evictat (MB): 228, raport 0.07, suprasarcină (%): 14, contor de evicție severă: 45, procent de blocuri de date în cache (curent): 16
evictat (MB): 228, raport 0.05, suprasarcină (%): 14, contor de evicție severă: 46, procent de blocuri de date în cache (curent): 16
evictat (MB): 222, raport 0.04, suprasarcină (%): 11, contor de evicție severă: 47, procent de blocuri de date în cache (curent): 16
evictat (MB): 104, raport 0.03, suprasarcină (%): -48, contor de evicție severă: 47, procent de blocuri de date în cache (curent): 21 < obținerea de întreruperi
evictat (MB): 684, raport 0.2, suprasarcină (%): 242, contor de evicție severă: 48, procent de blocuri de date în cache (curent): 19
evictat (MB): 570, raport 0.23, suprasarcină (%): 185, contor de evicție severă: 49, procent de blocuri de date în cache (curent): 18
evictat (MB): 342, raport 0.22, suprasarcină (%): 71, contor de evicție severă: 50, procent de blocuri de date în cache (curent): 18
evictat (MB): 228, raport 0.21, suprasarcină (%): 14, contor de evicție severă: 51, procent de blocuri de date în cache (curent): 18
evictat (MB): 228, raport 0.2, suprasarcină (%): 14, contor de evicție severă: 52, procent de blocuri de date în cache (curent): 18
evictat (MB): 228, raport 0.18, suprasarcină (%): 14, contor de evicție severă: 53, procent de blocuri de date în cache (curent): 18
evictat (MB): 228, raport 0.16, suprasarcină (%): 14, contor de evicție severă: 54, procent de blocuri de date în cache (curent): 18
evictat (MB): 228, raport 0.14, suprasarcină (%): 14, contor de evicție severă: 55, procent de blocuri de date în cache (curent): 18
evictat (MB): 112, raport 0.14, suprasarcină (%): -44, contor de evicție severă: 55, procent de blocuri de date în cache (curent): 23 < presiune inversă
evictat (MB): 456, raport 0.26, suprasarcină (%): 128, contor de evicție severă: 56, procent de blocuri de date în cache (curent): 22
evictat (MB): 342, raport 0.31, suprasarcină (%): 71, contor de evicție severă: 57, procent de blocuri de date în cache (curent): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 58, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 59, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 60, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 61, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 62, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 63, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 64, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 65, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 66, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 67, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 68, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 69, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 70, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 71, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 72, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 73, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 74, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 75, current caching DataBlock (%): 22
evacuate (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 76, current caching DataBlock (%): 22
evacuate (MB): 21, ratio 0.33, overhead (%): -90, heavy eviction counter: 76, current caching DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Scan-urile au fost necesare pentru a ilustra același proces sub formă de grafic al proporțiilor între cele două secțiuni ale cache-ului — single (unde ajung blocurile care nu au fost niciodată solicitate) și multi (aici sunt păstrate datele care au fost „solicitate” cel puțin o dată):
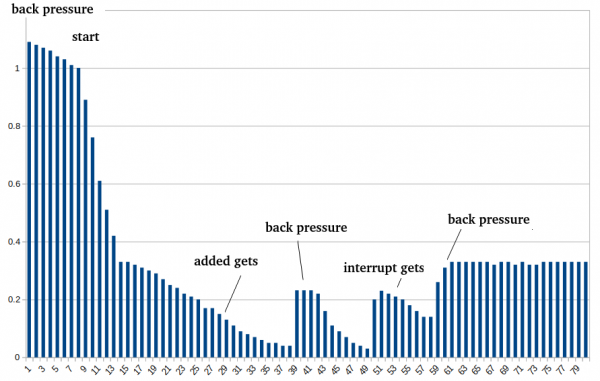
Și în final, cum arată funcționarea parametrilor sub formă de grafic. Pentru comparație, cache-ul a fost complet oprit la început, apoi a fost inițiat HBase cu caching și o întârziere de start a optimizării de 5 minute (30 de cicluri de evacuare).
Codul complet poate fi găsit în Pull Request pe github.
Cu toate acestea, 300 de mii de citiri pe secundă nu sunt tot ce poate fi obținut pe acest hardware în aceste condiții. Problema este că atunci când este necesar să accesați datele prin HDFS, se folosește mecanismul ShortCircuitCache (în continuare SSC), care permite accesul direct la date, evitând interacțiunea de rețea.
Profilarea a arătat că acest mecanism, deși oferă un câștig semnificativ, devine totuși într-un anumit moment o limitare, deoarece practic toate operațiile intensive se desfășoară în cadrul lock-ului, ceea ce duce la blocaje în cea mai mare parte a timpului.
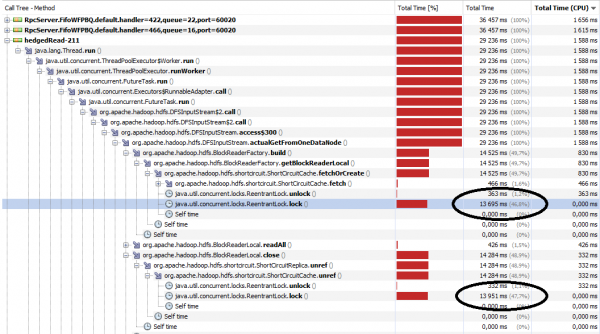
Conștientizând asta, am realizat că problema poate fi ocolită dacă creăm un array de SSC independente:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Și apoi lucrăm cu ele, excluzând intersecțiile și pe ultima cifră a offset-ului:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Acum putem începe testele. Pentru aceasta vom citi fișiere din HDFS cu o aplicație simplă și multi-threaded. Stabilim parametrii:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // în mod default = 1 MB și acest lucru încetinește semnificativ citirea, așa că este mai bine să ne conformăm nevoilor reale
conf.set("dfs.client.short.circuit.num", num); // de la 1 la 10
Și pur și simplu citim fișierele:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Acest cod se execută în fire separate și vom crește numărul de fișiere citite simultan (de la 10 la 200 — axa orizontală) și numărul de cache-uri (de la 1 la 10 — grafice). Axa verticală arată accelerarea pe care o oferă creșterea SSC în comparație cu cazul în care există un singur cache.
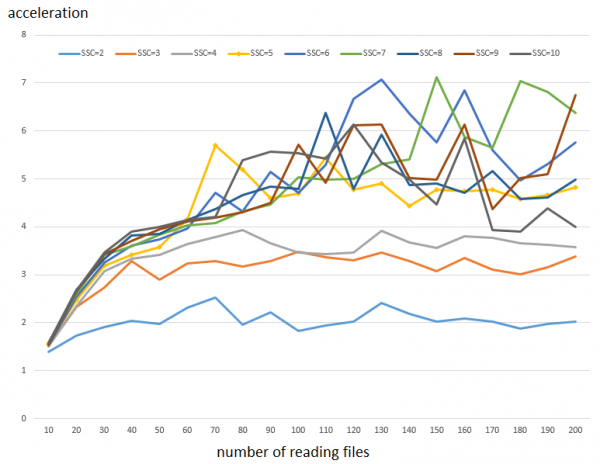
Cum se citește graficul: timpul de execuție pentru 100 de mii de citiri în blocuri de 64 KB cu un singur cache necesită 78 de secunde. În timp ce cu 5 cache-uri, acest lucru se realizează în 16 secunde. Deci, există o accelerare de ~5 ori. După cum se poate observa din grafic, la un număr mic de citiri paralele, efectul nu este foarte vizibil; acesta începe să joace un rol semnificativ atunci când numărul de fire de citire depășește 50. De asemenea, se observă că creșterea numărului de SSC de la 6 în sus oferă un câștig de performanță semnificativ mai mic.
Notă 1: deoarece rezultatele testării sunt destul de volatile (vezi mai jos), au fost efectuate 3 runde de teste, iar valorile obținute au fost medii.
Notă 2: Creșterea performanței de la setarea pentru acces aleatoriu este similară, deși accesul efectiv este puțin mai lent.
Cu toate acestea, este necesar să clarificăm că, spre deosebire de cazul HBase, această accelerare nu este întotdeauna gratuită. Aici mai degrabă „deblocăm” capacitățile CPU pentru a face muncă, în loc să stăm blocați pe blocaje.
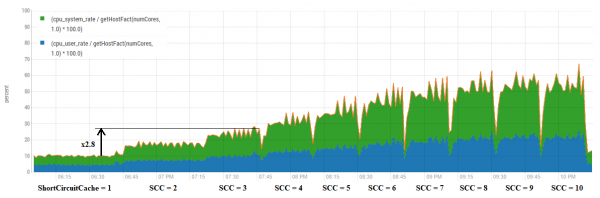
Aici se poate observa că, în general, creșterea numărului de cache-uri oferă o creștere proporțională a utilizării CPU. Cu toate acestea, există câteva combinații mai avantajoase.
De exemplu, să ne uităm mai atent la configurația SSC = 3. Creșterea performanței în acest interval este de aproximativ 3,3 ori. Mai jos sunt rezultatele celor trei execuții separate.
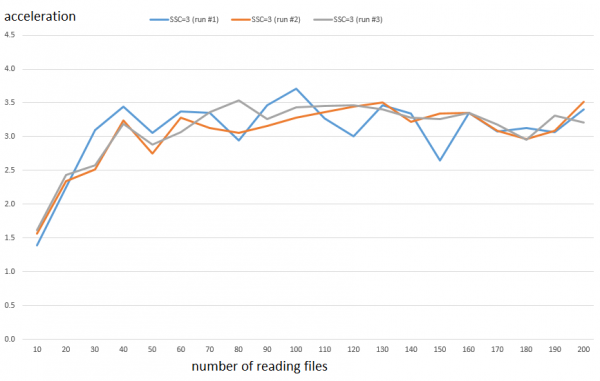
În timp ce consumul de CPU crește de aproximativ 2,8 ori. Diferența nu este foarte mare, dar micuța Greta se bucură deja și poate că va avea timp să meargă la școală și la ore.
Astfel, acest lucru va avea un efect pozitiv pentru orice instrument care utilizează accesul masiv la HDFS (de exemplu, Spark etc.), cu condiția ca codul aplicației să fie ușor (adică blocajul se află pe partea clientului HDFS) și să existe resurse libere pe CPU. Pentru a verifica, să testăm ce efect va avea aplicarea combinată a optimizării BlockCache și a tuning-ului SSC pentru citirea din HBase.
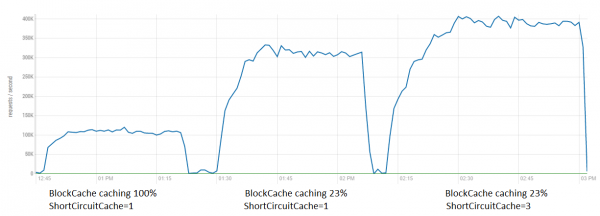
Aici se vede că, în astfel de condiții, efectul nu este atât de mare ca în testele rafinate (citire fără nicio prelucrare), totuși, a extrage încă 80K este destul de realizabil. Împreună, ambele optimizări oferă o accelerare de până la 4 ori.
De asemenea, pentru această optimizare a fost creat un PR , care a fost fuzionat și această funcționalitate va fi disponibilă în următoarele versiuni.
Și, în sfârșit, a fost interesant să comparăm performanța citirii între o bază de date wide-column precum Cassandra și HBase.
Pentru aceasta, au fost lansate instanțe ale utilitarului standard de testare a încărcării YCSB de pe două gazde (800 de fire în total). Pe partea serverului — câte 4 instanțe de RegionServer și Cassandra pe 4 gazde (nu aceleași cu cele pe care rulează clienții, pentru a evita influența lor). Citirile au fost efectuate din tabele de dimensiuni:
HBase — 300 GB pe HDFS (100 GB de date curate)
Cassandra — 250 GB (factor de replicare = 3)
Adică, volumul a fost aproximativ același (în HBase un pic mai mult).
Parametrii HBase:
dfs.client.short.circuit.num = 5 (optimizarea clientului HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — aceasta înseamnă că patch-ul va începe să funcționeze după 30 de evacuații (aproximativ 5 minute)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — volumul țintă pentru caching și evacuare
Jurnalele YCSB au fost analizate și compilate în grafice Excel:
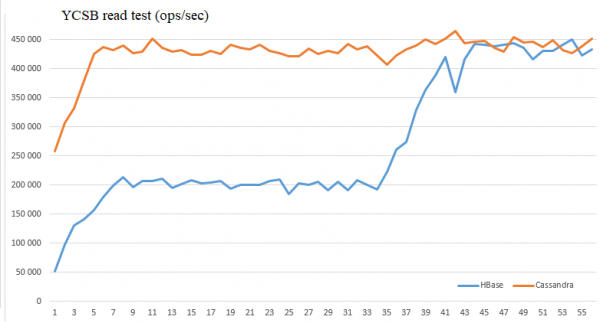
După cum se vede, datele de optimizare permit egalizarea performanței acestor Baze de Date în aceste condiții și atingerea a 450 de mii de citiri pe secundă.
Sperăm că aceste informații pot fi utile cuiva în fascinanta luptă pentru performanță.
Sursa: habr.com
