

Introducere
A venit vremea să cumpăr un sistem de stocare. Ce să aleg, pe cine să ascult? Vendorul A vorbește despre vendorul B, iar mai există integratorul C, care spune opusul și recomandă vendorul D. Într-o astfel de situație, chiar și un arhitect experimentat în sisteme de stocare va fi confuz, mai ales cu toți noii vendor și cu modurile actuale de SDS și hiperconvergență.
Așadar, cum să ne descurcăm în toate acestea și să nu ajungem în situații neplăcute? Noi ( Anton Jbankov și Evghenii Elizarov) vom încerca să explicăm acest lucru în limba română.
Articolul rezonează în mare parte și este de fapt o extensie a „” în ceea ce privește alegerea sistemelor de stocare a datelor și o revizuire a tehnologiilor de stocare. Vom analiza pe scurt teoria generală, dar recomandăm și consultarea articolului menționat.
De ce
Adesea, putem observa cum un nou venit pe un forum sau într-un chat specializat, precum Storage Discussions, pune întrebarea: „îmi oferă două opțiuni de sisteme de stocare - ABC SuperStorage S600 și XYZ HyperOcean 666v4, ce să recomand?”
Și începe o măsură a caracteristicilor implementării unor funcționalități complexe și neclare, care pentru o persoană neexperimentată sunt de-a dreptul greoaie.
Așadar, prima întrebare cheie pe care trebuie să ți-o pui cu mult înainte de a compara specificațiile din ofertele comerciale este - DE CE? De ce ai nevoie de acest sistem de stocare?
Răspunsul va fi surprinzător și foarte în stilul lui Tony Robbins - pentru a stoca date. Mulțumesc, căpitan! Cu toate acestea, uneori ne adâncim atât de mult în comparația detaliilor încât uităm de ce facem toate acestea.
Așadar, scopul sistemului de stocare a datelor este de a stoca și de a oferi acces la DATE cu o performanță specificată. De aici vom începe.
Date
Tipul de date
Ce date intenționăm să stocăm? O întrebare foarte importantă, care poate elimina multe sisteme de stocare din discuție. De exemplu, se preconizează stocarea înregistrărilor video și a fotografiilor. Imediat se pot elimina sistemele concepute pentru acces aleatoriu cu blocuri mici sau sistemele cu caracteristici proprii în ceea ce privește comprimarea / deduplicarea. Acestea pot fi sisteme excelente, nu dorim să spunem nimic rău despre ele. Dar, în acest caz, punctele lor forte pot deveni, dimpotrivă, slabe (video și fotografii nu se comprimă) sau pur și simplu vor crește semnificativ costul sistemului.
Și invers, dacă utilizarea țintă este o bază de date tranzacțională încărcată, atunci sistemele excelente de streaming pentru multimedia, capabile să furnizeze gigaocteți pe secundă, vor fi o alegere proastă.
Volumul de date
Câte date intenționăm să stocăm? Cantitatea se transformă întotdeauna în calitate, nu trebuie să uităm niciodată de acest lucru, mai ales în zilele noastre când volumul de date crește exponențial. Sistemele de clasă petabyte nu mai sunt o raritate, dar cu cât volumul de petabyte este mai mare, cu atât sistemul devine mai specializat, iar funcționalitatea obișnuită a sistemelor cu acces aleatoriu de mici și medii dimensiuni va fi mai puțin disponibilă. Pur și simplu pentru că doar tabelele statistice de acces pe blocuri devin mai mari decât volumul de memorie disponibil pe controlere. Nemaivorbind de comprimare / tiering. Să presupunem că dorim să schimbăm algoritmul de comprimare cu unul mai puternic și să comprimăm 20 de petabyte de date. Cât timp va dura: șase luni, un an?
Pe de altă parte, de ce să complicăm lucrurile, dacă trebuie să stocăm și să procesăm 500 GB de date? Numai 500. SSD-urile de uz casnic (cu un DWPD scăzut) de acest volum costă foarte puțin. De ce să construim o fabrică de Fiber Channel și să cumpărăm un sistem de stocare extern de înaltă clasă, care costă cât un pod de fontă?
Ce procent din volumul total reprezintă datele fierbinți? Cât de neuniformă este încărcătura pe volum de date? Aici poate ajuta foarte mult tehnologia de stocare stratificată sau Flash Cache, dacă volumul datelor fierbinți este nesemnificativ comparativ cu totalul. Sau, dimpotrivă, în cazul unei încărcări uniforme pe tot volumul, frecvent întâlnite în sistemele de flux (supraveghere video, unele sisteme de analiză), astfel de tehnologii nu vor aduce beneficii și doar vor crește costul / complexitatea sistemului.
IS
Cealaltă față a datelor este un sistem informațional care utilizează aceste date. IS are un set de cerințe care derivă din date. Detalii despre IS pot fi găsite în „Proiectarea unui centru de date virtualizat”.
Cerințe de redundanță / disponibilitate
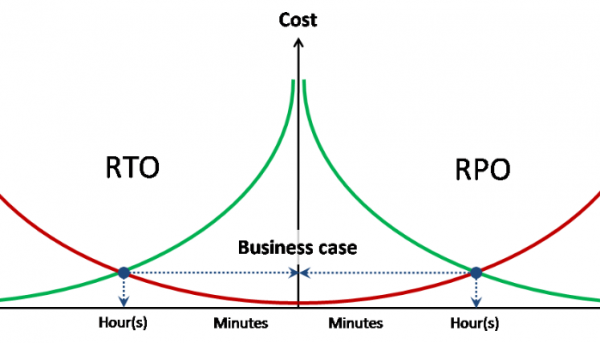
Cerințele de redundanță / disponibilitate a datelor sunt moștenite de la IS și se exprimă în trei valori — RPO, RTO, a.
Disponibilitate — proporția pentru o anumită perioadă de timp, în care datele sunt disponibile pentru a fi utilizate. De obicei, se exprimă prin numărul de 9. De exemplu, două dintre nouă într-un an înseamnă că disponibilitatea este de 99%, sau altfel spus, se permite o indisponibilitate de 95 de ore pe an. Trei dintre nouă — 9,5 ore pe an.
RPO / RTO — acestea sunt indicatori care nu sunt cumulativi, ci pentru fiecare incident (accident), spre deosebire de disponibilitate.
RPO — volumul de date pierdute în cazul unui accident (în ore). De exemplu, dacă backup-ul se face o dată pe zi, atunci RPO = 24 de ore. Adică, în cazul unui accident și pierderii complete a sistemului de stocare, se pot pierde date de până la 24 de ore (de la ultimul backup). Pe baza RPO stabilit pentru IS, se elaborează un regulament pentru backup. De asemenea, pe baza RPO, se poate înțelege cât de necesară este replicarea sincronă / asincronă a datelor.
RTO — timpul de recuperare a serviciului (acces la date) după un accident. Pe baza valorii RTO stabilite, putem înțelege dacă este necesar un metrocluster sau este suficientă replicarea unidirecțională. De asemenea, dacă este necesară o stocare hi-end cu mai multe controlere.
Cerințe de performanță
Cu toate că aceasta este o întrebare destul de evidentă, de aici apar cele mai multe dificultăți. În funcție de faptul dacă aveți deja o infrastructură sau nu și se vor construi căi pentru colectarea statisticilor necesare.
Aveți deja un sistem de stocare de date (SXD) și căutați o înlocuire sau doriți să achiziționați unul suplimentar pentru extindere. Totul este simplu aici. Înțelegeți ce servicii aveți deja și ce plănuiți să implementați în viitorul apropiat. Pe baza serviciilor actuale, aveți posibilitatea să colectați statistici de performanță. Stabiliți numărul actual de IOPS și întârzierile curente - care sunt aceste valori și sunt suficiente pentru necesitățile voastre? Puteți face acest lucru atât pe sistemul de stocare a datelor, cât și din partea gazdelor care sunt conectate la acesta.
Și este important să nu analizați doar sarcina curentă, ci pe o anumită perioadă (ideal o lună). Observați care sunt vârfurile maxime în timpul zilei, ce sarcină generează backup-urile etc. Dacă SXD-ul sau software-ul asociat nu vă oferă un set complet de aceste date, puteți folosi RRDtool gratuit, care poate lucra cu cele mai populare SXD-uri și switch-uri și vă poate oferi statistici detaliate de performanță. De asemenea, este bine să monitorizați sarcina și pe gazdele care lucrează cu acest SXD, pe mașinile virtuale specifice sau pe ceea ce anume funcționează pe această gazdă.
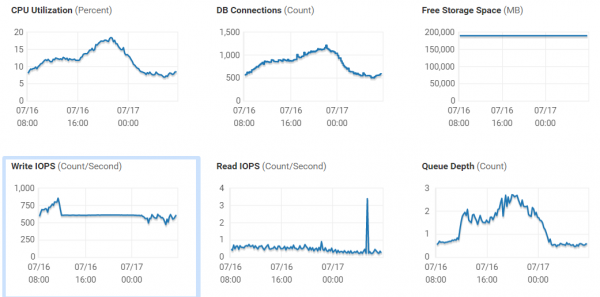
Merită să menționez separat că, dacă întârzierile de pe volum și de pe datastorul situat pe acest volum diferă semnificativ, ar trebui să acordați o atenție deosebită rețelei voastre SAN; există o probabilitate mare ca aceasta să aibă probleme, iar înainte de a achiziționa un nou sistem, ar trebui să clarificați această problemă, deoarece există o șansă ridicată de a îmbunătăți performanța sistemului actual.
Construiți o infrastructură de la zero sau achiziționați un sistem pentru un nou serviciu despre care nu aveți informații asupra sarcinilor. Aici există câteva opțiuni: discutați cu colegii pe resurse de specialitate pentru a încerca să obțineți și să prognozați sarcina, contactați un integrator care are experiență în implementarea unor astfel de servicii și care vă poate calcula sarcina. A treia opțiune (de obicei cea mai dificilă, mai ales dacă este vorba despre aplicații personalizate sau rare) este să încercați să descoperiți cerințele de performanță de la dezvoltatorii sistemului.
Și, atenție, cea mai corectă variantă din punct de vedere practic este un pilot pe echipamentul actual sau pe echipamentul furnizat pentru testare de către vendor / integrator.
Cerințe speciale
Cerințele speciale sunt toate acele aspecte care nu se încadrează în cerințele de performanță, disponibilitate și funcționalitate în ceea ce privește prelucrarea și furnizarea datelor.
Unul dintre cele mai simple cerințe speciale pentru un sistem de stocare a datelor poate fi considerat „media de informație transferabilă”. Și devine imediat evident că acest sistem de stocare a datelor trebuie să includă o bibliotecă de benzi sau pur și simplu un streamer pe care se salvează o copie de rezervă. După aceea, o persoană special instruită semnează banda și o duce cu mândrie într-un seif special.
Un alt exemplu de cerință specială este construcția protejată împotriva șocurilor.
Unde
A doua componentă principală în alegerea unui anumit sistem de stocare a datelor este informația despre LOCUL unde va fi amplasat acest sistem. De la geografie sau condiții climatice, până la personal.
Client
Pentru cine este planificat acest sistem de stocare a datelor? Întrebarea se bazează pe următoarele considerații:
Client guvernamental / comercial.
Clientul comercial nu are restricții și nu este obligat să organizeze licitații, cu excepția regulilor interne proprii.
Clientul guvernamental este o altă chestiune. 44 FZ și celelalte aspecte ale licitațiilor și cerințelor tehnice, care pot fi contestate.
Client sub sancțiuni
Aici întrebarea este foarte simplă — alegerea se limitează doar la ofertele disponibile pentru acest client.
Reguli interne / furnizori autorizați pentru achiziție / modele
Întrebarea este, de asemenea, extrem de simplă, dar trebuie avută în vedere.
Unde fizic
În această parte, discutăm toate problemele legate de geografie, canale de comunicare și microclimatul din camera de amplasare.
Personal
Cine va lucra cu acest sistem de stocare a datelor? Este la fel de important ca ceea ce poate face efectiv sistemul.
Oricât de promițătoare și admirabilă ar fi soluția de stocare de la vendorul A, nu are sens să o implementăm dacă personalul știe să lucreze doar cu vendorul B, și nu sunt planificate achiziții ulterioare sau colaborări constante cu A.
Și, bineînțeles, un alt aspect al problemei este cât de disponibil este personalul pregătit în această locație geografică, atât în cadrul companiei, cât și potențial pe piața muncii. Pentru anumite regiuni, poate avea o semnificație semnificativă alegerea unui sistem de stocare (СХД) cu interfețe simple sau cu posibilitatea unei gestionări centralizate de la distanță. Altfel, într-un anumit moment, poate deveni foarte complicat. Internetul este plin de povești despre cum un nou angajat, proaspăt absolvent, a configurat lucruri atât de greșit încât întreaga companie a fost afectată.
Mediu
Ei bine, și bineînțeles, o întrebare importantă este în ce mediu va funcționa acest СХД.
- Ce anume cu alimentarea electrică / răcirea?
- Ce tip de conectare?
- Unde va fi instalat?
- Și așa mai departe.
Adesea, aceste întrebări sunt considerate de la sine înțelese și nu sunt analizate în detaliu, dar uneori ele pot schimba complet situația.
Ce?
vendor
În prezent (mijlocul anului 2019), piața СХД din Rusia poate fi împărțită în 5 categorii convenționale:
- Într-o ligă superioară — companii renumite cu o gamă largă de produse, de la cele mai simple unități de discuri până la cele hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Într-o ligă secundară — companii cu o gamă limitată, jucători de nișă, furnizori serioși de SDS sau noi veniți promițători (Fujitsu, Datacore, Infinidat, Huawei, Pure etc.)
- Într-o ligă terță — soluții de nișă de nivel low-end, SDS ieftine, creații improvizate pe bază de ceph și alte proiecte open source (Infortrend, Starwind etc.)
- Segmentul SOHO — СХД mici și foarte mici la nivel de casă / mic birou (Synology, QNAP etc.)
- СХД-uri cu componente produse intern — includ atât hardware din liga întâi cu etichete schimbate, cât și câțiva reprezentanți din liga a doua (RAIDIX, le vom acorda un avans), dar în principal sunt din liga a treia (Aerodisk, Baum, Depo etc.)
Împărțirea este destul de convențională și nu înseamnă că segmentul terț sau SOHO sunt slabe și nu pot fi utilizate. În proiecte specifice cu un set bine definit de date și profil de sarcină, ele pot funcționa foarte bine, depășind liga întâi în ceea ce privește raportul calitate/preț. Este important mai întâi să ne clarificăm sarcinile, perspectivele de creștere, funcționalitățile necesare — și atunci Synology vă va servi cu credință și devotament, iar părul va deveni moale și mătăsos.
Unul dintre factorii importanți în alegerea unui furnizor este mediul existent. Ce tipuri de stocare aveți deja, cu ce soluții de stocare pot colabora inginerii. Aveți nevoie de un alt furnizor, de un alt punct de contact, veți migra treptat întreaga încărcătură de la furnizorul A la furnizorul B?
Nu ar trebui să creați entități mai mult decât este necesar.
iSCSI / FC / File
Privind protocoalele de acces, nu există o opinie unanimă printre ingineri, iar disputele seamănă mai mult cu discuții teologice decât cu cele inginerești. Totuși, în general, se pot menționa următoarele puncte:
FCoE este mai mult mort decât viu.
FC vs iSCSI. Unul dintre avantajele cheie ale FC în 2019 în comparație cu soluțiile de stocare IP, o fabrică dedicată pentru accesul la date, este contrabalansat de o rețea IP dedicată. Nu există avantaje globale ale FC față de rețelele IP și pe IP pot fi construite soluții de stocare de orice nivel de încărcare, inclusiv sisteme pentru baze de date mari pentru ABS-urile băncilor mari. Pe de altă parte, de ani de zile se prezice moartea FC-ului, dar mereu apare ceva care o împiedică. Astăzi, de exemplu, unii jucători de pe piața soluțiilor de stocare dezvoltă activ standardul NVMeoF. Dacă acesta va împărți soarta FCoE — rămâne de văzut.
Accesul la fișiere nu este, de asemenea, ceva desconsiderat. NFS / CIFS se comportă excelent în medii productive și, dacă sunt proiectate corect, nu au mai multe reclamații decât protocoalele de blocare.
Hibrid / All Flash Array
Soluțiile de stocare clasice sunt de două tipuri:
- AFA (All Flash Array) — sisteme optimizate pentru utilizarea SSD.
- Hibrid — permit utilizarea atât a HDD-urilor, cât și a SSD-urilor sau a combinațiilor lor.
Principala lor diferență constă în tehnologiile de stocare susținute și nivelul maxim de performanță (indicii ridicați IOPS și latențe scăzute). Ambele tipuri de sisteme (în majoritatea modelor lor, cu excepția segmentului low-end) pot funcționa atât ca dispozitive bloc, cât și ca file. Nivelul sistemului determină funcționalitatea susținută, iar la modelele inferioare, aceasta este adesea limitată la niveluri minime. Este important să acordăm atenție acestui aspect atunci când studiem specificațiile unui model specific, și nu doar capacitățile întregii game în ansamblu. De asemenea, evident, nivelul sistemului influențează caracteristicile sale tehnice, cum ar fi procesorul, capacitatea memoriei, cache-ul, numărul și tipurile de porturi etc. Din perspectiva gestionării, AFA se diferențiază de sistemele hibride (pe disc) doar în ceea ce privește implementarea mecanismelor de lucru cu SSD-uri, iar chiar dacă folosiți SSD-uri într-un sistem hibrid, nu înseamnă că veți putea obține un nivel de performanță similar cu cel al unui sistem AFA. De asemenea, în majoritatea cazurilor, mecanismele inline de stocare eficientă sunt dezactivate în sistemele hibride, iar activarea acestora duce la pierderi de performanță.
Sisteme de stocare speciale
Pe lângă sistemele de stocare de uz general, dedicate în principal prelucrării rapide a datelor, există sisteme de stocare speciale cu principii cheie, fundamental diferite de cele obișnuite (latență scăzută, multe IOPS):
Media.
Aceste sisteme sunt concepute pentru stocarea și prelucrarea fișierelor media, care au dimensiuni mari. Prin urmare, latența devine practic irrelevantă, iar capacitatea de a trimite și primi date pe o lățime de bandă largă în mai multe fluxuri paralele devine principală.
Sisteme de stocare cu deduplicare pentru copiile de siguranță.
Deoarece copiile de siguranță diferă puțin între ele în condiții normale (o copie de siguranță medie diferă de cea de ieri cu 1-2%), această clasă de sisteme comprimă datele înregistrate pe ele într-un număr relativ mic de suporturi fizice. De exemplu, în anumite cazuri, coeficientii de compresie a datelor pot ajunge la 200 la 1.
Sisteme de stocare obiectuală.
În aceste SCD nu există volume obișnuite cu acces prin blocuri și partajări de fișiere, ci mai mult seamănă cu o bază de date imensă. Accesul la un obiect stocat într-un astfel de sistem se face printr-un identificator unic sau prin metadate (de exemplu, toate obiectele în format JPEG, cu data creării între XX-XX-XXXX și YY-YY-YYYY).
Sisteme de conformitate.
Nu sunt foarte frecvente în Rusia astăzi, dar merită menționate. Scopul acestor SCD este de a asigura stocarea garantată a datelor pentru respectarea politicilor de securitate sau a cerințelor regulatorilor. În unele sisteme (de exemplu, EMC Centera) a fost implementată o funcție de interzicere a ștergerii datelor — de îndată ce cheia este întoarsă iar sistemul intră în această mod, nici administratorul, nici nimeni altcineva nu pot șterge fizic datele deja înregistrate.
Tehnologii proprii
Cache flash
Cache Flash – un termen comun pentru toate tehnologiile proprii de utilizare a memoriei flash ca memorie cache de nivel secundar. Atunci când se utilizează cache flash, SCD este de obicei calculat pentru a face față unei sarcini stabilite de pe discurile magnetice, în timp ce vârful este servit de cache.
În acest context, este important să înțelegem profilul sarcinii și gradul de localizare a accesărilor la blocurile volumelor de stocare. Cache flash este o tehnologie pentru sarcini cu o localizare ridicată a cererilor și este practic inaplicabilă pentru volumele cu o încărcare uniformă (cum ar fi în sistemele de analiză).
Pe piață există două implementări ale cache-ului flash:
- Read Only. În acest caz, sunt cache-uite doar datele pentru citire, iar scrierea se face direct pe discuri. Unii producători, cum ar fi NetApp, consideră că scrierea pe SCD-urile lor se face deja într-un mod optim, iar cache-ul nu va ajuta.
- Read/Write. Se cache-ază nu doar citirile, ci și scrierile, ceea ce permite tamponarea fluxului și reduce impactul RAID Penalty, crescând astfel performanța generală pentru SCD-uri cu un mecanism de scriere nu atât de optim.
Tiering
Stocarea multi-nivel (tiering) este o tehnologie care combină nivele de stocare cu performanțe diferite, cum ar fi SSD și HDD, într-un singur pool de discuri. În cazul unei persistențe accentuate a apelurilor către blocurile de date, sistemul va putea reechilibra automat blocurile de date, mutând cele încărcate pe un nivel cu performanțe ridicate, iar cele rece, dimpotrivă, pe un nivel mai lent.
Sistemele hibride din clasele inferioară și medie utilizează stocare stratificată cu mutarea datelor între straturi conform unui program. În acest context, dimensiunea blocului de stocare stratificată la cele mai bune modele este de 256 MB. Aceste caracteristici nu permit considerarea tehnologiei de stocare stratificată ca o tehnologie de creștere a performanței, așa cum greșit cred mulți. Stocarea stratificată în sistemele din clasele inferioară și medie reprezintă o tehnologie de optimizare a costurilor de stocare pentru sisteme cu o încărcare inegal distribuită.
Snapshot
Oricât de mult am vorbi despre fiabilitatea sistemelor de stocare a datelor, există numeroase oportunități de a pierde date, nesusținute de probleme hardware. Acestea pot fi viruși, hackeri sau orice altă ștergere/daunare neintenționată a datelor. Din acest motiv, backup-ul datelor productive este o parte esențială a muncii inginerilor.
Snapshot-ul este o captură a volumului la un anumit moment. Atunci când lucrăm cu majoritatea sistemelor, cum ar fi virtualizarea, bazele de date etc., este necesar să facem o astfel de captură din care să copiem datele într-un backup, în timp ce sistemele noastre de informații pot continua să lucreze cu acest volum. Totuși, trebuie să ne amintim că nu toate snapshot-urile sunt la fel de utile. Diferite furnizori au abordări diferite pentru crearea snapshot-urilor, legate de arhitectura lor.
CoW (Copy-On-Write). Atunci când se încearcă scrierea unui bloc de date, conținutul său original este copiat într-o zonă specială, după care scrierea se efectuează normal. Astfel, se previne deteriorarea datelor din snapshot. Evident, toate aceste manipulări „parazite” cu datele generează o încărcare suplimentară pe sistemul de stocare a datelor și din acest motiv, furnizorii cu o astfel de implementare nu recomandă utilizarea a mai mult de zece snapshot-uri, iar pe volumele foarte solicitate, să nu fie folosite deloc.
RoW (Redirect-on-Write). În acest caz, volumul original este practic înghețat, iar la încercarea de a scrie un bloc de date, sistemul de stocare scrie datele într-o zonă specială din spațiul liber, schimbând locația acestui bloc în tabela de metadate. Acest lucru permite reducerea numărului de operațiuni de rescriere, ceea ce, în cele din urmă, anulează scăderea performanței și elimină restricțiile asupra snapshot-urilor și numărului acestora.
Snapshot-urile sunt de asemenea de două tipuri în raport cu aplicațiile:
Consistentă aplicație. În momentul creării snapshot-ului, sistemul de stocare solicită agenților din sistemul de operare al utilizatorului să forțeze golirea cache-urilor de disc din memorie pe disc și să solicite acest lucru aplicației. În acest caz, la restaurarea din snapshot, datele vor fi consistente.
Consistentă crash. În acest caz, nimic de acest fel nu se întâmplă și snapshot-ul este creat așa cum este. La restaurarea dintr-un astfel de snapshot, imaginea este identică cu cea în care alimentarea a fost întreruptă brusc și este posibilă o anumită pierdere de date, care au rămas în cache și nu au ajuns pe disc. Aceste snapshot-uri sunt mai simple de implementat și nu generează o scădere a performanței aplicațiilor, dar sunt mai puțin fiabile.
De ce sunt necesare snapshot-urile în sistemele de stocare a datelor?
- Backup fără agent direct de la sistemul de stocare
- Crearea de medii de testare pe baza datelor reale
- În cazul sistemelor de stocare a fișierelor, poate fi utilizat pentru crearea de medii VDI prin utilizarea snapshot-urilor în loc de hypervisor
- Asigurarea unor RPO deosebit de reduse prin crearea de snapshot-uri programate cu o frecvență semnificativ mai mare decât frecvența de backup
Clonare
Clonarea volumului – funcționează pe un principiu similar cu snapshot-urile, dar servește nu doar pentru citirea datelor, ci pentru a lucra efectiv cu acestea. Avem posibilitatea de a obține o copie exactă a volumului nostru, cu toate datele de pe acesta, fără a face o copie fizică, ceea ce va economisi spațiu. Clonarea volumelor este utilizată de obicei fie în Test & Dev, fie dacă doriți să verificați funcționalitatea unor actualizări pe sistemul dumneavoastră informațional. Clonarea va permite să faceți acest lucru cât mai repede și mai economicos din punct de vedere al resurselor de disc, deoarece vor fi înregistrate doar blocurile de date modificate.
Replicare / journaling
Replicarea – mecanismul de crearea a unei copii a datelor pe un alt sistem de stocare fizic. De obicei, există o tehnologie proprie fiecărui furnizor, care lucrează doar în cadrul propriei game. De asemenea, există soluții externe, inclusiv cele care lucrează la nivel de hypervisor, cum ar fi VMware vSphere Replication.
Funcționalitatea tehnologiilor proprietare și ușurința utilizării acestora depășesc de obicei soluțiile standard, dar devin inaplicabile atunci când, de exemplu, este necesară realizarea unei replicări de la NetApp la HP MSA.
Replicarea se împarte în două subtipuri:
Sincronă. În cazul replicării sincrone, operațiunea de scriere este trimisă imediat la a doua unitate de stocare și nu se confirmă executarea până când unitatea de stocare de la distanță nu confirmă. Datorită acestui fapt, crește latența accesului, dar avem o copie exactă a datelor. Asta înseamnă că RPO = 0 în cazul pierderii unității de stocare principale.
Asincronă. Operațiunile de scriere sunt executate doar pe unitatea de stocare principală și sunt confirmate imediat, acumulându-se în paralel într-un buffer pentru transmiterea în loturi către unitatea de stocare de la distanță. Acest tip de replicare este relevant pentru datele mai puțin valoroase sau pentru canale cu lățimi de bandă mici sau cu o latență mare (caracteristică pentru distanțe mai mari de 100 km). Astfel, RPO = frecvența de trimitere a loturilor.
Adesea, împreună cu replicarea există un mecanism de jurnalizare a operațiunilor pe disc. În acest caz, se alocă o zonă specială pentru jurnalizare și se păstrează operațiuni de scriere până la o anumită adâncime în timp sau limitate de volumul jurnalului. Pentru anumite tehnologii proprietare, precum EMC RecoverPoint, există integrarea cu software-ul de sistem care permite legarea unor marcaje specifice la o anumită înregistrare în jurnal. Datorită acestui fapt, este posibil să se revină la starea volumului (sau să se creeze un clon) nu doar la 23 aprilie, ora 11:59:13 milisecunde, ci la momentul anterior „DROP ALL TABLES; COMMIT”.
Metro cluster
Metro cluster este o tehnologie care permite crearea unei replicări sincrone bidirecționale între două unități de stocare, astfel încât din punct de vedere exterior acea pereche să apară ca o singură unitate de stocare. Este utilizată pentru crearea de clustere cu brațe geografic dispersate pe distanțe de metrou (mai puțin de 100 km).
În exemplul utilizării într-un mediu de virtualizare, metro cluster permite crearea unui datastore cu mașini virtuale, disponibil pentru scriere simultan din două centre de date. În acest caz, se creează un cluster la nivelul hypervisor-ilor, format din gazde din diferite centre de date fizice, conectat la acest datastore. Acest lucru permite realizarea următoarelor:
- Automatizarea completă a procesului de recuperare după distrugerea unuia dintre centrele de date. Fără niciun instrument suplimentar, toate VM-urile care funcționau în centrul de date distrus vor fi repornite automat în cel rămas. RTO = timpul de așteptare al clusterului de înaltă disponibilitate (15 secunde pentru VMware) + timpul de încărcare a sistemului de operare și pornirea serviciilor.
- Evitarea dezastrelor sau, pe românește, prevenirea catastrofelor. Dacă sunt planificate lucrări de alimentare cu energie în centrul de date 1, avem posibilitatea de a migra întreaga încărcătură importantă în centrul de date 2 înainte de începerea lucrărilor.
Virtualizare
Virtualizarea sistemelor de stocare — este utilizarea tehnică a volumelor de la un alt sistem de stocare ca discuri. Virtualizatorul sistemului de stocare poate pur și simplu să extindă un volum străin către consumator ca și cum ar fi al său, în paralel cu oglindirea acestuia pe un alt sistem de stocare, sau chiar să creeze un RAID din volume externe.
Reprezentanții clasici ai virtualizării sistemelor de stocare sunt EMC VPLEX și IBM SVC. Desigur, sistemele de stocare cu funcție de virtualizare — NetApp, Hitachi, IBM / Lenovo Storwize.
De ce poate fi necesar?
- Rezervare la nivel de sistem de stocare. Se creează o oglindă între volume, iar o parte poate fi pe HP 3Par, iar cealaltă pe NetApp. Și virtualizatorul de la EMC.
- Migrarea datelor cu un timp minim de nefuncționare între sistemele de stocare ale diferitelor producători. Presupunem că datele trebuie migrate de pe un vechi 3Par, care va fi scos din uz, pe un nou Dell. În acest caz, consumatorii se deconectează de la 3Par, volumele sunt extinse sub VPLEX și sunt prezentate din nou consumatorilor. Deoarece nu s-a modificat nimic pe volum, activitatea continuă. În fundal, procesul de oglindire a volumului pe noul Dell se lansează, iar la finalizare oglinda este distrusă, iar 3Par este deconectat.
- Organizarea metroclustere.
Compresie / deduplicare
Compresia și deduplicarea sunt tehnologiile care vă permit să economisiți spațiu pe disk în sistemul dvs. de stocare. Merită menționat încă de la început că nu toate datele pot fi supuse compresiei și / sau deduplicării în principiu, iar unele tipuri de date se comprima și deduplica mai bine, iar altele, dimpotrivă.
Compresia și deduplicarea se împart în 2 tipuri:
Inline — comprimarea și deduplicarea blocurilor de date se realizează înainte de a scrie aceste date pe disc. Astfel, sistemul calculează doar hash-ul blocului și îl compară cu tabela de hash-uri deja existente. În primul rând, acest proces este mai rapid decât simpla scriere pe disc, iar în al doilea rând, nu consumăm spațiu pe disc inutil.
Post — atunci când aceste operații sunt efectuate deja pe datele scrise, care se află pe discuri. Așadar, datele sunt întâi scrise pe disc, iar abia apoi se calculează hash-ul și se elimină blocurile inutile, eliberând resursele de disc.
Merită menționat că majoritatea furnizorilor utilizează ambele tipuri, ceea ce permite optimizarea acestor procese și, prin urmare, creșterea eficienței lor. Majoritatea furnizorilor de SMB au utilitare disponibile care permit analiza seturilor dumneavoastră de date. Aceste utilitare funcționează pe aceeași logică implementată în SMB, astfel încât nivelul estimativ de eficiență va corespunde. De asemenea, nu trebuie uitat că mulți furnizori au programe de garanție a eficienței, care promite un nivel nu mai mic decât cel declarat pentru anumite (sau toate) tipuri de date. Și nu trebuie ignorată această programă, deoarece, calculând sistemul pentru nevoile dumneavoastră, ținând cont de coeficientul de eficiență al sistemului specific, puteți economisi la volum. De asemenea, este important să rețineți că aceste programe sunt proiectate pentru sistemele AFA, dar prin achiziționarea unui volum mai mic de SSD decât HDD-urile în sistemele tradiționale, se poate reduce costul, iar dacă nu se ajunge la prețul unui sistem de disc, se va apropia considerabil de acesta.
Model
Și aici ajungem la întrebarea corect formulată.
“Mi se oferă două opțiuni de SMB — ABC SuperStorage S600 și XYZ HyperOcean 666v4, ce recomandați?”
Se transformă în “Mi se oferă două opțiuni de SMB — ABC SuperStorage S600 și XYZ HyperOcean 666v4, ce recomandați?
Încărcarea țintă constă în mașini virtuale mixte VMware din mediile de producție / testare / dezvoltare. Test = producție. 150 TB pentru fiecare, cu o performanță de vârf de 80 000 IOPS, blocuri de 8kb, 50% acces aleatoriu, 80/20 citire-scriere. 300 TB pentru dezvoltare, unde 50 000 IOPS vor fi suficienți, 80 acces aleatoriu, 80 scriere.
Producția este, probabil, într-un metrocluster RPO = 15 minute, RTO = 1 oră, dezvoltarea în replicare asincronă RPO = 3 ore, testul pe un singur site.
Va fi un SGBD de 50TB, ar fi bine să avem jurnalizare pentru acestea.
Avem servere Dell peste tot, iar sistemele de stocare sunt vechi Hitachi, care abia fac față, planificăm o creștere a sarcinii de 50% în volum și performanță.
Așa cum se spune, întrebarea formulată corect conține 80% din răspuns.
Informații suplimentare
Ce ar trebui să cunoască suplimentar, în opinia autorilor
Cărți
- Oлифер și Олифер “Rețele de computere”. Cartea va ajuta la sistematizarea și poate la o mai bună înțelegere a modului în care funcționează mediul de transmisie de date pentru sistemele de stocare IP / Ethernet.
- “EMC Information Storage and Management”. O carte minunată despre bazele sistemelor de stocare, de ce, cum și pentru ce.
Forumuri și chat-uri
Recomandări generale
Prețuri
Acum, în ceea ce privește prețurile — în general, prețurile pentru sisteme de stocare sunt adesea doar prețuri de listă, din care fiecare client primește un discount individual. Mărimea discountului depinde de un număr mare de parametri, astfel că este imposibil să se prevadă ce preț final va obține exact compania dumneavoastră fără a face o solicitare către distribuitor. Totuși, în ultima vreme, modelele low-end au început să apară în magazinele obișnuite de computere, cum ar fi, de exemplu, sau . Acolo puteți achiziționa imediat sistemul care vă interesează la un preț fix, la fel ca orice componente de computer.
Dar este important de menționat că o comparație directă între TB/$ nu este corectă. Dacă privim din acest punct de vedere, cea mai ieftină soluție ar fi un simplu JBOD + server, care nu va oferi nici flexibilitatea, nici fiabilitatea pe care o asigură o SGBD completă, cu două controlere. Acest lucru nu înseamnă că JBOD este o soluție proastă, ci că trebuie să înțelegeți foarte clar — cum și în ce scopuri veți utiliza această soluție. Adesea se poate auzi că în JBOD nu are ce să se strice, deoarece există un singur backplane. Totuși, și backplane-urile pot da greș. Totul se strică mai devreme sau mai târziu.
În concluzie
Compararea sistemelor între ele nu ar trebui să se facă doar pe baza prețului sau doar pe baza performanței, ci pe baza unei combinații a tuturor indicatorilor.
Cumpărați HDD doar dacă sunteți siguri că aveți nevoie de ele. Pentru sarcini de lucru reduse și tipuri de date nescompressibile, ar trebui să luați în considerare programele de garanție a eficienței stocării pe SSD, care sunt acum disponibile de la majoritatea furnizorilor (și funcționează cu adevărat, chiar și în România), dar totul depinde de aplicațiile și datele care vor fi stocate pe această soluție de stocare.
Nu urmăriți economia excesivă. Uneori, acest lucru ascunde numeroase probleme neplăcute, unul dintre care Evgheni Elizarov l-a descris în articolele sale despre . Și ceea ce, în cele din urmă, această economie vă poate costa mai mult. Nu uitați - „achizitorul sărăcărește de două ori”.
Sursă: habr.com
