

Bună, habrovcanilor. Astăzi încep cursurile pentru primul grup al cursului . În acest context, dorim să vă povestim despre cum a decurs webinarul deschis pe acest curs.
În am discutat despre provocările cu care s-au confruntat bazele de date SQL în era cloud-ului și Kubernetes. De asemenea, am analizat cum se adaptează și transformă bazele de date SQL sub influența acestor provocări.
Webinarul a fost susținut de , Google Cloud Practice Delivery Manager la EPAM Systems.
Când copacii erau mici...
La început, hai să ne amintim cum a început alegerea SGBD-ului la sfârșitul secolului trecut. De fapt, nu va fi greu, deoarece alegerea SGBD-ului în acele vremuri începea și se termina Oracle.
La sfârșitul anilor '90 — începutul anilor 2000, nu existau multe opțiuni, în esență, în ceea ce privește SGBD-urile scalabile industrial. Da, existau IBM DB2, Sybase și alte baze de date care apăreau și dispăreau, dar, în general, ele nu erau atât de vizibile în comparație cu Oracle. Prin urmare, abilitățile inginerilor din acele vremuri erau, într-o oarecare măsură, legate de acel singur aspect existent.
Un DBA Oracle trebuia să știe:
- să instaleze Oracle Server din distribuție;
- să configureze Oracle Server:
- init.ora;
- listener.ora;
— să creeze:
- spații de tabele;
- scheme;
- utilizatori;
— să efectueze backup și restaurare;
— să monitorizeze;
— să combată interogările neoptimizate.
În același timp, nu era necesar de la un DBA Oracle:
- să știe să aleagă SGBD-ul optim sau o altă tehnologie de stocare și procesare a datelor;
- să asigure disponibilitate ridicată și scalabilitate orizontală (acesta nu era întotdeauna un domeniu de competență al DBA-ului);
- să aibă cunoștințe solide despre domeniul de aplicare, infrastructură, arhitectura aplicațiilor, sistemul de operare;
- să efectueze încărcarea și descărcarea datelor, migrarea datelor între diferite SGBD-uri.
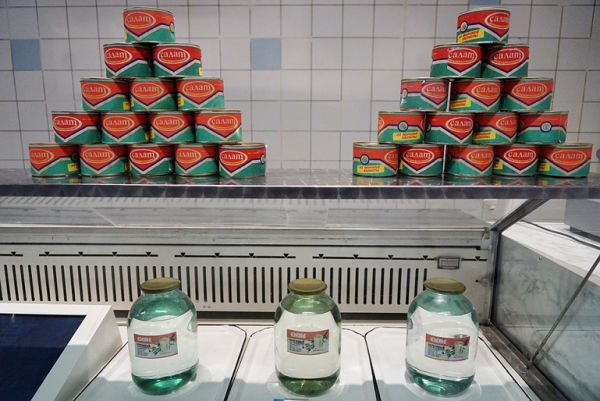
În general, dacă discutăm despre alegere în acele vremuri, se aseamănă cu alegerea dintr-un magazin sovietic la sfârșitul anilor '80:
Timpul nostru
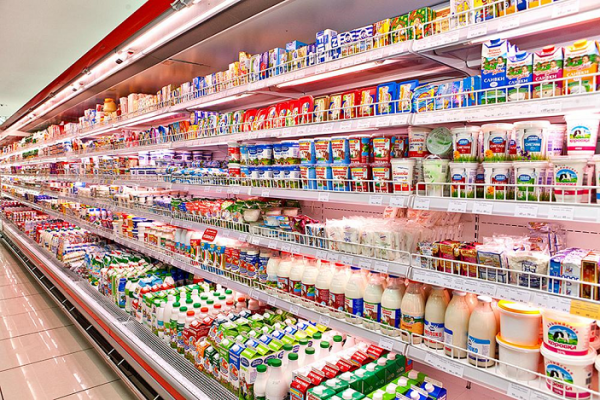
De atunci, desigur, copacii au crescut, lumea s-a schimbat, și a devenit așa:
S-a schimbat și piața SGBD-urilor, lucru care este evident în raportul recent al companiei Gartner:
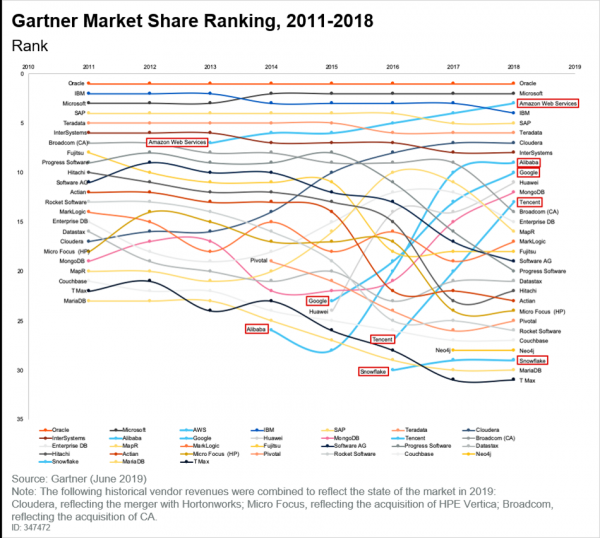
Și aici trebuie menționat că nișa lor a fost ocupată de servicii cloud, a căror popularitate crește. Dacă citim același raport al companiei Gartner, vom observa următoarele concluzii:
- Multe companii se află pe calea de a migra aplicațiile în cloud.
- Noile tehnologii apar inițial în cloud și nu este un fapt sigur că acestea vor fi mutate vreodată într-o infrastructură on-premises.
- Modelul de stabilire a prețurilor pe principiul pay-as-you-go a devenit obișnuit. Toată lumea dorește să plătească doar pentru ceea ce folosește, și acesta este deja mai mult decât o tendință, ci pur și simplu o constatare a realității.
Ce se întâmplă acum?
Astăzi suntem cu toții în cloud. Întrebările care ne apar sunt întrebări de alegere. Iar acestea sunt foarte multe, chiar dacă vorbim doar despre alegerea tehnologiilor de SGBD în format On-premises. De asemenea, avem servicii gestionate și SaaS. Astfel, alegerea devine tot mai complicată de la an la an.
Pe lângă întrebările de alegere, există și factori restrictivi:
- prețul. Multe tehnologii continuă să coste bani;
- abilități. Dacă vorbim despre software-ul liber, apare întrebarea abilităților, deoarece software-ul gratuit necesită de la persoanele care îl desfășoară și îl exploatează un anumit nivel de competență;
- funcționalitate. Nu toate serviciile disponibile în cloud, chiar și cele construite pe baza aceluiași Postgres, dispun de aceleași caracteristici ca și Postgres On-premises. Acesta este un factor important de știut și înțeles. Mai mult, acest factor devine din ce în ce mai important decât cunoașterea unor posibilități ascunse ale fiecărui SGBD în parte.
Ce așteaptă acum de la DA/DE:
- o bună înțelegere a domeniului și a arhitecturii aplicate;
- capacitatea de a alege tehnologia SGBD corespunzătoare în funcție de sarcina stabilită;
- abilitatea de a selecta metoda optimă de realizare a tehnologiei alese în contextul restricțiilor existente;
- capacitatea de a efectua transferul și migrarea datelor;
- abilitatea de a implementa și exploata soluțiile alese.
Exemplul de mai jos bazat pe GCP arată cum se face alegerea unei tehnologii de gestionare a datelor în funcție de structura acestora:
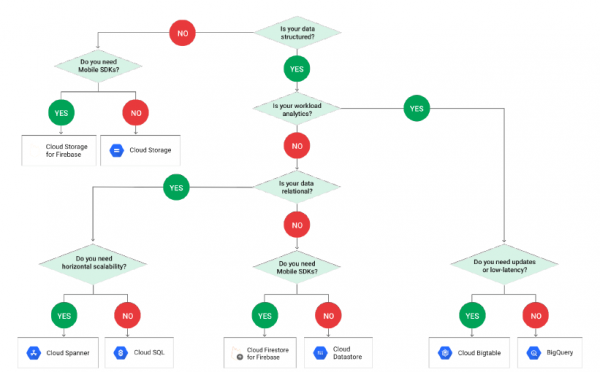
Atenție, în schemă nu se regăsește PostgreSQL, iar acest lucru se datorează faptului că el este ascuns sub terminologia Cloud SQL. Și atunci când ajungem în Cloud SQL, trebuie din nou să facem o alegere:
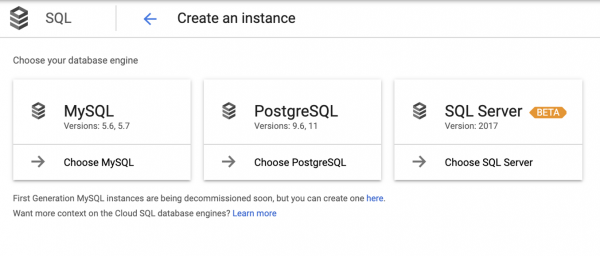
Este de remarcat că această alegere nu este întotdeauna clară, iar dezvoltatorii aplicației își ghidează adesea intuiția.
În total:
- Pe măsură ce avansăm, întrebarea alegerii devine din ce în ce mai actuală. Chiar și atunci când ne uităm doar la GCP, serviciile gestionate și SaaS, mențiunea despre RDBMS apare abia la pasul 4 (iar acolo Spanner este foarte aproape). În plus, alegerea PostgreSQL apare abia la pasul 5, alături de MySQL și SQL Server. Există mult, dar trebuie să alegem.
- Nu trebuie să uităm de limitările în fața ispitei. În general, toată lumea vrea Spanner, dar este scump. Așadar, o cerere tipică arată aproximativ așa: „Faceți-ne, vă rugăm, Spanner, dar la prețul Cloud SQL, sunteți profesioniști, nu-i așa?”
Și ce ar trebui să facem?
Fără a pretinde că dețin adevărul absolut, să spunem următoarele:
Trebuie să schimbăm abordarea în învățare:
- să învățăm cum s-a predat anterior DBA nu are sens;
- cunoștințele despre un singur produs nu mai sunt suficiente;
- iar a cunoaște zeci la nivel de unu este imposibil.
Trebuie să știm nu doar produsul, ci și:
- cazul de utilizare al aplicării acestuia;
- diverse metode de implementare;
- avantajele și dezavantajele fiecărei metode;
- produse similare și alternative, pentru a face o alegere conștientă și optimă și nu întotdeauna în favoarea produsului cunoscut.
Și trebuie să știm, de asemenea, cum să migram datele și să înțelegem principiile de bază ale integrării cu ETL.
Caz real
Recent, a fost necesar să se dezvolte backend-ul pentru o aplicație mobilă. La momentul începerii lucrului la aceasta, backend-ul era deja dezvoltat și gata de implementare, iar echipa de dezvoltare a petrecut aproximativ doi ani pe acest proiect. În acest context, au fost stabilite următoarele sarcini:
- să construim CI/CD;
- să facem revizuirea arhitecturii;
- să lansăm totul în exploatare.
Aplicația în sine era microservizată, iar codul pe Python/Django a fost dezvoltat de la zero și direct în GCP. În ceea ce privește publicul țintă, s-a presupus că vor fi două regiuni - SUA și UE, iar traficul era distribuit prin Global Load Balancer. Toate Workloads și sarcinile de calcul funcționau în Google Kubernetes Engine.
În ceea ce privește datele, erau 3 structuri:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
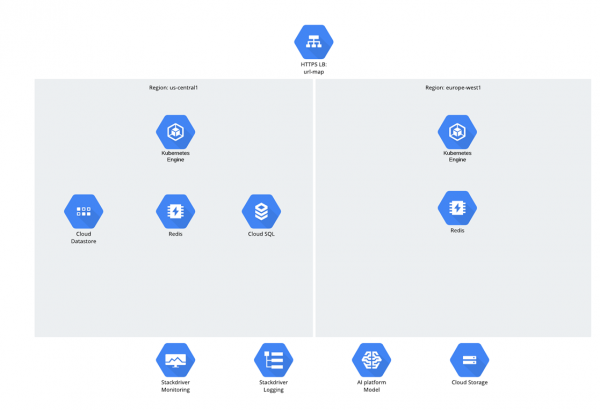
Poate că se va pune întrebarea de ce a fost ales Cloud SQL? Sincer, o astfel de întrebare provoacă o oarecare jenă în ultimii ani - există senzația că oamenii au început să se rușineze de bazele de date relaționale, dar, cu toate acestea, continuă să le folosească activ ;-).
În cazul nostru, Cloud SQL a fost ales din următoarele motive:
- Așa cum a fost menționat, aplicația a fost dezvoltată folosind Django, iar acesta are un model de mapare a datelor persistente din baza de date SQL în obiecte Python (Django ORM).
- Framework-ul în sine suporta o listă finală suficientă de DBMS-uri:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Prin urmare, PostgreSQL a fost ales din această listă mai degrabă intuitiv (nu vom alege Oracle, într-adevăr).
Ce a lipsit:
- aplicația a fost desfășurată doar în 2 regiuni, iar în planuri a apărut a 3-a (Asia);
- BD-ul se afla în regiunea nord-americană (Iowa);
- din partea clientului au existat temeri legate de posibilele întârzieri de acces din Europa și Asia și interferențe în servicii în cazul inactivității SGBD-ului.
Având în vedere că Django poate lucra cu mai multe BD-uri simultan și poate împărți între citire și scriere, în aplicație nu erau atât de multe scrieri (peste 90% – citire). În general, dacă s-ar fi putut face o replica pentru citire a bazei principale în Europa și Asia, asta ar fi fost o variantă de compromis. Dar ce este atât de complicat aici?
Complicația consta în faptul că clientul nu dorea să renunțe la utilizarea serviciilor gestionate și Cloud SQL. Iar posibilitățile Cloud SQL, în acest moment, sunt limitate. Cloud SQL suportă disponibilitate ridicată (HA) și Replica pentru citire (RR), dar aceeași RR este susținută doar într-o singură regiune. Creând BD în regiunea americană, nu se poate face o replică pentru citire în regiunea europeană prin Cloud SQL, deși PostgreSQL nu împiedică aceasta. Corespondenta cu angajații Google nu a dus la nimic și s-a încheiat cu promisiuni de genul „știm problema și lucrăm la ea, într-o zi va fi rezolvată”.
Dacă enumerăm posibilitățile Cloud SQL tezaic, ar arăta aproximativ așa:
1. Disponibilitate ridicată (HA):
- în cadrul unei singure regiuni;
- prin replicarea discurilor;
- nu se folosesc mecanisme PostgreSQL;
- posibilitate de gestionare automată și manuală – failover/failback;
- în timpul comutării SGBD-ul nu este disponibil timp de câteva minute.
2. Replica pentru citire (RR):
- în cadrul unei singure regiuni;
- standby activ;
- replicare prin streaming PostgreSQL.
În plus, așa cum este de obicei, atunci când alegi tehnologia întâlnești tot felul de limiteri:
- clientul nu dorea să creeze entități și să folosească IaaS, decât prin GKE;
- clientul nu dorea să desfășoare un PostgreSQL/MySQL self service;
- în general, Google Spanner ar fi fost destul de potrivit, dacă nu ar fi prețul său, totuși cu acesta Django ORM nu poate lucra, dar în rest este o soluție bună.
Având în vedere situația, clientul a pus o întrebare capcană: „Puteți să faceți ceva similar, care să fie ca Google Spanner, dar să funcționeze și cu Django ORM?”
Variantă de soluție nr. 0
Primul lucru care mi-a venit în minte:
- a rămâne în cadrul CloudSQL;
- replicarea încorporată între regiuni nu va exista în niciun fel;
- încercarea de a conecta o replică la Cloud SQL existent by PostgreSQL;
- într-un fel sau altul, să lansăm o instanță PostgreSQL, dar să nu intervenim în master.
Din păcate, s-a dovedit că nu se poate face acest lucru, deoarece nu există acces la host (el este în general într-un alt proiect) - pg_hba și așa mai departe, și de asemenea nu există acces sub superuser.
Varianta de soluție nr. 1
După noi reflecții și având în vedere circumstanțele anterioare, gândirea s-a schimbat puțin:
- încercăm să rămânem în CloudSQL, dar trecem la MySQL, deoarece Cloud SQL by MySQL are un master extern, care:
— este un proxy pentru MySQL extern;
— arată ca o instanță MySQL;
— a fost creat pentru migrarea datelor din alte clouduri sau on-premises.
Având în vedere că setarea replicării MySQL nu necesită acces la host, în principiu totul a funcționat, dar foarte instabil și inconfortabil. Iar când am mers mai departe, a devenit chiar înfricoșător, deoarece am desfășurat întreaga structură cu terraform, iar brusc s-a dovedit că masterul extern nu este suportat de terraform. Da, Google are CLI, dar dintr-un motiv oarecare, aici totul a funcționat sporadic - uneori se creează, alteori nu. Posibil din cauza că CLI a fost gândit pentru migrarea datelor din exterior, nu pentru replici.
Practic, a devenit clar că Cloud SQL nu este potrivit sub nicio formă. Cum se spune, am făcut tot ce am putut.
Varianta de soluție nr. 2
Deoarece nu am reușit să rămânem în Cloud SQL, am încercat să formulăm cerințele pentru o soluție de compromis. Cerințele s-au dovedit a fi următoarele:
- funcționarea în Kubernetes, utilizarea maximă a resurselor și capacităților Kubernetes (DCS, ...) și GCP (LB, ...);
- eliminarea balastului dintr-o mulțime de lucruri inutile în cloud, precum HA proxy;
- posibilitatea de a rula HA PostgreSQL sau MySQL în regiunile principale; în celelalte regiuni - HA din RR-ul regiunii principale plus copia acesteia (pentru fiabilitate);
- multi master (nu ne-am dorit să ne conectăm cu el, dar nu era o problemă foarte principială)
.
Ca urmare a acestor cerințe, pe orizont au apărut în sfârșit popțiuni potrivite pentru SGBD și interfața:
- MySQL Galera;
- CockroachDB;
- PostgreSQL tools
:
— pgpool-II;
— Patroni.
MySQL Galera
Tehnologia MySQL Galera a fost dezvoltată de compania Codership și reprezintă un plugin pentru InnoDB. Caracteristici:
- multi master;
- replicare sincronă;
- citire de pe orice nod;
- scriere pe orice nod;
- mecanism HA încorporat;
- există un Helm chart de la Bitnami.
CockroachDB
Conform descrierii, acest lucru este cu adevărat impresionant și reprezintă un proiect open source, scris în Go. Principalul participant este Cockroach Labs (fondată de foști angajați ai Google). Această bază de date relațională a fost creată inițial pentru a fi distribuită (cu scalare orizontală „din cutie”) și tolerantă la erori. Autorii săi din companie au subliniat obiectivul de a „combină bogăția funcționalității SQL cu disponibilitatea orizontală, obișnuită în soluțiile NoSQL”.
Un bonus plăcut este suportul pentru protocolul de conectare PostgreSQL.
Pgpool
Aceasta este o suprastructură peste PostgreSQL, de fapt, o nouă entitate care preia toate conexiunile și le procesează. Are un load balancer și un parser proprii, fiind licențiată sub licența BSD. Oferă oportunități vaste, dar arată oarecum înfricoșător, deoarece prezența unei noi entități ar putea constitui o sursă de aventuri suplimentare.
Patroni
Acesta a fost ultimul lucru pe care l-am observat și, după cum s-a dovedit, nu a fost în zadar. Patroni – o unealtă open source, care, în esență, reprezintă un daemon pe Python, permițând gestionarea automată a clusterelor PostgreSQL cu diverse tipuri de replicare și schimbarea automată a rolurilor. A fost foarte interesant, deoarece se integrează bine cu Kubernetes și nu implică entități noi.
Ce am ales în final
Alegerea nu a fost ușoară:
- CockroachDB — minunat, dar riscant;
- MySQL Galera — de asemenea decent, folosit pe scară largă, dar MySQL;
- Pgpool — multe entități suplimentare, integrarea cu cloud-ul și K8s nu este ideală;
- Patroni — integrare excelentă cu K8s, fără entități suplimentare, se integrează bine cu GCP LB.
Astfel, alegerea a fost făcută pentru Patroni.
Conclusions
A venit vremea să tragem câteva concluzii. Da, lumea infrastructurii IT s-a schimbat considerabil și aceasta este doar începutul. Dacă anterior, cloud-urile erau doar un alt tip de infrastructură, acum totul este diferit. Mai mult, inovațiile în cloud-uri apar constant, vor continua să apară și, poate, vor apărea doar în cloud-uri și vor fi apoi transferate în On-premises prin eforturile startup-urilor.
În ceea ce privește SQL, SQL va continua să existe. Asta înseamnă că trebuie să cunoaștem PostgreSQL și MySQL și să știm cum să lucrăm cu ele, dar este și mai important să știm să le aplicăm corect.
Sursa: habr.com
