

Când am terminat salata de Noul An, nu mai aveam nimic de făcut, așa că am decis să descarc toate articolele de pe Habr (și platformele conexe) și să le cercetez.
A rezultat câteva narațiuni interesante. Prima dintre ele este evoluția formatului și tematicii articolelor în cei 12 ani de existență ai site-ului. De exemplu, dinamica anumitor teme este destul de revelatoare. Continuarea se află mai jos.
Procesul de parsare
Pentru a înțelege cum s-a dezvoltat Habr, a fost necesar să trec prin toate articolele sale și să extrag meta-informațiile (de exemplu, datele). Trecerea a fost ușoară, deoarece linkurile pentru toate articolele au forma "habrahabr.ru/post/337722/", iar numerele sunt stabilite strict în ordine. Știind că ultimul post are un număr puțin mai mic de 350.000, am folosit un ciclu pentru a trece prin toate ID-urile posibile (cod în Python):
import numpy as np
from multiprocessing import Pool
with Pool(100) as p:
    docs = p.map(download_document, np.arange(350000))
Funcția download_document încearcă să încarce pagina cu ID-ul corespunzător și să extragă din structura HTML informații semnificative.
import requests
from bs4 import BeautifulSoup

def download_document(pid):
    """ Descarcă și procesează un document Habr și comentariile sale """
    # descărcarea documentului
    r = requests.get('https://habrahabr.ru/post/' + str(pid) + '/')
    # parsarea documentului
    soup = BeautifulSoup(r.text, 'html5lib') # în loc de html.parser
    doc = {}
    doc['id'] = pid
    if not soup.find("span", {"class": "post__title-text"}):
        # asta se întâmplă dacă articolul nu există sau a fost șters
        doc['status'] = 'title_not_found'
    else:
        doc['status'] = 'ok'
        doc['title'] = soup.find("span", {"class": "post__title-text"}).text
        doc['text'] = soup.find("div", {"class": "post__text"}).text
        doc['time'] = soup.find("span", {"class": "post__time"}).text
        # crearea altor câmpuri: hub-uri, etichete, vizualizări, comentarii, voturi etc.
        # ...
    # salvarea rezultatului într-un fișier separat
    fname = r'files/' + str(pid) + '.pkl'
    with open(fname, 'wb') as f:
        pickle.dump(doc, f)
În timpul parsării, am descoperit câteva lucruri noi.
În primul rând, se spune că a crea mai multe procese decât nucleele din procesor este inutil. Dar în cazul meu, s-a dovedit că resursa limitativă nu era procesorul, ci rețeaua, iar 100 de procese funcționează mai repede decât 4 sau, să zicem, 20.
În al doilea rând, în unele postări am întâlnit combinații de simboluri speciale — de exemplu, eufemisme de tip "%&#@". S-a dovedit că html.parser, pe care l-am folosit la început, reacționează la combinația &# într-un mod sensibil, considerând-o începutul unei entități HTML. M-am gândit să fac magie neagră, dar pe forum mi-au sugerat că pot schimba pur și simplu parserul.
În al treilea rând, am reușit să descarc toate publicațiile, cu excepția a trei. Documentele cu numerele 65927, 162075 și 275987 au fost șterse instantaneu de antivirusul meu. Acestea sunt articole despre o pagină JavaScript care încarcă un pdf malițios, un ransomware SMS sub forma unui set de plugin-uri pentru browsere și site-ul CrashSafari.com, care reinițializează iPhone-urile. Un alt articol a fost descoperit de antivirus mai târziu, în timpul scanării sistemului: postarea 338586 despre scripturile de pe site-ul unui magazin de animale, care folosesc procesorul utilizatorului pentru a mina criptomonede. Așadar, putem considera că munca antivirusului a fost destul de adecvată.
"Articolele 'viabile' s-au dovedit a fi doar jumătate din maximum potențial — 166307 bucăți. Pentru celelalte, Habr oferă variante precum 'pagina este învechită, a fost ștearsă sau nu a existat deloc'. Ei bine, se întâmplă și așa.
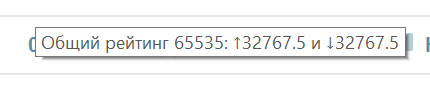
După descărcarea articolelor, a urmat o muncă tehnică: de exemplu, datele publicației trebuiau să fie convertite din formatul '21 decembrie 2006 la 10:47' în unul standard, datetime, iar '12,8k' vizualizări — în 12800. În această etapă au apărut și câteva alte cazuri ciudate. Cel mai amuzant este legat de numărarea voturilor și tipurile de date: în unele postări vechi s-a produs o depășire de tip int, iar acestea au primit câte 65535 de voturi.
Ca rezultat, textele articolelor (fără imagini) au ocupat 1.5 gigabytes, comentariile cu metainformații — încă 3, și aproximativ o sută de megabytes — metainformații despre articole. Acestea se puteau păstra complet în memorie, ceea ce a fost o surpriză plăcută pentru mine.
Am început analiza articolelor nu cu textele propriu-zise, ci cu metainformațiile: date, etichete, hub-uri, vizualizări și 'like-uri'. S-a dovedit că și acestea pot oferi multe informații.
Tendințele de dezvoltare ale Habrhabra
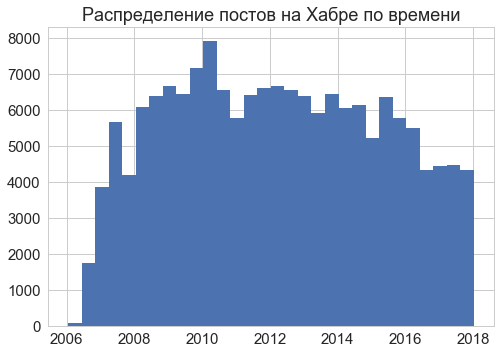
Articolele de pe site sunt publicate din 2006; cel mai intens — în anii 2008-2016.
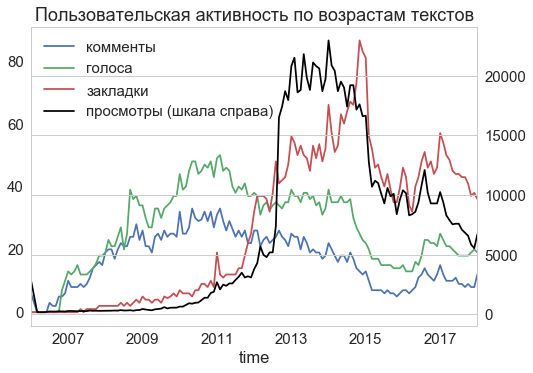
Nu este atât de simplu să evaluăm cât de activ au fost citite aceste articole în diferite perioade. Textele din 2012 și mai recente au fost comentate și evaluate mai activ, dar articolele mai noi au mai multe vizualizări și adăugări în bookmarks. Aceste metrici s-au comportat similar (au scăzut de două ori) doar o dată, în 2015. Poate că, în contextul unei crize economice și politice, atenția cititorilor s-a mutat de la blogurile IT la probleme mai dureroase.
În afară de articolele în sine, am extras și comentariile la acestea. Numărul comentariilor a ajuns la 6 milioane, dintre care 240 de mii au fost marcate ca fiind interzise ("O navă extraterestră a venit și a publicat această inscripție aici"). Un aspect util al comentariilor este că acestea sunt marcate cu timp. Prin studiul timpului comentariilor, putem să ne dăm seama aproximativ când sunt citite articolele.
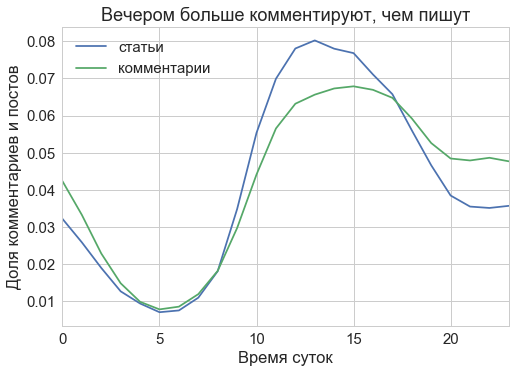
Se pare că cea mai mare parte a articolelor este scrisă și comentată undeva între orele 10 și 20, adică într-o zi tipică de lucru la Moscova. Acest lucru poate însemna că Habr este citit în scopuri profesionale și că este, de asemenea, o modalitate bună de a procrastina la muncă. Apropo, această distribuție a timpului din zi este stabilă de la înființarea Habr până în prezent.
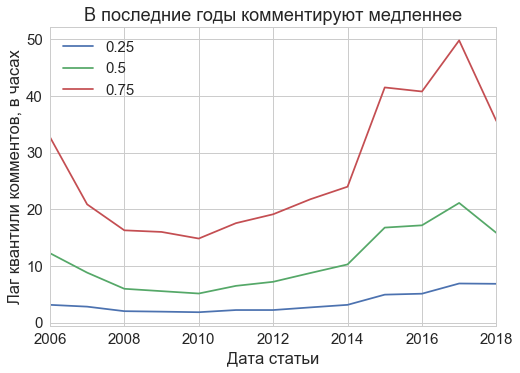
Cu toate acestea, principalul beneficiu al etichetei de timp a comentariului nu este ora din zi, ci durata "vieții active" a articolului. Am calculat cum este distribuit timpul de la publicarea articolului până laComentariul acestuia. S-a constatat că acum comentariul median (linia verde) apare aproximativ după 20 de ore, adică în primele 24 de ore de la publicare, se lasă în medie puțin peste jumătate din toate comentariile la articol. Iar în două zile se lasă 75% din toate comentariile. În trecut, articolele erau citite chiar mai repede — astfel, în 2010, jumătate din comentarii veneau deja în primele 6 ore.
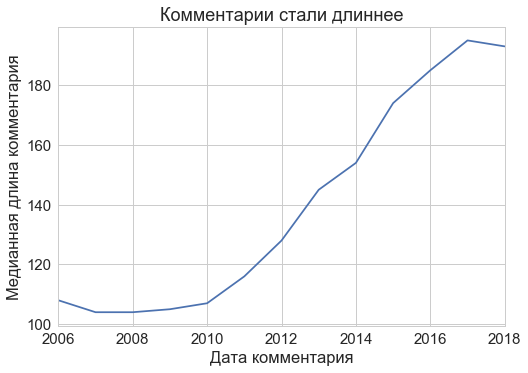
M-a surprins faptul că comentariile s-au lungit: numărul mediu de caractere în comentariu pe parcursul existenței Habr a crescut aproape de două ori!
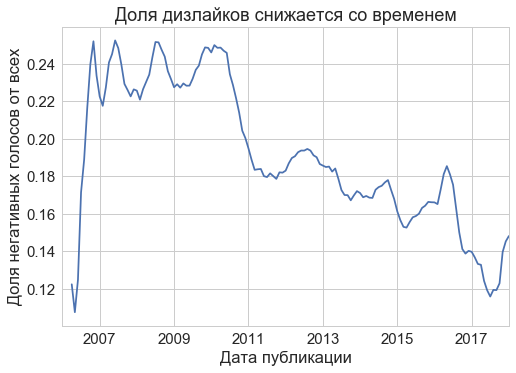
O modalitate mai simplă de feedback decât comentariile sunt voturile. Spre deosebire de multe alte resurse, pe Habr poți da nu doar voturi pozitive, ci și negative. Cu toate acestea, cititorii nu folosesc atât de des această ultimă opțiune: proporția actuală a voturilor negative este de aproximativ 15% din toate voturile exprimate. În trecut, aceasta era mai mare, dar pe parcurs, cititorii au devenit mai binevoitori.
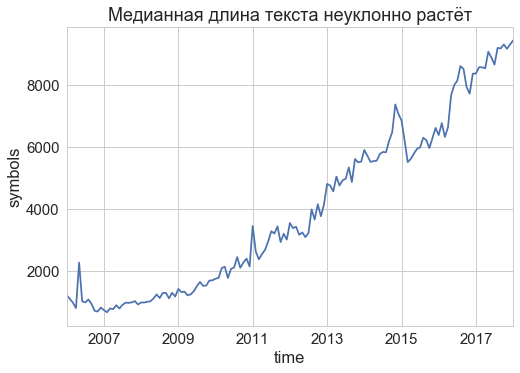
De-a lungul timpului, și textele s-au schimbat. De exemplu, lungimea tipică a textului continuă să crească constant de la lansarea site-ului, în ciuda crizelor. În decurs de un deceniu, textele au devenit aproape de zece ori mai lungi!
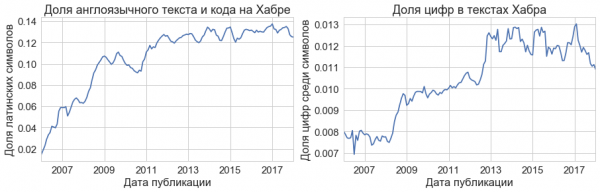
Stilistica textelor (într-o primă aproximare) s-a schimbat și ea. În primii ani de existență a Habr, de exemplu, a crescut proporția codului și a numerelor în texte:
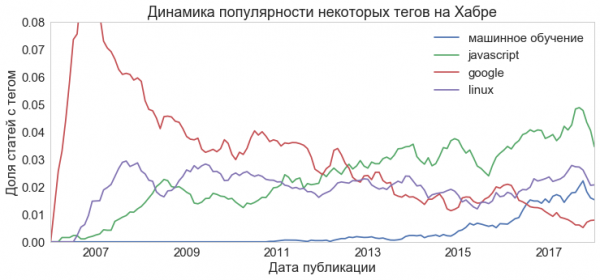
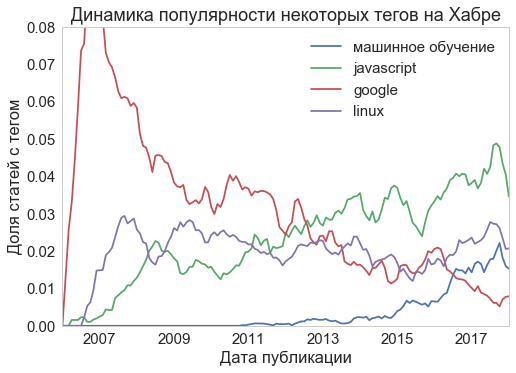
După ce am analizat dinamica generală a site-ului, am decis să măsor cum a evoluat popularitatea diverselor teme. Temele pot fi extrase automat din texte, dar pentru început, nu trebuie să reinventăm roata, ci să ne folosim de etichetele deja create de autorii fiecărui articol. Patru tendințe tipice le-am reprezentat grafic. Tema "Google" a dominat inițial (posibil, în principal, datorită optimizării SEO), dar a pierdut din greutate de-a lungul anilor. Javascript a fost o temă populară și continuă să fie, în timp ce învățarea automată a început să câștige popularitate rapid doar în ultimii ani. Linux rămâne o temă constant relevantă pe parcursul întregului deceniu.
Desigur, am devenit curios cu privire la temele care atrag mai multă activitate din partea cititorilor. Am calculat numărul median de vizualizări, voturi și comentarii pentru fiecare temă. Iată ce a rezultat:
- Cele mai vizualizate teme: arduino, web design, dezvoltare web, sumare, link-uri, css, html, html5, nginx, algoritmi.
- Cele mai "like-uite" teme: VKontakte, umor, jquery, opera, c, html, dezvoltare web, html5, css, web design.
- Cele mai discutate teme: opera, skype, freelancing, VKontakte, ubuntu, muncă, nokia, nginx, arduino, firefox.
Apropo, având în vedere că compar temele, se poate face un clasament al lor în funcție de frecvență (și compara rezultatele cu ).
- În întreaga sa existență, cele mai populare etichete de pe Habr (în ordine descrescătoare) au fost google, android, javascript, microsoft, linux, php, apple, java, python, programare, startup-uri, dezvoltare, ios, startup, rețele sociale.
- În 2017, cele mai populare teme au fost javascript, python, java, android, dezvoltare, linux, c++, programare, php, c#, ios, învățare automată, securitate informațională, microsoft, react.
Comparând aceste clasamente, putem observa, de exemplu, ascensiunea triumfătoare a Pythonului și dispariția php-ului, sau "apusul" temelor de startup și ascensiunea învățării automate.
Nu toate etichetele de pe Habr au o tematică atât de evidentă. Iată, de exemplu, o duzină de etichete care au apărut doar o singură dată, dar mi s-au părut amuzante. Așadar: "idee motor al progresului", "încărcare din imaginea dischetei", "statul Iowa", "dramaturgie", "superaleș", "motor cu aburi", "ce să faci sâmbătă", "am un vulpe în mașina de tocat", "dar s-a întâmplat ca întotdeauna", "nu am reușit să inventez etichete amuzante". Pentru a determina tematica acestor articole, etichetele nu sunt suficiente - va trebui să realizăm o modelare tematică asupra textelor articolelor.
O analiză mai detaliată a conținutului articolelor va fi în următoarea postare. În primul rând, intenționez să construiesc un model care să prognozeze numărul de vizualizări al unui articol în funcție de conținutul său. În al doilea rând, vreau să învăț o rețea neuronală să genereze texte în același stil ca și autorii de pe Habr. Așa că abonați-vă 🙂
P.S. Iată și datasetul .
Sursa: habr.com
