

Salut, Habrări! Această carte este potrivită pentru orice dezvoltator care dorește să înțeleagă procesarea în flux. Înțelegerea programării distribuite va ajuta la studierea mai bună a Kafka și Kafka Streams. Ar fi bine să cunoști și cadrul Kafka, dar nu este obligatoriu: îți voi explica tot ce trebuie să știi. Dezvoltatorii experimentați de Kafka, la fel ca și începătorii, vor învăța din această carte cum să creeze aplicații interesante pentru procesarea în flux folosind biblioteca Kafka Streams. Dezvoltatorii Java de nivel mediu și înalt, deja familiarizați cu concepte precum serializarea, vor învăța să își aplice abilitățile pentru a crea aplicații Kafka Streams. Codul sursă al cărții este scris în Java 8 și folosește semnificativ sintaxa expresiilor lambda din Java 8, astfel că abilitatea de a lucra cu funcții lambda (chiar și în alte limbaje de programare) îți va fi de folos.
Fragment. 5.3. Agregarea și operațiile pe fereastră
În această secțiune, vom trece la studierea celor mai promițătoare părți ale Kafka Streams. Până acum, am analizat următoarele aspecte ale Kafka Streams:
- crearea unei topologii de procesare;
- utilizarea stării în aplicațiile de flux;
- efectuarea de conexiuni între fluxurile de date;
- diferențele între fluxurile de evenimente (KStream) și fluxurile de actualizări (KTable).
În exemplele următoare, vom aduna toate aceste elemente împreună. De asemenea, te vei familiariza cu operațiile pe feronță — o altă posibilitate extraordinară a aplicațiilor de flux. Primul nostru exemplu va fi o agregare simplă.
5.3.1. Agregarea volumului vânzărilor de acțiuni pe industrii
Agregarea și gruparea sunt instrumente esențiale în lucrul cu datele de flux. Studierea înregistrărilor individuale pe măsură ce acestea sosesc se dovedește adesea insuficientă. Pentru a extrage informații suplimentare din date, sunt necesare gruparea și combinarea acestora.
În acest exemplu, va trebui să îmbraci costumul unui trader intradag care trebuie să urmărească volumul vânzărilor de acțiuni ale companiilor din mai multe industrii. În special, te interesează cinci companii cu cele mai mari volume de vânzări de acțiuni în fiecare dintre industriile respective.
Pentru o astfel de agregare, vor fi necesari câțiva pași pentru a traduce datele în forma dorită (dacă vorbim în termeni generali).
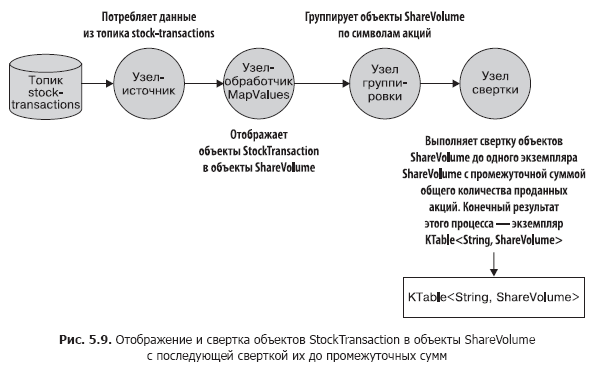
- Creează o sursă bazată pe un topic pentru a publica informații brute despre tranzacțiile cu acțiuni. Va trebui să mapăm un obiect de tip StockTransaction într-un obiect de tip ShareVolume. Problema este că obiectul StockTransaction conține metadate despre vânzări, iar noi avem nevoie doar de datele despre numărul de acțiuni vândute.
- Grupează datele ShareVolume după simbolurile acțiunilor. După grupare, aceste date pot fi consolidate în sume intermediare ale volumului de vânzări ale acțiunilor. Este de remarcat că metoda KStream.groupBy returnează o instanță de tip KGroupedStream. O instanță de KTable poate fi obținută apelând apoi metoda KGroupedStream.reduce.
Ce este interfața KGroupedStream?
Metodele KStream.groupBy și KStream.groupByKey returnează o instanță de KGroupedStream. KGroupedStream reprezintă o viziune intermediară a fluxului de evenimente după gruparea pe chei. Nu este destinat pentru a fi utilizat direct. În schimb, KGroupedStream este folosit pentru operațiuni de agregare, al căror rezultat este întotdeauna un KTable. Și deoarece rezultatul operațiunilor de agregare este un KTable și se aplică un depozit de stări, este posibil ca nu toate actualizările rezultate să fie trimise mai departe în canal.
Metoda KTable.groupBy returnează un KGroupedTable analogic — o reprezentare intermediară a fluxului de actualizări, regroupate pe cheie.
Să facem o mică pauză și să ne uităm la fig. 5.9, care arată ce am realizat. Această topologie ar trebui să vă fie deja bine cunoscută.
Să ne uităm acum la codul pentru această topologie (poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.2).
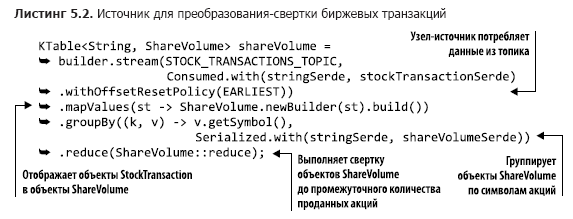
Codul prezentat este concis și realizează multe acțiuni într-un număr mic de linii. În primul parametru al metodei builder.stream, puteți observa ceva nou: valoarea tipului enumerat AutoOffsetReset.EARLIEST (există de asemenea și LATEST), definită folosind metoda Consumed.withOffsetResetPolicy. Prin intermediul acestui tip enumerat, se poate specifica strategia de resetare a deplasării pentru fiecare KStream sau KTable, având prioritate asupra parametrului de resetare a deplasării din configurație.
GroupByKey și GroupBy
În interfața KStream există două metode pentru gruparea înregistrărilor: GroupByKey și GroupBy. Ambele returnează un KGroupedTable, astfel încât o întrebare firescă poate apărea: care este diferența dintre ele și când să folosiți fiecare dintre ele?
Metoda GroupByKey se aplică atunci când cheile din KStream sunt deja nenule. De asemenea, indicatorul „necesită reproiectare” nu a fost niciodată setat.
Metoda GroupBy presupune că ați schimbat cheile pentru grupare, astfel că indicatorul de reproiectare este setat pe true. Execuția după metoda GroupBy a conexiunilor, agregărilor etc. va duce la reproiectarea automată.
Rezumat: ar trebui să utilizați GroupByKey când este posibil, și nu GroupBy.
Ce fac metodele mapValues și groupBy este clar, așa că să aruncăm o privire asupra metodei sum() (o puteți găsi în fișierul src/main/java/bbejeck/model/ShareVolume.java) (listare 5.3).
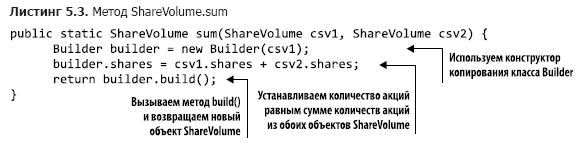
Metoda ShareVolume.sum returnează suma intermediară a volumului vânzărilor de acțiuni, iar rezultatul întregului lanț de calcul este un obiect KTable. Acum înțelegeți rolul pe care îl joacă KTable. Atunci când obiectele ShareVolume sunt primite, în obiectul KTable corespunzător se păstrează ultima actualizare validă. Este important să nu uităm că toate actualizările sunt reflectate în shareVolumeKTable precedent, dar nu toate sunt trimise mai departe.
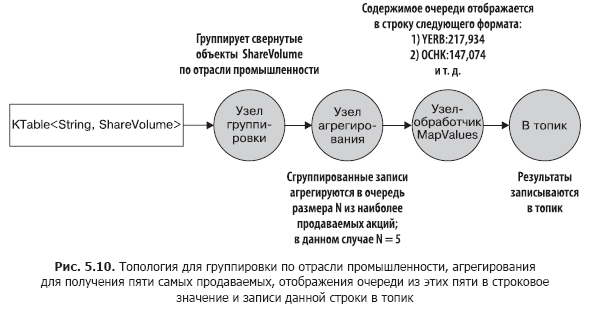
Apoi, folosind acest KTable, executăm agregarea (pe baza numărului de acțiuni vândute), pentru a obține cinci companii cu cele mai mari volume de vânzări de acțiuni din fiecare ramură industrială. Acțiunile noastre vor fi similare cu cele din prima agregare.
- Executați o altă operație groupBy pentru a grupa obiectele ShareVolume individuale după sectoarele industriale.
- Trebuie să începem să sumăm obiectele ShareVolume. De data aceasta, obiectul de agregare este o coadă de prioritate de dimensiune fixă. Într-o astfel de coadă de dimensiune fixă, se păstrează doar cinci companii cu cele mai mari cantități de acțiuni vândute.
- Maparea cozii din punctul anterior într-o valoare de tip șir și returnarea celor cinci acțiuni cele mai vândute după numărul de acțiuni pe sectoare industriale.
- Scrieți rezultatele sub formă de șir în topic.
În figura 5.10 este ilustrat graficul topologiei fluxului de date. După cum puteți observa, al doilea ciclu de procesare este destul de simplu.
Acum, având clar în minte structura acestui al doilea ciclu de procesare, putem consulta codul său sursă (îl veți găsi în fișierul src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listare 5.4).
În acest inițializator există o variabilă fixedQueue. Acesta este un obiect personalizat - un adaptor pentru java.util.TreeSet, care este utilizat pentru a urmări cele N cele mai mari rezultate în ordine descrescătoare a numărului de acțiuni vândute.
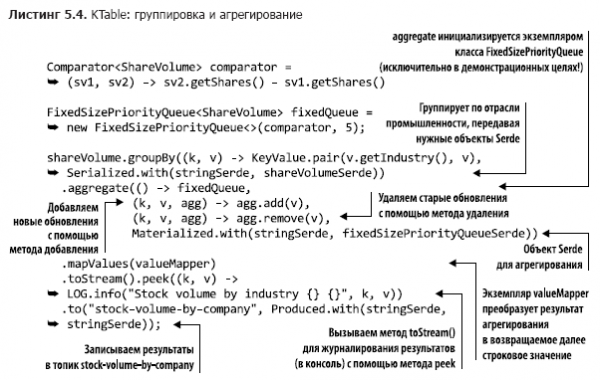
Te-ai întâlnit deja cu apelurile groupBy și mapValues, așa că nu ne vom opri asupra lor (apelăm metoda KTable.toStream, deoarece metoda KTable.print este considerată învechită). Dar tu nu ai văzut încă versiunea KTable a metodei aggregate(), astfel că vom petrece puțin timp discutând despre aceasta.
Așa cum îți amintești, KTable se distinge prin faptul că înregistrările cu aceleași chei sunt considerate actualizări. KTable înlocuiește vechea înregistrare cu una nouă. Agregarea se face în mod similar: se agregă ultimele înregistrări cu aceeași cheie. Atunci când o înregistrare sosește, aceasta este adăugată în instanța clasei FixedSizePriorityQueue cu ajutorul sumatorului (al doilea parametru în apelul metodei aggregate), dar dacă există deja o altă înregistrare cu aceleași cheie, atunci vechea înregistrare este eliminată cu ajutorul scăzătorului (al treilea parametru în apelul metodei aggregate).
Asta înseamnă că agregatorul nostru, FixedSizePriorityQueue, nu agreghează toate valorile cu aceeași cheie, ci păstrează suma mobile a cantităților celor N cele mai vândute tipuri de acțiuni. Fiecare înregistrare care soseste conține numărul total de acțiuni vândute până acum. KTable îți va oferi informații despre ce acțiuni ale companiilor sunt cele mai vândute în prezent, agregarea mobilă a fiecărei actualizări nu este necesară.
Am învățat să facem două lucruri importante:
- să grupăm valorile într-o KTable după cheia comună;
- să efectuăm asupra acestor valori grupate operații utile, cum ar fi reducerea și agregarea.
Capacitatea de a efectua aceste operații este esențială pentru a înțelege sensul datelor care circulă prin aplicația Kafka Streams și pentru a descoperi ce informații aduc acestea.
Am combinat, de asemenea, unele dintre conceptele cheie discutate anterior în această carte. În capitolul 4 am vorbit despre importanța unui stat local rezistent la erori pentru o aplicație de streaming. Primul exemplu din acest capitol a demonstrat de ce este atât de important statul local - oferă posibilitatea de a urmări informațiile pe care le-ai văzut deja. Accesul local permite evitarea întârzierilor de rețea, făcând aplicația mai performantă și mai rezistentă la erori.
Atunci când efectuezi vreo operație de agregare sau de reducere, trebuie să specifici numele magazinului de stare. Operațiile de reducere și agregare returnează o instanță KTable, iar KTable folosește magazinul de stare pentru a înlocui vechile rezultate cu cele noi. Așa cum ai observat, nu toate actualizările sunt trimise mai departe în pipeline, ceea ce este important, deoarece operațiile de agregare sunt destinate obținerii de informații finale. Dacă nu se utilizează statul local, KTable va trimite mai departe toate rezultatele agregării și reducerii.
În continuare, vom analiza executarea unor operații precum agregarea, în cadrul unei anumite intervale de timp - așa-numitele operații de fereastră (windowing operations).
5.3.2. Operații de fereastră
În secțiunea anterioară, ne-am familiarizat cu agregarea și reducerea „mobilă”. Aplicația efectua o reducere continuă a volumului de vânzări de acțiuni, urmată de agregarea celor mai vândute cinci acțiuni pe bursă.
Uneori, astfel de agregări și reduceri continue sunt necesare. Iar alteori, trebuie să efectuezi operații doar pe un anumit interval de timp. De exemplu, să calculezi câte tranzacții bursiere cu acțiunile unei companii specifice au avut loc în ultimele 10 minute. Sau câți utilizatori au dat clic pe un nou banner publicitar în ultimele 15 minute. Aplicația poate efectua astfel de operații de mai multe ori, dar cu rezultate referitoare doar la intervalele de timp specificate (feronțe de timp).
Numărarea tranzacțiilor bursiere pe client
În exemplul următor, ne vom ocupa de urmărirea tranzacțiilor bursiere pentru mai mulți traderi - fie organizații mari, fie investitori individuali ingenioși.
Există două posibile motive pentru un astfel de tip de urmărire. Unul dintre ele este necesitatea de a ști ce cumpără/vând liderii din piață. Dacă acești jucători mari și investitorii experimentați observă oportunități, are sens să urmăm strategiile lor. Al doilea motiv este dorința de a identifica eventualele semne de tranzacții ilegale care utilizează informații interne. Pentru aceasta, va trebui să analizați corespondența dintre mari creșteri ale vânzărilor și comunicatele de presă importante.
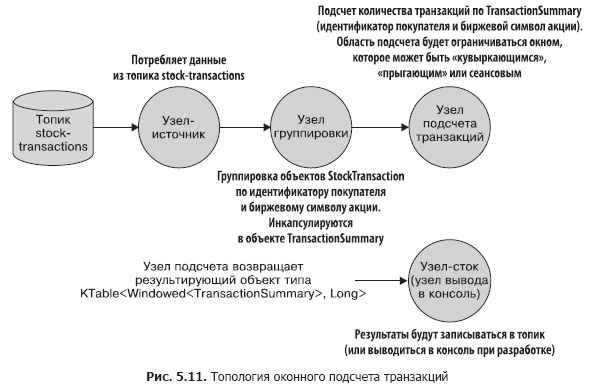
Această urmărire constă din etape precum:
- crearea unui flux de citire din topicul stock-transactions;
- gruparea înregistrărilor de intrare după identificatorul cumpărătorului și simbolul bursier al acțiunii. Apelul metodei groupBy returnează o instanță a clasei KGroupedStream;
- returnarea fluxului de date limitat de o fereastră temporală prin metoda KGroupedStream.windowedBy, ceea ce permite realizarea agregării pe feronțe. În funcție de tipul de fereastră, este returnat fie TimeWindowedKStream, fie SessionWindowedKStream;
- contorizarea tranzacțiilor pentru operațiunea de agregare. Fluxul de date pe feronțe determină dacă o anumită înregistrare este luată în calcul la această contorizare;
- înregistrarea rezultatelor în topic sau afișarea lor în consola de dezvoltare.
Topologia acestei aplicații este simplă, dar o diagramă vizuală nu ar strica. Să ne uităm la figura 5.11.
În continuare, vom explora funcționalitatea operațiunilor pe feronțe și codul corespunzător.
Tipuri de feronțe
În Kafka Streams există trei tipuri de feronțe:
- de sesiuni;
- «tumbling» (imediat);
- sliding/«hopping» (glisante/«sărind»).
Alegerea unui tip depinde de cerințele de afaceri. Feronțele «tumbling» și «hopping» sunt limitate în timp, în timp ce restricțiile feronțelor de sesiune sunt legate de acțiunile utilizatorilor — durata sesiunii(-elor) este definită exclusiv prin cât de activ se comportă utilizatorul. Principalul aspect de reținut este că toate tipurile de feronțe se bazează pe marcajele de dată/ora ale înregistrărilor, nu pe timpul sistemului.
În continuare, vom implementa topologia noastră cu fiecare dintre tipurile de feronțe. Codul complet va fi prezentat doar în primul exemplu; pentru celelalte tipuri de feronțe, nimic nu se va schimba, în afară de tipul operației pe feronțe.
Feronțe de sesiune
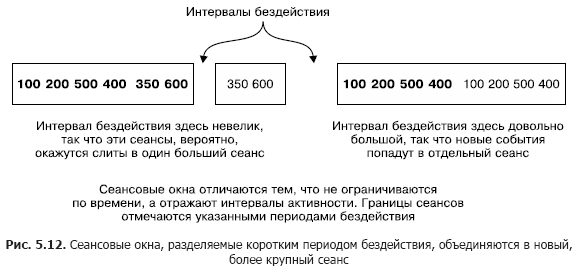
Feronile de sesiune se deosebesc semnificativ de toate celelalte tipuri de feron. Ele sunt limitate nu atât de timp, cât de activitatea utilizatorului (sau activitatea entității pe care doriți să o urmăriți). Feronile de sesiune sunt delimitate prin intervale de inactivitate.
Figura 5.12 ilustrează conceptul de feron de sesiune. O sesiune mai mică se va contopi cu sesiunea din stânga sa. Iar sesiunea din dreapta va fi separată, deoarece urmează un interval lung de inactivitate. Feronile de sesiune se bazează pe acțiunile utilizatorilor, dar aplică marcaje de dată/ora din înregistrări pentru a determina la ce sesiune aparține înregistrarea.
Utilizarea feronilor de sesiune pentru a urmări tranzacțiile de bursă
Vom folosi feronii de sesiune pentru a captura informații despre tranzacțiile de bursă. Implementarea feronilor de sesiune este prezentată în listarea 5.5 (care poate fi găsită în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
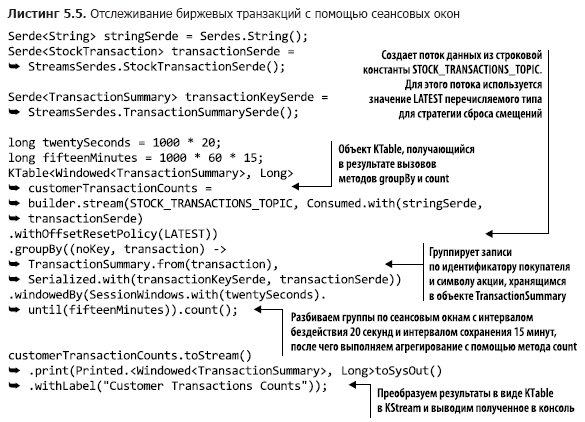
Cele mai multe operațiuni din această topologie le-ați întâlnit deja, așa că nu este nevoie să le discutăm din nou aici. Însă, există câteva elemente noi pe care le vom discuta acum.
La orice operațiune groupBy se realizează de obicei o operațiune de agregare (agregare, compresie sau numărare). Puteți efectua fie o agregare cumulativă cu totaluri progresive, fie o agregare pe feron, în care se iau în considerare înregistrările dintr-un interval de timp specificat.
Codul din listarea 5.5 efectuează numărătoarea tranzacțiilor în cadrul feronilor de sesiune. În figura 5.13, aceste acțiuni sunt analizate pas cu pas.
Prin apelul windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)), creăm un feron de sesiune cu un interval de inactivitate de 20 de secunde și un interval de păstrare de 15 minute. Intervalul de inactivitate de 20 de secunde înseamnă că aplicația va include orice înregistrare care ajunge în intervalul de 20 de secunde de la finalizarea sau începerea sesiunii curente în sesiunea curentă (activă).
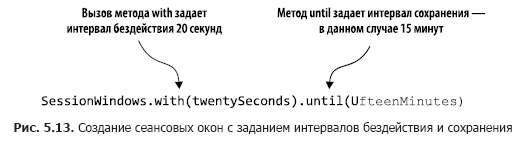
În continuare, specificăm ce operațiune de agregare trebuie efectuată în fereastra de sesiune — în acest caz, count. Dacă înregistrarea de intrare depășește intervalul de inactivitate (de orice parte de la marca de dată/oră), aplicația creează o nouă sesiune. Intervalul de păstrare înseamnă menținerea sesiunii timp de un anumit timp și permite datele întârziate care depășesc perioada de inactivitate a sesiunii, dar care încă pot fi atașate. În plus, începutul și sfârșitul noii sesiuni, care rezultă din fuziune, corespund celei mai timpurii și celei mai recente mărci de dată/oră.
Să luăm în considerare câteva înregistrări din metoda count pentru a vedea cum funcționează sesiunile (tabelul 5.1).
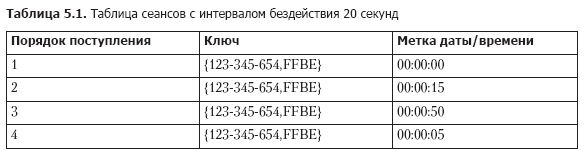
La primirea înregistrărilor, căutăm sesiuni deja existente cu aceeași cheie, cu timpul de sfârșit mai mic decât marca de dată/oră curentă — intervalul de inactivitate și timpul de început mai mare decât marca de dată/oră curentă + intervalul de inactivitate. Având în vedere acest lucru, cele patru înregistrări din tabelul 5.1 se combină într-o singură sesiune în felul următor.
1. Prima înregistrare primită este înregistrarea 1, astfel că timpul de început este egal cu timpul de sfârșit și este 00:00:00.
2. Apoi vine înregistrarea 2, iar noi căutăm sesiuni care se termină nu mai devreme de 23:59:55 și încep nu mai târziu de 00:00:35. Găsim înregistrarea 1 și combinăm sesiunile 1 și 2. Luăm timpul de început al sesiunii 1 (cel mai timpuriu) și timpul de sfârșit al sesiunii 2 (cel mai tardiv), astfel încât noua noastră sesiune începe la 00:00:00 și se termină la 00:00:15.
3. Vine înregistrarea 3, căutăm sesiuni între 00:00:30 și 00:01:10 și nu găsim niciuna. Adăugăm a doua sesiune pentru cheia 123-345-654,FFBE, care începe și se termină la 00:00:50.
4. Vine înregistrarea 4, iar noi căutăm sesiuni între 23:59:45 și 00:00:25. De data aceasta se găsesc ambele sesiuni — 1 și 2. Toate cele trei sesiuni se combină într-o singură sesiune, cu timpul de început 00:00:00 și timpul de sfârșit 00:00:15.
Din ceea ce este spus în această secțiune, merită reținut următoarele aspecte importante:
- sesiunile — nu sunt feronete de dimensiuni fixe. Durata unei sesiuni este determinată de activitatea dintr-un interval de timp dat;
- mărcile de dată/oră din date determină dacă un eveniment se încadrează într-o sesiune existentă sau într-un interval de inactivitate.
În continuare, vom discuta următoarea variantă de feronete — feronetele „răsturnate”.
Feronetele „răsturnate”
Feronțele „tumbling” capturează evenimentele care au loc într-un anumit interval de timp. Imaginați-vă că trebuie să capturați toate tranzacțiile bursiere ale unei companii la fiecare 20 de secunde, astfel că adunați toate evenimentele din acest interval. La sfârșitul intervalului de 20 de secunde, fereastra „tumbling” se mută pe un nou interval de observație de 20 de secunde. Figura 5.14 ilustrează această situație.
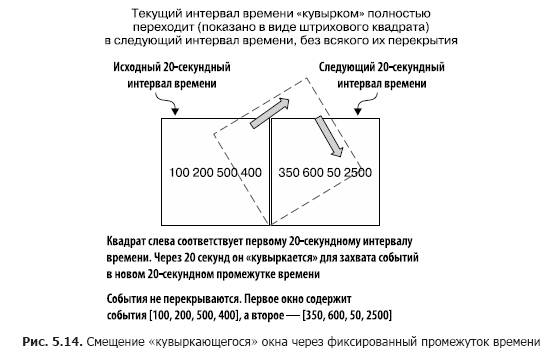
După cum observați, toate evenimentele care au venit în ultimele 20 de secunde sunt incluse în fereastră. La sfârșitul acestui interval, se creează o nouă fereastră.
În listarea 5.6 este prezentat codul care demonstrează utilizarea feronțelor „tumbling” pentru a captura tranzacțiile bursiere la fiecare 20 de secunde (acesta poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
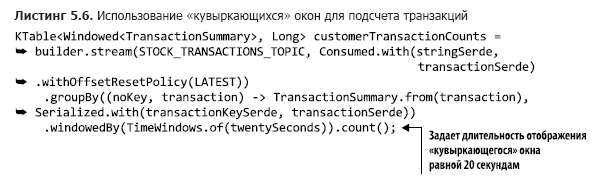
Datorită acestei mici modificări a apelului metodei TimeWindows.of, se poate utiliza o fereastră „tumbling”. În acest exemplu nu există apelul metodei until(), ceea ce va folosi intervalul de retenție implicit, de 24 de ore.
În cele din urmă, este timpul să trecem la ultima opțiune de feronțe — feronțele „hopping”.
Feronțele „sliding”/„hopping”
Feronțele „sliding”/„hopping” sunt asemănătoare cu cele „tumbling”, dar cu o mică diferență. Feronțele „sliding” nu așteaptă sfârșitul intervalului de timp înainte de a crea o nouă fereastră pentru a procesa evenimentele recente. Ele initializează noi calcule după un interval de așteptare mai mic decât durata feronței.
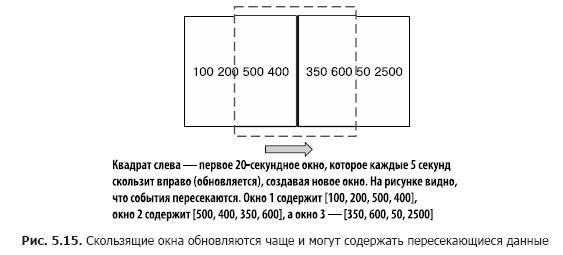
Pentru a ilustra diferențele dintre feronțele „tumbling” și „hopping”, să ne întoarcem la exemplul cu numărarea tranzacțiilor bursiere. Scopul nostru rămâne acela de a număra tranzacțiile, dar nu dorim să așteptăm întregul interval de timp înainte de a actualiza contorul. În schimb, vom actualiza contorul la intervale de timp mai scurte. De exemplu, vom continua să numărăm tranzacțiile la fiecare 20 de secunde, dar vom actualiza contorul la fiecare 5 secunde, așa cum se arată în figura 5.15. Astfel, vom avea trei feronțe de rezultat cu date suprapuse.
În listarea 5.7 este prezentat codul pentru definirea feronțelor „sliding” (acesta poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
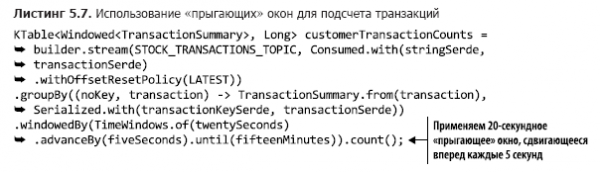
Fereastra „care se răstoarnă” poate fi transformată într-o „fereastră care sare” prin adăugarea apelului metodei advanceBy(). În exemplul dat, intervalul de salvare este de 15 minute.
În această secțiune, ați văzut cum să restricționați rezultatele agregării prin feronțiile temporale. În special, ar trebui să rețineți din această secțiune următoarele trei lucruri:
- dimensiunea feronțiilor este limitată nu de intervalul de timp, ci de activitatea utilizatorilor;
- feronțiile „care se răstoarnă” oferă o imagine de ansamblu a evenimentelor pe parcursul unui interval de timp dat;
- durata feronțiilor „care sar” este fixă, dar acestea sunt adesea actualizate și pot conține în toate feronțiile înregistrări care se intersectează.
În continuare, vom învăța cum să transformăm KTable înapoi în KStream pentru a le conecta.
5.3.3. Conectarea obiectelor KStream și KTable
În capitolul 4 am discutat despre conectarea a două obiecte KStream. Acum va trebui să învățăm să conectăm KTable și KStream. Asta ar putea fi necesar din următorul motiv simplu. KStream este un flux de înregistrări, iar KTable este un flux de actualizări ale înregistrărilor, dar uneori ar putea fi nevoie să adăugăm un context suplimentar fluxului de înregistrări utilizând actualizările din KTable.
Vom lua datele despre numărul de tranzacții bursiere și le vom conecta cu știrile bursiere pentru industriile corespunzătoare. Iată ce trebuie să facem pentru a realiza acest lucru având în vedere codul deja existent.
- Transformați obiectul KTable cu date despre numărul de tranzacții bursiere într-un KStream, schimbând ulterior cheia cu o cheie care indică industria corespunzătoare acestui simbol bursier.
- Creați un obiect KTable care citește date dintr-un topic cu știri bursiere. Acest nou KTable va fi categorizat pe industrii.
- Conectați actualizările de știri cu informațiile despre numărul de tranzacții bursiere pe industrii.
Acum să vedem cum putem implementa acest plan de acțiune.
Transformarea KTable în KStream
Pentru a transforma KTable în KStream, trebuie să faceți următoarele.
- Apelați metoda KTable.toStream().
- Folosind apelul metodei KStream.map, schimbați cheia cu denumirea industriei, după care extrageți din instanța Windowed obiectul TransactionSummary.
Vom lega aceste operații într-un lanț în felul următor (codul poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (lista 5.8).
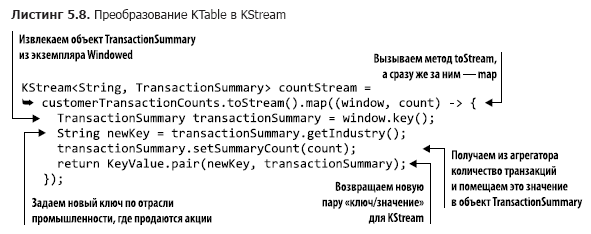
Deoarece efectuăm operațiunea KStream.map, reasignarea pentru instanța KStream returnată se realizează automat atunci când este utilizată în conexiune.
Am finalizat procesul de transformare, acum trebuie să creăm un obiect KTable pentru a citi știrile bursiere.
Crearea unui KTable pentru știrile bursiere
Din fericire, pentru a crea obiectul KTable este suficient un singur rând de cod (acest cod poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listarea 5.9).
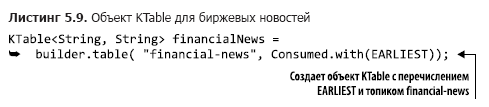
Este de menționat că nu sunt necesare obiecte Serde, deoarece în setări se folosesc Serde pentru șiruri de caractere. De asemenea, datorită utilizării enumerării EARLIEST, tabelul este umplut cu înregistrări de la început.
Acum putem trece la etapa finală — conexiunea.
Conectarea actualizărilor de știri cu datele despre numărul de tranzacții
Crearea conexiunii nu prezintă dificultăți. Vom folosi o conexiune stângă în cazul în care nu există știri bursiere pentru sectorul industrial corespunzător (codul necesar poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listarea 5.10).
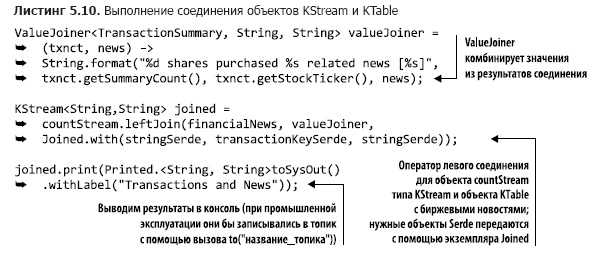
Acest operator leftJoin este destul de simplu. Spre deosebire de conexiunile din capitolul 4, metoda JoinWindow nu este utilizată, deoarece la realizarea conexiunii KStream-KTable pentru fiecare cheie în KTable există doar o singură înregistrare. Această conexiune nu este limitată în timp: înregistrarea este ori prezentă în KTable, ori nu. Concluzia principală: prin intermediul obiectelor KTable se pot îmbogăți KStream-urile cu date de referință mai puțin frecvent actualizate.
Acum vom examina o metodă mai eficientă de îmbogățire a evenimentelor din KStream.
5.3.4. Obiectele GlobalKTable
După cum ați înțeles, există o necesitate de a îmbogăți fluxurile de evenimente sau de a le adăuga context. În capitolul 4 ați văzut conexiuni între două obiecte KStream, iar în secțiunea anterioară — conexiunea KStream și KTable. În toate aceste cazuri este necesară reasignarea fluxului de date când se transformă cheile într-un nou tip sau valoare. Uneori reasignarea se face explicit, iar alteori Kafka Streams o face automat. Reasignarea este necesară deoarece cheile s-au schimbat și înregistrările trebuie să ajungă în noi secțiuni, altfel conexiunea devine imposibilă (acest lucru a fost discutat în capitolul 4, în punctul „Reasignarea datelor” din subsecțiunea 4.2.4).
Reparționarea are un preț
Reparționarea necesită costuri - costuri suplimentare de resurse pentru crearea de subiecte intermediare, păstrarea datelor duplicat într-un alt subiect; de asemenea, înseamnă o întârziere mai mare din cauza scrierii și citirii din acest subiect. În plus, atunci când este nevoie să se efectueze o conexiune pe mai mult de un aspect sau dimensiune, trebuie să se organizeze conexiuni în lanț, să se mapese înregistrările cu chei noi și să se repete procesul de reparționare.
Conexiunea cu seturi de date mai mici
În unele cazuri, volumul de date de referință cu care se planifică conectarea este relativ mic, astfel că copiile lor complete pot încăpea local pe fiecare dintre noduri. Pentru astfel de situații, în Kafka Streams este prevăzută o clasă GlobalKTable.
Instanțele GlobalKTable sunt unice, deoarece aplicația replică toate datele pe fiecare dintre noduri. Și deoarece pe fiecare dintre noduri se află toate datele, nu este nevoie să se reparționeze fluxul de evenimente pe cheia datelor de referință, astfel încât să fie accesibil tuturor secțiilor. Cu ajutorul obiectelor GlobalKTable se pot efectua, de asemenea, conexiuni fără cheie. Să ne întoarcem la unul dintre exemplele anterioare pentru a demonstra această capacitate.
Conectarea obiectelor KStream cu obiectele GlobalKTable
În subsecțiunea 5.3.2 am efectuat agregarea pe feroneri a tranzacțiilor bursiere pe clienți. Rezultatele acestei agregări arătau cam așa:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Deși aceste rezultate corespundeau obiectivului stabilit, ar fi fost mai convenabil dacă s-ar fi afișat și numele clientului și denumirea completă a companiei. Pentru a adăuga numele clientului și denumirea companiei, se pot efectua conexiuni obișnuite, dar va fi necesar să se facă două mapări ale cheilor și să se repete reparționarea. Cu ajutorul GlobalKTable se pot evita costurile pentru astfel de operațiuni.
Pentru aceasta, ne vom folosi de obiectul countStream din listingul 5.11 (codul corespunzător poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), conectându-l cu două obiecte GlobalKTable.
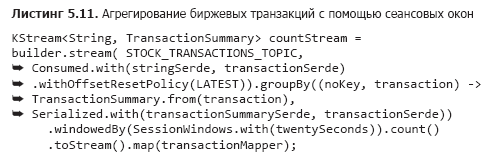
Am discutat despre acest lucru anterior, așa că nu voi repeta. Totuși, vreau să subliniez că codul din funcția toStream().map este abstractizat într-o funcție obiect pentru a îmbunătăți lizibilitatea, în loc de a folosi o expresie lambda încorporată.
Următorul pas este declararea a două instanțe GlobalKTable (codul respectiv poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listare 5.12).
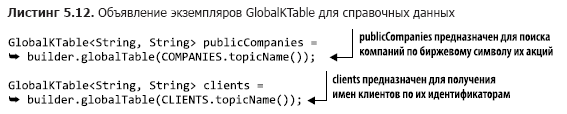
Rețineți că numele topicurilor sunt descrise folosind tipuri enumerate.
Acum că am pregătit toate componentele, trebuie să scriem codul pentru îmbinare (care poate fi găsit în fișierul src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listare 5.13).
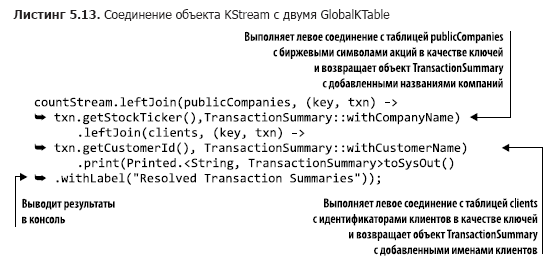
Deși în acest cod sunt incluse două îmbinări, acestea sunt organizate sub formă de lanț, deoarece rezultatele lor nu sunt utilizate separat. Rezultatele sunt afișate la sfârșitul întregii operațiuni.
Când rulați operațiunea de mai sus, veți obține rezultate de forma următoare:
{customer='Barney, Smith' company="Exxon", transactions= 17}Substanța nu s-a schimbat, dar aceste rezultate arată mai clar.
Dacă luați în considerare capitolul 4, ați văzut deja câteva tipuri de îmbinări în acțiune. Acestea sunt enumerate în tab. 5.2. Această tabelă reflectă capacitățile de îmbinare relevante pentru versiunea 1.0.0 Kafka Streams; în versiunile viitoare, este posibil să se schimbe ceva.
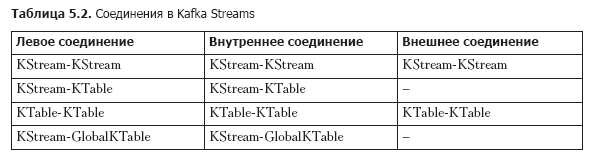
În concluzie, vreau să vă reamintesc esențialul: puteți îmbina fluxuri de evenimente (KStream) și fluxuri de actualizări (KTable) folosind o stare locală. În plus, dacă dimensiunea datelor de referință nu este prea mare, puteți utiliza obiectul GlobalKTable. GlobalKTable replică toate secțiunile pe fiecare nod al aplicației Kafka Streams, asigurând astfel disponibilitatea tuturor datelor, indiferent de secțiunea la care corespunde cheia.
În continuare, vom explora capacitatea Kafka Streams care permite observarea modificărilor stării fără a consuma date din topicul Kafka.
5.3.5. Stare disponibilă pentru interogare
Am efectuat deja câteva operațiuni implicând stare și am afișat întotdeauna rezultatele în consolă (în scopuri de dezvoltare) sau le-am înregistrat într-un topic (pentru scopuri de producție). Înregistrând rezultatele într-un topic, este necesar să folosiți un consumator Kafka pentru a le vizualiza.
Citirea datelor din aceste subiecte poate fi considerată o formă de vizualizare materializată (materialized views). Pentru nevoile noastre, putem folosi definiția unei vizualizări materializate de pe Wikipedia: „...un obiect fizic al bazei de date care conține rezultatele execuției unei interogări. De exemplu, poate fi o copie locală a datelor îndepărtate, sau un subset de rânduri și/sau coloane ale unei tabele sau rezultatelor unei combinații, sau un tabel de sumar obținut prin agregare” (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams permite de asemenea efectuarea de interogări interactive (interactive queries) asupra magazinelor de stare, ceea ce oferă posibilitatea citirii directe a acestei vizualizări materializate. Este important de menționat că interogarea magazinului de stare este o operație „doar pentru citire”. Datorită acestui lucru, nu trebuie să vă faceți griji că veți face starea inconsecventă în timpul procesării datelor de către aplicație.
Posibilitatea interogărilor directe asupra magazinelor de stare este foarte importantă. Aceasta înseamnă că putem crea aplicații — tablouri de bord fără a fi necesar să obținem mai întâi datele de la consumatorul Kafka. De asemenea, îmbunătățește eficiența aplicației, deoarece nu este necesar să scriem din nou datele:
- datorită localizării datelor, acestea pot fi accesate rapid;
- se exclude duplicarea datelor, deoarece acestea nu sunt scrise în stocarea externă.
Cel mai important lucru pe care aș dori să-l rețineți: puteți efectua interogări direct la stare din aplicație. Nu poate fi subestimată capacitatea pe care aceasta v-o oferă. În loc să consumați date din Kafka și să salvați înregistrările într-o bază de date pentru aplicație, puteți efectua interogări asupra magazinelor de stare cu același rezultat. Interogările directe la magazinele de stare înseamnă un volum mai mic de cod (fără consumator) și mai puțin software (fără necesitatea unei tabele de baze de date pentru a stoca rezultatele).
Am acoperit o cantitate considerabilă de informații în acest capitol, așa că vom întrerupe temporar discuția noastră despre interogările interactive la stocările de stare. Dar nu vă faceți griji: în capitolul 9 vom crea o aplicație simplă - un panou de informare cu interogări interactive. Pentru a demonstra interogările interactive și posibilitățile de a le integra în aplicațiile Kafka Streams, vor fi utilizate unele dintre exemplele din acest capitol și cel anterior.
Rezumat
- Obiectele KStream reprezintă fluxuri de evenimente, comparabile cu inserțiile într-o bază de date. Obiectele KTable reprezintă fluxuri de actualizări, fiind mai asemănătoare cu actualizările din baza de date. Dimensiunea unui obiect KTable nu crește, înregistrările vechi fiind înlocuite cu cele noi.
- Obiectele KTable sunt necesare pentru operații de agregare.
- Prin operațiile de fereastră, se pot grupa datele agregate în coșuri temporale.
- Datorită obiectelor GlobalKTable, este posibil să accesați datele de referință din orice punct al aplicației, indiferent de împărțirea pe secțiuni.
- Este posibil să se facă conexiuni între obiectele KStream, KTable și GlobalKTable.
Până acum, ne-am concentrat asupra creării de aplicații Kafka Streams prin intermediul DSL-ului KStream de nivel înalt. Deși abordarea de nivel înalt permite crearea de programe curate și concise, utilizarea sa reprezintă un compromis. Lucrul cu DSL-ul KStream înseamnă sporirea conciziei codului în detrimentul controlului. În capitolul următor, vom explora API-ul de nivel scăzut al nodurilor de procesare și vom analiza alte compromisuri. Programele vor deveni mai lungi decât erau până acum, dar vom avea oportunitatea de a crea practic orice nod de procesare de care am avea nevoie.
→ Puteți citi mai multe despre carte la
→ Pentru utilizatorii Habr, un discount de 25% cu cupoane - Kafka Streams
→ După plata versiunii tipărite a cărții, o carte electronică va fi trimisă pe e-mail.
Sursa: habr.com
