

Iată cum arată redundanța
Codurile de redundanță* sunt larg utilizate în sistemele de calcul pentru a crește fiabilitatea stocării datelor. La Yandex, ele sunt folosite în foarte multe proiecte. De exemplu, utilizarea codurilor de redundanță în locul replicării în depozitul nostru intern de obiecte economisește milioane fără a reduce fiabilitatea. Totuși, în ciuda răspândirii largi, o descriere clară a modului în care funcționează codurile de redundanță este destul de rar întâlnită. Cei care doresc să înțeleagă se confruntă cu ceva de genul (din ):
Mă numesc Vadim, la Yandex mă ocup de dezvoltarea depozitului intern de obiecte MDS. În acest articol voi descrie, în cuvinte simple, fundamentele teoretice ale codurilor de redundanță (codurile Reed-Solomon și LRC). Voi explica cum funcționează, fără matematică complexă și termeni rari. La final, voi prezenta exemple de utilizare a codurilor de redundanță la Yandex.
O serie de detalii matematice nu le voi examina în detaliu, dar voi oferi linkuri pentru cei care doresc să aprofundeze subiectul. De asemenea, aș remarca faptul că unele definiții matematice pot să nu fie stricte, deoarece articolul este destinat nu matematicienilor, ci inginerilor care doresc să înțeleagă esența problemei.
* În literatura în limba engleză, codurile de redundanță sunt adesea numite erasure codes.
1. Esența codurilor de redundanță
Esența tuturor codurilor de redundanță este extrem de simplă: a stoca (sau a transmite) date astfel încât să nu se piardă în caz de erori (defecțiuni ale discurilor, erori de transmisie a datelor etc.).
În majoritatea* codurilor de redundanță, datele sunt împărțite în n blocuri de date, pentru care se consideră m blocuri de coduri de redundanță, astfel rezultând în total n + m blocuri. Codurile de redundanță sunt construite astfel încât să permită recuperarea n blocuri de date, folosind doar o parte din n + m blocuri. În continuare, ne vom concentra doar pe codurile de redundanță pe blocuri, adică pe cele în care datele sunt împărțite în blocuri.
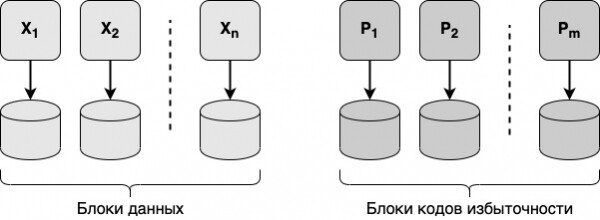
Pentru a restaura toate n blocuri de date, este necesar să aveți minimum n din n + m blocuri, deoarece nu este posibil să obțineți n blocuri având doar n-1 bloc (în acest caz, ar trebui să luați 1 bloc „din aer”). Sunt suficiente n blocuri arbitrare din n + m blocuri pentru a restaura toate datele? Aceasta depinde de tipul de coduri de redundanță, de exemplu, codurile Reed-Solomon permit restaurarea tuturor datelor cu ajutorul n blocuri arbitrare, în timp ce codurile de redundanță LRC - nu întotdeauna.
Stocarea datelor
În sistemele de stocare a datelor, de obicei, fiecare dintre blocurile de date și blocurile de coduri de redundanță sunt scrise pe un disc separat. Astfel, în cazul defectării unui disc arbitrar, datele originale pot fi restabilite și citite. Datele pot fi restaurate chiar și în cazul defectării simultane a mai multor discuri.
Transferul de date
Codurile de redundanță pot fi utilizate pentru transmiterea fiabilă a datelor într-o rețea nesigură. Datele transmise sunt împărțite în blocuri, pentru acestea se calculează coduri de redundanță. Prin rețea sunt transmise atât blocurile de date, cât și blocurile de coduri de redundanță. În cazul în care apar erori în blocuri arbitrare (până la un anumit număr de blocuri), datele pot fi totuși transmise fără erori prin rețea. Codurile Reed-Solomon, de exemplu, sunt utilizate pentru transmiterea datelor prin linii de comunicație optică și în comunicațiile prin satelit.
* Există, de asemenea, coduri de redundanță în care datele nu sunt împărțite în blocuri, de exemplu, codurile Hamming și codurile CRC, utilizate pe scară largă pentru transmiterea datelor în rețele Ethernet. Acestea sunt coduri pentru codificarea rezistentă la interferențe, destinate detectării erorilor, nu corectării acestora (codul Hamming permite, de asemenea, corectarea parțială a erorilor).
2. Codurile Reed-Solomon
Codurile Reed-Solomon sunt unele dintre cele mai răspândite coduri de redundanță, inventate încă în anii 1960 și utilizate pe scară largă în anii 1980 pentru producția în masă de discuri compacte.
Există două întrebări cheie pentru înțelegerea codurilor Reed-Solomon: 1) cum se creează blocuri de coduri de redundanță; 2) cum se recuperează datele cu ajutorul blocurilor de coduri de redundanță. Să găsim răspunsuri la acestea.
Pentru simplificare, vom considera că n=6 și m=4. Alte scheme sunt examinate prin analogie.
Cum se creează blocuri de coduri de redundanță
Fiecare bloc de coduri de redundanță este considerat independent de celelalte. Pentru calcularea fiecărui bloc se folosesc toate blocurile de date n. În diagrama de mai jos, X1-X6 sunt blocuri de date, iar P1–P4 sunt blocuri de coduri de redundanță.
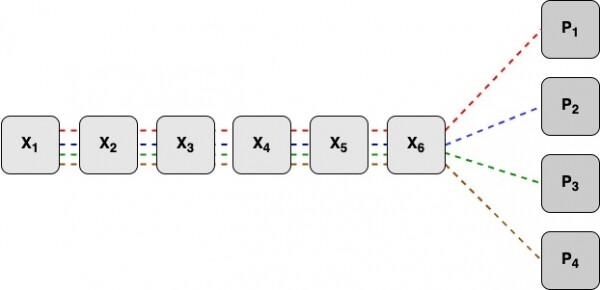
Toate blocurile de date trebuie să fie de dimensiuni egale, iar pentru aliniere se pot folosi biți nuli. Blocurile obținute de coduri de redundanță vor avea aceeași dimensiune ca blocurile de date. Toate blocurile de date sunt împărțite în cuvinte (de exemplu, câte 16 biți). Presupunem că am împărțit blocurile de date în k cuvinte. Atunci, toate blocurile de coduri de redundanță vor fi de asemenea împărțite în k cuvinte.
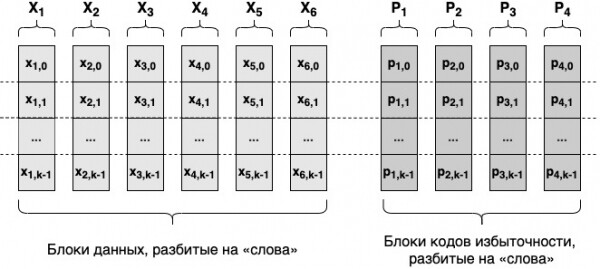
Pentru calcularea celui i-lea cuvânt din fiecare bloc de redundanță se vor folosi cele i-lea cuvinte ale tuturor blocurilor de date. Acestea vor fi calculate conform următoarei formule:
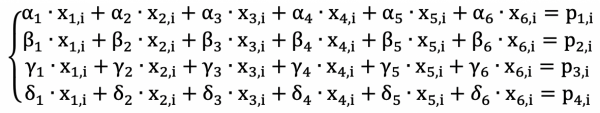
Aici valorile x reprezintă cuvintele blocurilor de date, p reprezintă cuvintele blocurilor de coduri de redundanță, toate alfa, beta, gamma și delta sunt numere special alese, identice pentru toate i. Este important de menționat că toate aceste valori nu sunt numere obișnuite, ci elemente ale unui câmp Galois, iar operațiile +, -, *, / nu sunt operații standard, ci operații speciale introduse pentru elementele câmpului Galois.
De ce sunt necesare câmpurile Galois
Ar părea că totul este simplu: împărțim datele în blocuri, blocurile în cuvinte, folosind cuvintele blocurilor de date pentru a calcula cuvintele blocurilor de coduri de redundanță — obținem blocuri de coduri de redundanță. În general, așa funcționează, dar diavolul se află în detalii:
- Așa cum am menționat mai sus, dimensiunea cuvântului este fixă; în exemplul nostru este de 16 biți. Formulele de mai sus pentru codurile Reed-Solomon sunt astfel încât, atunci când se folosesc numere întregi obișnuite, rezultatul calculului p poate să nu fie reprezentabil printr-un cuvânt de dimensiune acceptabilă.
- La recuperarea datelor, formulele de mai sus vor fi considerate ca un sistem de ecuații care trebuie rezolvat pentru a recupera datele. În procesul de soluționare, poate apărea necesitatea de a împărți numere întregi, rezultatul fiind un număr real, care nu poate fi reprezentat exact în memoria computerului.
Aceste probleme împiedică utilizarea numerelor întregi pentru codurile Reed-Solomon. Soluția problemei este originală și poate fi descrisă astfel: să venim cu numere speciale care pot fi reprezentate folosind cuvinte de lungimea necesară (de exemplu, 16 biți), iar rezultatul tuturor operațiunilor efectuate asupra lor (adunare, scădere, înmulțire, împărțire) va fi, de asemenea, reprezentat în memoria computerului prin cuvinte de lungimea necesară.
Aceste „numere speciale” sunt studiate de matematică de mult timp și se numesc câmpuri. Un câmp este un set de elemente cu operații specifice de adunare, scădere, înmulțire și împărțire.
Câmpurile Galois* sunt câmpuri pentru care există și este unică rezultatul fiecărei operațiuni (+, -, *, /) pentru orice două elemente ale câmpului. Câmpurile Galois pot fi construite pentru numere care sunt puteri ale lui 2: 2, 4, 8, 16 etc. (de fapt, puteri ale oricărui număr prim p, dar în practică ne interesează doar puterile lui 2). De exemplu, pentru cuvinte de dimensiune de 16 biți, acest câmp conține 65.536 de elemente, pentru fiecare pereche dintre acestea putându-se găsi rezultatul oricărei operațiuni (+, -, *, /). Valorile x, p, alfa, beta, gamma, delta din ecuațiile de mai sus pentru calcule vor fi considerate elemente ale câmpului Galois.
Prin urmare, avem un sistem de ecuații, cu ajutorul căruia putem construi blocuri de coduri de redundanță, scriind un program de calculator corespunzător. Cu acest sistem de ecuații putem efectua, de asemenea, recuperarea datelor.
* Aceasta nu este o definiție strictă, ci mai degrabă o descriere.
Cum să recuperăm datele
Recuperarea este necesară atunci când din n + m blocuri, o parte a blocurilor lipsește. Acestea pot fi atât blocuri de date, cât și blocuri de coduri de redundanță. Lipsa blocurilor de date și/sau a blocurilor de coduri de redundanță va însemna că în ecuațiile de mai sus sunt necunoscute variabilele corespunzătoare x și/sau p.
Ecuațiile pentru codurile Reed-Solomon pot fi considerate un sistem de ecuații în care toate valorile alfa, beta, gamma, delta sunt constante, toate x și p, corespunzătoare blocurilor disponibile, sunt variabile cunoscute, iar celelalte x și p sunt necunoscute.
De exemplu, să presupunem că blocurile de date 1, 2, 3 și blocul de coduri de redundanță 2 sunt indisponibile, atunci pentru grupa i de cuvinte va exista următorul sistem de ecuații (necunoscutele sunt marcate cu roșu):
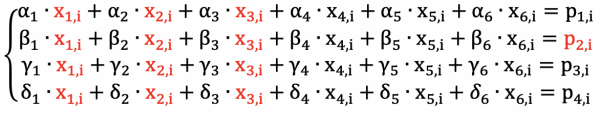
Avem un sistem de 4 ecuații cu 4 necunoscute, ceea ce înseamnă că putem să-l rezolvăm și să recuperăm datele!
Din acest sistem de ecuații rezultă o serie de concluzii despre recuperarea datelor pentru codurile Reed-Solomon (n blocuri de date, m blocuri de coduri de redundanță):
- Datele pot fi recuperate în cazul pierderii oricăror m blocuri sau mai puțin. În cazul pierderii a m+1 sau mai multe blocuri, datele nu pot fi recuperate: nu se poate rezolva un sistem de m ecuații cu m + 1 necunoscute.
- Pentru a recupera chiar și un singur bloc de date, trebuie să folosim orice n din blocurile rămase, putând utiliza oricare dintre codurile de redundanță.
Ce mai trebuie să știți
În descrierea de mai sus, evit o serie de întrebări importante, pentru analizarea cărora trebuie să ne aprofundăm în matematică. În special, nu menționez următoarele:
- Sistemul de ecuații pentru codurile Reed-Solomon trebuie să aibă o (singură) soluție pentru orice combinații de necunoscute (nu mai mult de m necunoscute). Pe baza acestei cerințe, se aleg valorile alpha, beta, gamma și delta.
- Sistemul de ecuații trebuie să fie capabil să fie construit automat (în funcție de blocurile care nu sunt disponibile) și să fie rezolvat.
- Trebuie construit un câmp Galois: pentru o dimensiune dată a cuvântului, trebuie să putem găsi rezultatul oricărei operații (+, -, *, /) pentru orice două elemente.
La finalul articolului există linkuri către literatura referitoare la aceste întrebări importante.
Alegerea n și m
Cum se aleg practic n și m? În practică, în sistemele de stocare a datelor, codurile de redundanță sunt utilizate pentru economisirea spațiului, așa că m este întotdeauna ales mai mic decât n. Valorile lor concrete depind de o serie de factori, inclusiv:
- Fiabilitatea stocării datelor. Cu cât m este mai mare, cu atât mai multe defecte ale discurilor pot fi suportate, adică fiabilitatea este mai mare.
- Redundanța stocării. Cu cât raportul m / n este mai mare, cu atât redundanța stocării va fi mai mare, iar sistemul va costa mai mult.
- Timpul de procesare a cererilor. Cu cât suma n + m este mai mare, cu atât timpul de răspuns la cereri va fi mai lung. Deoarece pentru citirea datelor (în timpul recuperării) trebuie citite n blocuri, găzduite pe n discuri diferite, timpul de citire va fi determinat de cel mai lent disc.
În plus, stocarea datelor în mai multe centre de date impune restricții suplimentare asupra alegerii n și m: în cazul în care un centru de date este oprit, datele trebuie să fie încă disponibile pentru citire. De exemplu, pentru stocarea datelor în 3 centre de date, trebuie respectată condiția: m >= n/2, altfel este posibil să se ajungă în situația în care datele nu sunt disponibile pentru citire în cazul unei opriri a unui centru de date.
3. LRC — Coduri locale de reconstrucție
Pentru a recupera datele folosind codurile Reed-Solomon, este necesar să se folosească n blocuri de date arbitrare. Acesta este un dezavantaj considerabil pentru sistemele distribuite de stocare a datelor, deoarece pentru a recupera datele de pe un disc defect, va trebui să se citească datele de pe majoritatea celorlalte, generând o încărcătură suplimentară mare pe discuri și rețea.
Cele mai frecvente erori sunt indisponibilitatea unui bloc de date din cauza defectării sau suprasolicitării unui disc. Poate fi redusă cumva încărcătura excesivă pentru recuperarea datelor în acest caz (cel mai frecvent)? Se pare că da: special pentru aceasta există codurile de redundanță LRC.
LRC (Coduri locale de reconstrucție) sunt coduri de redundanță inventate de Microsoft pentru utilizarea în Windows Azure Storage. Ideea LRC este extrem de simplă: a împărți toate blocurile de date în două (sau mai multe) grupe și a calcula o parte din blocurile de coduri de redundanță pentru fiecare grupă în parte. Astfel, o parte din blocurile de coduri de redundanță vor fi calculate utilizând toate blocurile de date (în LRC acestea sunt denumite coduri globale de redundanță), iar o parte — cu ajutorul uneia dintre cele două grupe de blocuri de date (acestea sunt denumite coduri locale de redundanță).
LRC este reprezentat prin trei numere: n-r-l, unde n este numărul de blocuri de date, r este numărul de blocuri globale de coduri de redundanță, iar l este numărul de blocuri locale de coduri de redundanță. Pentru a citi datele în cazul indisponibilității unui bloc de date, este necesar să se citească doar n/l blocuri — acesta fiind de l ori mai puțin decât în codurile Reed-Solomon.
De exemplu, să analizăm schema LRC 6-2-2. X1–X6 — 6 blocuri de date, P1, P2 — 2 blocuri globale de redundanță, P3, P4 — 2 blocuri locale de redundanță.
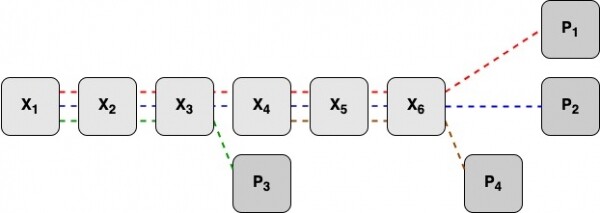
Blocurile de coduri de redundanță P1, P2 sunt calculate cu ajutorul tuturor blocurilor de date. Blocul de coduri de redundanță P3 — cu ajutorul blocurilor de date X1–X3, blocul de coduri de redundanță P4 — cu ajutorul blocurilor de date X4–X6.
Restul se face în LRC, similar cu codurile Reed-Solomon. Ecuațiile pentru calcularea cuvintelor blocurilor de coduri redundante sunt următoarele:
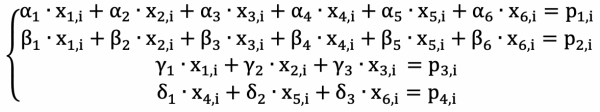
Pentru a determina numerele alfa, beta, gamma, delta, este necesar să se îndeplinească o serie de condiții care garantează posibilitatea de a recupera datele (adică soluția sistemului de ecuații). Mai multe detalii pot fi citite în .
De asemenea, în practică, pentru calcularea codurilor redundante locale P3, P4 se aplică operația XOR.
Din sistemul de ecuații pentru LRC rezultă o serie de concluzii:
- Pentru a recupera un bloc de date este suficient să se citească n/l blocuri (n/2 în exemplul nostru).
- Dacă r + l blocuri nu sunt accesibile, iar toate blocurile fac parte din aceeași grupă, atunci datele nu pot fi recuperate. Acest lucru poate fi explicat ușor printr-un exemplu. Să presupunem că blocurile X1–X3 și P3 nu sunt accesibile: acestea constituie r + l blocuri dintr-o singură grupă, 4 în cazul nostru. Atunci avem un sistem de 3 ecuații cu 4 necunoscute, care nu poate fi rezolvat.
- În toate celelalte cazuri de inaccesibilitate a r + l blocuri (când din fiecare grupă este disponibil cel puțin un bloc), datele în LRC pot fi recuperate.
Astfel, LRC are avantaje față de codurile Reed-Solomon în recuperarea datelor după erori simple. În codurile Reed-Solomon, pentru a recupera chiar și un singur bloc de date, este necesar să se utilizeze n blocuri, în timp ce în LRC pentru recuperarea unui bloc de date este suficient să se folosească n/l blocuri (n/2 în exemplul nostru). Pe de altă parte, LRC este inferior codurilor Reed-Solomon în ceea ce privește numărul maxim de erori tolerate. În exemplele de mai sus, codurile Reed-Solomon pot recupera datele în cazul a 4 erori, iar pentru LRC există 2 combinații de 4 erori în care datele nu pot fi recuperate.
Ceea ce este mai important — depinde de situația specifică, dar adesea economisirea sarcinii redundante oferite de LRC depășește o ușoară fiabilitate mai mică a stocării.
4. Alte coduri de redundanță
Pe lângă codurile Reed-Solomon și LRC, există multe alte coduri de redundanță. Diferite coduri de redundanță folosesc matematici diferite. Iată câteva alte coduri de redundanță:
- Cod de redundanță prin operatorul XOR. Operația XOR se desfășoară pe n blocuri de date, și rezultatul este 1 bloc de coduri redundante, adică schema n+1 (n blocuri de date, 1 cod de redundanță). Se folosește în , unde blocurile de date și codurile de redundanță sunt scrise în mod ciclisc pe toate discurile din matrice.
- Algoritmul even-odd, bazat pe operația XOR. Permite construirea a 2 blocuri de coduri de redundanță, adică schema n+2.
- Algoritmul STAR, bazat pe operația XOR. Permite construirea a 3 blocuri de coduri de redundanță, adică schema n+3.
- Codurile pyramide — încă un tip de coduri de redundanță de la Microsoft.
5. Utilizare în Yandex
O serie de proiecte infrastructurale ale Yandex utilizează coduri de redundanță pentru stocarea fiabilă a datelor. Iată câteva exemple:
- Stocarea obiectelor interne MDS, despre care am scris la începutul articolului.
- — sistemul MapReduce al Yandex.
- (Yandex DataBase) — bază de date distribuită newSQL.
În MDS, se utilizează coduri de redundanță LRC, schema 8-2-2. Datele cu coduri de redundanță sunt scrise pe 12 discuri diferite în servere diferite în 3 centre de date diferite: câte 4 servere în fiecare centru. Citește mai multe despre asta în .
În YT se utilizează atât coduri Reed-Solomon (schema 6-3), care au fost implementate primele, cât și coduri de redundanță LRC (schema 12-2-2), LRC fiind metoda preferată de stocare.
În YDB se utilizează coduri de redundanță bazate pe even-odd (schema 4-2). Despre codurile de redundanță în YDB s-a vorbit deja .
Aplicarea diferitelor scheme de coduri de redundanță este dictată de diferitele cerințe impuse sistemelor. De exemplu, în MDS, datele stocate cu ajutorul LRC sunt distribuite în 3 centre de date. Este esențial ca datele să rămână accesibile la citire în cazul defectării oricărui centru de date, așa că blocurile trebuie să fie distribuite astfel încât, în cazul inaccesibilității oricărui centru, numărul blocurilor inaccesibile să nu depășească limita admisibilă. În schema 8-2-2 se pot plasa câte 4 blocuri în fiecare centru, astfel încât, la deconectarea oricărui centru, vor fi inaccesibile 4 blocuri, iar datele vor putea fi citite. Indiferent de schema aleasă pentru plasarea în cele 3 centre de date, trebuie să existe (r + l) / n >= 0,5, adică redundanța stocării va fi de minimum 50%.
În YT situația este diferită: fiecare cluster YT se află integral într-un centru de date (clustere diferite în centre de date diferite), astfel încât nu există această restricție. Schema 12-2-2 oferă o redundanță de 33%, adică stocarea datelor devine mai ieftină, de asemenea, pot supraviețui până la 4 deconectări simultane ale discurilor, la fel ca schema din MDS.
Există încă multe particularități în aplicarea codurilor de redundanță în sistemele de stocare și procesare a datelor: nuanțele restaurării datelor, influența restaurării asupra timpului de executare a cererilor, particularitățile scrierii datelor etc. Am de gând să vorbesc separat despre aceste și alte particularități ale aplicării codurilor de redundanță în practică, dacă tema va fi de interes.
6. Linkuri
- Seria de articole despre codurile Reed-Solomon și câmpurile Galois:
În acestea se analizează matematica mai profund, într-un limbaj accesibil. - Articol de la Microsoft despre LRC:
În secțiunea 2 se explică pe scurt teoria, apoi se discută despre experiența aplicării LRC în practică. - Schema even-odd:
- Schema STAR:
- Coduri piramidale:
- Coduri de redundanță în MDS:
- Coduri de redundanță în YT:
- Coduri de redundanță în YDB:
Sursa: habr.com
