

Urmărirea conexiunilor („conntrack”) este o funcție esențială a stivei de rețea din nucleul Linux. Aceasta permite nucleului să urmărească toate conexiunile logice de rețea sau fluxurile, identificând astfel toate pachetele care formează fiecare flux, pentru a putea fi procesate consecvent împreună.
Conntrack este o funcție importantă a nucleului, utilizată în anumite cazuri fundamentale:
- NAT se bazează pe informațiile de la conntrack, permițându-i să proceseze uniform toate pachetele dintr-un singur flux. De exemplu, atunci când un pod se adresează unui serviciu Kubernetes, echilibratorul de sarcină kube-proxy folosește NAT pentru a direcționa traficul către un anumit pod din interiorul clusterului. Conntrack înregistrează că pentru o anumită conexiune toate pachetele către IP-ul serviciului trebuie să fie trimise către același pod, iar pachetele returnate de podul backend-ului trebuie să fie redirecționate de NAT înapoi către podul din care a venit cererea.
- Firewall-urile cu urmărirea stării, cum ar fi Calico, se bazează pe informațiile de la conntrack pentru a adăuga traficul „de răspuns” în lista albă. Acest lucru vă permite să redactați o politică de rețea care spune: „permiteți pod-ului meu să se conecteze la orice adresă IP externă” fără a fi necesar să scrieți o politică pentru a permite explicit traficul de răspuns. (Fără aceasta, ar fi trebuit să adăugați o regulă mult mai puțin sigură „permit pachetelor în podul meu din orice IP”.)
În plus, conntrack îmbunătățește de obicei performanța sistemului (reducând consumul de timp al procesorului și timpul de întârziere al pachetelor), deoarece doar primul pachet dintr-un flux
trebuie să treacă prin procesarea completă a stivei de rețea pentru a determina ce să facă cu acesta. Consultați postarea „” pentru a vedea un exemplu despre cum funcționează.
Cu toate acestea, conntrack are propriile sale limitări...
Așadar, unde a mers totul prost?
Tabelul conntrack are o dimensiune maximă personalizabilă, iar dacă devine plin, conexiunile încep de obicei să fie refuzate sau întrerupte. Pentru a gestiona traficul majorității aplicațiilor, în tabel este disponibilă o cantitate suficientă de spațiu liber și acest lucru nu va deveni niciodată o problemă. Totuși, există câteva scenarii în care merită să luați în considerare utilizarea tabelului conntrack:
- Cazul cel mai evident este atunci când serverul dumneavoastră procesează un număr extrem de mare de conexiuni active simultane. De exemplu, dacă tabela dumneavoastră conntrack este setată la 128k înregistrări, dar aveți > 128k conexiuni simultane, cu siguranță veți întâmpina o problemă!
- Un caz puțin mai puțin evident: dacă serverul dumneavoastră procesează un număr foarte mare de conexiuni pe secundă. Chiar dacă conexiunile sunt de scurtă durată, ele continuă să fie urmărite de Linux pentru o perioadă de timp (implicit 120s). De exemplu, dacă tabela dumneavoastră conntrack este setată la 128k înregistrări și încercați să procesați 1100 de conexiuni pe secundă, acestea vor depăși dimensiunea tabelei conntrack, chiar dacă conexiunile sunt foarte efemere (128k / 120s = 1092 conexiuni / s).
Există câteva tipuri nișate de aplicații care se încadrează în aceste categorii. În plus, dacă aveți mulți adversari, umplerea tabelei conntrack a serverului dumneavoastră cu multe conexiuni semi-închise poate fi utilizată ca parte a unei atacuri de tip „refuz de serviciu” (DOS). În ambele cazuri, conntrack poate deveni un gât de blocare în sistemul dumneavoastră. În unele cazuri, ajustările parametrilor tabelei conntrack pot fi suficiente pentru a satisface nevoile dumneavoastră — prin creșterea dimensiunii sau reducerea timpurilor de expirare conntrack (dar dacă faceți asta greșit, veți întâmpina mari dificultăți). Pentru alte cazuri, va fi necesar să ocoliți conntrack pentru traficul agresiv.
Un exemplu real
Să dăm un exemplu concret: un mare furnizor de SaaS cu care am lucrat avea o serie de servere memcached pe gazde (nu mașini virtuale), fiecare dintre acestea procesând 50K+ conexiuni efemere pe secundă.
Ei au experimentat cu configurația conntrack, mărind dimensiunile tabelei și reducând timpul de urmărire, dar configurația a devenit nesigură, consumul de RAM a crescut semnificativ, ceea ce a fost o problemă (de ordinul GB!), iar conexiunile erau atât de scurte încât conntrack nu genera câștigul de performanță obișnuit (reducerea consumului de CPU sau întârzierilor pachetelor).
Ca alternativă, ei s-au adresat Calico. Politicile de rețea Calico permit evitarea utilizării conntrack pentru un anumit tip de trafic (folosind opțiunea doNotTrack pentru politici). Aceasta le-a oferit nivelul de performanță necesar, plus un nivel suplimentar de securitate oferit de Calico.
Ce sunt dispus să facă pentru a înlătura conntrack?
- Politicile de rețea do-not-track ar trebui în general să fie simetrice. În cazul unui furnizor SaaS: aplicațiile lor funcționau în interiorul unei zone protejate și, prin urmare, folosind politica de rețea, puteau adăuga pe lista albă traficul de la alte aplicații specifice cărora le era permis accesul la memcached.
- Politica do-not-track nu ține cont de direcția conexiunii. Astfel, în cazul unei breșe la serverul memcached, teoretic se poate încerca conectarea la oricare dintre clienții memcached, dacă folosește portul de sursă corect. Totuși, dacă ai definit corect politica de rețea pentru clienții tăi memcached, aceste încercări de conectare vor fi respinse pe partea clientului.
- Politica do-not-track se aplică fiecărui pachet, spre deosebire de politicile obișnuite care se aplică doar primului pachet din flux. Aceasta poate crește consumul de resurse CPU pentru fiecare pachet, deoarece trebuie aplicată politica pentru fiecare pachet. Dar pentru conexiunile de scurtă durată, acest consum este echilibrat de reducerea cheltuielilor de resurse pentru procesarea conntrack. De exemplu, în cazul unui furnizor SaaS, numărul de pachete pentru fiecare conexiune a fost foarte mic, astfel că cheltuielile suplimentare de resurse CPU pentru aplicarea politicilor fiecărui pachet au fost justificate.
Să înceapă testele
Am efectuat un test pe un pod cu serverul memcached și mai multe poduri cu clienți memcached, desfășurate pe noduri îndepărtate, astfel încât să putem lansa un număr foarte mare de conexiuni pe secundă. Serverul cu podul serverului memcached avea 8 nuclee și 512k înregistrări în tabela conntrack (mărimea standard a tabelei pentru gazdă).
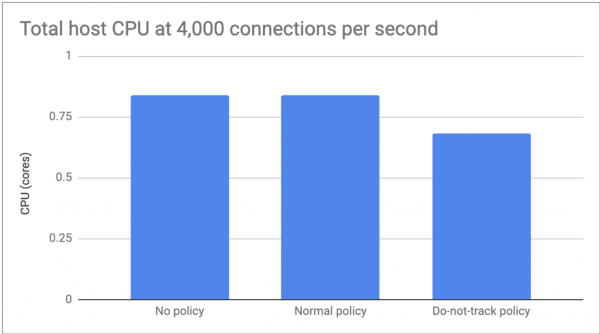
Am măsurat diferența de performanță între: fără politică de rețea; cu o politică Calico obișnuită; și cu politica Calico do-not-track.
Pentru primul test, am setat numărul de conexiuni la 4.000 pe secundă, astfel că ne-am putut concentra pe diferența de consum de CPU. Aici nu au existat diferențe semnificative între absența politicii și politica obișnuită, însă politica do-not-track a crescut consumul de CPU cu aproximativ 20%.
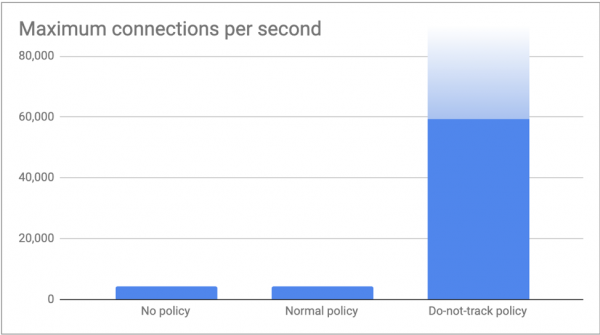
În al doilea test, am inițiat cât mai multe conexiuni posibil cu clienții noștri și am măsurat numărul maxim de conexiuni pe secundă pe care serverul nostru memcached a reușit să le gestioneze. Așa cum ne așteptam, în cazul „fără politici” și „politica obișnuită”, ambele au atins limita conntrack de peste 4.000 de conexiuni pe secundă (512k / 120s = 4.369 conexiuni/s). Cu politica do-not-track, clienții noștri au trimis 60.000 de conexiuni pe secundă fără probleme. Suntem siguri că am putea crește acest număr conectând mai mulți clienți, dar considerăm că aceste cifre sunt deja suficiente pentru a ilustra mesajul acestui articol!
Concluzie
Conntrack este o funcție importantă a nucleului. Își îndeplinește foarte bine rolul. Este utilizat adesea de componente cheie ale sistemului. Cu toate acestea, în anumite scenarii, suprasarcina cauzată de conntrack depășește avantajele obișnuite pe care le oferă. În acest scenariu, politicile de rețea Calico pot fi folosite pentru a dezactiva selectiv utilizarea conntrack, sporind astfel nivelul de securitate în rețea. Pentru tot restul traficului, conntrack rămâne partenerul vostru!
Citiți și alte articole de pe blogul nostru:
Sursa: habr.com
