

Platforma permite standardizarea creării , inclusiv în infrastructura furnizorilor de servicii cloud, pe platforme de virtualizare sau în sisteme bare-metal. Pentru a crea, în adevăratul sens al cuvântului, o platformă cloud, a trebuit să preluăm controlul strict asupra tuturor elementelor folosite și astfel să creștem fiabilitatea complexului proces de automatizare.
O soluție evidentă a fost utilizarea ca standard a Red Hat Enterprise Linux CoreOS (o variantă a Red Hat Enterprise Linux) și CRI-O, și iată de ce...
Având în vedere că tema navigației este foarte potrivită pentru a găsi analogii în explicarea funcționării Kubernetes și containerelor, să încercăm să explicăm problemele de afaceri pe care le rezolvă CoreOS și CRI-O, prin exemplul . În 1803, Marcus Brunel a fost însărcinat cu fabricarea a 100 de mii de blocuri de rigging pentru nevoile flotei navale în expansiune a Marii Britanii. Blocul de rigging este un tip de echipament folosit pentru fixarea sforilor la vele. Până la începutul secolului 19, aceste blocuri erau fabricate manual, dar Brunel a reușit să automatizeze producția și să înceapă fabricarea blocurilor standardizate folosind mașini. Automatizarea acestui proces a însemnat că toate blocurile rezultate erau practic identice, puteau fi ușor înlocuite în cazul unor defectiuni și puteau fi produse în cantități mari.
Și acum imaginați-vă că Brunel ar fi trebuit să facă această muncă pentru 20 de modele diferite de nave (versiuni Kubernetes) și pentru cinci planete diferite cu curenți marini și vânturi complet diferite (furnizori de cloud). În plus, era necesar ca toate navele (clusterele OpenShift), indiferent de planetele pe care navighează, să se comporte uniform din perspectiva capitanilor (operatori care gestionează funcționarea clusterelor). Continuând analogia marină, capitanilor navelor nu le pasă ce blocuri de rigging (CRI-O) sunt folosite pe navele lor – pentru ei este esențial ca aceste blocuri să fie rezistente și fiabile.
În fața OpenShift 4, ca platformă de cloud, se află o problemă de afaceri foarte similară. Noduri noi trebuie să fie create în momentul formării clusterului, în caz de eșec al unuia dintre noduri, sau atunci când se scalează clusterul. Atunci când se creează și se inițializează un nou nod, componentele critice ale gazdei, inclusiv CRI-O, trebuie să fie configurate corespunzător. Ca în orice alt domeniu de producție, la început este necesar să se furnizeze „materia primă”. În cazul navelor, materiile prime sunt metalul și lemnul. Totuși, când se creează gazda pentru desfășurarea containerelor în clusterul OpenShift 4, la intrare trebuie să existe fișiere de configurare și servere API furnizate. După aceea, OpenShift va asigura nivelul necesar de automatizare pe tot parcursul ciclului de viață, oferind suportul de produs necesar pentru utilizatori finali și recuperând astfel investițiile în platformă.
OpenShift 4 a fost creat astfel încât să asigure o actualizare ușoară a sistemului pe parcursul întregului ciclu de viață al platformei (pentru versiunile 4.X) pentru toți principalii furnizori de computație în cloud, platforme de virtualizare și chiar sisteme bare metal. Pentru aceasta, nodurile trebuie să fie create pe baza unor elemente interschimbabile. Atunci când clusterul necesită o nouă versiune de Kubernetes, acesta primește și versiunea corespunzătoare de CRI-O pe CoreOS. Deoarece versiunea CRI-O este legată direct de Kubernetes, acest lucru simplifică în mare măsură orice permutări în scopul testării, depistării problemelor sau suportului. În plus, o astfel de abordare ajută la reducerea costurilor pentru utilizatorii finali și Red Hat.
Aceasta este o viziune fundamental nouă asupra clustrelor Kubernetes, care pune bazele pentru planificarea unor funcții noi, foarte utile și atractive. CRI-O (proiectul Open Container Runtime Interface — Open Container Initiative, pe scurt CRI-OCI) s-a dovedit a fi cea mai bună alegere pentru crearea masivă de noduri, necesară pentru a funcționa cu OpenShift. CRI-O va înlocui motorul Docker folosit anterior, oferind utilizatorilor OpenShift – da, nu ați auzit greșit – un motor de container plictisitor, creat special pentru a lucra cu Kubernetes.
Lumea containerelor deschise
Lumea se îndreaptă de mult timp spre containere deschise. Fie că este vorba despre Kubernetes sau la niveluri mai de bază, duce la apariția unui ecosistem de inovații la fiecare nivel.
Totul a început cu crearea inițiativei Open Containers Initiative . În acest stadiu timpuriu al activității, au fost formulate specificațiile pentru și . Acest lucru a permis garantarea faptului că instrumentele pot folosi un standard unic și un format unic pentru a lucra cu ele. Ulterior, au fost adăugate specificațiile , ceea ce a permis utilizatorilor să facă schimb cu ușurință de .
Apoi, comunitatea Kubernetes a dezvoltat un standard unic pentru interfața pluggable, denumită . Datorită acestui fapt, utilizatorii Kubernetes au putut conecta diverse motoare pentru a lucra cu containere în plus față de Docker.
Inginerii Red Hat și Google au observat o nevoie existentă pe piață pentru un motor de containere care să poată accepta cereri de la Kubelet prin protocolul CRI și au prezentat containere care erau compatibile cu specificațiile OCI menționate mai sus. Astfel, Dar, așteptați, pentru că am spus că acest material va fi dedicat CRI-O? Într-adevăr, așa este, doar că odată cu lansarea proiectul a fost redenumit CRI-O.
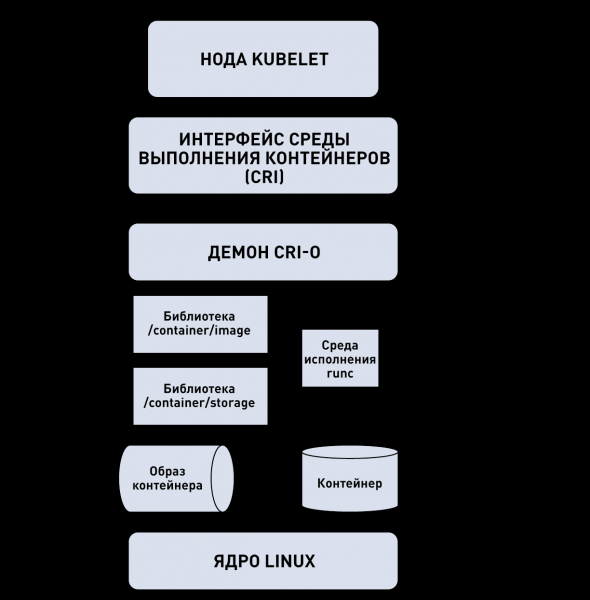
Fig. 1.
Inovații cu CRI-O și CoreOS
Odată cu lansarea platformei OpenShift 4, a fost schimbat , utilizat implicit în platformă, iar CRI-O a înlocuit Docker, oferind un mediu economic, stabil, simplu și lipsit de agitație pentru rularea containerelor, care se dezvoltă în paralel cu Kubernetes. Aceasta simplifică semnificativ întreținerea și configurarea cluster-ului. Configurarea motorului de containere și a gazdelor, precum și gestionarea acestora devine automatizată în cadrul OpenShift 4.
Stai puțin, cum adică?
Exact așa, cu apariția OpenShift 4, acum nu mai este necesar să te conectezi la gazde separate și să instalezi motorul de containere, să configurezi stocarea, să configurezi serverele pentru căutare sau să configurezi rețeaua. Platforma OpenShift 4 a fost complet reproiectată pentru utilizarea the nu doar din perspectiva aplicațiilor utilizatorilor finali, ci și din perspectivă operațiunilor de bază la nivel de platformă, cum ar fi desfășurarea imaginilor, configurarea sistemului sau instalarea actualizărilor.
Kubernetes a permis întotdeauna utilizatorilor să gestioneze aplicațiile, definind starea dorită și folosind , pentru a garanta că starea efectivă se aliniază cât mai mult cu starea specificată. Această deschide mari oportunități atât din perspectiva dezvoltării, cât și din perspectiva operațiunilor. Dezvoltatorii pot defini starea dorită, operatorului sub formă de fișier YAML sau JSON, iar apoi operatorul poate crea în mediu operațional instanța necesară a aplicației, astfel încât starea de funcționare a acestei instanțe va corespunde total stării specificate.
Folosind operatorii (Operators) în platformă, OpenShift 4 aduce această nouă paradigmă (folosind conceptul de stare specificată și efectivă) în gestionarea RHEL CoreOS și CRI-O. Sarcinile de configurare și gestionare a versiunilor sistemului de operare și al motorului de containere sunt automatizate cu ajutorul așa-numitului . MCO simplifică în mod semnificativ munca administratorului de cluster, practic automatizând ultimele etape ale instalării, precum și operațiunile ulterioare instalării (operațiuni ziua doi). Toate acestea fac din OpenShift 4 o adevărată platformă cloud. Vom discuta mai în detaliu despre acest lucru mai târziu.
Lansarea containerelor
Utilizatorii au avut posibilitatea de a utiliza motorul CRI-O în platforma OpenShift începând cu versiunea 3.7 în statut de Tech Preview și cu versiunea 3.9 în statut de Generally Available (dispune de suport în prezent). În plus, Red Hat utilizează pe scară largă în OpenShift Online începând cu versiunea 3.10. Toate acestea au permis echipei care lucrează la CRI-O să acumuleze o experiență uriașă în desfășurarea pe scară largă a containerelor în clustere mari Kubernetes. Pentru a obține o idee de bază despre modul în care Kubernetes utilizează CRI-O, să analizăm următoarea ilustrație, care arată principiul de lucru al arhitecturii.
Fig. 2. Cum funcționează containerele într-un cluster Kubernetes
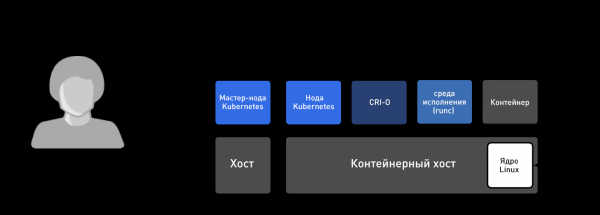
CRI-O simplifică crearea de noi gazde pentru containere prin sincronizarea întregului nivel superior în timpul inițializării noilor noduri și la lansarea noilor versiuni ale platformei OpenShift. Revizuirea întregii platforme permite actualizări / rollback-uri tranzacționale, precum și prevenirea blocajelor reciproce în dependențele dintre nucleul gazdelor de containere, motorul de containere, noduri (Kubelets) și nodul master Kubernetes Master. Prin gestionarea centralizată a tuturor componentelor platformei, cu control și gestionare a versiunilor, se poate monitoriza întotdeauna un traseu clar din starea A în starea B. Aceasta simplifică procesul de actualizări, crește securitatea, îmbunătățește raportarea performanței și ajută la reducerea costurilor de actualizare și instalare a noilor versiuni.
Demonstrarea puterii elementelor interschimbabile
După cum s-a menționat anterior, utilizarea Machine Config Operator pentru gestionarea gazdelor de containere și a motorului de containere în OpenShift 4 oferă un nou nivel de automatizare care nu a fost posibil pe platforma Kubernetes anterior. Pentru a demonstra noile capabilități, vom arăta cum ați putea face modificări în fișierul crio.conf. Pentru a evita confuzia în terminologie, încercați să vă concentrați pe rezultate.
În primul rând, să creăm ceea ce se numește configurația mediului de execuție pentru containere – Container Runtime Config. Considerați-l ca un fel de resursă Kubernetes care reprezintă configurația pentru CRI-O. În realitate, este o versiune specializată a ceea ce se numește MachineConfig, care reprezintă orice configurație desfășurată pe mașina RHEL CoreOS în cadrul clusterei OpenShift.
Această resursă personalizată, numită ContainerRuntimeConfig, a fost creată pentru a ușura administrarea configurației CRI-O pentru administratorii de cluster. Este un instrument destul de puternic, care poate fi aplicat doar pe anumite noduri, în funcție de setările MachineConfigPool. Considerați-o ca un grup de mașini care servesc același scop.
Acordați atenție ultimelor două linii pe care urmează să le modificăm în fișierul /etc/crio/crio.conf. Aceste două linii sunt foarte asemănătoare cu liniile din fișierul crio.conf, iar acestea sunt:
vi ContainerRuntimeConfig.yaml
Concluzie:
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Acum vom trimite acest fișier în clusterul Kubernetes și vom verifica dacă a fost creat cu adevărat. Rețineți că operațiunea se desfășoară exact ca și în cazul oricărui alt resource Kubernetes:
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Concluzie:
NAME              AGE
set-log-and-pid   22h
După ce am creat ContainerRuntimeConfig, trebuie să modificăm unul dintre MachineConfigPools pentru a informa Kubernetes că dorim să aplicăm această configurație unui anumit grup de mașini din cluster. În acest caz, vom modifica MachineConfigPool pentru nodurile master:
oc edit MachineConfigPool/master
Ieșire (pentru claritate, esența principală este lăsată):
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
În acest moment, MCO începe să creeze un nou fișier crio.conf pentru cluster. În același timp, fișierul de configurare complet poate fi vizualizat prin API-ul Kubernetes. Rețineți că ContainerRuntimeConfig este doar o versiune specializată a MachineConfig, așa că putem vedea rezultatul, examinând liniile necesare din MachineConfigs:
oc get MachineConfigs | grep rendered
Concluzie:
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16h
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16h
Observați că fișierul de configurare obținut pentru nodurile master este o versiune mai nouă decât configurațiile originale. Pentru a-l vizualiza, rulați următoarea comandă. De asemenea, subliniem că acesta ar putea fi unul dintre cele mai bune scripturi pe o singură linie din întreaga istorie Kubernetes:
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Concluzie:
pids_limit = 2048
Acum să ne asigurăm că configurația a fost aplicată tuturor nodurilor master. Mai întâi, să obținem lista nodurilor din cluster:
oc get node | grep master

Ieșire:

ip-10-0-135-153.us-east-2.compute.internal   Ready master 23h v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Ready master 23h v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Ready master 23h v1.12.4+509916ce1
Acum să examinăm fișierul instalat. Veți observa că fișierul a fost actualizat cu noile valori pentru directivele pid și debug pe care le-am specificat în resursa ContainerRuntimeConfig. Eleganța în sine:
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid’
Concluzie:
...
pids_limit = 2048
...
log_level = "debug"
...
Toate aceste modificări în cluster au fost efectuate chiar și fără a lansa SSH. Toată munca a fost realizată prin apelarea la nodul principal Kubernetes. Asta înseamnă că aceste noi parametrii au fost configurați doar pe nodurile principale. Nodurile de lucru, în acest caz, nu au fost schimbate, ceea ce demonstrează avantajele metodologiei Kubernetes folosind stări declarate și actualizate în ceea ce privește gazdele containerelor și motoarele de containere cu elemente interschimbabile.
Exemplul de mai sus arată capacitatea de a face modificări într-un cluster mic de OpenShift Container Platform 4 cu trei noduri de lucru sau într-un gigantic cluster de producție cu 3000 de noduri. În orice caz, volumul de muncă va fi același – și foarte mic – este suficient să configurați fișierul ContainerRuntimeConfig și să schimbați o etichetă (label) în MachineConfigPool. Și puteți face acest lucru cu orice versiune utilizată în Kubernetes platforma OpenShift Container Platform 4.X pe parcursul întregului său ciclu de viață.
Adesea, companiile tehnologice evoluează atât de repede încât nu putem explica de ce alegem anumite tehnologii pentru componentele de bază. Motoarele containerelor au fost istoric componenta cu care utilizatorii interacționează direct. Deoarece popularitatea containerelor a început logic odată cu apariția motoarelor de containere, utilizatorii manifestă adesea interes față de acestea. Aceasta este încă un motiv pentru care Red Hat a ales CRI-O. Containerele evoluează, iar astăzi concentrarea principală se află pe orchestrare, și am ajuns la concluzia că CRI-O oferă cea mai bună experiență atunci când lucrează cu OpenShift 4.
Sursa: habr.com
