

Să ne imaginăm. Într-o cameră sunt blocați 5 pisici, și pentru a merge să-și trezească stăpânul, trebuie să se înțeleagă între ele, deoarece usa poate fi deschisă doar dacă se apasă cinci pe ea. Dacă una dintre pisici este pisica lui Schrödinger, iar celelalte nu știu despre decizia lui, se pune întrebarea: „Cum pot ei face asta?”
În acest articol, voi explica pe înțelesul tuturor componenta teoretică a lumii sistemelor distribuite și principiile lor de funcționare. De asemenea, voi aborda superficial ideea principală din spatele Paxos.
Atunci când dezvoltatorii folosesc infrastructuri cloud, diverse baze de date și lucrează în clustere cu un număr mare de noduri, ei sunt încrezători că datele vor fi integrale, securizate și mereu disponibile. Dar de unde vin aceste garanții?
Practic, garanțiile pe care le avem sunt garanțiile furnizorului. Acestea sunt descrise în documentație cam așa: „Acest serviciu este destul de fiabil, are un SLA specificat, nu vă faceți griji, totul va funcționa distribuit, așa cum vă așteptați.”
Suntem predispuși să credem în bine, deoarece unii băieți deștepți din companii mari ne-au asigurat că totul va fi bine. Nu ne punem întrebarea: de ce, de fapt, ar putea funcționa asta? Există vreo justificare formală pentru corectitudinea funcționării acestor sisteme?
Recent am fost la și m-am simțit foarte inspirat de acest subiect. Lecțiile din școală semănau mai mult cu cursuri de analiză matematică decât cu ceva legat de sisteme informatice. Dar tocmai așa au fost demonstrate, la vremea respectivă, cele mai importante algoritmi pe care îi folosim în fiecare zi, fără să ne dăm seama.
În majoritatea sistemelor distribuite moderne se folosește algoritmul de consens Paxos și diversele sale modificări. Cea mai tare parte este că fundamentarea și posibilitatea existenței acestui algoritm pot fi dovedite simplu cu un pix și o foaie de hârtie. În același timp, în practică, algoritmul este aplicat în sisteme mari, care funcționează pe un număr enorm de noduri în cloud.
O ilustrație simplă a subiectului care va fi discutat în continuare: problema celor doi generali.Hai să analizăm pentru început .
Avem două armate – roșie și albă. Trupele albe sunt bazate în orașul asediat. Trupele roșii, conduse de generalii A1 și A2, se află de ambele părți ale orașului. Sarcina roșilor este să atace orașul alb și să învingă. Totuși, fiecare armată a fiecărui general roșu este mai mică decât armata albă.
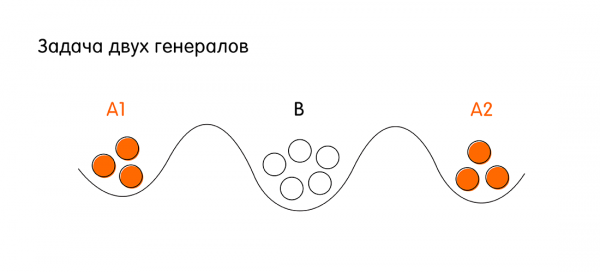
Condițiile de victorie pentru roșii: ambii generali trebuie să atace simultan pentru a avea un avantaj numeric asupra albilor. Pentru aceasta, generalii A1 și A2 trebuie să ajungă la un acord între ei. Dacă fiecare atacă separat, roșii vor pierde.
Pentru a ajunge la un consens, generalii A1 și A2 pot trimite mesageri unii altora prin teritoriul orașului alb. Mesagerul poate ajunge cu succes la generalul aliat sau poate fi interceptat de inamic. Întrebarea este: există o astfel de secvență de comunicație între generalii roșii (secvența de trimitere a mesagerilor de la A1 la A2 și invers de la A2 la A1), prin care se garantează că vor ajunge să se înțeleagă asupra atacului la ora X. Aici, prin garanții se înțelege că ambii generali vor avea o confirmare clară că aliatul (celălalt general) va ataca cu siguranță la timpul stabilit X.
Să presupunem că A1 trimite un mesager către A2 cu mesajul: „Să atacăm azi la miezul nopții!”. Generalul A1 nu poate ataca fără confirmarea generalului A2. Dacă mesagerul de la A1 a ajuns, atunci generalul A2 trimite o confirmare cu mesajul: „Da, hai să îi ducem pe albi”. Dar acum generalul A2 nu știe dacă mesagerul său a ajuns sau nu, nu are garanții că atacul va fi simultan. Acum, generalul A2 are nevoie din nou de o confirmare.
Dacă continuăm să detaliem comunicația lor, se va dovedi următoarele: indiferent câte cicluri de schimb de mesaje ar fi, nu există o modalitate de a informa cu certitudine amândoi generalii că mesajele lor au fost primite (cu condiția ca oricare dintre mesageri să fie interceptat).
Problema celor doi generali este o ilustrație excelentă a unui sistem distribuit foarte simplu, în care există două noduri cu comunicație nesigură. Asta înseamnă că nu avem o garanție de 100% că se vor sincroniza. Despre astfel de probleme, dar la o scară mai mare, vom discuta mai departe în articol.
Introducem conceptul de sisteme distribuite
Un sistem distribuit este un grup de computere (pe care le vom numi noduri) care pot schimba mesaje. Fiecare nod este o entitate autonomă. Un nod poate procesa sarcini în mod independent, dar pentru a interacționa cu alte noduri, trebuie să trimită și să primească mesaje.
Cum sunt implementate concret mesajele, ce protocoale sunt utilizate - nu ne interesează în acest context. Este important că nodurile sistemului distribuit pot face schimb de date între ele prin trimiterea de mesaje.
Definiția în sine nu pare foarte complicată, dar trebuie să luăm în considerare că un sistem distribuit are o serie de atribute care vor fi importante pentru noi.
Atributele sistemelor distribuite
- Concurența – capacitatea de a apari simultane sau evenimente concurente în sistem. Mai mult, vom considera că evenimentele survenite pe două noduri diferite sunt potențial concurente până când nu avem un ordine clar definită a apariției acestor evenimente. Și, de obicei, nu avem așa ceva.
- Lipsa ceasurilor globale. Nu avem un ordonare clară a evenimentelor din cauza lipsei ceasurilor globale. În lumea obișnuită a oamenilor, ne-am obișnuit cu faptul că avem ceasuri și un timp absolut. Totul se schimbă când vine vorba de sistemele distribuite. Chiar și ceasurile atomice extrem de precise au un drift și sunt posibile situații în care nu putem spune care dintre cele două evenimente a avut loc prima. Așadar, nu ne putem baza nici pe timp.
- Defecțiunea independentă a nodurilor sistemului. Mai există o problemă: ceva poate merge prost pur și simplu pentru că nodurile noastre nu sunt eterne. Poate că un disc dur se defectează, o mașină virtuală din cloud se repornește, rețeaua poate să clipească și mesajele să se piardă. Mai mult, pot exista situații în care nodurile funcționează, dar în același timp operează împotriva sistemului. Ultima clasă de probleme a primit chiar și un nume separat: problema . Cel mai popular exemplu de sistem distribuit cu o astfel de problemă este Blockchain. Dar astăzi nu vom examina această clasă specială de probleme. Ne vor interesa situațiile în care pur și simplu unul sau mai multe noduri pot cădea din funcțiune.
- Modele de comunicație (modele de schimb de mesaje) între noduri. Am stabilit că nodurile comunică prin schimb de mesaje. Există două modele cunoscute de schimb de mesaje: sincron și asincron.
Modele de comunicare între noduri în sisteme distribuite
Modelul sincron – știm cu siguranță că există o delta de timp finit cunoscut, în care mesajul ajunge garantat de la un nod la altul. Dacă acest timp a expirat și mesajul nu a sosit, putem spune cu certitudine că nodul a eșuat. În acest model, avem un timp de așteptare predictibil.
Modelul asincron – în modelele asincrone considerăm că timpul de așteptare este finit, dar nu există o delta de timp după care putem garanta că nodul a eșuat. Adică, timpul de așteptare pentru un mesaj de la un nod poate fi oricât de lung. Aceasta este o definiție importantă, de care vom discuta mai departe.
Conceptul de consens în sistemele distribuite
Înainte de a defini formal conceptul de consens, să luăm în considerare un exemplu de situație în care acesta este necesar, și anume – Replica mașinii de stare.
Avem un anumit jurnal distribuit. Ne-ar plăcea să fie consistent și să conțină date identice pe toate nodurile sistemului distribuit. Când unul dintre noduri află o nouă valoare pe care intenționează să o înregistreze în jurnal, sarcina sa devine să propună această valoare celorlalte noduri, astfel încât jurnalul să fie actualizat pe toate nodurile și sistemul să ajungă într-o nouă stare consistentă. Este important ca nodurile să ajungă la un acord: toate nodurile sunt de acord că noua valoare propusă este corectă, toate nodurile acceptă această valoare, și abia atunci pot toate să scrie în jurnal noua valoare.
Cu alte cuvinte: niciunul dintre noduri nu a contestat că ar avea informații mai actuale, iar valoarea propusă este greșită. Acordul între noduri și consensul asupra unei valori corecte acceptate este consensul într-un sistem distribuit. Mai departe, vom discuta despre algoritmii care permit sistemului distribuit să atingă consens în mod garantat.
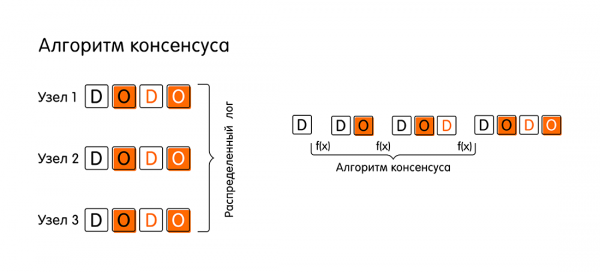
Mai formal, putem defini un algoritm de consens (sau pur și simplu algoritmul de consens) ca o funcție care transformă un sistem distribuit din starea A în starea B. Această stare este acceptată de toate nodurile, iar toate nodurile o pot confirma. Așa cum se dovește, această sarcină nu este deloc trivială, așa cum pare la prima vedere.
Proprietățile algoritmului de consens
Algoritmul de consens trebuie să aibă trei proprietăți pentru ca sistemul să continue să existe și să aibă progrese în tranziția dintr-o stare în alta:
- Acord – toate nodurile care funcționează corect trebuie să accepte aceeași valoare (în articole, această proprietate este de asemenea menționată ca proprietate de siguranță). Toate nodurile care funcționează acum (care nu au eșuat și nu au pierdut conexiunea cu celelalte) trebuie să ajungă la un acord și să accepte o anumită valoare comună finală.
Aici este important să înțelegem că nodurile din sistemul distribuit pe care îl discutăm doresc să ajungă la un acord. Adică, vorbim acum despre sisteme în care ceva poate eșua (de exemplu, un nod poate eșua), dar în acest sistem cu siguranță nu există noduri care lucrează intenționat împotriva altora (sarcina generalilor bizantini). Datorită acestei proprietăți, sistemul rămâne consistent.
- Integritate – dacă toate nodurile care funcționează corect propun aceeași valoare v, atunci fiecare nod care funcționează corect trebuie să accepte această valoare v.
- Terminare – toate nodurile care funcționează corect vor accepta în cele din urmă o anumită valoare (proprietate de activitate), ceea ce permite algoritmului să aibă progres în sistem. Fiecare nod corect funcționând trebuie, mai devreme sau mai târziu, să accepte valoarea finală și să confirme acest lucru: „Pentru mine, această valoare este adevărată, sunt de acord cu întregul sistem”.
Exemplu de funcționare a algoritmului de consens
Deși proprietățile algoritmului pot să nu fie complet clare, să ilustăm printr-un exemplu etapele prin care trece cel mai simplu algoritm de consens într-un sistem cu un model sincronic de schimb de mesaje, în care toate nodurile funcționează corect, mesajele nu se pierd și nimic nu se strică (chiar se întâmplă asta?).
- Totul începe cu o propunere de căsătorie (Propose). Să presupunem că un client s-a conectat la nodul numit „Nod 1” și a început o tranzacție, transmitând nodului o nouă valoare – O. De acum înainte, vom numi „Nod 1” proposer. Ca proposer, „Nod 1” trebuie acum să informeze întreaga sistemă că are date noi și trimite tuturor celorlalte noduri mesaje: „Uitați! Am primit valoarea „O” și vreau să o înregistrez! Vă rog să confirmați că și voi veți înregistra „O” în jurnalul vostru”.

- Următoarea etapă este votarea pentru valoarea propusă (Voting). De ce este necesară aceasta? Este posibil ca altor noduri să le fi sosit informații mai recente și acestea să aibă date referitoare la aceeași tranzacție.
Când nodul „Nod 1” își trimite propunerea, celelalte noduri verifică în jurnalele lor datele referitoare la acest eveniment. Dacă nu există contradicții, nodurile declară: „Da, nu am alte date referitoare la acest eveniment. Valoarea „O” este cea mai recentă informație pe care o avem”.În orice alt caz, nodurile pot răspunde „Nodului 1”: „Ascultă! Am date mai recente referitoare la această tranzacție. Nu „O”, ci ceva mai bun”.
În etapa de votare, nodurile ajung la o decizie: fie toți acceptă o singură valoare, fie unul dintre ele votează împotrivă, indicând că are date mai recente.
- Dacă runda de votare a avut loc cu succes, iar toți au fost „pentru”, sistemul trece la o nouă etapă – acceptarea valorii (Accept). „Nod 1” adună toate răspunsurile de la celelalte noduri și anunță: „Toți au fost de acord cu valoarea „O”! Acum declar oficial că „O” este noua noastră valoare, comună tuturor! Notați-vă în carnet, nu uitați. Înregistrați în jurnalul vostru!”
- Celelalte noduri trimit confirmarea (Accepted) că au înregistrat valoarea „O”, nimic nou neprimind în acest timp (o formă de two-phase commit). După acest eveniment semnificativ, considerăm că tranzacția distribuită s-a finalizat.
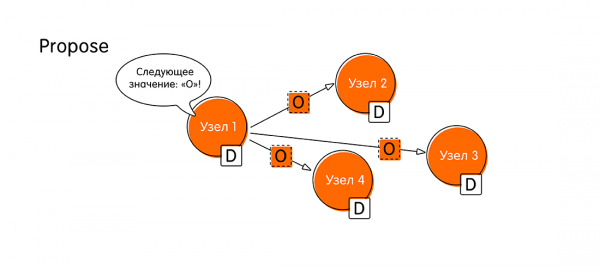
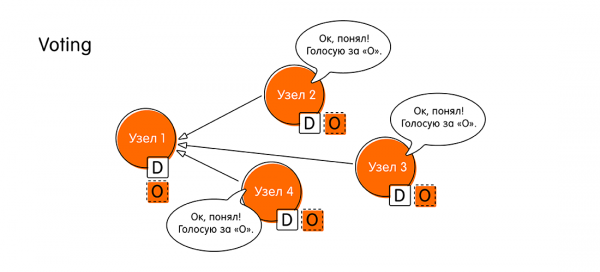
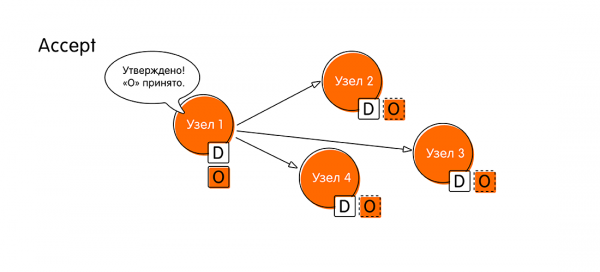
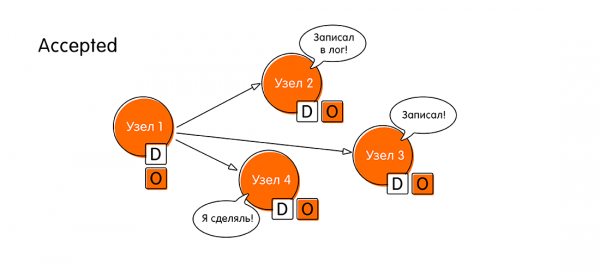
Astfel, algoritmul de consens în cazul simplu constă din patru pași: propunere, votare (voting), acceptare (accept), confirmarea acceptării (accepted).
Dacă la vreun pas nu am reușit să ajungem la un consens, algoritmul se repornește, având în vedere informațiile pe care le vor oferi nodurile care au refuzat să confirme valoarea propusă.
Algoritmul de consens într-un sistem asincron
Până acum, totul a fost bine, deoarece vorbeam despre un model sincron de schimb de mesaje. Dar știm că în lumea modernă ne-am obișnuit să facem totul asincron. Cum funcționează un algoritm similar într-un sistem cu un model asincron de schimb de mesaje, unde considerăm că timpul de așteptare pentru răspuns de la un nod poate fi, în teorie, nesfârșit (de altfel, eșecul unui nod poate fi văzut ca un exemplu în care un nod poate răspunde oricât de mult)?
Acum că știm, în principiu, cum funcționează algoritmul de consens, o întrebare pentru acei cititori curioși care au ajuns până aici: câte noduri dintr-un sistem cu N noduri, având un model de mesaje asincron, pot ieși din funcțiune astfel încât sistemul să poată atinge consensul în continuare?
Răspunsul corect și explicația se află sub spoiler.Răspunsul corect: 0. Dacă măcar un nod dintr-un sistem asincron iese din funcțiune, sistemul nu va putea atinge consensul. Această afirmație este demonstrată în teorema cunoscută în anumite cercuri FLP (1985, Fischer, Lynch, Paterson, link către sursa originală la finalul articolului): „Imposibilitatea de a atinge consens distribuțional în cazul eșecului măcar a unui nod”.
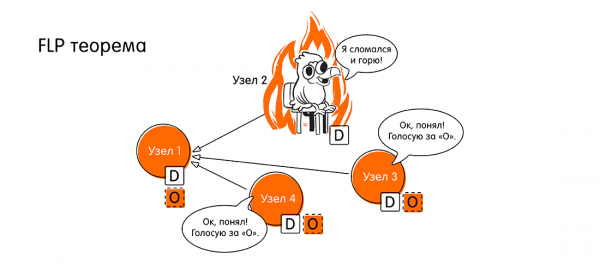
Băieți, atunci avem o problemă, ne-am obișnuit cu totul asincron. Și acum se întâmplă asta. Cum mai trebuie să continuăm?
Acum am discutat despre teorie, despre matematică. Ce înseamnă „consensul nu poate fi atins”, traducând din limbajul matematic în limbajul nostru – ingineresc? Aceasta înseamnă că „nu poate fi atins tot timpul”, adică există un caz în care consensul nu este realizabil. Dar care este acel caz?
Aceasta este o încălcare a proprietății de liveness, descrisă mai sus. Nu avem un consens comun, iar sistemul nu poate progresa (nu poate termina într-un timp finit) în cazul în care nu avem răspuns din partea tuturor nodurilor. Deoarece într-un sistem asincron nu avem un timp de răspuns previzibil, și nu putem ști dacă un nod a ieșit din funcțiune sau pur și simplu răspunde încet.
Dar în practică, putem găsi o soluție. Să presupunem că algoritmul nostru poate funcționa mult timp în cazuri de eșec (poate funcționa teoretic la nesfârșit). Dar în cele mai multe situații, când majoritatea nodurilor funcționează corect, vom avea progres în sistem.
În practică, ne ocupăm cu modele de comunicare parțial sincronizate. Parțiala sincronizare este înțeleasă astfel: în general, avem un model asincron, dar se introduce formal un anumit concept de «timp de stabilizare globală» a unui moment dat.
Acest moment poate să nu apară o perioadă nelimitată, dar, odată, el trebuie să se întâmple. Un ceas virtual va suna, iar de atunci putem prezice delta de timp în care mesajele vor ajunge. De atunci, sistemul devine din asincron în sincron. În practică, ne confruntăm exact cu astfel de sisteme.
Algoritmul Paxos rezolvă problemele de consens.
– este o familie de algoritmi care abordează problema consensului pentru sisteme parțial sincronizate, cu condiția că anumite noduri pot ieși din funcțiune. Autorul lui Paxos este . El a propus o dovadă formală a existenței și corectitudinii algoritmului în 1989.
Însă, dovada s-a dovedit a fi deloc trivială. Prima publicație a fost lansată abia în 1998 (33 de pagini) cu descrierea algoritmului. Așa cum s-a dovedit, aceasta a fost extrem de dificil de înțeles, iar în 2001 a fost publicată o explicație a articolului, care a ocupat 14 pagini. Volumele publicațiilor sunt menționate pentru a arăta că, de fapt, problema consensului nu este deloc simplă și că în spatele acestor algoritmi se află un efort imens al celor mai inteligenți oameni.
Este interesant că Leslie Lamport însuși a observat în cursul său că în al doilea articol explicativ există o afirmație, o linie (nu a specificat care), care poate fi interpretată diferit. Din această cauză, un număr mare de implementări moderne ale Paxos funcționează nu tocmai corect.
O analiză detaliată a funcționării lui Paxos ar necesita mai multe articole, așadar voi încerca să transmit foarte pe scurt ideea principală a algoritmului. La sfârșitul articolului meu veți găsi materiale pentru o aprofundare ulterioară în acest subiect.
Roluri în Paxos
În algoritmul Paxos există un concept de roluri. Să examinăm cele trei principale (există și modificări cu roluri adiționale):
- Propozitori (pot fi întâlniți de asemenea termeni: lideri sau coordonatori). Aceștia sunt oamenii care află despre un nou tip de valoare de la utilizator și își asumă rolul de lider. Sarcina lor este să inițieze un ciclu de propunere a noii valori și să coordoneze acțiunile ulterioare ale nodurilor. În plus, Paxos permite existența mai multor lideri în anumite situații.
- Acceptori (Votanti). Acestea sunt nodurile care votează pentru acceptarea sau respingerea unei anumite valori. Rolul lor este foarte important, deoarece decizia finală despre starea sistemului după fiecare etapă a algoritmului de consens depinde de ei.
- Învățăcei. Noduri care pur și simplu acceptă și înregistrează noua valoare acceptată, atunci când starea sistemului se schimbă. Aceștia nu iau decizii, ci doar primesc datele și le pot transmite utilizatorului final.
Un nod poate îndeplini mai multe roluri în funcție de situație.
Conceptul de cvórum
Presupunem că avem un sistem format din N noduri. Și din acestea, maximum F noduri pot să eșueze. Dacă F noduri eșuează, atunci în cluster trebuie să avem, minimum 2F + 1 noduri acceptoare.
Acest lucru este necesar pentru a ne asigura că, chiar și în cea mai gravă situație, nodurile „bune” care funcționează corect au o majoritate. Cu alte cuvinte, F + 1 noduri „bune” care au fost de acord, iar valoarea finală va fi acceptată. În caz contrar, ar putea apărea situații în care grupuri locale diferite acceptă valori diferite și nu pot ajunge la un consens. De aceea, avem nevoie de o majoritate absolută pentru a câștiga votul.
Ideea generală de funcționare a algoritmului de consens Paxos
Algoritmul Paxos preconizează două faze mari, care sunt împărțite fiecare în două pași:
- Faza 1a: Pregătire. În etapa de pregătire, liderul (proposer) comunică tuturor nodurilor: „Începem o nouă etapă de votare. Avem un nou tur. Numărul acestui tur este n. Acum vom începe votarea”. Deocamdată, el anunță doar începutul unui nou ciclu, fără a comunica o nouă valoare. Scopul acestei etape este de a iniția un nou tur și de a anunța tuturor numărul său unic. Numărul turului este important, trebuie să fie o valoare mai mare decât toate numerele voturilor anterioare ale tuturor liderilor anteriori. Datorită numărului turului, celelalte noduri din sistem vor înțelege cât de recente sunt datele liderului. Probabil că alte noduri au deja rezultatele votării din tururi mult mai recente și îi vor spune liderului că a rămas în urmă.
- Faza 1b: Promisiune. Când nodurile-acceptori au primit numărul noului tur de votare, pot exista două rezultate posibile:
- Numărul n al noului vot este mai mare decât numărul oricărui vot anterior în care a participat acceptorul. Atunci, acceptorul trimite liderului o promisiune că nu va mai participa la voturi cu un număr mai mic decât n. Dacă acceptorul a reușit să voteze pentru ceva (adică a acceptat deja o valoare în a doua fază), el anexează promisiunii sale valoarea acceptată și numărul votului în care a participat.
- În caz contrar, dacă acceptorul știe deja despre un vot cu un număr mai mare, el poate pur și simplu să ignore etapa de pregătire și să nu răspundă liderului.
- Faza 2a: Accept. Liderul trebuie să aștepte un răspuns de la cvorum (majoritatea nodurilor din sistem) și, dacă a primit numărul necesar de răspunsuri, are două variante de acțiune:
- Unii dintre acceptori au trimis valori pentru care au votat deja. În acest caz, liderul alege valoarea din votul cu numărul maxim. Să numim această valoare x, și trimite tuturor nodurilor un mesaj de tipul: „Accept (n, x)”, unde primul element este numărul votului din propria sa etapă Propose, iar al doilea element este valoarea pentru care s-au adunat, adică valoarea pentru care, de fapt, votăm.
- Dacă niciunul dintre acceptatori nu a trimis vreo valoare și pur și simplu au promis să voteze în acest rund, liderul poate să le propună să voteze pentru valoarea sa, adică valoarea pentru care a devenit lider. Să-i spunem y. El trimite tuturor nodurilor un mesaj de tip: „Accept (n, y)”, similar cu rezultatul anterior.
- Faza 2b: Acceptat. Așadar, nodurile-acceptatoare, la primirea mesajului „Accept(…)” de la lider, sunt de acord cu acesta (trimit tuturor nodurilor o confirmare că sunt de acord cu noua valoare) doar dacă nu au promis vreunui alt lider să participe la voturi în această rundă. n’ > n, altfel, ignoră cererea de confirmare.
Dacă liderul primește răspunsul majorității nodurilor, iar toate acestea confirmă noua valoare, atunci noua valoare este considerată acceptată. Ura! Dacă însă majoritatea nu este atinsă sau sunt noduri care au refuzat să accepte noua valoare, totul o ia de la capăt.
Iată cum funcționează algoritmul Paxos. Fiecare dintre aceste etape are multe subtilități, practic nu am discutat diferitele tipuri de eșec, problemele cu liderii multipli și multe altele, dar scopul acestui articol este doar de a introduce cititorul la un nivel general în lumea calculului distribuit.
De asemenea, merită menționat că Paxos nu este singurul de acest tip; există și alte algoritmi, de exemplu, , dar aceasta este deja o temă pentru un alt articol.
Linkuri pentru studiu suplimentar
Nivel „începător”:
- , Preethi Kasireddy, articol pe blog pe Medium
- , Adi Kancherla, articol pe blog pe Medium
- , Ittai Abraham, blog
- , Ittai Abraham, articol pe blog
Nivel „Leslie Lamport”:
- , Fischer, Lynch și Paterson, lucrare de cercetare, 1985
- , Leslie Lamport, lucrare de cercetare, 1998
- , Leslie Lamport, lucrare de cercetare, 2001
Sursa: habr.com
