

Din ce în ce mai des, clienții ne cer: „Vrem ceva ca Amazon RDS, dar mai ieftin”; „Vrem ceva ca RDS, dar peste tot, în orice infrastructură”. Pentru a realiza o astfel de soluție gestionată pe Kubernetes, am analizat starea actuală a celor mai populare operatori pentru PostgreSQL (Stolon, operatorii de la Crunchy Data și Zalando) și am făcut alegerea noastră.
Acest articol reflectă experiența noastră obținută atât din punct de vedere teoretic (revizuirea soluțiilor), cât și practic (ce am ales și ce rezultat a avut). Dar mai întâi, să stabilim ce cerințe sunt impuse unei posibile înlocuiri a RDS…
Ce este RDS
Când oamenii vorbesc despre RDS, din experiența noastră, ei se referă la un serviciu de baze de date gestionat (managed) care:
- se configurează ușor;
- oferă posibilitatea de a lucra cu snapshot-uri și de a se recupera din acestea (preferabil cu suport pentru );
- permite crearea de topologii master-slave;
- are o listă bogată de extensii;
- oferă audit și gestionarea utilizatorilor/accesului.
În general, abordările pentru realizarea acestei sarcini pot fi foarte diferite, însă calea cu un Ansible condiționat nu ne este apropiată. (La aceeași concluzie au ajuns și colegii de la 2GIS în urma de a crea „un instrument pentru desfășurarea rapidă a unui cluster rezistent bazat pe Postgres”.)
Exact operatorii sunt abordarea general acceptată pentru a rezolva astfel de sarcini în ecosistemul Kubernetes. Detalii despre aceștia în contextul bazelor de date rulate în Kubernetes au fost deja prezentate de tehnicul director „Flanta”, , pe .
NB: Pentru crearea rapidă a unor operatori simpli, recomandăm să acordați atenție utilitarului nostru Open Source . Folosind acesta, se poate face fără cunoștințe de Go, într-un mod mai familiar pentru administratori: pe Bash, Python etc.
Pentru PostgreSQL există câțiva operatori K8s populari:
- Stolon;
- Operatorul PostgreSQL de la Crunchy Data;
- Operatorul Postgres de la Zalando.
Să le examinăm mai atent.
Alegerea operatorului
Pe lângă acele funcționalități importante menționate mai sus, noi — ca ingineri de operațiuni în infrastructura Kubernetes — ne-am așteptat de asemenea de la operatori la următoarele:
- deplasare din Git și cu ;
- suport pentru anti-afinitate pod;
- instalarea afinității de nod sau selector de nod;
- instalarea tolerancelor;
- disponibilitatea opțiunilor de tuning;
- tehnologii și chiar comenzi clare.
Fără a intra în detalii pentru fiecare punct (întrebați în comentarii dacă mai aveți întrebări după citirea întregului articol), voi sublinia în general că acești parametri sunt necesari pentru o descriere mai precisă a specializării nodurilor clusterului, astfel încât să le putem comanda pentru aplicații specifice. Astfel, putem obține un echilibru optim între performanță și cost.
Acum, să ne îndreptăm atenția asupra operatorilor PostgreSQL.
1. Stolon
de la compania italiană Sorint.lab în a fost considerat un etalon printre operatorii pentru SGBD. Este un proiect destul de vechi: prima sa lansare publică a avut loc în noiembrie 2015(!), iar repository-ul GitHub se poate lăuda cu aproape 3000 de stele și 40+ de colaboratori.
Și într-adevăr, Stolon este un exemplu excelent de arhitectură bine gândită:
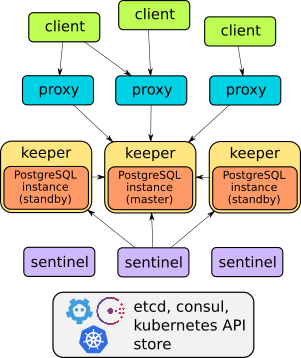
Detaliile despre acest operator pot fi găsite în raport sau . În general, este suficient să spunem că acesta poate face tot ce a fost descris: failover, proxy pentru acces transparent al clienților, backup-uri... Și, în plus, proxy-urile oferă acces printr-un singur endpoint de serviciu — spre deosebire de celelalte două soluții discutate mai departe (care au câte două servicii pentru accesul la bază de date).
Cu toate acestea, Stolon , motiv pentru care nu poate fi implementat astfel încât să creeze rapid și ușor — „ca niște plăcinte calde” — instanțe de SGBD în Kubernetes. Managementul se face prin utilitarul stolonctl, implementarea — prin chart Helm, iar definițiile utilizatorilor sunt specificate în ConfigMap.
Pe de o parte, se pare că operatorul nu este chiar un operator (deoarece nu utilizează CRD). Dar pe de altă parte, este un sistem flexibil care permite configurarea resurselor în K8s așa cum vă convine.
În concluzie, personal nu ni s-a părut optim să avem un chart separat pentru fiecare SGBD. De aceea, am început să căutăm alternative.
2. Crunchy Data PostgreSQL Operator
, o tânără startup americană, părea o alternativă logică. Povestea sa publică începe cu prima lansare din martie 2017, de atunci repository-ul GitHub a obținut puțin mai puțin de 1300 de stele și 50+ de colaboratori. Ultima lansare din septembrie a fost testată pentru a funcționa cu Kubernetes 1.15—1.18, OpenShift 3.11+ și 4.4+, GKE și VMware Enterprise PKS 1.3+.
Arhitectura Crunchy Data PostgreSQL Operator corespunde, de asemenea, cerințelor enunțate:
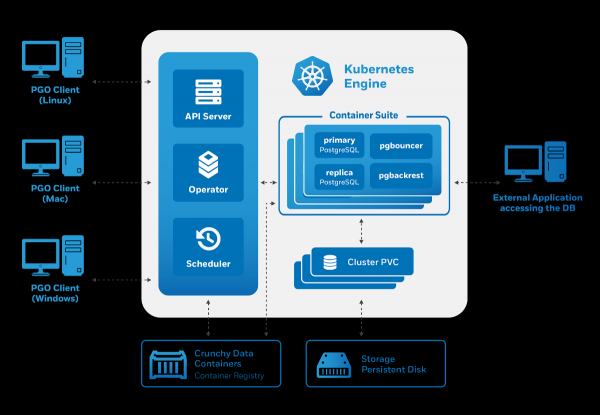
Managementul se face prin utilitarul pgo, însă acesta generează resurse personalizate pentru Kubernetes. Astfel, ne-a bucurat ca potențiali utilizatori operatorul,
- există gestionare prin CRD;
- gestionare convenabilă a utilizatorilor (tot prin CRD);
- integrare cu alte componente — o colecție specializată de imagini de containere pentru PostgreSQL și utilitare pentru lucrul cu aceasta (inclusiv pgBackRest, pgAudit, extensii din contrib etc.).
Cu toate acestea, încercările de a începe utilizarea operatorului de la Crunchy Data au scos la iveală câteva probleme:
- Nu a existat opțiunea de tolerații — a fost prevăzut doar nodeSelector.
- Pod-urile create au fost parte a Deployment-ului, deși am desfășurat o aplicație stateful. Spre deosebire de StatefulSet, Deployment-urile nu pot crea discuri.
Ultima deficiență duce la momente amuzante: în mediu de testare, am reușit să lansăm 3 replici cu un singur disc stocare locală, rezultat în care operatorul raporta că 3 replici funcționează (deși nu era așa).
O altă caracteristică a acestui operator este integrarea sa gata făcută cu diferite sisteme auxiliare. De exemplu, este ușor de instalat pgAdmin și pgBounce, iar se iau în considerare Grafana și Prometheus pre-configurate. În recentul se remarcă integrarea îmbunătățită cu proiectul , ceea ce permite operatorului să ofere o vizualizare clară a metricelor PgSQL „din cutie”.
Cu toate acestea, alegerea ciudată a resurselor Kubernetes generate ne-a determinat să căutăm o altă soluție.
3. Zalando Postgres Operator
Produsele Zalando ne sunt cunoscute de mult: avem experiență cu Zalenium și, desigur, am încercat — soluția lor populară HA pentru PostgreSQL. Despre abordarea companiei în crearea a povestit unul dintre autorii săi — Alexey Klyukin — în emisiunea , și ne-a plăcut.
Aceasta este cea mai tânără soluție dintre cele discutate în articol: primul release a avut loc în august 2018. Cu toate acestea, chiar și în ciuda numărului mic de release-uri formale, proiectul a parcurs un drum lung, depășind deja soluția de la Crunchy Data cu peste 1300 de stele pe GitHub și cel mai mare număr de contribuabili (peste 70).
„Sub capotă”, acest operator utilizează soluții verificate în timp:
- Patroni și pentru gestionare,
- — pentru backup-uri,
- — ca pool de conexiuni.
Iată cum este prezentată arhitectura operatorului de la Zalando:
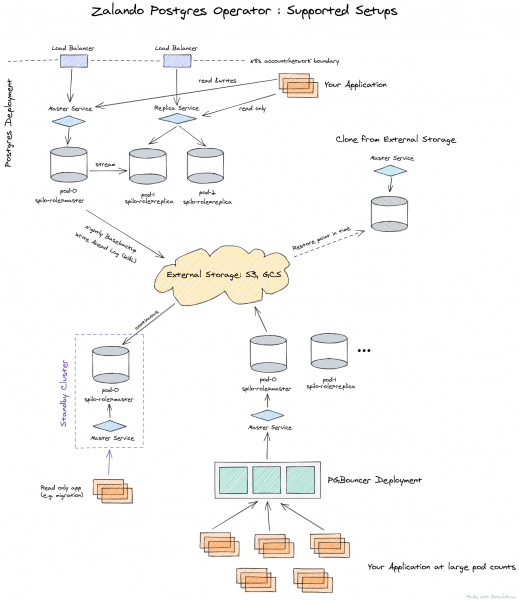
Operatorul este complet gestionat prin Custom Resources, creând automat un StatefulSet din containere, care pot fi apoi personalizate, adăugând în pod diferite sidecar-uri. Toate acestea reprezintă un avantaj semnificativ în comparație cu operatorul de la Crunchy Data.
Deoarece soluția oferită de Zalando a fost aleasă dintre cele 3 variante analizate, descrierea ulterioară a funcționalităților sale va fi prezentată mai jos, împreună cu practica aplicării acesteia.
Practica cu Postgres Operator de la Zalando
Implementarea operatorului se face foarte simplu: este suficient să descărcați cea mai recentă versiune de pe GitHub și să aplicați fișierele YAML din directorul corespunzător. Ca o opțiune, se poate utiliza de asemenea .
După instalare, trebuie să vă ocupați de configurarea . Aceasta se realizează prin ConfigMap postgres-operator în spațiul de nume unde a fost instalat operatorul. Odată ce stocurile sunt configurate, puteți lansa primul cluster PostgreSQL.
De exemplu, implementarea standard arată astfel:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Acest manifest implementează un cluster din 3 instanțe cu sidecar sub forma , de unde colectăm metrici pentru aplicație. După cum observați, totul este foarte simplu și, dacă doriți, puteți crea literal un număr nelimitat de clustere.
Merită să acordați atenție și panoului web pentru administrare — . Acesta vine împreună cu operatorul și permite crearea și ștergerea clusterelor, precum și gestionarea backup-urilor efectuate de operator.
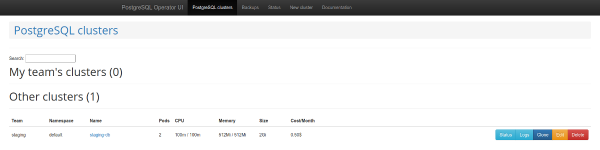
Lista clusterelor PostgreSQL
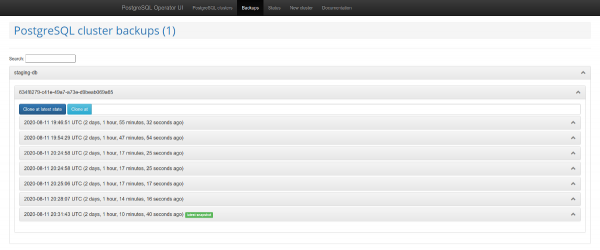
Gestionarea backup-urilor
O altă caracteristică interesantă este suportul pentru . Acest mecanism creează automat roluri în PostgreSQL, pe baza listei de nume de utilizatori primite. După aceea, API-ul permite returnarea listei de utilizatori pentru care rolurile sunt create automat.
Probleme și soluții
Cu toate acestea, utilizarea operatorului a scos la iveală rapid câteva dezavantaje semnificative:
- lipsa suportului pentru nodeSelector;
- imposibilitatea de a dezactiva backup-urile;
- folosind funcția de creare a bazelor, nu apar privilegii implicite;
- periodic, documentația este insuficientă sau nu este actualizată.
Din fericire, multe dintre acestea pot fi rezolvate. Să începem cu sfârșitul — problemele cu documentația.
Cel mai probabil, vă veți confrunta cu neclaritatea în ceea ce privește modul de a defini backup-ul și cum să conectați bucket-ul de backup la Operator UI. Despre aceasta, documentația menționează în treacăt, iar descrierea reală se găsește în :
- trebuie să creați un secret;
- să-l transmiteți operatorului în parametru
pod_environment_secret_nameîn CRD cu configurațiile operatorului sau în ConfigMap (depinde de modul în care ați decis să instalați operatorul).
Cu toate acestea, s-a dovedit că în prezent acest lucru este imposibil. De aceea am adunat cu anumite dezvoltări suplimentare externe. Detalii despre aceasta — vezi mai jos.
Dacă transmiteți operatorului parametrii pentru backup, și anume — wal_s3_bucket și cheile de acces în AWS S3, atunci el va face backup la tot: nu doar la bazele din producție, ci și la cele de stagiu. Acest lucru nu ne-a convenit.
În descrierea parametrilor pentru Spilo, care este wrapper-ul Docker de bază pentru PgSQL atunci când se folosește operatorul, s-a descoperit că se poate transmite parametrul WAL_S3_BUCKET gol, astfel dezactivând backup-urile. Mai mult, spre marele nostru avantaje a fost găsit un , pe care l-am acceptat imediat în fork-ul nostru. Acum este suficient să adăugați enableWALArchiving: false în resursa clusterului PostgreSQL.
Da, a existat posibilitatea de a face altfel, pornind 2 operatori: unul pentru stagiu (fără backup-uri) și celălalt — pentru producție. Dar am reușit să ne descurcăm cu unul singur.
Bine, am învățat să oferim bazelor acces pentru S3 și backup-urile au început să ajungă în stocare. Cum să facem să funcționeze paginile backup-urilor în Operator UI?
În Operator UI va trebui să adăugați 3 variabile:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
După aceasta, gestionarea backup-urilor va deveni disponibilă, ceea ce în cazul nostru va simplifica munca cu stagiu, permițând livrarea instantaneelor din producție fără scripturi suplimentare.
Ca un alt avantaj, s-a menționat colaborarea cu Teams API și posibilitățile extinse pentru a crea baze și roluri prin intermediul operatorului. Totuși, rolurile create nu aveau privilegii implicite. Prin urmare, utilizatorul cu drepturi de citire nu putea citi noile tabele.
De ce așa? Cu toate că în codul necesar GRANT, acestea nu sunt aplicate întotdeauna. Există 2 metode: syncPreparedDatabases și syncDatabases. În syncPreparedDatabases — cu toate că în secțiunea preparedDatabases există o condiție defaultRoles și defaultUsers pentru crearea rolurilor, — permisiunile implicite nu se aplică. Suntem în proces de pregătire a unui patch, astfel încât aceste permisiuni să fie aplicate automat.
Și ultimul aspect în actualizările relevante pentru noi — , adăugând Node Affinity în StatefulSet-ul creat. Clienții noștri preferă adesea să economisească costurile folosind instanțe spot, iar pe acestea nu ar trebui să se plaseze servicii de baze de date. Această problemă ar putea fi rezolvată și prin tolerații, dar prezența Node Affinity oferă o mai mare siguranță.
Ce a ieșit?
Ca urmare a soluționării problemelor enumerate, am fork-uit Postgres Operator de la Zalando în , unde acesta este construit cu patch-uri atât de utile. Iar pentru un plus de confort, am strâns și .
Lista PR-urilor acceptate în fork:
- ;
- ;
- ;
- .
Ar fi grozav dacă comunitatea ar susține aceste PR-uri, astfel încât să ajungă în upstream cu următoarea versiune a operatorului (1.6).
Bonus! Poveste de succes cu migrarea production
Dacă utilizați Patroni, este posibil să migrați production live pe operator cu un timp minim de nefuncționare.
Spilo permite crearea de clustere standby prin stocări S3 cu , când log-ul binar PgSQL este mai întâi salvat în S3, iar apoi este descărcat de replica. Dar ce să faceți dacă nu folosiți Wal-E în infrastructura veche? Soluția la această problemă a fost deja pe Habr.
Ajutorul vine de la replicarea logică PostgreSQL. Totuși, nu ne vom adânci în detalii despre cum să creăm publicații și înscrieri, deoarece… planul nostru a eșuat.
Problema este că în baza de date existau mai multe tabele încărcate cu milioane de rânduri, care, în plus, erau continuu populate și șterse. de copy_data, când o nouă replică copiază tot conținutul de pe master, pur și simplu nu reușea să țină pasul cu master-ul. Copierea conținutului a funcționat o săptămână, dar nu a ajuns niciodată la master. În cele din urmă, am reușit să rezolvăm problema cu ajutorul colegilor de la Avito: putem muta datele folosind pg_dump. Voi descrie varianta noastră (ușor îmbunătățită) a acestui algoritm.
Ideea este că se poate face o subscripție oprită, legată de un anumit slot de replicare, și apoi se poate corecta numărul de tranzacție. Exista replici disponibile pentru a lucra cu producția. Acest lucru este important deoarece replica va ajuta la crearea unui dump consistent și va continua să primească modificări din master.
În comenzile ulterioare care descriu procesul de migrare, vor fi folosite următoarele denumiri pentru gazde:
- master — serverul sursă;
- replica1 — replica streaming pe vechea producție;
- replica2 — noua replică logică.
Planul de migrație
1. Vom crea pe master o subscripție pentru toate tabelele din schema public bazei dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Vom crea un slot de replicare pe master:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Vom opri replicarea pe vechea replică:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Vom obține numărul de tranzacție de la master:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Vom face un dump de pe vechea replică. Vom face acest lucru în mai multe fire, ceea ce va ajuta la accelerarea procesului:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Vom încărca dump-ul pe noul server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. După încărcarea dump-ului, putem începe replicarea pe replica streaming:
psql -h replica1 -c "select pg_wal_replay_resume();"
8. Vom crea o subscripție pe noua replică logică:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
9. Vom obține oid subscripției:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
10. Să presupunem că am obținut oid=1000. Vom aplica numărul de tranzacție la subscripție:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
11. Vom porni replicarea:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
12. Vom verifica statutul subscripției, replicarea ar trebui să funcționeze:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
13. După ce replicarea este pornită și bazele sunt sincronizate, se poate face switch.
14. După oprirea replicării, trebuie corectate secvențele. Acest lucru este bine descris .
Datorită acestui plan, switch-ul s-a realizat cu întârzieri minime.
Concluzie
Operatorii Kubernetes simplifică diverse acțiuni, reducându-le la creare de resurse K8s. Totuși, după ce ați realizat o automatizare remarcabilă cu ajutorul lor, este important să rețineți că aceasta poate aduce și o serie de nuanțe neașteptate, așa că abordați alegerea operatorilor cu înțelepciune.
După ce am analizat trei dintre cei mai populari operatori Kubernetes pentru PostgreSQL, ne-am decis în favoarea proiectului de la Zalando. Am întâmpinat anumite dificultăți în acest proces, dar rezultatul ne-a bucurat realmente, așa că plănuim să extindem această experiență și la alte instalări PgSQL. Dacă aveți experiență cu soluții similare, ne-ar face plăcere să vedem detalii în comentarii!
P.S.
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
