

Bună ziua din nou! Titlul articolului vorbește de la sine. În preajma începerii cursului, vă propunem să analizăm cine sunt inginerii de date. Articolul conține multe linkuri utile. Lectură plăcută.
Un ghid simplu despre cum să prindeți valul Data Engineering și să nu lăsați să vă tragă în abis.
Se pare că, în zilele noastre, toată lumea vrea să devină data scientist. Dar ce ziceți de Data Engineering? În esență, este o combinație între analistul de date și data scientist; inginerul de date este, de obicei, responsabil pentru gestionarea fluxurilor de lucru, a conductelor de procesare și a proceselor ETL.Având în vedere importanța acestor funcții, în prezent este un jargon profesional popular care câștigă din ce în ce mai multă amploare.
Salariul ridicat și cererea uriașă sunt doar o mică parte din ceea ce face această muncă extrem de atrăgătoare! Dacă doriți să vă alăturați rândurilor eroilor, niciodată nu este prea târziu să începeți să învățați. În această postare am adunat toate informațiile necesare pentru a vă ajuta să faceți primii pași.
Așadar, să începem!
Ce este Data Engineering?
Sincer, nu există o explicație mai bună decât aceasta:
«Un savant poate descoperi o nouă stea, dar nu o poate crea. Va trebui să ceară inginerului să facă asta pentru el.»
–Gordon Lindsay Glegg
Astfel, rolul inginerului de date este destul de important.
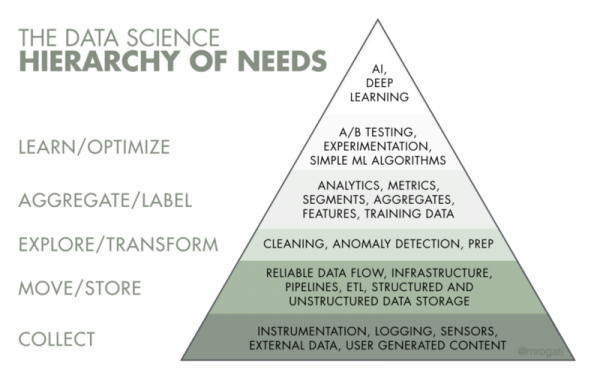
După cum reiese din denumire, ingineria datelor se ocupă de date, și anume de livrarea, stocarea și procesarea acestora. Prin urmare, principala sarcină a inginerilor este de a asigura o infrastructură de date fiabilă. Dacă ne uităm la ierarhia nevoilor în AI, ingineria datelor se situează în primele 2-3 etape: colectarea, mutarea și stocarea, pregătirea datelor.
Cu ce se ocupă inginerul de date?
Odată cu apariția big data, domeniul de responsabilitate s-a schimbat drastic. Dacă anterior acești experți scriau interogări SQL complexe și transferau date utilizând instrumente precum Informatica ETL, Pentaho ETL, Talend, acum cerințele pentru inginerii de date au crescut.
Cele mai multe companii care au posturi disponibile pentru inginer de date pun următoarele cerințe:
- Cunoștințe excelente de SQL și Python.
- Experiență cu platforme cloud, în special Amazon Web Services.
- Cunoștințe preferate de Java/Scala.
- O bună înțelegere a bazelor de date SQL și NoSQL (modelare de date, stocare a datelor).
Rețineți că aceasta este doar cea mai esențială informație. Din această listă, se poate deduce că inginerii de date sunt specialiști în dezvoltarea software-ului și în backend.
De exemplu, dacă o companie începe să genereze un volum mare de date din diverse surse, sarcina ta ca inginer de date este să organizezi colectarea informațiilor, procesarea și stocarea acestora.
Lista instrumentelor utilizate în acest caz poate varia, totul depinde de volumul acestor date, de viteza de sosire și de omogenitate. Majoritatea companiilor nu se confruntă cu big data, așa că pentru un depozit centralizat, așa-numitul depozit de date, se poate folosi o bază de date SQL (PostgreSQL, MySQL etc.) cu un set mic de scripturi care direcționează datele către depozit.
Gigantii IT, precum Google, Amazon, Facebook sau Dropbox, impun cerințe mai ridicate: cunoștințe de Python, Java sau Scala.
- Experiență în lucrul cu big data: Hadoop, Spark, Kafka.
- Cunoștințe de algoritmi și structuri de date.
- Înțelegerea principiilor sistemelor distribuite.
- Experiența cu instrumente de vizualizare a datelor, cum ar fi Tableau sau ElasticSearch, este un mare plus.
Cu alte cuvinte, există o tendință clară către big data, și anume spre procesarea acestora în condiții de încărcare mare. Aceste companii au cerințe crescute privind disponibilitatea sistemului.
Ingineri de date vs. oameni de știință ai datelor
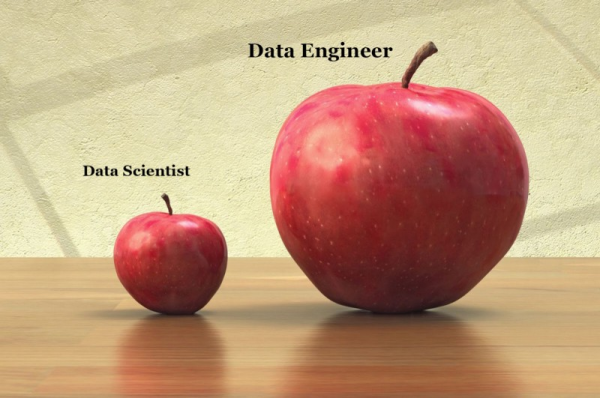
Bine, a fost o comparație simplă și amuzantă (nimic personal), dar de fapt lucrurile sunt mult mai complicate.
În primul rând, trebuie să știi că există destul de multă ambiguitate în delimitarea rolurilor și abilităților dintre omul de știință al datelor și inginerul de date. Asta înseamnă că te poți simți confuz cu privire la abilitățile necesare pentru a fi un inginer de date de succes. Desigur, există anumiți abilități care se suprapun între cele două roluri. Dar există și o serie întreagă de abilități complet opuse.
Știința datelor este o afacere serioasă, dar ne îndreptăm spre o lume cu știința datelor funcționale, unde practicanții pot realiza propria lor analiză. Pentru a activa conductele de date și structurile integrate de date, ai nevoie de ingineri de date, nu de oameni de știință.
Este inginerul de date mai căutat decât omul de știință al datelor?
— Da, pentru că înainte să poți pregăti o prăjitură cu morcovi, trebuie mai întâi să aduni, să cureți și să ai morcovi!
Un inginer de date se înțelege în programare mai bine decât orice datascientist, dar când vine vorba de statistică, totul este invers.
Dar iată avantajul inginerului de date:
fără el/ea, valoarea modelului-prototip, care cel mai adesea constă dintr-un fragment de cod de calitate îndoielnică într-un fișier Python, obținut de la un datascientist și care somehow dă un rezultat, tinde spre zero.
Fără inginerul de date, acest cod nu va deveni niciodată un proiect, iar nicio problemă de afaceri nu va fi rezolvată eficient. Inginerul de date încearcă să transforme totul într-un produs.
Informațiile de bază pe care trebuie să le cunoască un inginer de date
Așadar, dacă acest loc de muncă îți trezește pasiunea și ești plin de entuziasm — ești capabil să înveți, poți să stăpânești toate abilitățile necesare și să devii cu adevărat o stea rock în domeniul dezvoltării datelor. Și, da, poți realiza asta chiar și fără abilități de programare sau alte cunoștințe tehnice. E greu, dar posibil!
Care sunt primii pași?
Trebuie să ai o idee generală despre ce este ce.
În primul rând, ingineria datelor se referă la informatică. Concret — trebuie să înțelegi algoritmi și structuri de date eficiente. În al doilea rând, deoarece inginerii de date lucrează cu date, este necesar să înțelegem principiile de funcționare ale bazelor de date și structurile care stau la baza acestora.
De exemplu, bazele de date SQL obișnuite B-tree se bazează pe structura de date B-Tree, iar în repositoare moderne distribuite, LSM-Tree și alte variante ale tabelelor hash.
* Acești pași se bazează pe un articol remarcabil . Așadar, dacă știi limba rusă, susține acest autor și citește .
1. Algoritmi și structuri de date
Folosirea structurii de date corecte poate îmbunătăți semnificativ performanța algoritmului. Ideal, ar trebui să studiem structuri de date și algoritmi în școlile noastre, dar rar se abordează. Oricum, a te familiariza nu este niciodată prea târziu.
Așadar, iată cursurile mele gratuite preferate pentru a învăța structuri de date și algoritmi:
În plus, nu uitați de lucrarea clasică asupra algoritmilor lui Thomas Cormen — . Este ghidul perfect atunci când trebuie să-ți reîmprospătezi memoria.
- Pentru a-ți îmbunătăți abilitățile, folosește .
De asemenea, te poți adânci în lumea bazelor de date prin intermediul unor videoclipuri uimitoare de la Universitatea Carnegie Mellon pe Youtube:
- .
- .
2. Învață SQL
Toată viața noastră constă în date. Și pentru a extrage aceste date dintr-o bază de date, trebuie să 'vorbești' cu ele într-o limbă comună.
SQL (Structured Query Language – Limbajul de interogare structurată) este limbajul de comunicare în domeniul datelor. Indiferent de ce spune cineva, SQL a trăit, trăiește și va trăi încă mult timp.
Dacă ai fost mult timp în dezvoltare, probabil că ai observat că zvonurile despre sfârșitul iminent al SQL apar periodic. Limbajul a fost dezvoltat la începutul anilor '70 și încă se bucură de o popularitate imensă în rândul analiștilor, dezvoltatorilor și pur și simplu entuziaștilor.
Fără cunoștințe de SQL, în ingineria datelor nu ai nimic de făcut, deoarece inevitabil va trebui să creezi interogări pentru extragerea datelor. Toate stocările moderne de date mari suportă SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… și multe altele.
Pentru a analiza un strat mare de date stocat în sisteme distribuite, cum ar fi HDFS, au fost inventate mecanisme SQL: Apache Hive, Impala etc. Vezi, nu se va duce nicăieri.
Cum să înveți SQL? Pur și simplu fă-o practic.
Pentru asta, ți-aș recomanda să consulti un excelent tutorial, care, de altfel, este gratuit, de la .
O caracteristică distinctivă a acestor cursuri este existența unui mediu interactiv în care poți scrie și executa interogări SQL direct în browser. Resursa nu ar fi de prisos. Și poți aplica aceste cunoștințe în în secțiunea Baze de date.
3. Programare în Python și Java/Scala
De ce ar trebui să înveți limbajul de programare Python, am discutat deja în articolul . Cât despre Java și Scala, majoritatea instrumentelor pentru stocarea și procesarea unor volume mari de date sunt scrise în aceste limbi. De exemplu:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Pentru a înțelege cum funcționează aceste instrumente, trebuie să știți limbile în care sunt scrise. Abordarea funcțională Scala permite rezolvarea eficientă a problemelor de procesare paralelă a datelor. Python, din păcate, nu se poate lăuda cu viteza și procesarea paralelă. În general, cunoașterea mai multor limbaje și paradigme de programare influențează pozitiv diversitatea abordărilor pentru soluționarea problemelor.
Pentru a vă familiariza cu limbajul Scala, puteți citi de la creatorul limbajului. De asemenea, compania Twitter a publicat un ghid introductiv bun — .
În ceea ce privește Python, consider că este cea mai bună carte de nivel mediu.
4. Instrumente pentru lucrul cu big data
Iată o listă cu cele mai populare instrumente din lumea big data:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Mai multe informații despre construirea blocurilor mari de date le puteți găsi în acest minunat . Cele mai populare instrumente sunt Spark și Kafka. Merită cu siguranță să le studiați, ideal ar fi să înțelegeți cum funcționează din interior. Jay Kreps (co-autor al Kafka) a publicat în 2013 o lucrare monumentală , de altfel, ideile principale din acest talmud au fost folosite pentru a crea Apache Kafka.
- O introducere în Hadoop poate fi .
- Cel mai complet ghid pentru Apache Spark pentru mine este — .
5. Platforme cloud
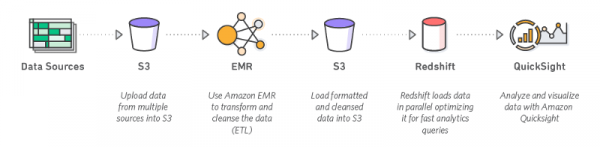
Cunoașterea măcar unei platforme cloud se află pe lista cerințelor de bază pentru candidații pentru postul de inginer de date. Angajatorii preferă Amazon Web Services, pe locul doi se află platforma cloud Google, iar pe locul trei Microsoft Azure.
Trebuie să fiți bine familiarizați cu Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Sisteme distribuite
Lucrul cu big data presupune existența de clustere de computere care funcționează independent, legătura între care se realizează prin intermediul rețelei. Cu cât este mai mare clusterul, cu atât crește probabilitatea eșecului nodurilor membroase. Pentru a deveni un expert de top în domeniul datelor, trebuie să aprofundați problemele și soluțiile existente pentru sistemele distribuite. Acest domeniu este vechi și complex.
Andrew Tanenbaum este considerat un pionier în acest domeniu. Pentru cei care nu se tem de teorie, recomand cartea sa , pentru începători, poate părea complicată, dar cu adevărat vă va ajuta să vă perfecționați abilitățile.
Consider că este cea mai bună carte introductivă. Apropo, Martin are un curs minunat . Lucrarea sa vă va ajuta să sistematizați cunoștințele despre construcția infrastructurii moderne pentru stocarea și procesarea datelor mari.
Pentru cei care iubesc să se uite la videoclipuri, pe Youtube există un curs .
7. Conducte de Date
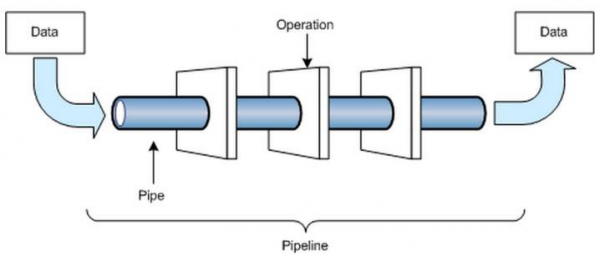
Conductele de date sunt esențiale pentru a putea trăi ca inginer de date.
Cea mai mare parte a timpului, inginerul de date construiește așa-numita pipeliner de date, adică creează un proces de livrare a datelor dintr-un loc în altul. Acestea pot fi scenarii utilizator care merg la API-ul unui serviciu extern sau efectuează cereri SQL, completează datele și le plasează într-un depozit centralizat (depozit de date) sau într-un depozit de date neîntreprinse (lacul de date).
În concluzie: lista de verificare principală a inginerului de date
Să rezumăm — este necesară o bună înțelegere a următoarelor:
- Sisteme informaționale;
- Dezvoltarea software-ului (Agile, DevOps, Tehnici de Design, SOA);
- Sisteme distribuite și programare paralelă;
- Noțiuni de bază despre baze de date — planificare, proiectare, operare și depanare;
- Proiectarea experimentelor — A/B teste pentru validarea conceptelor, determinarea fiabilității, performanței sistemelor, precum și elaborarea unor rute fiabile pentru furnizarea rapidă a soluțiilor bune.
Acestea sunt doar câteva cerințe pentru a deveni inginer de date, așa că studiați și familiarizați-vă cu sistemele de date, sistemele informaționale, livrarea continuă/implementarea/integrarea, limbajele de programare și alte subiecte de informatică (nu în toate disciplinele).
Și, în cele din urmă, ultimul, dar foarte important lucru pe care vreau să-l spun.
Calea devenirei în Data Engineering nu este atât de simplă pe cât pare. Nu iartă, frustrează, și trebuie să fii pregătit pentru asta. Unele momente din această călătorie te pot face să vrei să renunți la tot. Dar este un adevărat efort și un proces de învățare.
Pur și simplu nu exagera de la început. Tot sensul călătoriei este să înveți cât mai mult și să fii pregătit pentru noi provocări.
Iată o imagine excelentă cu care m-am întâlnit, care ilustrează bine acest moment:
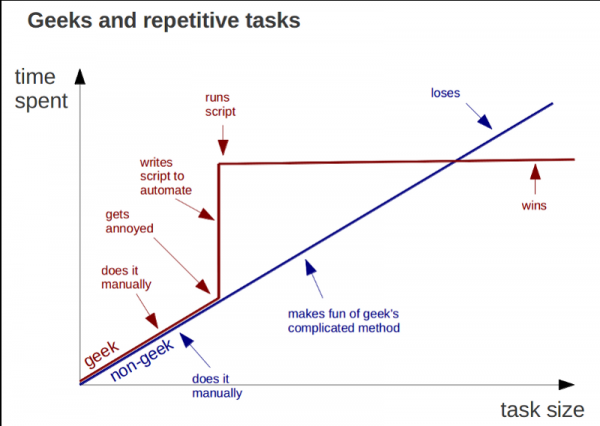
Și da, nu uita să eviți epuizarea și să te odihnești. Acest lucru este foarte important. Mult succes!
Ce părere aveți despre articol, prieteni? Vă invităm la , care va avea loc astăzi la 20.00. În cadrul webinarului vom discuta despre cum să construim un sistem de procesare a datelor eficient și scalabil pentru o mică companie sau un startup, cu costuri minime. Ca practică, ne vom familiariza cu instrumentele de procesare a datelor Google Cloud. Ne vedem curând!
Sursa: habr.com
