

Nota traducătorului.: Acest articol, scris de Galo Navarro, care ocupă funcția de Principal Software Engineer la compania europeană Adevinta, este o „investigație” captivantă și instructivă în domeniul exploatării infrastructurii. Titlul său original a fost puțin modificat în traducere dintr-un motiv pe care autorul îl explică la început.
Nota autorului: Se pare că această publicație mult mai multă atenție decât se aștepta. Încă primesc comentarii furioase despre cum titlul articolului duce la confuzie și despre faptul că unii cititori sunt întristați. Înțeleg motivele pentru care se întâmplă asta, așa că, în ciuda riscului de a distruge întreaga intrigă, vreau să vă spun imediat despre ce este vorba în acest articol. Observ o chestiune curioasă atunci când echipele trec pe Kubernetes: de fiecare dată când apare o problemă (de exemplu, creșterea latenței după migrare), primul lucru pe care îl blamează este Kubernetes, dar apoi se dovedește că orchestratorul, în general, nu este vinovat. Acest articol povestește despre unul dintre aceste cazuri. Titlul său repetă exclamația unuia dintre dezvoltatorii noștri (veți vedea că Kubernetes nu are nimic de-a face aici). Nu veți găsi revelații neașteptate despre Kubernetes, dar puteți conta pe câteva lecții bune despre sisteme complexe.
Acum câteva săptămâni, echipa mea s-a ocupat de migrarea unui microserviciu pe platforma principală, care include CI/CD, un mediu de lucru bazat pe Kubernetes, metrici și alte utilități utile. Leagănul a avut un caracter experimental: planificam să îl folosim ca bază și să mutăm încă aproximativ 150 de servicii în următoarele luni. Toate acestea sunt responsabile pentru funcționarea unor dintre cele mai mari platforme online din Spania (Infojobs, Fotocasa etc.).
După ce am desfășurat aplicația în Kubernetes și am redirecționat o parte din trafic către ea, ne aștepta o surpriză alarmantă. Latența (latency) cererilor în Kubernetes era de 10 ori mai mare decât în EC2. În general, era necesar fie să căutăm o soluție la această problemă, fie să renunțăm la migrarea microserviciului (și, posibil, la întregul proiect).
De ce este latența în Kubernetes atât de mare comparativ cu EC2?
Pentru a găsi punctul slab, am colectat metrici pe toată calea cererii. Arhitectura noastră este simplă: API Gateway (Zuul) proxează cererile către instanțele microserviciului în EC2 sau Kubernetes. În Kubernetes folosim NGINX Ingress Controller, iar backend-urile sunt obiecte de tipul cu aplicația JVM pe platforma Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Se părea că problema era legată de întârzierea din etapa inițială a funcționării backend-ului (am marcat porțiunea problematică din grafic ca «xx»). În EC2, răspunsul aplicației dura aproximativ 20 ms. În Kubernetes, întârzierea creștea până la 100—200 ms.
Am exclus rapid posibilii suspecți legați de schimbarea mediei de execuție. Versiunea JVM a rămas aceeași. Problemele de containerizare nu au fost nici ele de vină: aplicația funcționa deja cu succes în containere în EC2. Încărcarea? Dar am observat întârzieri mari chiar și la 1 cerere pe secundă. Pauzele pentru colectarea gunoiului puteau fi de asemenea ignorate.
Unul dintre administratorii noștri de Kubernetes s-a întrebat dacă aplicația are dependențe externe, deoarece în trecut cererile DNS au cauzat probleme similare.
Ipoteza 1: rezolvarea numelui DNS
La fiecare cerere, aplicația noastră face între una și trei apeluri la instanța AWS Elasticsearch dintr-un domeniu de genul elastic.spain.adevinta.com. În containere avem , așa că putem verifica dacă într-adevăr căutarea domeniului durează mult timp.
Cererile DNS din container:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Cererile similare din una dintre instanțele EC2, unde este găzduită aplicația:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Având în vedere că căutarea durează aproximativ 30 ms, a devenit clar că rezolvarea DNS atunci când se face apel la Elasticsearch contribuie la creșterea întârzierii.
Cu toate acestea, era ciudat din două motive:
- Avem deja o mulțime de aplicații în Kubernetes care interacționează cu resursele AWS, dar nu suferă de întârzieri mari. Indiferent de motiv, acesta este specific pentru acest caz.
- Știm că JVM efectuează caching in-memory pentru DNS. În imaginile noastre, valoarea TTL este specificată în
$JAVA_HOME/jre/lib/security/java.securityși este setată la 10 secunde:networkaddress.cache.ttl = 10. Cu alte cuvinte, JVM ar trebui să cacheze toate solicitările DNS timp de 10 secunde.
Pentru a confirma prima ipoteză, am decis să renunțăm temporar la apelurile DNS și să vedem dacă problema dispare. Inițial, am decis să reproiectăm aplicația pentru a se conecta direct la Elasticsearch prin adresă IP, și nu prin nume de domeniu. Aceasta ar necesita modificarea codului și o nouă desfășurare, așa că am asociat pur și simplu domeniul cu adresa sa IP în /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comAcum containerul obținea IP-ul aproape instantaneu. Acest lucru a dus la o îmbunătățire oarecare, dar ne-am apropiat doar puțin de nivelul de întârziere așteptat. Deși rezolvarea DNS dura mult timp, adevărata cauză ne scăpa încă.
Diagnosticații prin rețea
Am decis să analizăm traficul din container cu ajutorul tcpdump, pentru a urmări ce se întâmplă exact în rețea:
[root@be-851c76f696-alf8z \/]# tcpdump -leni any -w capture.pcap Apoi, am trimis câteva solicitări și am preluat capture-ul lor (kubectl cp my-service:\/capture.pcap capture.pcap) pentru o analiză ulterioară în .
În solicitările DNS nu era nimic suspect (cu excepția unei mici probleme despre care voi vorbi mai târziu). Dar au existat anumite ciudățenii în modul în care serviciul nostru a gestionat fiecare solicitare. Mai jos este un screenshot al capture-ului care arată acceptarea solicitării înainte de a începe răspunsul:
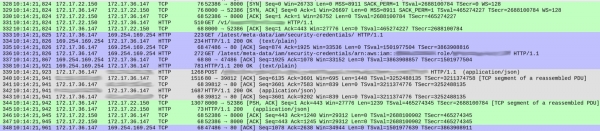
Numerele pachetelor sunt listate în prima coloană. Pentru claritate, am evidențiat în culori diverse fluxurile TCP.
Fluxul verde, început cu pachetul 328, arată cum clientul (172.17.22.150) a stabilit o conexiune TCP cu containerul (172.17.36.147). După strângerea de mâini inițială (328-330), pachetul 331 a adus HTTP GET \/v1\/.. — solicitarea de intrare către serviciul nostru. Întregul proces a durat 1 ms.
Fluxul gri (începând de la pachetul 339) arată că serviciul nostru a trimis un HTTP request către instanța Elasticsearch (strângerea de mâini TCP este absentă, deoarece se folosește o conexiune existentă). Acest lucru a durat 18 ms.
Până acum totul pare în regulă, iar timpii se potrivesc aproximativ cu întârzierile așteptate (20-30 ms în măsurătorile de la client).
Cu toate acestea, secțiunea albastră durează 86 ms. Ce se întâmplă în ea? Cu pachetul 333, serviciul nostru a trimis o cerere HTTP GET la /latest/meta-data/iam/security-credentials, iar imediat după aceasta, pe aceeași conexiune TCP, o altă cerere GET la /latest/meta-data/iam/security-credentials/arn:...
Am descoperit că acest lucru se repetă cu fiecare cerere din întreaga trasare. Rezolvarea DNS este într-adevăr puțin mai lentă în containerele noastre (explicația acestui fenomen este destul de interesantă, dar o voi păstra pentru un articol separat). A fost evident că întârzierile mari sunt cauzate de apelurile la serviciul AWS Instance Metadata la fiecare cerere.
Ipoteza 2: apeluri suplimentare la AWS
Ambele endpoint-uri aparțin . Microserviciul nostru folosește acest serviciu în timpul lucrului cu Elasticsearch. Ambele apeluri fac parte din procesul de bază al autentificării. Endpoint-ul la care se face apel la prima cerere furnizează rolul IAM asociat cu instanța.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
A doua cerere se conectează la al doilea endpoint pentru privilegii temporare pentru această instanță:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Clientul le poate utiliza pentru o perioadă scurtă de timp și trebuie să obțină periodic noi certificate (până la Expiration). Modelul este simplu: AWS efectuează o rotație frecventă a cheilor temporare din motive de securitate, dar clienții pot să le cacheze câteva minute, compensând scăderea performanței asociată obținerii de noi certificate.
AWS Java SDK ar trebui să își asume responsabilitățile pentru organizarea acestui proces, totuși dintr-un anumit motiv acest lucru nu se întâmplă.
Căutând pe issues pe GitHub, ne-am lovit de problema . Aceasta ne-a ajutat să determinăm direcția în care trebuie să „săpăm” mai departe.
AWS SDK actualizează certificatele când se îndeplinește una dintre următoarele condiții:
- Data expirării lor (
Expiration) intră înEXPIRATION_THRESHOLD, stabilit în cod la 15 minute. - Din ultima încercare de a actualiza certificatele a trecut mai mult timp decât
REFRESH_THRESHOLD, stabilit la 60 de minute.
Pentru a verifica efectiv perioada de valabilitate a certificatelor obținute de noi, am executat comenzile cURL de mai sus din container și din instanța EC2. Timpul de valabilitate al certificatului obținut din container s-a dovedit a fi mult mai scurt: exact 15 minute.
Acum totul este clar: pentru prima solicitare, serviciul nostru primea certificate temporare. Deoarece perioada lor de valabilitate nu depășea 15 minute, la următoarea solicitare, AWS SDK decidea să le reînnoiască. Și acest lucru se întâmpla cu fiecare solicitare.
De ce a devenit perioada de valabilitate a certificatelor mai scurtă?
Serviciul AWS Instance Metadata este destinat lucrului cu instanțele EC2, nu cu Kubernetes. Pe de altă parte, nu ne doream să schimbăm interfața aplicațiilor. În acest scop, am folosit — un instrument care, prin agenți pe fiecare nod Kubernetes, permite utilizatorilor (ingineri care implementează aplicații în cluster) să atribuie roluri IAM containerelor din pod-uri, de parcă ar fi instanțe EC2. KIAM intercepta apelurile către serviciul AWS Instance Metadata și le procesa din cache-ul său, după ce le obținea de la AWS. Din punctul de vedere al aplicației, nimic nu se schimbă.
KIAM furnizează certificate pe termen scurt pod-urilor. Acest lucru este întreprins, având în vedere că durata medie de viață a unui pod este mai mică decât a unei instanțe EC2. În mod implicit, perioada de valabilitate a certificatelor .
Prin urmare, dacă suprapunem ambele valori implicite, apare o problemă. Fiecare certificat furnizat aplicației expiră în 15 minute. În acest context, AWS Java SDK forțează reînnoirea oricărui certificat a cărui perioadă de valabilitate se apropie de expirare.
Ca rezultat, certificatul temporar este reînnoit cu fiecare solicitare, ceea ce implică câteva apeluri la API-ul AWS și duce la o întârziere semnificativă. În AWS Java SDK am găsit , care menționează o problemă similară.
Soluția s-a dovedit a fi simplă. Am reconfigurat KIAM pentru a solicita certificate cu o perioadă de valabilitate mai lungă. Odată ce s-a întâmplat acest lucru, solicitările au început să treacă fără implicarea serviciului AWS Metadata, iar întârzierea a scăzut chiar sub un nivel mai scăzut decât în EC2.
Conclusions
Din experiența noastră cu migrațiile, putem spune că una dintre cele mai frecvente surse de probleme nu sunt erorile în Kubernetes sau în alte componente ale platformei. De asemenea, nu este legată de vreo defectiune fundamentală în microserviciile pe care le migrăm. Problemele apar adesea pur și simplu din cauza faptului că combinăm diferite elemente.
Amestecăm sisteme complexe care anterior nu au interacționat între ele, așteptând ca împreună să formeze un sistem unificat, mai mare. Din păcate, cu cât sunt mai multe elemente, cu atât există mai multe șanse pentru erori, sporind entropia.
În cazul nostru, întârzierea mare nu a rezultat din erori sau soluții proaste în Kubernetes, KIAM, AWS Java SDK sau microserviciul nostru. A fost rezultatul combinării a două parametrii independenți, setați implicit: unul în KIAM, celălalt în AWS Java SDK. Separat, ambii parametrii au sens: atât politica activă de actualizare a certificatelor în AWS Java SDK, cât și perioada scurtă de valabilitate a certificatelor în KAIM. Însă, când sunt combinate, rezultatele devin imprevizibile. Două soluții independente și logice nu trebuie neapărat să aibă sens atunci când sunt unite.
P.S. de la traducător
Pentru a afla mai multe despre arhitectura utilitarului KIAM pentru integrarea AWS IAM cu Kubernetes, puteți vizita de către creatorii săi.
De asemenea, în blogul nostru citiți:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
