

Numele meu este Victor Iagofarov și mă ocup de dezvoltarea platformei Kubernetes în compania DomClick, în funcția de lider tehnic al echipei de dezvoltare din echipa Ops (exploatare). Aș dori să vorbesc despre structura proceselor noastre Dev Ops, despre particularitățile exploatării unuia dintre cele mai mari clustere k8s din Rusia, precum și despre practicile DevOps/SRE pe care le aplică echipa noastră.
Echipa Ops
În echipa Ops lucrează în prezent 15 persoane. Trei dintre ei se ocupă de birou, doi lucrează în alt fus orar și sunt disponibili, inclusiv noaptea. Astfel, întotdeauna cineva din Ops este la monitor și pregătit să reacționeze la un incident de orice complexitate. Nu avem ture de noapte, ceea ce ne păstrează sănătatea mintală și ne permite tuturor să ne odihnim și să ne desfășurăm timpul liber nu doar în fața computerului.
Competențele tuturor sunt diferite: specialiști în rețele, DBA, specialiști în tehnologia ELK, administratori/dezvoltatori Kubernetes, experți în monitorizare, virtualizare, hardware etc. Cei care ne unesc este că fiecare poate înlocui într-o oarecare măsură pe oricare dintre noi: de exemplu, poate adăuga noduri noi în clusterul k8s, actualiza PostgreSQL, scrie pipeline CI/CD + Ansible, automatiza ceva în Python/Bash/Go, conecta echipamente în centrul de date. Competențele puternice într-un domeniu nu împiedică schimbarea direcției de activitate și începerea perfecționării într-un alt domeniu. De exemplu, am fost angajat în companie ca specialist în PostgreSQL, iar acum zona mea principală de responsabilitate sunt clusterele Kubernetes. În echipă, orice formă de creștere este binevenită, iar simțul colaborării este foarte dezvoltat.
Apropo, căutăm. Cerințele pentru candidați sunt destul de standard. Personal, consider că este important ca persoana să se integreze în echipă, să fie nonconflictuală, dar, de asemenea, să știe să își susțină punctul de vedere, să își dorească să se dezvolte și să nu se teamă să facă lucruri noi, să își propună idei. De asemenea, sunt necesare abilități de programare în limbaje script, cunoștințe de bază despre Linux și limba engleză. Engleza este necesară doar pentru ca persoana, în caz de probleme, să poată căuta rapid o soluție în 10 secunde, nu în 10 minute. Este foarte greu să găsești specialiști cu cunoștințe profunde de Linux: e amuzant, dar doi din trei candidați nu pot răspunde la întrebarea „Ce este Load Average? Din ce se compune?”, iar întrebarea „Cum se adună un core dump dintr-o aplicație C” este considerată ceva dintr-o lume a supereroilor… sau a dinozaurilor. Trebuie să ne obișnuim cu asta, deoarece de obicei oamenii au alte competențe bine dezvoltate, iar noi vom învăța „linux”. Răspunsul la întrebarea „de ce trebuie să știe toate acestea un inginer DevOps în lumea modernă a cloud-ului” va trebui să rămână în afara articolului, dar dacă ar fi să spunem în trei cuvinte: toate acestea sunt necesare.
Echipa Tools
Echipa Tools joacă un rol important în automatizare. Sarcina principală a acestora este crearea de instrumente grafice și CLI convenabile pentru dezvoltatori. De exemplu, dezvoltarea noastră internă Confer permite, în esență, să lansezi o aplicație în Kubernetes cu câteva clicuri, să configurezi resursele acesteia, cheile din vault etc. A fost Jenkins + Helm 2, dar a fost necesar să dezvoltăm un instrument propriu pentru a evita copierea și lipirea, aducând astfel uniformitate în ciclul de viață al software-ului.
Echipa Ops nu scrie pipelini pentru dezvoltatori, dar poate oferi consultanță pentru orice întrebare legată de scrierea acestora (unii încă au Helm 3).
DevOps
În ceea ce privește DevOps, considerăm că ar trebui să arate așa:
Echipele Dev scriu codul, îl lansează prin Confer în dev -> qa/stage -> prod. Responsabilitatea ca codul să nu se blocheze și să nu genereze erori revine echipelor Dev și Ops. În timpul zilei, reacția la incidentul legat de aplicația proprie trebuie să vină, în primul rând, de la persoana de serviciu din echipa Ops, iar în timpul serii și pe timpul nopții, administratorul de serviciu (Ops) trebuie să îl trezească pe dezvoltatorul de serviciu, dacă este sigur că problema nu este în infrastructură. ToateMetricile și alertele din monitorizare apar automat sau semi-automat.
Zona de responsabilitate Ops începe din momentul lansării aplicației în producție, dar responsabilitatea Dev nu se oprește aici — facem același lucru și suntem într-o barcă comună.
Dezvoltatorii consultă administratorii dacă au nevoie de ajutor în scrierea unui microserviciu administrativ (de exemplu, backend Go + HTML5), iar administratorii consultă dezvoltatorii pentru orice întrebări legate de infrastructură sau de k8s.
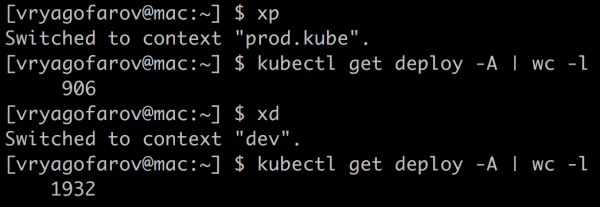
Apropo, nu avem deloc monolit, doar microservicii. Numărul acestora variază între 900 și 1000 în clusterul k8s în producție, dacă măsurăm după numărătoare. deploymentsNumărul de pod-uri variază între 1700 și 2000. În clusterul de producție, sunt în prezent aproximativ 2000 de pod-uri.
Nu pot numi cifre exacte, deoarece monitorizăm microserviciile inutile și le eliminăm într-un mod semi-automat. Monitorizarea entităților inutile în k8s este ajutată de , ceea ce economisește resurse și bani.
Gestionarea resurselor
Monitorizare
Punctul esențial în exploatarea unui cluster mare devine un monitorizare bine structurată și informativă. Până acum nu am găsit o soluție universală care să acopere 100% din toate cerințele de monitorizare, așa că, periodic, construim diverse soluții personalizate în acest mediu.
- Zabbix. Vechea monitorizare, care este destinată, în primul rând, pentru a urmări starea generală a infrastructurii. Ne spune când un nod moare din cauza procesorului, memoriei, discurilor, rețelei și așa mai departe. Nimic supranatural, dar avem și un DaemonSet dedicat agenților, cu ajutorul căruia, de exemplu, monitorizăm starea DNS în cluster: căutăm pod-uri core dns nefuncționale, verificăm accesibilitatea host-urilor externe. S-ar putea să te întrebi de ce ne-am îngrijora pentru asta, dar la volume mari de trafic, acest component este un punct serios de defectare. Anterior am discutat despre cum am luptat cu performanța DNS în cluster.
- Operatorul PrometheusUn set de exportatori diferiți oferă o viziune amplă a tuturor componentelor cluster-ului. Apoi, vizualizăm toate acestea pe mari tablouri de bord în Grafana, iar pentru notificări folosim alertmanager.
Un alt instrument util pentru noi a devenit . Am scris acest lucru după ce am întâlnit de mai multe ori situații în care o echipă suprapunea căile Ingress ale altei echipe, ceea ce genera erori 50x. Acum, înainte de a desfășura în producție, dezvoltatorii verifică că nu afectează pe nimeni, iar pentru echipa mea este un instrument util pentru diagnosticarea inițială a problemelor cu Ingress-urile. Este amuzant că a fost inițial scris pentru administratori și arăta destul de „brut”, dar după ce instrumentul a fost apreciat de echipele de dezvoltare, s-a transformat mult și nu mai arată ca „un sistem făcut de administratori pentru administratori”. În curând ne vom despărți de acest instrument și astfel de situații vor fi validate înainte de lansarea pipeline-ului.
Resursele echipelor în „Kube”
Înainte de a începe cu exemplele, merită să explicăm cum funcționează alocarea resurselor pentru microservicii.
Pentru a înțelege ce echipe și în ce cantități utilizează resursele lor resurse (procesor, memorie, SSD local), alocăm fiecărei echipe propriul namespace în „Kube” și limităm capacitățile sale maxime de procesor, memorie și disc, discutând în prealabil nevoile echipelor. Prin urmare, o echipă, în general, nu va bloca desfășurarea întregului cluster, alocându-și mii de nuclee și terabyte de memorie. Accesurile în namespace sunt acordate prin AD (folosim RBAC). Namespace-urile și limitele lor sunt adăugate printr-un pull request în depozitul GIT, iar mai departe, întregul proces este desfășurat automat printr-un pipeline Ansible.
Exemplu de alocare a resurselor pentru o echipă:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Cereri și limite
În „Kube” Request — este cantitatea de resurse rezervate garantat pentru pod (unul sau mai multe containere Docker) în cluster. Limită — este maximul negarantat. Adesea se poate observa pe grafice că o anumită echipă a stabilit prea multe cereri pentru toate aplicațiile sale și nu poate desfășura aplicația în „Kube”, deoarece toate cererile din namespace-ul lor sunt deja „consumate”.
Soluția corectă în această situație: a verifica consumul real de resurse și a compara cu cantitatea solicitată (Request).
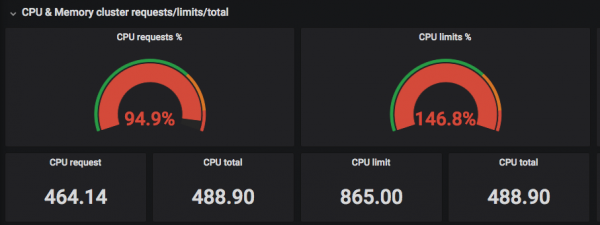
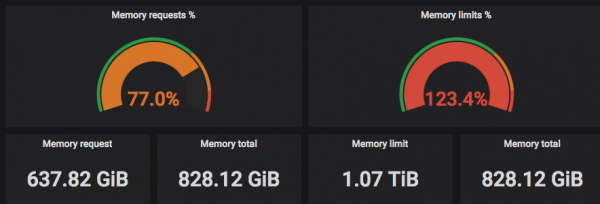
În capturile de ecran de mai sus, se poate observa că cererile (Requested) de CPU se apropie de cantitatea reală de fire, iar limitele pot depăși numărul real de fire ale procesoarelor centrale =)
Acum vom analiza în detaliu un namespace (am ales namespace-ul kube-system — namespace-ul sistemului pentru componentele „Kube”) și vom observa raportul dintre timpul real de procesare a CPU-ului și memoria utilizată în raport cu cea solicitată:
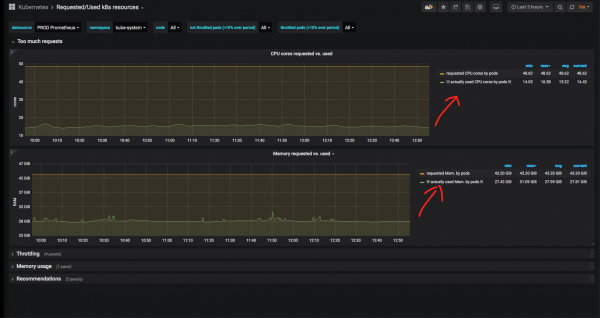
Este evident că memoria și CPU-ul rezervate pentru serviciile de sistem sunt mult mai mari decât cele utilizate de fapt. În cazul kube-system, acest lucru este justificat: a fost cazul în care controller-ul nginx ingress sau nodelocaldns au atins limita CPU-ului și au consumat foarte mult RAM, de aceea această rezervă este justificată. În plus, nu ne putem baza pe graficele din ultimele 3 ore: este de dorit să vedem metricile istorice pe o perioadă mai lungă de timp.
A fost dezvoltat un sistem de „recomandări”. De exemplu, aici putem vedea ce resurse ar trebui să își crească „limitele” (pragurile maxime permise), pentru a nu se produce „trotlină” (throttling): acel moment când CPU-ul sau memoria au fost deja consumate în intervalul de timp alocat și așteaptă să fie „dezghețate”:
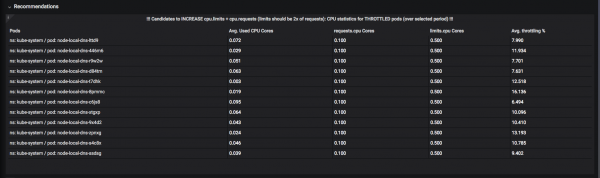
Iată podurile cărora ar trebui să le temperăm apetitul:
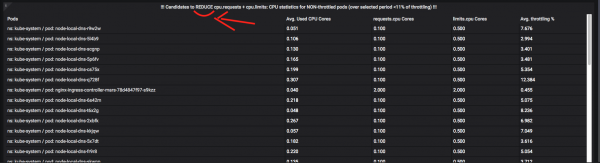
Despre trotlină + monitorizarea resurselor poate constitui subiectul a mai multor articole, așa că nu ezitați să puneți întrebări în comentarii. Pe scurt, pot spune că sarcina de automatizare a acestor metrici este destul de complexă și necesită mult timp și acrobații cu funcțiile „de fereastră” și „CTE” Prometheus / VictoriaMetrics (aceste termeni sunt puse între ghilimele, deoarece în PromQL aproape că nu există nimic similar, și trebuie să construim interogări ciudate pe câteva ecrane de text și să ne ocupăm de optimizarea lor).
În final, dezvoltatorii au instrumente pentru monitorizarea propriilor namespaces în „Kube”, și sunt capabili să aleagă ei înșiși unde și când să „taie” resursele la anumite aplicații, iar anumitor poduri le pot oferi toată puterea CPU-ului pe întreaga noapte.
Metodologii
În companie, așa cum este acum la modă, aderăm la practicile DevOps și SRE-practici. Când în companie sunt 1000 de microservicii, aproximativ 350 de dezvoltatori și 15 administratori pentru întreaga infrastructură, trebuie să „fim la modă”: în spatele acestor „buzzword-uri” se ascunde o necesitate acută de automatizare a tot ce este posibil, iar administratorii nu trebuie să fie un dop în procese.
Ca Ops, oferim diverse metrici și dashboard-uri pentru dezvoltatori, legate de timpul de răspuns al serviciilor și erorile acestora.
Folosim metodologii precum: , și , combinându-le. Ne străduim să minimizăm numărul de tablouri de bord pentru a putea vedea dintr-o privire care serviciu este în degradare (de exemplu, codurile de răspuns pe secundă, timpul de răspuns pe percentilă de 99), și așa mai departe. De îndată ce sunt necesare noi metrici pentru tablourile de bord comune, le desenăm și le adăugăm imediat.
Nu am desenat grafice de o lună. Probabil că acesta este un semn bun: înseamnă că majoritatea «dorintelor» sunt deja implementate. A fost o vreme când, în fiecare săptămână, desenam cel puțin o dată pe zi un nou grafic.
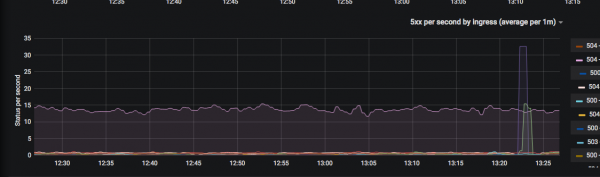
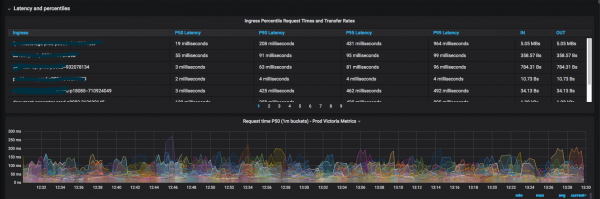
Rezultatul obținut este valoros deoarece acum dezvoltatorii merg destul de rar la admini cu întrebări «unde pot verifica o metrică».
Implementare Service Mesh nu este departe și ar trebui să le ușureze viața tuturor, colegii de la Tools sunt deja aproape de implementarea unui «Istio al omului sănătos»: ciclul de viață al fiecărei cereri HTTP(s) va fi vizibil în monitorizare, iar întotdeauna se va putea înțelege «în ce etapă s-a stricat totul» în interacțiunea inter-servicii (și nu numai). Abonați-vă la noutățile hub-ului companiei DomClick. =)
Suport pentru infrastructura Kubernetes
Din motive istorice, folosim o versiune patch-uită Kubespray — rol Ansible pentru desfășurarea, extinderea și actualizarea Kubernetes. La un moment dat, suportul pentru instalările non-kubeadm a fost eliminat din ramura principală, iar procesul de trecere la kubeadm nu a fost propus. În cele din urmă, compania Southbridge a făcut un fork (cu suport kubeadm și o soluție rapidă pentru probleme critice).
Procesul de actualizare a tuturor clusterelor k8s arată astfel:
- Luăm Kubespray de la Southbridge, comparăm cu ramura noastră, fuzionăm.
- Implementăm actualizarea în Stress-«Cub».
- Implementăm actualizarea pe câte un nod (în Ansible asta înseamnă «serial: 1») în Dev-«Cub».
- Actualizăm Prod sâmbătă seara pe câte un nod.
În viitor, avem planuri să înlocuim Kubespray cu ceva mai rapid și să trecem la kubeadm.
În total, avem trei «Cubi»: Stress, Dev și Prod. Planificăm să lansăm încă unul (hot standby) Cub Prod în cel de-al doilea centru de date. Stress și Dev trăiesc în «virtuale» (oVirt pentru Stress și VMWare cloud pentru Dev). Prod-«Cub» trăiește pe «hardware gol» (bare metal): acestea sunt noduri identice cu 32 de fire CPU, 64-128 GB de memorie și 300 GB SSD RAID 10 — în total 50 de bucăți. Trei noduri «subțiri» sunt rezervate pentru «mastere» Prod-«Cuburi»: 16 GB de memorie, 12 fire CPU.
Pentru producție preferăm să folosim «hardware gol» și evităm straturile suplimentare precum OpenStack: nu avem nevoie de «vecini zgomotoși» și timpul CPU steal timeȘi dificultatea administrării crește aproape de două ori în cazul OpenStack-ului in-house.
Pentru CI/CD, folosim un server GIT dedicat pentru „kuburi” și alte componente infrastructurale, Helm 3 (am trecut destul de greu de la Helm 2, dar suntem foarte mulțumiți de opțiune atomic), Jenkins, Ansible și Docker. Ne plac feature-branch-urile și desfășurarea în medii diferite dintr-un singur repository.
Concluzie
Așa arată, în mare, procesul DevOps în cadrul companiei DomClick din perspectiva unui inginer de operare. Articolul a ieșit mai puțin tehnic decât mă așteptam: așadar, urmăriți noutățile DomClick pe Habr: vor fi articole mai „hardcore” despre Kubernetes și nu numai.
Sursa: habr.com
