

Sursa:
Regresia liniară este unul dintre algoritmii fundamentali pentru multe domenii legate de analiza datelor. Motivul este evident. Este un algoritm foarte simplu și ușor de înțeles, ceea ce contribuie la utilizarea sa pe scară largă de mai multe decenii, dacă nu sute de ani. Ideea este că presupunem o dependență liniară a unei variabile de un set de alte variabile, iar apoi încercăm să recreem această dependență.
Dar, în acest articol nu vom discuta despre aplicarea regresiei liniare pentru rezolvarea problemelor practice. Vor fi analizate aspectele interesante ale implementării algoritmilor distribuiți pentru recrearea acesteia, cu care ne-am confruntat în timpul scrierii modulului de învățare automată în . Puțină matematică de bază, fundamentele învățării automate și calculului distribuit vor ajuta la înțelegerea modului de restaurare a regresiei liniare, chiar dacă datele sunt distribuite între mii de noduri.
Despre ce este vorba?
Avem în față sarcina de a restaura o dependență liniară. Ca date de intrare, se oferă un set de vectori de variabile presupus independente, fiecăruia fiind asociat o anumită valoare a variabilei dependente. Aceste date pot fi reprezentate sub formă de două matrice:

Acum, având în vedere că există o dependență, și că este liniară, să notăm ipoteza noastră sub formă de produs de matrice (pentru a simplifica notarea, aici și mai departe se presupune că termenul liber al ecuației este ascuns sub  , iar ultima coloană a matricei
 conține unități):

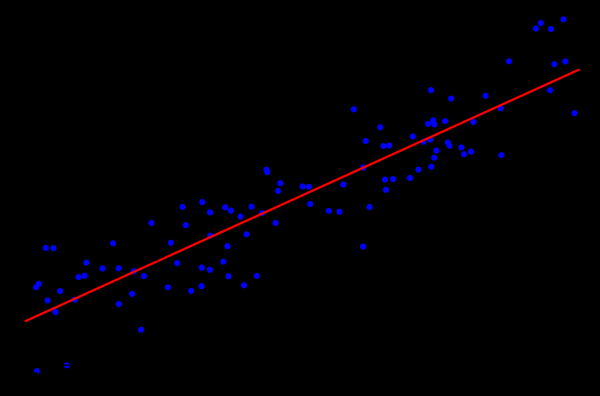
Foarte asemănător cu un sistem de ecuații liniare, nu-i așa? Așa pare, dar este probabil ca acel sistem de ecuații să nu aibă soluții. Cauza este zgomotul care există practic în orice date reale. De asemenea, o cauză poate fi absența dependenței liniare ca atare, care poate fi abordată introducând variabile suplimentare, care depind neliniar de cele inițiale. Să luăm în considerare următorul exemplu:
Sursa:
Acesta este un exemplu simplu de regresie liniară care demonstrează dependența unei variabile (pe axa  ) de o altă variabilă (pe axa
 ). Pentru ca sistemul de ecuații liniare corespunzător acestui exemplu să aibă o soluție, toate punctele trebuie să se afle exact pe o linie dreaptă. Dar acest lucru nu este cazul. Iar faptul că nu se află pe o linie dreaptă se datorează zgomotului (sau ipotezei greșite privind existența unei corelații liniare). Prin urmare, pentru a reconstrui corelația lineară pe baza datelor reale, în general, este necesar să introducem o altă ipoteză: datele de intrare conțin zgomot și acest zgomot are . Se pot face presupuneri și despre alte tipuri de distribuții ale zgomotului, dar în majoritatea cazurilor se consideră oarecum distribuția normală, despre care se va discuta în continuare.
Metoda maximelor probabilităților
Deci, am presupus că există un zgomot aleator distribuit normal. Ce ar trebui să facem în această situație? În matematică există și se utilizează pe scară largă . Pe scurt, esența sa constă în alegerea și maximizarea ulterioară a acesteia.
Ne întoarcem la reconstrucția dependenței liniare din date cu zgomot normal. Observăm că dependența liniară presupusă este așteptarea matematică  distribuției normale existente. În același timp, probabilitatea ca
 să ia o anumită valoare, sub condiția existenței observabilelor
 , arată astfel:

Acum să înlocuim  și
 variabilele necesare:

Rămâne doar să găsim vectorul  , pentru care această probabilitate este maximă. Pentru a maximiza o astfel de funcție, este convenabil să o logaritmăm mai întâi (logaritmul funcției va atinge maximul în aceeași punct ca și funcția în sine):

Ceea ce, la rândul său, se reduce la minimizarea următoarei funcții:

Apropo, acest lucru se numește metoda . De multe ori, toate considerațiile de mai sus sunt omise și se folosește pur și simplu această metodă.
Dezintegrarea QR
Minimul funcției menționate mai sus poate fi găsit, dacă găsim punctul în care gradientul acestei funcții este egal cu zero. Iar gradientul va fi scris în următorul mod:

este o metodă matriceală de rezolvare a problemei de minimizare utilizată în metoda celor mai mici pătrate. În acest sens, vom rescrie ecuația în formă matriceală:

Deci, descompunem matricea  în matrice
 și
 și realizăm o serie de transformări (algoritmul QR de descompunere nu va fi discutat aici, doar utilizarea sa în raport cu problema stabilită):

Matricea  este ortogonală. Aceasta ne permite să scăpăm de produsul
 :

Și dacă înlocuim  pe
 , atunci va rezulta
 . Având în vedere că
 este o matrice triunghiulară superioară, arată astfel:

Aceasta se poate rezolva prin metoda substituției. Elementul  se află ca
 , elementul anterior
 se află ca
 și așa mai departe.
Aici merită să menționăm că complexitatea algoritmului rezultat datorită utilizării descompunerii QR este egală  . Cu toate acestea, deși operația de înmulțire a matricelor se paralelizează bine, nu pare posibil să scriem o versiune distribuită eficientă a acestui algoritm.
Declinarea gradientului
Vorbind despre minimizarea unei funcții, întotdeauna merită să ne amintim de metoda (stocastică) a coborârii gradientului. Aceasta este o metodă simplă și eficientă de minimizare, bazată pe calculul iterativ al gradientului funcției într-un punct și mutarea ulterioară în direcția opusă gradientului. Fiecare astfel de pas apropie soluția de minim. Gradientul arată în continuare astfel:

Această metodă se paralelizează și distribuie bine datorită proprietăților lineare ale operatorului gradient. Observăm că în formula prezentată mai sus sub semnul sumei se află termeni independenți. Cu alte cuvinte, putem calcula gradientul independent pentru toate indicii  de la
 , în paralel cu calculul gradientului pentru indicii de la
 la
 . Apoi, se vor aduna gradientele obținute. Rezultatul sumei va fi același ca și cum am fi calculat direct gradientul pentru indicii de la
 . Astfel, dacă datele sunt distribuite între mai multe părți ale datelor, gradientul poate fi calculat independent pe fiecare parte, iar apoi rezultatele acestor calcule pot fi adunate pentru a obține rezultatul final:

Din punct de vedere al implementării, aceasta se încadrează în paradigma . La fiecare pas al coborârii gradientului, o sarcină de calculare a gradientului este trimisă fiecărui nod de date, apoi gradientele calculate sunt adunate, iar rezultatul sumei lor este folosit pentru îmbunătățirea rezultatului.
Deși implementarea sa este simplă și poate fi executată în paradigma MapReduce, declinul gradientului are și dezavantajele sale. În special, numărul de pași necesari pentru a atinge convergența este semnificativ mai mare comparativ cu alte metode mai specializate.
LSQR
— o altă metodă de rezolvare a problemei, care se potrivește atât pentru recuperarea regresiei liniare, cât și pentru rezolvarea sistemelor de ecuații liniare. Principalul său avantaj constă în faptul că combină beneficiile metodelor matriceale și ale abordării iterative. Implementări ale acestei metode pot fi găsite în biblioteca , cât și în . Descrierea acestei metode nu va fi oferită aici (o puteți găsi în articolul ). În schimb, va fi demonstrată o abordare care permite adaptarea LSQR pentru a fi implementată într-un mediu distribuit.
La baza metodei LSQR se află . Aceasta este o procedură iterativă, fiecare iterație constând în următorii pași:
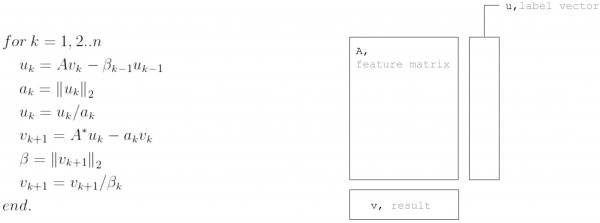
Dar, considerând că matricea  este împărțită orizontal, fiecare iterație poate fi reprezentată sub formă de două etape MapReduce. Astfel, se reușește să se minimizeze transferurile de date în cursul fiecărei dintre iterații (doar vectorii cu lungimea egală cu numărul de necunoscute):
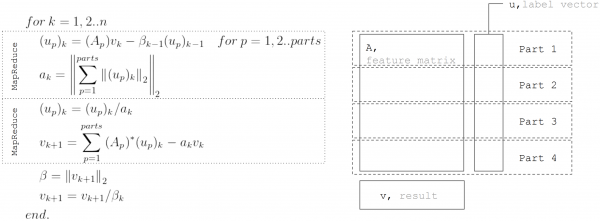
Această abordare este utilizată în implementarea regresiei liniare în .
Concluzie
Există multe algoritmi pentru recuperarea regresiei liniare, dar nu toți pot fi aplicați în orice condiție. De exemplu, descompunerea QR este excelentă pentru soluții exacte în seturi mici de date. Declinele gradientului se implementează simplu și permit găsirea rapidă a unei soluții aproximative. Însă LSQR combină cele mai bune proprietăți ale celor două algoritmi anterioare, deoarece poate fi distribuit, converge mai repede comparativ cu declinul gradientului și permite oprirea timpurie a algoritmului, spre deosebire de descompunerea QR pentru căutarea unei soluții aproximative.
Sursa: habr.com
