

Să analizăm conceptele de bază ale logării în Docker și Kubernetes, după care vom explora două instrumente care pot fi utilizate cu încredere în producție: Grafana Loki și stiva EFK (Elasticsearch + Fluent Bit + Kibana).
Materialul articolului este o sinteză din . Dacă există dorința și mai ales necesitatea de producție, se poate urma o instruire completă — înscrieți-vă la cursul despre .
Logarea în Docker
La nivel de Kubernetes, aplicațiile sunt pornite în pod-uri, dar la nivelul inferior ele funcționează de obicei în Docker. De aceea, trebuie să configurăm logarea astfel încât să colectăm jurnalele din containere. Containerele sunt lansate de Docker — deci trebuie să înțelegem cum funcționează logarea la nivelul Docker.
Sper că fiecare cititor știe: jurnalele aplicației trebuie să fie scrise în stdout/stderr, nu în interiorul containerului. Jurnalele sunt agregate de Docker Daemon, care lucrează doar cu acele jurnale care sunt trimise la stdout/stderr. În plus, scrierea jurnalelor în interiorul containerului duce la probleme: containerul se umflă din cauza creșterii jurnalului (deoarece cel mai probabil nu există Logrotate în container), iar Docker Daemon nu are informații despre acest jurnal.
Docker are mai mulți drivere de log sau plugin-uri pentru colectarea jurnalelor din containere. În versiunea gratuită Docker Community Edition (CE), driverele de log sunt mai puține decât în versiunea comercială Docker Enterprise Edition (EE).
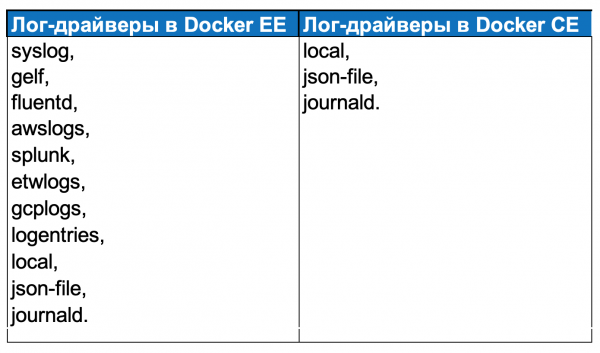
Nu am folosit niciodată Docker EE în practică: în Southbridge ne străduim să respectăm soluțiile Open Source, iar majoritatea clienților nu au nevoie de funcționalitățile suplimentare ale Docker EE.
Driverele de log în Docker CE:
local — scrierea jurnalelor în fișiere interne ale Docker Daemon;
json-file — crearea de json-log în folderul fiecărui container;
journald — trimiterea jurnalelor către journald.
Setările de logare în Docker se află în fișierul daemon.json.
În câmpul “log-driver” se indică plugin-ul, iar în câmpul “log-opts” — setările acestuia. În exemplul de mai sus este menționat plugin-ul “json-file”, limita de dimensiune a jurnalului — “max-size”: “10m”; limita numărului de fișiere (setările rotației) — “max-file”: “3”; și valorile care vor fi adăugate la jurnale.
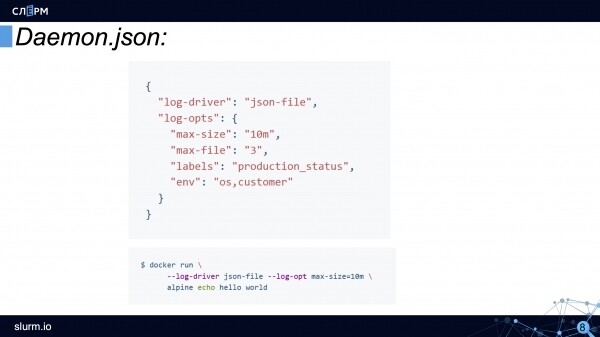
Unele setări ale driverului de log pot fi specificate prin interfața de linie de comandă. Este convenabil dacă un anumit container trebuie să fie lansat cu un alt driver de log.
Iată cum arată schema de logare în Docker:
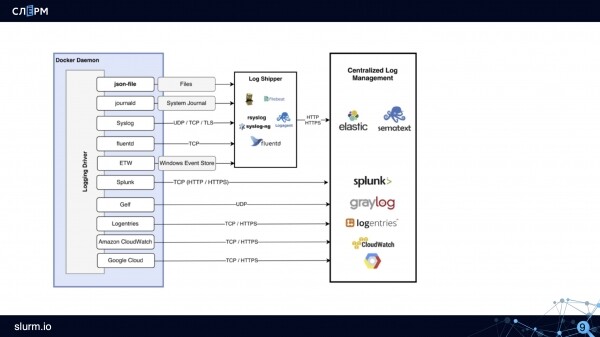
Cum funcționează schema: un driver de log-uri, cum ar fi json-file, creează fișiere. Colectoarele de log-uri (Rsyslog, Fluentd, Logagent și altele) adună aceste fișiere și le transmit pentru stocare în Elastic, Sematext sau alte depozite.
Caracteristici ale logării în Kubernetes
Simplificat, schema de logare în Kubernetes arată astfel: există un pod, în care se rulează un container, iar containerul trimite log-urile în stdout/stderr. Apoi, Docker creează un fișier și înregistrează log-urile, care pot fi apoi rotite.
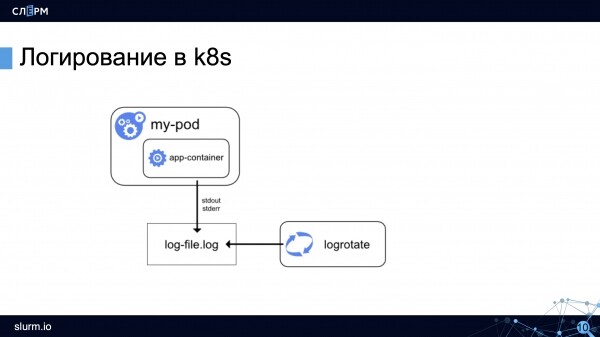
Să analizăm caracteristicile logării în Kubernetes.
A păstra log-urile între deployment-uri. Aceasta este o condiție obligatorie pentru o configurare corectă a logării. Dacă nu se păstrează log-urile între deployment-uri, atunci la lansarea unei noi versiuni a aplicației, log-urile anterioarei vor fi suprascrise, iar repornirea containerului va duce de asemenea la pierderea log-urilor. Kubernetes are un parametru —previous, care permite vizualizarea log-urilor aplicației înainte de ultimul restart al Pod-ului, dar nu mai adânc.
A agrega log-urile de pe toate instanțele. Dacă microserviciile sunt găzduite în cloud, atunci controlul sistemului este responsabilitatea furnizorului de cloud. Dacă microserviciile sunt pe echipamentele proprii, atunci pe lângă log-urile din containere, trebuie să se adune și log-urile sistemului.
Anterior, nu existau instrumente convenabile pentru colectarea log-urilor atât din sistem, cât și din microservicii. De obicei, un instrument aduna log-urile sistemului (de exemplu, Rsyslog), iar un altul — log-urile din Docker (de exemplu, journal-bit cu configurarea driver-ului de log Docker pe journald). S-a încercat utilizarea journal-bit — pentru a aduna log-urile și din containere (în driver-ul de log Docker specificând că trebuie să se scrie log-urile în journald), și din sistem (în CentOS 7 deja există systemd și journald). Soluția este funcțională, dar nu ideală. Dacă sunt multe log-uri, journal-bit începe să întârzie, iar mesajele se pierd.
Experimentele au continuat — și am găsit o altă abordare. În CentOS 7, principalele log-uri de sistem (messages, audit, secure) sunt duplicate în var-log sub formă de fișiere. În Docker, de asemenea, se poate configura salvarea log-urilor în fișiere json. Prin urmare, aceste fișiere din CentOS 7 și Docker pot fi adunate împreună.
Între timp, soluția ELK Stack a devenit populară. Aceasta este o combinație de mai multe instrumente: Elasticsearch, Logstash și Kibana.
Elasticsearch stochează log-urile din containere, Logstash adună log-urile din instanțe, Kibana permite procesarea log-urilor obținute, creând grafice pe baza acestora. O perioadă, ELK Stack a fost utilizat activ, dar, din punctul meu de vedere, timpul său a trecut. Voi explica ulterior de ce.
Adăugarea de metadate. Poduri, aplicațiile și containerele pot fi pornite de oriunde. Mai mult, o aplicație poate avea mai multe instanțe. Jurnalele sunt scrise într-un format uniform, iar noi trebuie să înțelegem care este replica specifică, ce Pod scrie și în ce spațiu de nume se află. De aceea, este necesar să adăugăm metadate în jurnale.
Parsat jurnalele. Este amuzant, dar costurile de suport pentru sistemul de jurnalizare și monitorizare pot depăși cheltuielile pentru aplicația principală. Atunci când ai zeci și sute de mii de jurnale pe secundă, acest lucru pare logic, dar totuși trebuie să cunoaștem limita. Una dintre metodele de a găsi această limită este parsarea jurnalele.
În general, nu trebuie să colectezi și să stochezi toate jurnalele, ci să trimiți la stocare doar o parte - de exemplu, jurnalele cu statut «warning» sau «error». Dacă vorbim despre jurnalele nginx sau ale controlerelor de ingress, atunci se pot trimite la stocare doar cele care au un statut diferit de 200. Dar acest lucru nu este un sfat universal: dacă construiești cumva analize pe jurnalele Nginx, atunci evident că ar trebui să le colectezi.
Nu este recomandat să filtrezi jurnalele fără discernământ, deoarece datele filtrate ar putea să nu fie suficiente pentru o analiză normală. Pe de altă parte, poate analizele ar trebui să se facă nu la nivel de jurnalizare, ci la nivel de colectare a metricilor. Atunci nu va fi necesar să stochezi sute de mii de rânduri cu cod 200. Una dintre abordări este să obții informații despre trafic și erori din metricile controlerelor de ingress.
În general, trebuie să te gândești bine: ce vrei să stochezi și cât timp, deoarece altfel va apărea o situație în care sistemul de jurnalizare va consuma mai multe resurse decât proiectul principal.
Momentan nu există o soluție standard pentru jurnalizare. Spre deosebire de monitorizare, unde există o soluție preponderentă, Prometheus, în jurnalizare nu există un standard.
În cadrul acestei lecții, vom examina două instrumente: unul popular și celălalt - în creștere. Pe lângă acestea, există și altele, dar în acest articol nu le vom aborda.
Având în vedere toate caracteristicile discutate anterior, jurnalizarea în Kubernetes poate fi acum reprezentată în acest mod:
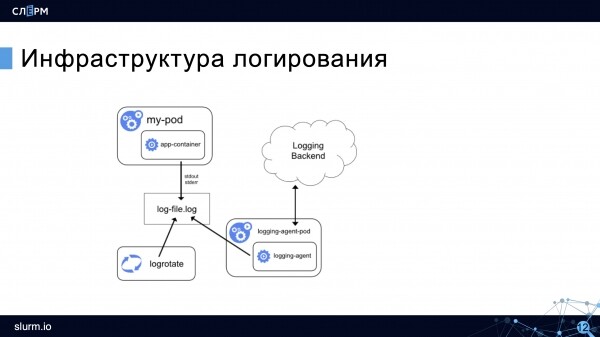
Rămâne jurnalul containerului, rotirea, dar apare un agent colector, care adună jurnalele și le trimite la stocare (în diagramă - în Logging Backend). Agentul funcționează pe fiecare nod și, în general, este pornit în Kubernetes.
Acum să discutăm despre instrumentele de logging.
— noul nostru sistem de agregare a log-urilor, — care a ajutat să ne asigurăm că toate Ingester-urile s-au comportat corect în timpul și după eșec.
a apărut recent, dar a devenit deja destul de cunoscut. Avantajele sale sunt: se instalează ușor, consumă puține resurse și nu necesită instalarea Elasticsearch, deoarece stochează datele în TSDB (baze de date pentru serii temporale). În articolul trecut, am menționat că Prometheus stochează date în astfel de baze, și aceasta este una dintre numeroasele asemănări între cele două produse. Dezvoltatorii afirmă chiar că Loki este 'Prometheus pentru lumea logging-ului'.
O mică digresiune despre TSDB pentru cei care nu au citit. : TSDB se descurcă excelent cu sarcina de a stoca cantități mari de date și serii temporale, dar nu este destinat pentru stocarea pe termen lung. Dacă din vreun motiv trebuie să păstrați logurile mai mult de două săptămâni, ar fi mai bine să le configurați pentru a fi transferate în altă bază de date.
Un alt avantaj al lui Loki este că pentru vizualizarea datelor se folosește Grafana. Este foarte convenabil: în Grafana vizualizăm datele de monitorizare și tot acolo, conectând Loki, putem vedea logurile. Din loguri se pot construi grafice.
Arhitectura lui Loki arată cam așa:
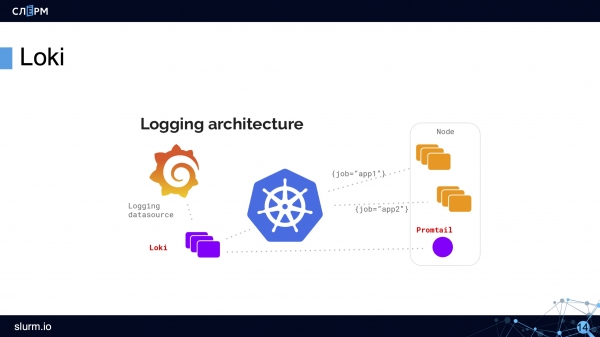
Prin intermediul DaemonSet, pe toate serverele din cluster se desfășoară un agent — Promtail sau Fluent Bit. Agentul colectează logurile. Loki le preia și le stochează în TSDB. Logurile sunt imediat adăugate cu metadate, ceea ce este convenabil: se poate filtra după Pods, namespaces, numele containerelor și chiar după etichete.
Loki funcționează într-un mediu familiar Grafana. Loki are chiar și un propriul limbaj de interogare, numit LogQL — care, după denumire și sintaxă, seamănă cu PromQL din Prometheus. În interfața lui Loki există sugestii pentru interogări, așa că nu trebuie să le ții minte pe de rost.
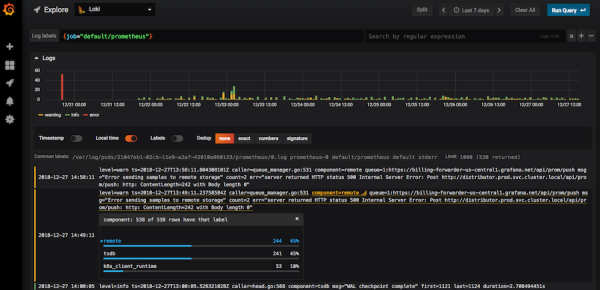
Loki în interfața Grafana
Folosind filtre, în Loki poți găsi coduri ('400', '404' și orice altul); poți vizualiza logurile de pe întreaga nod; poți filtra toate logurile care conțin cuvântul 'eroare'. Dacă dai clic pe un log, se va deschide un card cu toate informațiile despre eveniment.
În Loki există suficiente instrumente care permit extragerea logurilor dorite, deși, onest vorbind, tehnic ar putea fi mai multe. Acum Loki este în dezvoltare activă și câștigă popularitate.
Elastic + Fluent Bit + Kibana (Stiva EFK)
Stiva EFK este un instrument de logging mai clasic și, în același timp, la fel de popular.
La începutul articolului s-a menționat ELK (Elasticsearch + Logstash + Kibana), dar această stivă a devenit învechită din cauza lui Logstash, care nu este prea performant și consumă multe resurse. În locul său, a început să fie utilizat agentul mai ușor și mai performant Fluentd, iar după un timp acesta a fost ajutat de — un agent de colectare și mai ușor și și mai performant.
Dacă este să credem dezvoltatorii, Fluent Bit este de peste 100 de ori mai performant decât Fluentd: „acolo unde Fluentd consumă 20 MB de RAM, Fluent Bit va consuma 150 KB” — citat direct din documentație. Având în vedere acest lucru, Fluent Bit este utilizat mai frecvent.
Fluent Bit are mai puține funcționalități decât Fluentd, dar acoperă cerințele de bază, așa că noi folosim de obicei Fluent Bit.
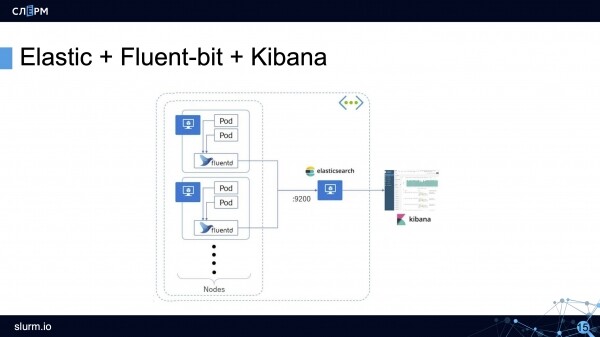
Schema de lucru a stivei EFK: agentul colectează jurnalele din toate podurile (de obicei, un DaemonSet care rulează pe toate serverele clusterului) și le trimite în stocare (Elasticsearch, PostgreSQL sau Kafka). Kibana se conectează la stocare și extrage toate informațiile necesare.
oferă informațiile într-o interfață web convenabilă. Există grafice, filtre și multe altele.
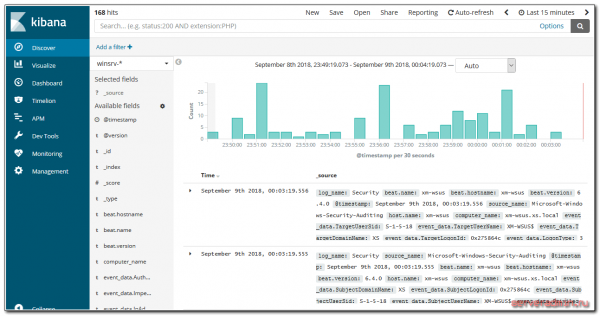
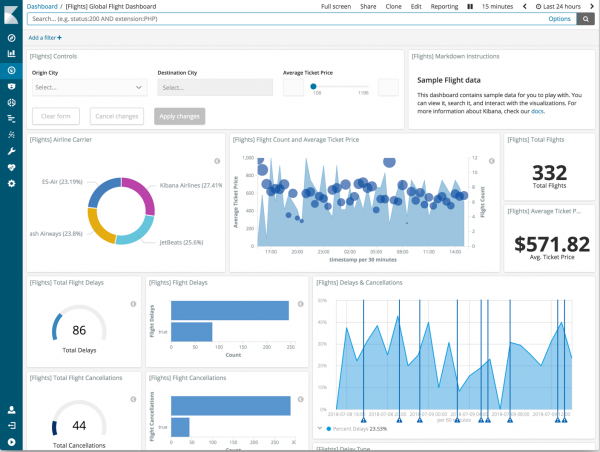
Din jurnale se pot crea tablouri de bord complete.
Funcționalitățile Fluent Bit
Deoarece despre Fluent Bit, în general, s-a auzit mai puțin decât despre Logstash, să-l examinăm un pic mai în detaliu. Fluent Bit poate fi logic împărțit în 6 module, unele dintre module pot avea pluginuri care extind funcționalitățile Fluent Bit.
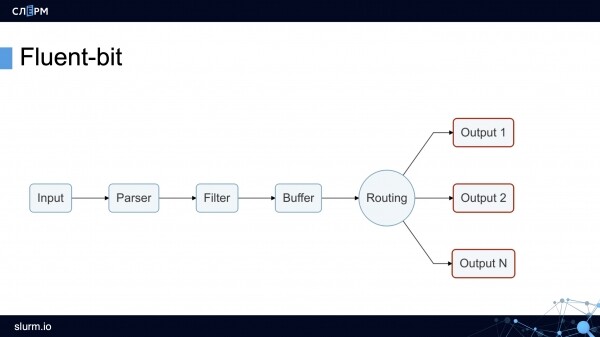
Modul Input colectează jurnale din fișiere, servicii systemd și chiar din tcp-socket (trebuie doar să specifici endpoint-ul, iar Fluent Bit va începe să acceseze acea adresă). Aceste funcționalități sunt suficiente pentru a colecta jurnale atât din sistem, cât și din containere.
În producție, de obicei, folosim pluginuri (poate fi direcționat către un folder cu jurnale) și (îi poți spune din ce servicii să adune jurnale).
Modul Parser transformă jurnalele într-un format comun. În mod implicit, jurnalele Nginx sunt reprezentate ca un șir de caractere. Cu ajutorul pluginului, acest șir poate fi transformat în JSON: se pot specifica câmpuri și valorile acestora. Lucrul cu JSON este mult mai simplu decât cu un jurnal în format de șir de caractere, deoarece există opțiuni mai flexibile de sortare.
Modul Filter. La acest nivel sunt eliminat jurnalele nedorite. De exemplu, pentru stocare sunt trimise doar jurnalele cu valoarea „warning” sau cu anumite etichete. Jurnalele selectate ajung în buffer.
Modul Buffer. Fluent Bit are două tipuri de buffer: buffer în memorie și buffer pe disc. Buffer-ul este un spațiu de stocare temporar pentru jurnalele de logare, necesar în caz de erori sau defecțiuni. Toată lumea vrea să economisească pe RAM, așa că de obicei se aleg buffer-ele pe disc. Dar trebuie avut în vedere că jurnalele sunt totuși descărcate în memorie înainte de a fi scrise pe disc.
Modulul Routing/Output conține reguli și adrese pentru trimiterea jurnalelor. Așa cum am menționat, jurnalele pot fi trimise în Elasticsearch, PostgreSQL sau, de exemplu, Kafka.
Interesant este că din Fluent Bit jurnalele pot fi trimise în Fluentd. Fiindcă primul este mai ușor și mai puțin funcțional, prin el se pot colecta jurnalele și trimite în Fluentd, iar acolo, folosind pluginuri suplimentare, ele pot fi procesate și trimise în stocări.
Dacă plănuiți să folosiți Elasticsearch…
În final, două sfaturi pentru cei care plănuiesc să folosească Elasticsearch ca stocare de jurnale în producție.
- Configurați alerte folosind . Acest program extrage din fluxul general de jurnale mesajele importante și face alerte pe mail sau în alt canal. Totuși, nu cu mult timp în urmă a apărut .
- Rotunjiți jurnalele folosind aplicația sau apelând API-ul Elasticsearch. Elastic, în principiu, face acum pași semnificativi în gestionarea vieții indexurilor fără a folosi instrumente externe. În general, nu are nici un sens să păstrați jurnalele mult timp: este puțin probabil ca un jurnal să fie necesar după două săptămâni — dacă este cu adevărat critic, în două săptămâni cu siguranță va fi procesat. În caz extrem, jurnalele vechi pot fi arhivate și trimise undeva pentru stocare pe termen lung. Am auzit despre jurnale speciale care trebuie păstrate prin lege timp de 5 ani. Personal, nu m-am întâlnit cu așa ceva, dar aș trata astfel de informații diferit de jurnalele obișnuite, și poate chiar le-aș păstra separat.
Continuarea urmează...
Autor: Marcel Ibraev, administrator certificat Kubernetes, inginer practicant la compania , speaker și dezvoltator de cursuri .
Sursa: habr.com
