

TL;DR
- Pentru a obține o observabilitate ridicată a containerelor și microserviciilor, a jurnalelor și a metricilor primare este insuficient.
- Pentru o recuperare mai rapidă și pentru a spori reziliența, aplicațiile trebuie să aplice Principiul Observabilității Mari (HOP, High Observability Principle).
- La nivel de aplicație, HOP necesită: jurnalizare adecvată, monitorizare atentă, verificări de disponibilitate și trasabilitate a performanței/trecerilor.
- Ca parte a HOP, utilizați verificări readinessProbe și livenessProbe Kubernetes.
Ce este un Șablon de verificare a disponibilității?
Când proiectați o aplicație critică și cu disponibilitate ridicată, este foarte important să luați în considerare un aspect precum reziliența. O aplicație este considerată rezilientă dacă se recuperează rapid după o defecțiune. O aplicație de tip cloud tipică folosește o arhitectură de microservicii – atunci când fiecare componentă este plasată într-un container separat. Și pentru a vă asigura că aplicația pe k8s este cu disponibilitate ridicată, trebuie să urmați anumite șabloane atunci când proiectați un cluster. Printre acestea se numără Șablonul de verificare a disponibilității. Acesta definește modul în care aplicația comunică k8s despre starea sa de funcționare. Aceasta nu este doar informația despre faptul că pod-ul funcționează, ci și despre modul în care acceptă cererile și răspunde la ele. Cu cât Kubernetes știe mai multe despre disponibilitatea pod-ului, cu atât mai multe decizii inteligente ia în ceea ce privește rutarea traficului și echilibrarea încărcării. Astfel, Principiul Observabilității Mari permite aplicației să răspundă la cereri în mod oportun.
Principiul Observabilității Mari (HOP)
Principiul Observabilității Mari este unul dintre . În arhitectura microserviciilor, serviciile nu îi pasă cum se procesează cererea lor (și acesta este lucrul corect), ci este important cum primesc răspunsuri de la serviciile care le acceptă. De exemplu, pentru autentificarea utilizatorului, un container trimite o cerere HTTP unui alt container, așteptând un răspuns într-un anumit format – și asta este tot. Cererea poate fi procesată de PythonJS, iar răspunsul de Python Flask. Containerele sunt unul pentru celălalt ceea ce sunt cutii negre cu conținut ascuns. Totuși, principiul LOD (Limitare de Operationalitate Deschisă) necesită ca fiecare serviciu să dezvăluie mai multe puncte finale API, care arată cât de funcțional este, precum și starea sa de disponibilitate și reziliență la defecte. Aceste metrice sunt solicitate de Kubernetes pentru a planifica pașii următori în rutare și distribuția încărcăturii.
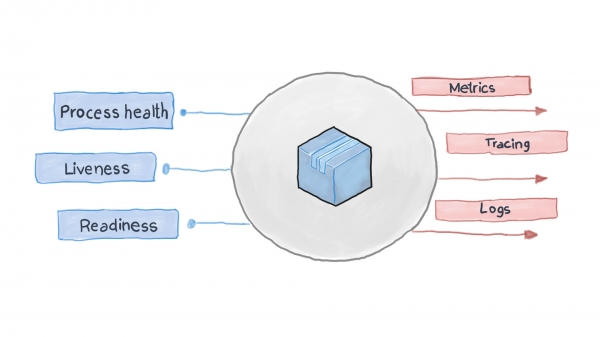
O aplicație cloud bine proiectată își înregistrează evenimentele principale utilizând fluxuri standard de intrare-ieșire STDERR și STDOUT. Apoi, un serviciu auxiliar își face treaba, de exemplu filebeat, logstash sau fluentd, livrând jurnalele într-un sistem de monitorizare centralizat (de exemplu Prometheus) și un sistem de colectare a jurnalelor (un set de software ELK). Schema de mai jos arată cum funcționează aplicația cloud conform Șablonului de Verificare a Funcționalității și Principiului de Înaltă Observabilitate.
Cum se aplică Șablonul de Verificare a Funcționalității în Kubernetes?
Din cutie, k8s monitorizează starea pod-urilor folosind unul dintre controlere (, , , și altele, și altele). Detectând că un pod a picat dintr-un anumit motiv, controlerul încearcă să-l repornească sau să-l reprogrameze pe un alt nod. Totuși, un pod poate raporta că este activ și funcționează, în timp ce de fapt nu funcționează. De exemplu: aplicația dumneavoastră utilizează Apache ca server web, ați instalat componenta pe mai multe pod-uri din cluster. Deoarece biblioteca a fost configurată incorect – toate cererile către aplicație răspund cu codul 500 (eroare internă a serverului). La verificarea livrării, starea pod-urilor dă un rezultat de succes, dar clienții gândesc altceva. Această situație nedorită o vom descrie astfel:
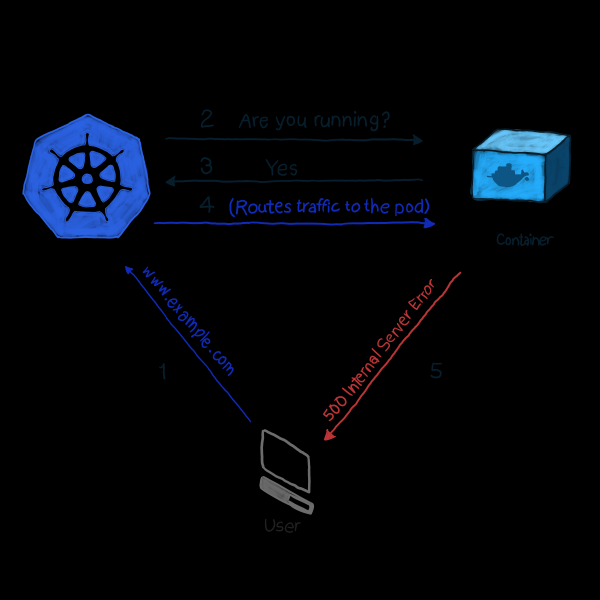
În exemplul nostru, k8s efectuează verificarea funcționalității. În acest tip de verificare, kubelet monitorizează constant starea procesului din container. Dacă detectează că procesul s-a oprit, îl repornește. Dacă o eroare poate fi rezolvată printr-un simplu restart al aplicației, iar programul este proiectat să se oprească la orice eroare, atunci pentru a urma NORN și șablonul verificării stării, este suficient să verificați starea procesului. Este păcat doar că nu toate erorile pot fi rezolvate printr-un restart. În acest caz, k8s oferă două metode mai profunde de diagnosticare a problemelor în funcționarea pod-ului: și .
LivenessProbe
În timp ce livenessProbe kubelet efectuează trei tipuri de verificări: nu doar stabilește dacă pod-ul funcționează, ci și dacă este pregătit să primească și să răspundă adecvat la cereri:
- Se stabilește un request HTTP către pod. Răspunsul trebuie să conțină un cod HTTP în intervalul 200-399. Astfel, codurile 5xx și 4xx semnalizează că pod-ul are probleme, chiar dacă procesul funcționează.
- Pentru verificarea pod-urilor cu servicii non-HTTP (de exemplu, serverul de e-mail Postfix), este necesară stabilirea unei conexiuni TCP.
- Executarea unei comenzi arbitrare pentru pod (intern). Verificarea este considerată reușită dacă codul de ieșire al comenzii este 0.
Un exemplu despre cum funcționează. Definiția următorului pod conține o aplicație NodeJS, care returnează o eroare 500 la cererile HTTP. Pentru a ne asigura că containerul este repornit după primirea unei astfel de erori, folosim parametrul livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Aceasta nu diferă de orice altă definiție a unui pod, dar adăugăm obiectul .spec.containers.livenessProbe. Parametrul httpGet care primește calea pe care trimite un request HTTP GET (în exemplul nostru, aceasta este /, dar în scenarii de producție poate fi și altceva, cum ar fi /api/v1/status). De asemenea, livenessProbe primește parametrul initialDelaySeconds, care dictează operațiunilor de verificare să aștepte un număr specificat de secunde. Întârzierea este necesară deoarece containerului îi trebuie timp pentru a se porni, iar la repornire va fi inaccesibil pentru o perioadă de timp.
Pentru a aplica această configurație în cluster, utilizați:
kubectl apply -f pod.yamlDupă câteva secunde, puteți verifica conținutul pod-ului folosind următoarea comandă:
kubectl describe pods node500La finalul ieșirii, căutați .
După cum puteți vedea, livenessProbe a inițiat o cerere HTTP GET, iar containerul a returnat o eroare 500 (exact așa cum a fost programat), kubelet l-a repornit.
Dacă sunteți curios cum a fost programată aplicația NideJS, iată fișierul app.js și Dockerfile-ul utilizate:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Am întâmpinat o eroaren");
});

server.listen(3000, function() {
    console.log('Serverul rulează pe portul 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Este important să reținem următoarele: livenessProbe va reporni containerul doar în cazul unei defecțiuni. Dacă repornirea nu rezolvă eroarea care împiedică funcționarea containerului, kubelet nu va putea lua măsuri pentru a remedia problema.
readinessProbe
readinessProbe funcționează similar cu livenessProbe (cereri GET, conexiuni TCP și execuția comenzilor), cu excepția măsurilor de remediere a defecțiunilor. Containerul în care a fost detectată o eroare nu va fi repornit, ci izolat de traficul venit. Imaginați-vă că unul dintre containere efectuează multe calcule sau este supus unei sarcini foarte mari, ceea ce duce la creșterea timpului de răspuns la cereri. În cazul livenessProbe, va fi efectuat un test de disponibilitate a răspunsului (prin parametrul de testare timeoutSeconds), după care kubelet va reporni containerul. La repornire, containerul începe să execute sarcini consumatoare de resurse și va fi din nou repornit. Acest lucru poate fi critic pentru aplicațiile care necesită un timp rapid de răspuns. De exemplu, o mașină aflată în mișcare așteaptă un răspuns de la server, iar răspunsul întârzâie - și mașina se accidentează.
Să scriem o definiție pentru readinessProbe, care va seta timpul de răspuns pentru cererea GET la maximum două secunde, iar aplicația va răspunde la cererea GET după 5 secunde. Fișierul pod.yaml ar trebui să arate astfel:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Să desfășurăm pod-ul cu kubectl:
kubectl apply -f pod.yamlSă așteptăm câteva secunde și apoi să vedem cum a funcționat readinessProbe:
kubectl describe pods nodedelayedLa sfârșitul ieșirii, putem observa că o parte din evenimente sunt similare .
După cum puteți vedea, kubectl nu a repornit pod-ul când timpul de verificare a depășit 2 secunde. În schimb, a anulat cererea. Conexiunile de intrare sunt redirecționate către alte pod-uri funcționale.
Observați: acum, când sarcina suplimentară a fost eliminată de pe pod, kubectl redirecționează din nou cererile către acesta: răspunsurile la cererile GET nu mai sunt întârziate.
Pentru comparație: mai jos este fișierul app.js modificat:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server is running at 3000')
})
TL;DR
Înainte de apariția aplicațiilor cloud, principalele instrumente de monitorizare și verificare a stării aplicațiilor erau jurnalele. Totuși, nu existau instrumente pentru a lua măsuri de remediere. Jurnalele sunt încă utile astăzi și trebuie colectate și trimise în sistemul de colectare a jurnalelor pentru analizarea incidentelor și luarea deciziilor. [aceasta putea fi realizată și fără aplicații cloud, de exemplu, cu ajutorul monit, dar cu k8s a devenit mult mai simplu 🙂 – nota red. ]
Astăzi, corectările trebuie făcute aproape în timp real, așa că aplicațiile nu mai trebuie să fie cutii negre. Nu, ele trebuie să arate punctele finale care permit sistemelor de monitorizare să solicite și să colecteze date valoroase despre starea proceselor, astfel încât să reacționeze instantaneu, dacă este necesar. Acest lucru se numește Șablon de proiectare pentru verificarea funcționalității, care urmează Principiul observației ridicate (NOR).
Kubernetes oferă în mod implicit 2 tipuri de verificări ale stării: readinessProbe și livenessProbe. Ambele utilizează aceleași tipuri de verificări (cereri HTTP GET, conexiuni TCP și execuția de comenzi). Se deosebesc prin deciziile pe care le iau în răspuns la defecțiunile din pod-uri. livenessProbe repornește containerul cu speranța că eroarea nu se va mai repeta, în timp ce readinessProbe izolează pod-ul de traficul entrant – până la remedierea cauzei problemei.
Un design corect al aplicației ar trebui să includă ambele tipuri de verificări și să colecteze suficiente date, în special atunci când apare o situație excepțională. De asemenea, ar trebui să arate punctele finale API necesare, care transmit sistemului de monitorizare (aceluiași Prometheus) metrice importante ale stării de funcționalitate.
Sursa: habr.com
