

Un aspect important în funcționarea sistemelor distribuite este gestionarea defectelor. Kubernetes ajută în acest sens, utilizând controloare care monitorizează starea sistemului dvs. și repornește serviciile care nu mai funcționează. Cu toate acestea, Kubernetes poate opri forțat funcționarea aplicațiilor dvs. pentru a asigura viabilitatea generală a sistemului. În această serie, vom examina cum putem ajuta Kubernetes să își îndeplinească sarcinile mai eficient și să reducă timpul de nefuncționare al aplicațiilor.
Înainte de a începe utilizarea containerelor, majoritatea aplicațiilor funcționau pe mașini virtuale sau fizice. Dacă o aplicație se blocase sau dădea o eroare, era necesar mult timp pentru a opri sarcina în execuție și pentru a relansa programul. În cel mai rău caz, cineva trebuia să rezolve această problemă manual noaptea, la ore necorespunzătoare. Dacă o sarcină importantă era efectuată de doar 1-2 mașini de lucru, o astfel de defecțiune era complet inacceptabilă.
De aceea, în loc de o repornire manuală, s-a început utilizarea monitorizării la nivel de procese pentru a reporni automat aplicația în caz de închidere neașteptată. Dacă programul s-a defectat, procesul de monitorizare captează codul de ieșire și repornește serverul. Odată cu apariția unor sisteme precum Kubernetes, acest tip de reacție la defectele sistemului a fost pur și simplu integrat în infrastructură.
Kubernetes folosește un ciclu de evenimente de tip „observare – înregistrare a diferențelor – acțiune” pentru a se asigura că resursele rămân funcționale pe parcursul tranziției din containere către nodurile propriu-zise.
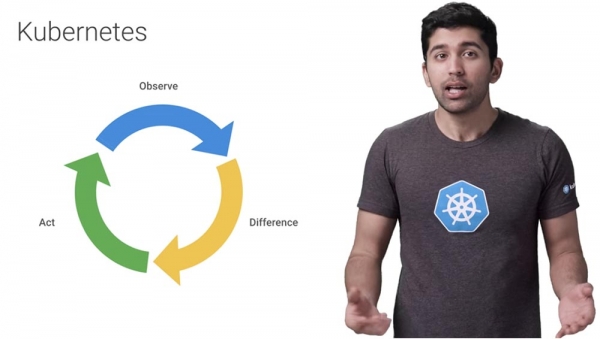
Aceasta înseamnă că nu mai trebuie să rulați manual monitorizarea proceselor. Dacă un resource nu trece testul de sănătate, Kubernetes îi va oferi pur și simplu un înlocuitor automat. În plus, Kubernetes face mult mai mult decât să monitorizeze defecțiunile aplicațiilor dvs. El poate crea mai multe copii ale aplicației pentru a funcționa pe mai multe mașini, poate actualiza aplicația sau poate rula simultan mai multe versiuni ale aplicației dvs.
Există multe motive pentru care Kubernetes poate întrerupe funcționarea unui container sănătos. De exemplu, dacă actualizați desfășurarea, Kubernetes va opri treptat podurile vechi, în timp ce pornește noi. Dacă dezactivați un nod, Kubernetes va opri toate podurile de pe acel nod. În cele din urmă, dacă un nod rămâne fără resurse, Kubernetes va opri toate podurile pentru a elibera aceste resurse.
De aceea, este foarte important ca aplicația dumneavoastră să se oprească cu un impact minim asupra utilizatorului final și cu un timp de recuperare cât mai mic. Aceasta înseamnă că, înainte de a se opri, trebuie să salveze toate datele necesare, să închidă toate conexiunile de rețea, să finalizeze toate sarcinile restante și să reușească să efectueze alte sarcini urgente.
În practică, aceasta înseamnă că aplicația dumneavoastră trebuie să fie capabilă să gestioneze mesajul SIGTERM – semnalul de terminare a procesului, care este semnalul implicit pentru utilitarul kill în sistemele de operare din familia Unix. La primirea acestui mesaj, aplicația ar trebui să se oprească.
După ce Kubernetes a decis să finalizeze un pod, are loc o serie de evenimente. Să examinăm fiecare pas pe care îl face Kubernetes atunci când oprește un container sau un pod.
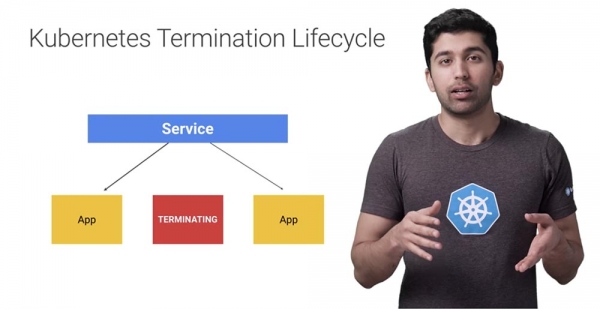
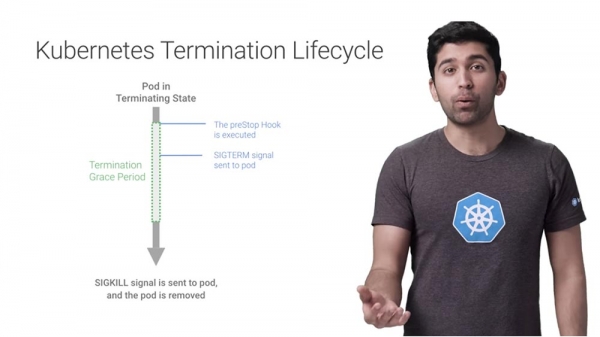
Să presupunem că dorim să finalizăm unul dintre poduri. În acest moment, acesta va înceta să primească trafic nou – containerele funcționale din pod nu vor fi afectate, dar tot traficul nou va fi blocat.
Să analizăm hook-ul preStop – acesta este un comandă specială sau o solicitare HTTP trimisă containerelor din pod. Dacă aplicația dumneavoastră nu se închide corect la primirea SIGTERM, puteți folosi preStop pentru a finaliza corect funcționarea.
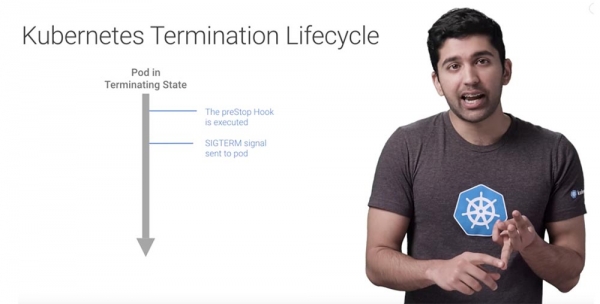
Cele mai multe programe se închid corect la primirea semnalului SIGTERM, dar dacă utilizați cod terț sau un sistem pe care nu-l puteți controla complet, hook-ul preStop oferă o modalitate excelentă de a apela o oprire elegantă fără a modifica aplicația.
După executarea acestui hook, Kubernetes va trimite containerelor din pod un semnal SIGTERM, care le va informa că vor fi deconectate în curând. La primirea acestui semnal, codul dumneavoastră va trece la procesul de deconectare. Acest proces poate include oprirea oricăror conexiuni de lungă durată, cum ar fi legătura cu baza de date sau fluxurile WebSocket, salvarea stării curente și altele.
Chiar dacă utilizați hook-ul preStop, este foarte important să verificați ce se întâmplă cu aplicația dumneavoastră atunci când îi trimiteți semnalul SIGTERM, cum se comportă, pentru a evita evenimentele sau modificările în funcționarea sistemului cauzate de oprirea podului.
În acest moment, înainte de a lua măsuri ulterioare, Kubernetes va aștepta o perioadă specificată, denumită terminationGracePeriodSecond, sau perioada pentru deconectare corectă la primirea semnalului SIGTERM.
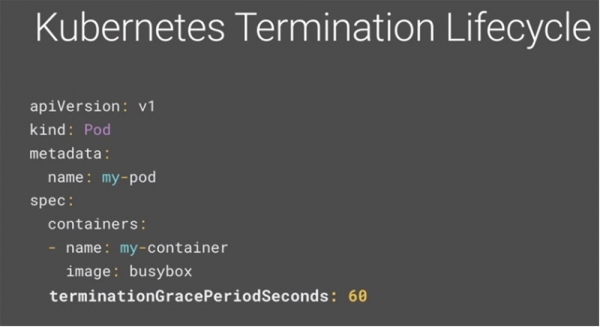
În mod implicit, această perioadă este de 30 de secunde. Este important de subliniat că aceasta se desfășoară în paralel cu hook-ul preStop și semnalul SIGTERM. Kubernetes nu va aștepta finalizarea hook-ului preStop și a SIGTERM — dacă aplicația dumneavoastră se încheie înainte de expirarea perioadei de TerminationGracePeriod, Kubernetes va trece imediat la pasul următor. De aceea, verificați ca valoarea acestei perioade în secunde să nu fie mai mică decât timpul necesar pentru deconectarea corectă a podului, iar dacă depășește 30s, creșteți perioada la dimensiunea necesară în YAML. În exemplul dat, acesta este de 60s.
Și în cele din urmă, ultimul pas — dacă containerele continuă să funcționeze după expirarea terminationGracePeriod, acestea vor trimite semnalul SIGKILL și vor fi eliminate forțat. În acest moment, Kubernetes va curăța de asemenea toate celelalte obiecte ale podului.
Kubernetes oprește podurile din mai multe motive, de aceea asigurați-vă că aplicația dumneavoastră se va închide corect în orice situație, pentru a asigura funcționarea stabilă a serviciului.
Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
