

Salut, Habr! Invităm ingineri de date și specialiști în învățare automată la un curs demo gratuit . De asemenea, publicăm un articol de Luca Monno — Șeful Analiticii Financiare la CDP SpA.
Una dintre cele mai utile și simple metode de învățare automată este Învățarea în Ansamblu. Învățarea în Ansamblu este metoda din spatele XGBoost, Bagging-ului, Pădurii Random și a multor altor algoritmi.
Pe Towards Data Science sunt multe articole interesante, dar am ales două povești ( și ), care mi-au plăcut cel mai mult. Atunci, de ce să scriu încă un articol despre EL? Pentru că vreau să vă arăt cum funcționează printr-un exemplu simplu, care mi-a arătat că nu există nici o magie aici.
Când am văzut prima dată EL în acțiune (aplicându-l pe câteva modele de regresie foarte simple) nu-mi venea să cred ochilor, și încă îmi amintesc de profesorul care m-a învățat această metodă.
Aveam două modele diferite (două algoritmi slabi de învățare) cu valori R² out-of-sample de 0,90 și 0,93, respectiv. Înainte de a vedea rezultatul, am crezut că voi obține un R² undeva între cele două valori inițiale. Cu alte cuvinte, am considerat că EL poate fi folosit pentru ca modelul să nu funcționeze mai rău decât cel mai slab, dar nici atât de bine cât ar putea funcționa cel mai bun model.
Cu cea mai mare surprindere, rezultatele mediei simple a predicțiilor au dat un R² de 0,95.
La început, am început să caut o eroare, dar apoi m-am gândit că poate exista o magie ascunsă aici!
Ce este Învățarea în Ansamblu
Cu ajutorul EL se pot combina predicțiile a două sau mai multe modele pentru a obține un model mai fiabil și mai performant. Există multe metodologii pentru lucrul cu ansambluri de modele. Aici voi atinge două dintre cele mai utile, pentru a oferi o imagine generală.
Folosind regresie se pot media valorile modelului existent.
Folosind clasificare modelele pot alege etichetele. Eticheta care a fost aleasă cel mai des – este cea care va fi aleasă de noul model.
De ce EL funcționează mai bine
Principala cauză pentru care EL funcționează mai bine este că fiecare predicție are o eroare (știm asta din teoria probabilităților), combinarea a două predicții poate ajuta la reducerea erorii, îmbunătățind astfel performanța (RMSE, R² etc.).
În următorul grafic se vede cum două algoritmi slabi funcționează cu un set de date. Primul algoritm are o panta mai mare decât ar fi necesar, în timp ce la al doilea este aproape zero (posibil din cauza regularizării excesive). Dar ensemble arată un rezultat mult mai bun.
Dacă ne uităm la indicatorul R², atunci pentru primul și al doilea algoritm de învățare, acesta va fi -0,01¹, 0,22, respectiv, în timp ce pentru ansamblu va fi de 0,73.
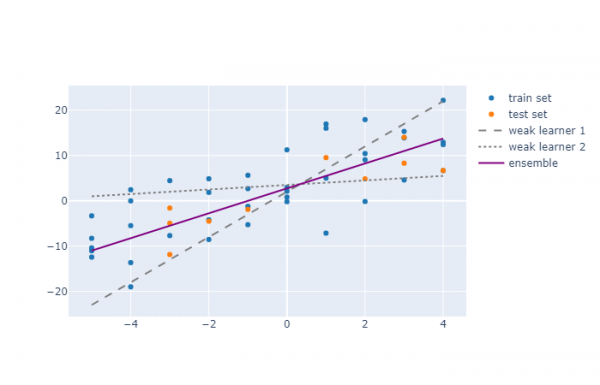
Există multe motive pentru care un algoritm poate fi un model slab, chiar și în acest exemplu de bază: poate ați decis să folosiți regularizarea pentru a evita overfitting-ul sau ați ales să nu excludeți anumite anomalii, sau poate ați utilizat regresia polinomială și ați ales un grad greșit (de exemplu, ați folosit un polinom de gradul doi, iar în datele de testare există o asimetrie evidentă pentru care ar fi fost mai potrivit un grad trei).
Când EL funcționează mai bine
Să examinăm doi algoritmi de învățare care lucrează cu aceleași date.
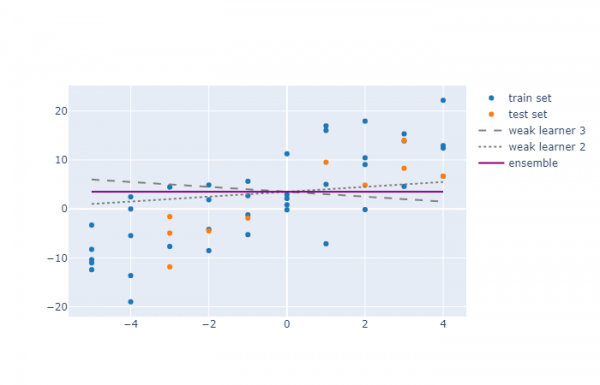
Aici se vede că combinarea celor două modele nu a îmbunătățit semnificativ performanța. Inițial, pentru cei doi algoritmi de învățare, valorile R² erau -0,37 și 0,22, respectiv, iar pentru ansamblu a ieșit -0,04. Deci, modelul EL a obținut o valoare medie a indicatorilor.
Cu toate acestea, între aceste două exemple există o mare diferență: în primul exemplu, erorile modelelor erau corelate negativ, iar în al doilea – pozitiv (coeficientii celor trei modele nu au fost evaluați, ci pur și simplu au fost aleși de autor ca exemplu).
Prin urmare, Învațarea prin Ansamblu poate fi utilizată pentru a îmbunătăți echilibrul dintre bias și varianță în orice caz, dar când erorile modelelor nu sunt corelate pozitiv, utilizarea EL poate duce la o creștere a performanței.
Modele omogene și eterogene
Adesea, EL este folosit în modele omogene (ca în acest exemplu sau în pădurea aleatorie), dar de fapt puteți combina diferite modele (regresie liniară + rețea neurală + XGBoost) cu seturi diferite de variabile explicative. Cel mai probabil, aceasta va duce la erori necorelate și o îmbunătățire a performanței.
Compararea cu diversificarea portofoliului
EL funcționează prin analogie cu diversificarea din teoria portofoliului, dar este cu atât mai bine pentru noi.
Atunci când diversificați, încercați să reduceți dispersia indicatorilor voștri, investind în acțiuni necorelate. Un portofoliu de acțiuni bine diversificat va oferi un rezultat mai bun decât cea mai slabă acțiune individuală, dar niciodată mai bun decât cea mai bună.
Citat din Warren Buffett:
„Diversificarea este o protecție împotriva ignoranței; pentru cei care nu știu ce fac, ea [diversificarea] are foarte puțin sens.”
În învățarea automată, EL ajută la reducerea dispersiei modelului vostru, dar acest lucru poate conduce la crearea unui model cu o performanță generală mai bună decât cea mai bună model inițial.
Să rezumăm
Combinarea mai multor modele într-unul este o metodă relativ simplă care poate conduce la soluționarea problemei bias-variance și la îmbunătățirea performanței.
Dacă aveți două sau mai multe modele care funcționează bine, nu alegeți între ele: folosiți-le pe toate (dar cu prudență)!
Interesat să dezvoltați în această direcție? Înscrieți-vă pentru un demo gratuit și participați la — Inginer de Machine Learning la Mail.ru Group.
Sursa: habr.com
