

Raportul prezintă câteva abordări care permit monitorizarea performanței interogărilor SQL, atunci când sunt milioane pe zi, iar serverele PostgreSQL controlate sunt sute.
Ce soluții tehnice ne permit să gestionăm eficient un astfel de volum de informații și cum le facilitează viața dezvoltatorului obișnuit.
Cui îi interesează analiza problemelor specifice și diferite tehnici de optimizare a interogărilor SQL și soluționarea problemelor tipice ale DBA-urilor în PostgreSQL - pot de asemenea pe această temă.
Mă numesc Kirill Borovikov, reprezint . Concret, mă specializ în gestionarea bazelor de date în cadrul companiei noastre.
Astăzi vă voi povesti despre cum ne ocupăm cu optimizarea interogărilor, atunci când trebuie să rezolvăm nu doar performanța unui singur interogare, ci să abordăm problema în masă. Când sunt milioane de interogări și trebuie să găsiți niște abordări pentru soluționarea aceastei mari probleme.
În general, „Tensor” pentru milioanele noastre de clienți este : rețea socială corporativă, soluții pentru videoconferințe, pentru gestionarea documentelor interne și externe, sisteme de contabilitate și de gestiune a stocurilor,... Adică un „mega-combiner” pentru managementul complex al afacerilor, care cuprinde peste 100 de proiecte interne diferite.
Pentru ca toate acestea să funcționeze și să se dezvolte normal - avem 10 centre de dezvoltare în întreaga țară, în care sunt mai mult de 1000 de dezvoltatori.
Colaborăm cu PostgreSQL din 2008 și am acumulat un volum mare de ceea ce procesăm - acestea sunt datele clienților, statisticele, analizele, datele din sistemele externe de informații - peste 400TB. Numai în „produție” sunt aproximativ 250 de servere, iar totalul serverelor de baze de date pe care le monitorizăm - aproximativ 1000.
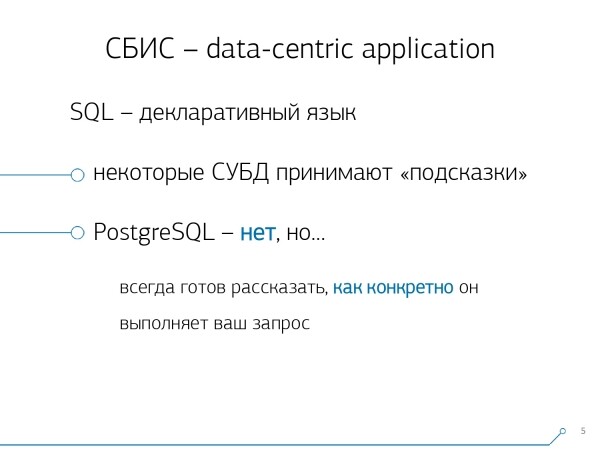
SQL este un limbaj declarațional. Descrieți nu „cum” ar trebui să funcționeze ceva, ci „ce” doriți să obțineți. SGBD-ul știe mai bine cum să facă JOIN - cum să unească tabelele dvs., ce condiții să impună, ce va merge pe index, ce nu...
Unele SGBD acceptă sugestii: „Nu, acestea două tabele trebuie conectate într-o anumită ordine”, dar PostgreSQL nu face așa. Aceasta este o poziție conștientă a principalelor dezvoltatori: „Mai bine îmbunătățim optimizatorul de interogări, decât să permitem dezvoltatorilor să folosească anumite sugestii.”
Dar, cu toate că PostgreSQL nu permite gestionarea sa "din exterior", acesta oferă o excelentă oportunitate de a vedea ce se întâmplă "în interior", atunci când executați interogarea dvs. și unde apar problemele.
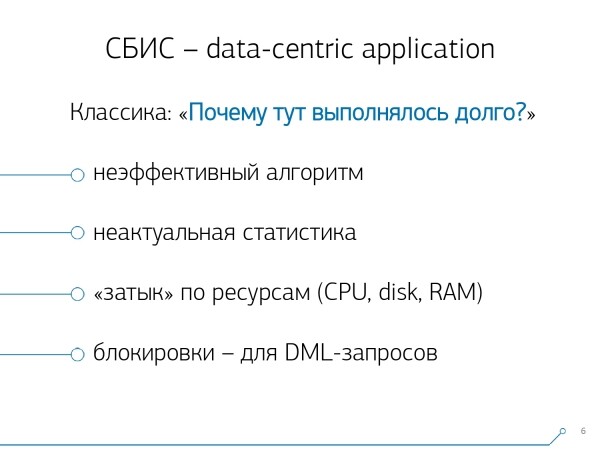
În general, cu ce probleme clasice se confruntă dezvoltatorul [la DBA] de obicei? „Am executat o interogare și totul este lent, totul se blochează, se întâmplă ceva… E o tragedie!”
Cauzele sunt de obicei aceleași:
- algoritmul interogării este ineficient
Dezvoltatorul: „Acum am 10 tabele în SQL prin JOIN…" – și se așteaptă ca condițiile lui să se „rezolve” miraculos, iar el să obțină totul rapid. Dar nu există miracole, și orice sistem, având o astfel de variabilitate (10 tabele într-un FROM), va genera întotdeauna o marjă de eroare. [] - statistici neactualizate
Acest moment este foarte relevant pentru PostgreSQL, atunci când ați "importat" un set mare de date pe server, faceți o interogare – și acesta "scanează secvențial" tabela. Deoarece ieri avea 10 înregistrări, iar astăzi 10 milioane, dar PostgreSQL nu este încă la curent, și trebuie să-i sugerați acest lucru. [] - întreruperi de resurse
Ați pus o bază de date mare și grea pe un server slab, care nu are suficient spațiu pe disc, memorie, sau performanță a procesorului. Și aceasta e tot… Există un plafon de performanță, deasupra căruia nu mai puteți sări. - blocaje
Un moment complex, dar acestea sunt cele mai relevante pentru diferite interogări de modificare (INSERT, UPDATE, DELETE) – este o temă separată, mai amplă.
Obținerea planului
… Și pentru tot restul avem nevoie de un plan! Trebuie să vedem ce se întâmplă în interiorul serverului.
Planul de execuție a interogării pentru PostgreSQL este un arbore al algoritmului de execuție a interogării, în reprezentare text. Acest algoritm a fost declarat cel mai eficient în urma analizei făcute de planner.
Fiecare nod din arbore este o operațiune: extragerea datelor din tabelă sau index, construirea unei hărți bitwise, unirea a două tabele, combinarea, intersectarea sau excluderea selecțiilor. Execuția interogării este parcurgerea nodurilor acestui arbore.
Pentru a obține planul interogării, cea mai simplă metodă este să executați operatorul EXPLAIN. Pentru a-l obține cu toate atributele reale, adică pentru a executa de fapt interogarea pe baza – EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Un moment prost: atunci când îl executați, se întâmplă „aici și acum”, așa că este potrivit doar pentru depanarea locală. Dacă luați însă un server foarte solicitat, care se află sub un flux puternic de modificări ale datelor, și vedeți: „Ah! Aici avem un request lent.se execută.” Cu o jumătate de oră, o oră în urmă — în timp ce colindați și extrăgeți acest request din loguri, ducându-l din nou pe server, întregul set de date și statistica s-au schimbat. Îl executați pentru a depana — iar acesta se execută repede! Și nu puteți înțelege „de ce”, de ce să aibă lent.
Pentru a înțelege ce s-a întâmplat exact în momentul în care requestul se execută pe server, oameni inteligenți au scris . Acesta este prezent practic în toate cele mai comune distribuții PostgreSQL și poate fi activat simplu în fișierul de configurare.
Dacă înțelege că un request se execută mai mult decât limita pe care i-ați setat-o, face o „captură” a planului acestui request și scrie totul împreună în log.
Se pare că totul e bine acum, mergem în log și vedem acolo… [o porțiune de text]. Dar nu putem spune nimic despre acesta, în afară de faptul că este un plan excelent, deoarece s-a executat în 11ms.
Părea totul bine — dar nu se înțelege nimic, ce s-a întâmplat de fapt. În afară de timpul total, nu vedem nimic special. Pentru că a privi o astfel de „latuhă” în text simplu nu este deloc ușor.
Dar chiar și să fie greu de privit, să fie incomod, există probleme mai fundamentale:
- În nod este indicată suma resurselor întregului subarbore din jur. Adică pur și simplu nu putem ști cât timp a fost cheltuit pe acest Index Scan — dacă sub el există vreo condiție înfășurată. Trebuie să ne uităm dinamic, să vedem dacă există „ copii” și variabile condiționale, CTE — și să scădem totul „în minte”.
- Al doilea punct: timpul indicat în nod este timpul de execuție singular al nodului.Dacă acest nod a fost executat ca urmare, de exemplu, a unei bucle peste înregistrările din tabel, de mai multe ori, în plan crește numărul de loops — ciclurile acestui nod. Dar timpul atomic de execuție rămâne același în plan. Așadar, pentru a înțelege cât de mult a fost executat acest nod în total, trebuie să înmulțim unul cu celălalt — din nou „în minte”.
În aceste condiții, a înțelege „Cine este cea mai slabă verigă?” este practic imposibil. De aceea, chiar și dezvoltatorii spun în „manual” că „Înțelegerea planului este o artă pe care trebuie să o înveți, o experiență…”.
Dar avem 1000 de dezvoltatori și nu poți transmite această experiență fiecăruia. Eu, tu, el — știm, dar cineva de acolo — nu știe deja. Poate că va învăța, poate că nu, dar trebuie să lucreze acum — de unde ar putea obține această experiență.
Vizualizarea planului
De aceea, am realizat că, pentru a înțelege aceste probleme, avem nevoie de o bună vizualizare a planului.
Am început prin a căuta pe „piață” — haideți să căutăm pe internet ce există, de fapt.
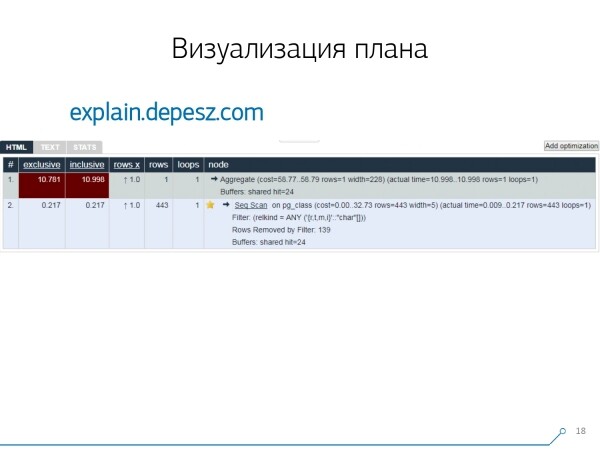
Dar s-a dovedit că există foarte puține soluții „viabile”, care să evolueze mai mult sau mai puțin — literal, una singură: de Hubert Lubaczewski. La intrare, în câmp, „îi dai” o reprezentare textuală a planului, iar el îți arată un tabel cu datele analizate:
- timpul propriu de procesare al nodului
- timpul total pe întreg subarborele
- numărul de înregistrări care a fost extras și care era așteptat statistic
- corpului nodului în sine
De asemenea, acest serviciu are opțiunea de a împărtăși arhiva de linkuri. Ai dus planul tău acolo și spui: „Hei, Vasia, iată-ți un link, ceva nu este în regulă”.
Dar există și câteva probleme minore.
În primul rând, o cantitate imensă de „copy-paste”. Ieși un fragment din log, îl bagi acolo, și din nou, și din nou.
În al doilea rând, nu există o analiză a cantității de date citite — aceleași buffers, pe care le afișează EXPLAIN (ANALYZE, BUFFERS), aici nu vedem. El pur și simplu nu știe să le analizeze, să le înțeleagă și să lucreze cu ele. Când citești multe date și înțelegi că s-ar putea să nu te „așezi” corect pe disc și în cache-ul de memorie, această informație este foarte importantă.
Al treilea aspect negativ — dezvoltarea foarte slabă a acestui proiect. Commits foarte mici, bine dacă o dată la jumătate de an, și codul este scris în Perl.
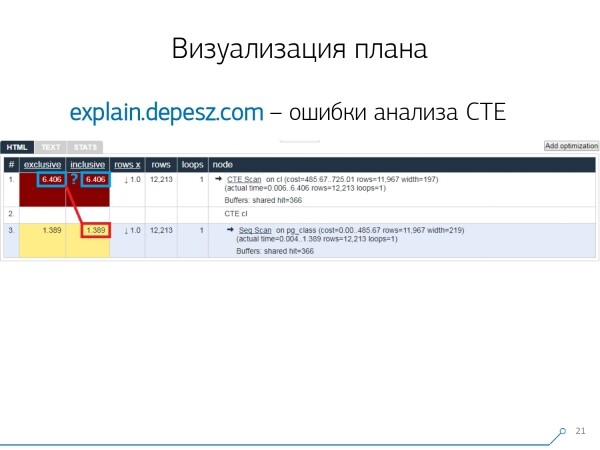
Dar acestea sunt toate „lirice”, cu care am putea cumva trăi, dar există un lucru care ne-a îndepărtat foarte mult de acest serviciu. Acestea sunt erori în analiza Common Table Expression (CTE) și a diferitelor noduri dinamice, cum ar fi InitPlan/SubPlan.
Dacă dăm crezare acestei imagini, timpul total de execuție al fiecărui nod individual este mai mare decât timpul total de execuție al întregului interogări. Foarte simplu — nu s-a scăzut timpul de generare a acestui CTE din nodul CTE Scan.. Așadar, nu mai știm răspunsul corect, cât a durat scanarea CTE.
Aici am înțeles că este timpul să scriem ceva de-ale noastre — ura-ura! Fiecare dezvoltator spune: „Acum vom scrie noi, va fi foarte simplu!”
Am ales un stivă tipică pentru servicii web: nucleul pe Node.js + Express, am integrat Bootstrap și pentru graficele frumoase — D3.js. Și așteptările noastre s-au dovedit a fi justificate — primul prototip l-am obținut în 2 săptămâni:
- parserul propriu al planului
Adică acum putem analiza orice plan generat de PostgreSQL. - analiza corectă a nodurilor dinamice — CTE Scan, InitPlan, SubPlan
- analiza distribuției buffer-elor — unde sunt citite paginile de date din memorie, unde din cache-ul local, unde de pe disc
- am obținut claritate
Pentru a nu căuta în jurnal tot acest „detaliu”, ci pentru a vedea imediat „punctul slab” într-o imagine.
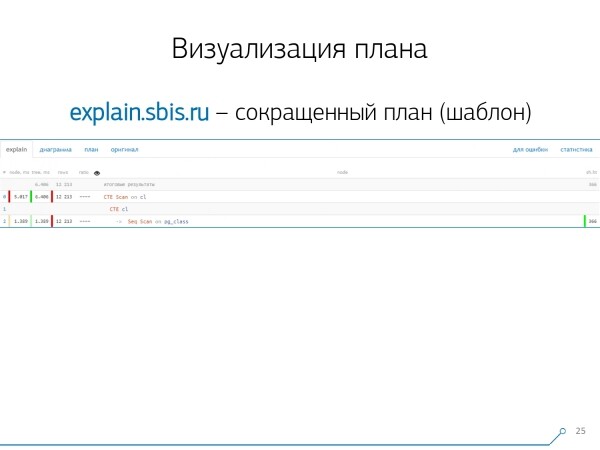
Am obținut o imagine similară — direct cu evidențierea sintaxei. Dar, de obicei, dezvoltatorii noștri lucrează deja fără o reprezentare completă a planului, ci cu un rezumat. Toate cifrele le-am parcurs deja și le-am aruncat în stânga și în dreapta, iar în mijloc am lăsat doar prima linie, care este acel nod: CTE Scan, generarea CTE sau Seq Scan pe o anumită tabelă.
Această reprezentare prescurtată o numim șablonul planului.
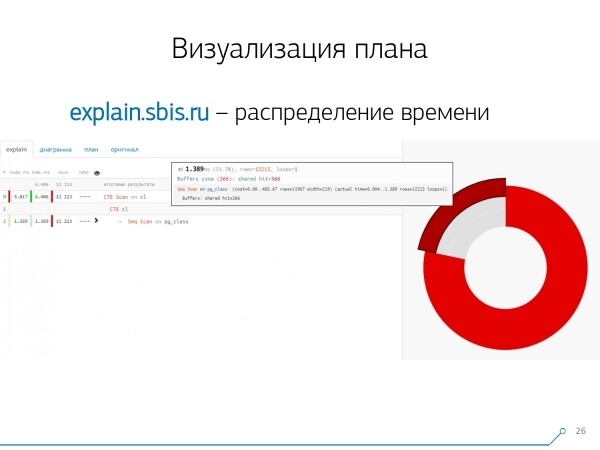
Ce ar mai fi convenabil? Ar fi convenabil să vedem ce proporție din timpul total se alocă pentru fiecare nod — și am „lipit” o parte pe lateral diagramă circulară.
Aducem cursorul pe nod și vedem — se pare că Seq Scan a ocupat mai puțin de un sfert din tot timpul, iar restul de 3/4 a fost ocupat de CTE Scan. Groaznic! Această observație despre „viteza” CTE Scan, dacă le folosiți frecvent în interogările dvs. Ele nu sunt foarte rapide — pierd chiar și în fața scanării obișnuite a tabelei.
Dar, în mod obișnuit, astfel de diagrame sunt mai interesante, mai complexe, când aducem cursorul pe un segment și vedem, de exemplu, că mai mult de jumătate din tot timpul un anumit Seq Scan l-a „consumat”. Și încă avea un Filter în interior, o mulțime de înregistrări fiind respinse prin acesta… Puteți trimite această imagine dezvoltatorului și să spuneți: „Vasile, aici totul este o problemă! Investighează, uită-te — ceva nu este în regulă!”
Desigur, fără „capcane” nu s-a putut.
Primul lucru asupra căruia ne-am axat a fost problema rotunjirii. Timpul nodului fiecărui element din plan este specificat cu o precizie de 1μs. Și atunci când numărul de cicluri al nodului depășește, de exemplu, 1000 — după execuția PostgreSQL, când a fost realizată rotunjirea, în urma calculului invers obținem un timp total «undeva între 0.95ms și 1.05ms». Când se vorbește de microsecunde — nu e mare lucru, dar când ajungem la [miliseunde] — trebuie să avem în vedere această informație atunci când «desfacem» resursele pe nodurile planului «cine a consumat cât».
Al doilea aspect, mai complex, se referă la distribuția resurselor (acelor buffers) pe nodurile dinamice. Aceasta ne-a costat încă vreo 4 săptămâni în primele 2 săptămâni pe prototip.
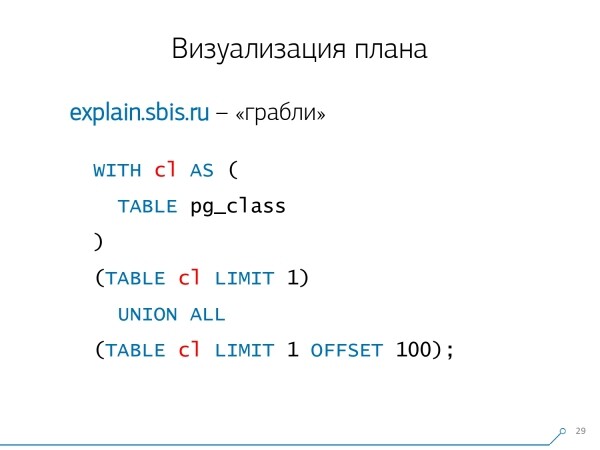
Este destul de simplu să obții o astfel de problemă — facem un CTE și citim aparent ceva în el. De fapt, PostgreSQL este «inteligent» și nu va citi nimic direct de acolo. Apoi luăm prima înregistrare din el, iar la aceasta ne referim la centaiu din același CTE.
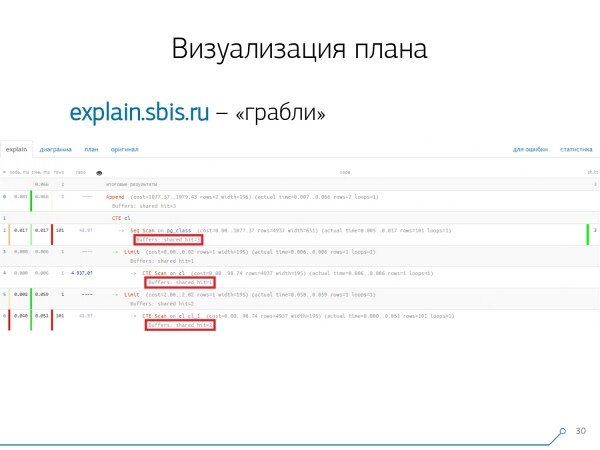
Ne uităm la plan și înțelegem — ciudat, am avut 3 buffers (pagini de date) «consumate» în Seq Scan, încă 1 în CTE Scan, și încă 2 în al doilea CTE Scan. Așadar, dacă le adunăm, obținem 6, dar din tabel am citit doar 3! CTE Scan nu citește nimic din nicăieri, ci lucrează direct cu memoria procesului. Așadar, aici este clar că ceva nu este în regulă!
De fapt, se dovedește că cele 3 pagini de date care au fost solicitate de Seq Scan au fost solicitate mai întâi de primul CTE Scan, iar apoi de al doilea, și au citit încă 2. Așadar, în total au fost citite 3 pagini de date, nu 6.
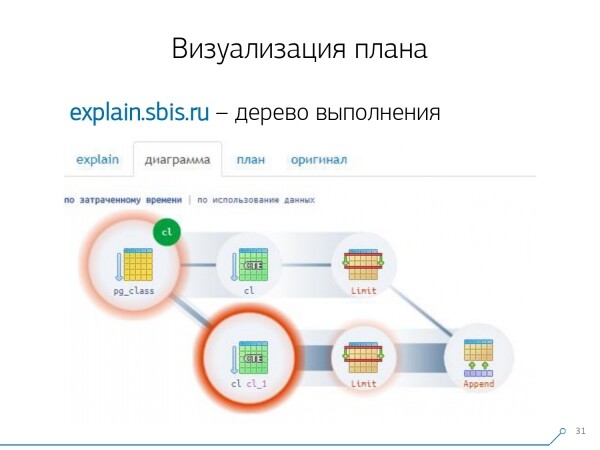
Și această imagine ne-a dus la înțelegerea că execuția planului nu este un arbore, ci pur și simplu un graf aciclic. Și am obținut un diagramă aproximativă, astfel încât să înțelegem «ce de unde a venit». Aici am creat un CTE din pg_class și am solicitat-o de două ori, iar aproape tot timpul am folosit ramura când am solicitat-o a doua oară. Este clar că citirea înregistrării 101 este mult mai scumpă decât citirea primei din tabel.

Am respirat adânc pentru o vreme. Am spus: «Acum, Neo, știi kung-fu! Acum experiența noastră este chiar pe ecranul tău. Acum poți să o folosești.»
Consolidarea logurilor
Cei 1000 de dezvoltatori ai noștri.au respirat ușurați. Dar noi știam că aveam doar câteva sute de servere „de producție” și că tot acest „copy-paste” din partea dezvoltatorilor nu era deloc convenabil. Am realizat că trebuie să ne ocupăm noi de acest lucru.
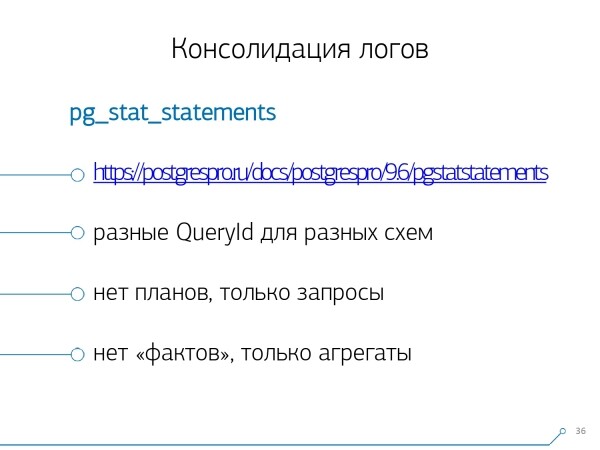
Există de fapt un modul standard care poate colecta statistici, dar trebuie activat în configurație — acesta este . Dar nu ne-a satisfăcut.
În primul rând, același tip de cerere pe diferite scheme în cadrul aceleași baze de date primește QueryId-uri diferite. Asta înseamnă că dacă mai întâi facem SET search_path = '01'; SELECT * FROM user LIMIT 1;, iar apoi SET search_path = '02'; și executăm aceeași cerere, atunci în统计 aceasta vor fi înregistrări diferite, iar eu nu voi putea colecta statistici generale pe baza acestui profil de cerere, fără a lua în considerare schemele.
Al doilea punct care ne-a împiedicat să-l folosim este lipsa planurilor. Adică nu există planul — există doar solicitarea în sine. Vedem ce a fost lent, dar nu înțelegem de ce. Și aici revenim la problema setului de date în continuă schimbare.
Și ultimul punct — lipsa „faptelor”. Adică nu putem face referire la o instanță specifică a execuției cererii — aceasta nu există, există doar statistici agregate. Cu asta putem lucra, dar este foarte complicat.
Așa că am decis să luptăm cu „copy-paste-ul” și am început să scriem un colector..
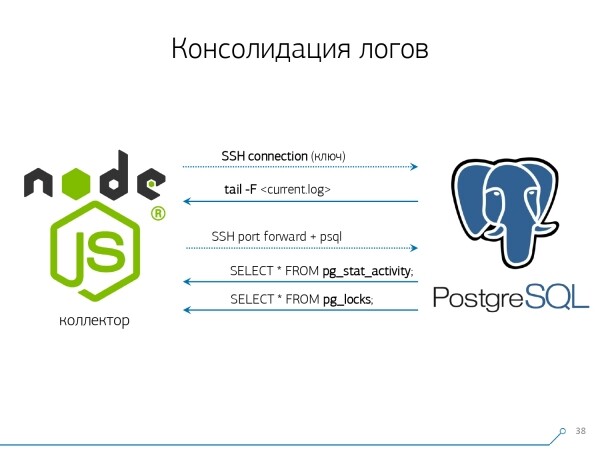
Colectorul se conectează prin SSH, „întinde” o conexiune securizată către serverul cu baza de date folosind un certificat și tail -F se „prinde” de log-ul de fișier. Astfel, în această sesiune obținem un „oglină” completă a întregului log de fișier, pe care serverul îl generează. Sarcina pe serverul în sine este minimă, deoarece nu facem nicio analiză, ci doar mirroring-ul traficului.
Întrucât am început să scriem interfața pe Node.js, am continuat să scriem colectorul pe aceeași platformă. Iar această tehnologie s-a dovedit a fi eficientă, deoarece pentru a lucra cu date textuale slab formatate, cum ar fi log-urile, utilizarea JavaScript este foarte convenabilă. Iar infrastructura Node.js ca platformă backend permite să lucrăm ușor și confortabil cu conexiunile de rețea, dar și în general cu fluxurile de date.
Prin urmare, noi „întindem” două conexiuni: prima, pentru a „asculta” logul în sine și a-l aduce la noi, iar a doua — pentru a întreba periodic baza de date. „Iată, în log a apărut mesajul că a fost blocată tabela cu oid 123”, dar acest lucru nu spune nimic dezvoltatorului, și ar fi bine să întrebăm baza de date „Ce este totuși OID = 123?”. Și astfel între timp întrebăm periodic baza de date despre ce nu știm încă.
„Numai un lucru nu ai luat în considerare, există un tip de albine cu formă de elefant!...” Am început să dezvoltăm acest sistem când voiam să monitorizăm 10 servere. Cele mai critice, în opinia noastră, pe care apăreau anumite probleme, cu care era dificil de lucrat. Însă în primul trimestru am obținut 100 pentru monitorizare — pentru că sistemul a fost „primit”, toată lumea a dorit, era convenabil pentru toată lumea.
Toate acestea trebuie adunate, fluxul de date este mare, activ. Practic, ceea ce monitorizăm, cu ce știm să lucrăm — aceea folosim. Folosim și PostgreSQL ca stocare de date. Nu există nimic mai rapid pentru a „înghiți” date în el decât operatorul. COPIE încă nu avem.
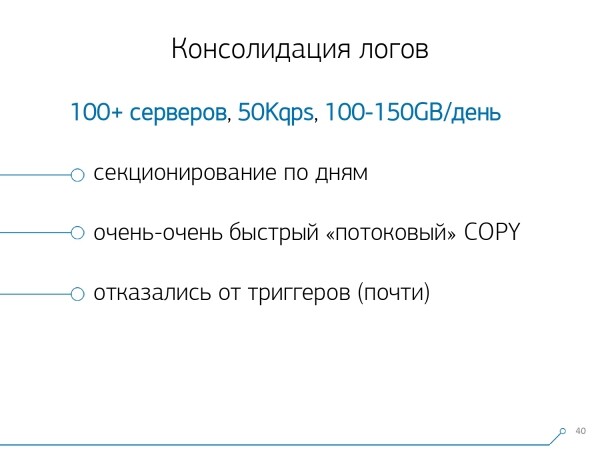
Dar doar să „înghițim” date — nu este exact tehnologia noastră. Pentru că dacă aveți pe 100 de servere aproximativ 50k de cereri pe secundă, atunci asta vă generează 100-150GB de loguri pe zi. Prin urmare, a trebuit să ajustăm cu grijă baza de date.
În primul rând, am făcut partiționare pe zile, pentru că, în mare, pe nimeni nu interesează corelația între zile. Care este diferența ce s-a întâmplat ieri, dacă în noaptea asta ați lansat o nouă versiune a aplicației — și deja aveți o nouă statistică.
În al doilea rând, am învățat (am fost nevoiți să) scriem foarte, foarte repede cu ajutorul COPIE. Adică nu doar COPIE, pentru că este mai rapid decât INSERT, ci chiar mai rapid.
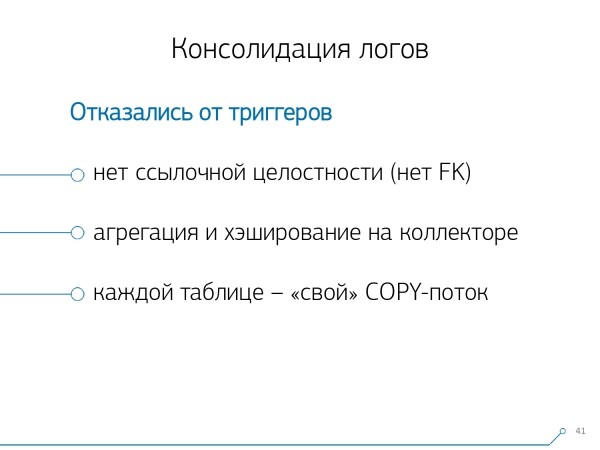
Al treilea aspect — a fost necesar să renunțăm la trigger-uri, și prin urmare, și la Foreign Keys. Adică nu avem deloc integritate referențială. Pentru că, dacă aveți o tabelă care are un cuplu de FK, și spuneți în structura Bazei de Date că „iată, înregistrarea din log se referă prin FK, de exemplu, la un grup de înregistrări”, atunci când o inserați, PostgreSQL nu are altă opțiune decât să execute corect SELECT 1 FROM master_fk1_table WHERE ... cu acel identificator pe care încercați să-l inserați — doar pentru a verifica dacă această înregistrare este acolo, pentru a vă asigura că nu „rupeți” Foreign Key-ul prin inserția dumneavoastră.
Obținem, în loc de un singur înregistrare în tabela țintă și indicii săi, de asemenea, citind din toate tabelele la care se referă. Iar noi nu avem nevoie de asta — sarcina noastră este să scriem cât mai mult și cât mai repede, cu cea mai mică încărcare. Așadar, FK — la revedere!
Următoarea problemă — agregarea și hash-ul. În mod inițial, acestea erau implementate în baza de date — este convenabil să faci cât mai repede o înregistrare într-o anumită tabele. „plus unu” direct în trigger.. Bine, este convenabil, dar este problematic — introduci o înregistrare și ești obligat să citești și să scrii ceva din altă tabelă. Și nu doar că trebuie să citești și să scrii — trebuie să faci asta de fiecare dată.
Acum imaginați-vă că aveți o tabelă în care pur și simplu numărați câte solicitări au trecut printr-un anumit gazduitor: +1, +1, +1, ..., +1. Și, în principiu, nu aveți nevoie de asta — totul poate fi sumat în memorie pe colector și trimis în baza de date dintr-o dată. +10.
Da, în cazul unor probleme, integritatea logică poate fi „deteriorată”, dar este un caz aproape nerealist — pentru că aveți un server normal, cu o baterie în controller, având un jurnal de tranzacții, un jurnal pe sistemul de fișiere… În general, nu merită. Nu merită pierderea de performanță pe care o obțineți din cauza funcționării triggerelor/FK, acele cheltuieli pe care le suportați în acest caz.
Același lucru este valabil și pentru hash. Vine către voi o solicitare, din care calculați în baza de date un anumit identificator, îl scrieți în bază și apoi îl comunicați tuturor. Totul este în regulă, până în momentul în care, în timpul scrierii, vine o a doua persoană care vrea să scrie același lucru — și veți avea o blocare, iar asta deja este problematic. Așadar, dacă puteți genera anumite ID-uri pe client (în raport cu baza de date), este mai bine să faceți asta.
Ne-a mers perfect să folosim MD5 de la text — solicitare, plan, șablon,… Îl calculăm pe partea colectorului, și îl „turnăm” în baza deja cu ID-ul generat. Lungimea MD5 și secționarea zilnică ne permit să nu ne facem griji cu privire la coliziunile posibile.
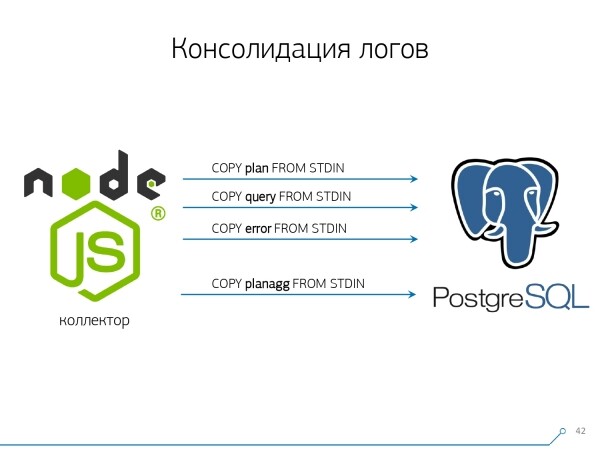
Dar pentru a scrie totul rapid, a trebuit să modificăm însăși procedura de scriere.
Cum se scriu de obicei datele? Avem un anumit set de date, îl împărțim în mai multe tabele, iar apoi folosim COPY — mai întâi în primul, apoi în al doilea, apoi în al treilea... Este incomod, pentru că aparent scriem un singur flux de date în trei etape consecutive. Neplăcut. Se poate face mai repede? Se poate!
Pentru aceasta, este suficient să desfășurăm aceste fluxuri pe paralel unul cu altul. Astfel, apar erori, cereri, șabloane, blocaje… în fluxuri separate — iar noi scriem totul în paralel. Este suficient să menținem permanent deschis un canal COPY pentru fiecare tabel țintă separat.
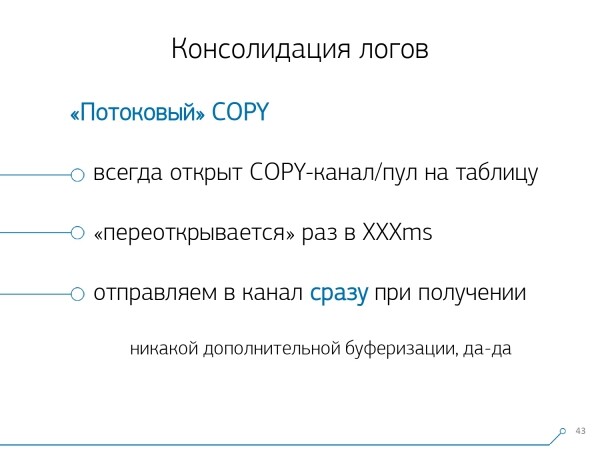
Adică, colectorul are întotdeauna un stream, în care pot scrie datele de care am nevoie. Dar pentru ca baza de date să vadă aceste date, iar cineva să nu rămână blocat, așteptând ca aceste date să fie scrise, COPY trebuie întrerupt periodic. Cea mai eficientă perioadă pentru noi a fost de aproximativ 100ms — închidem și deschidem imediat din nou pentru același tabel. Iar dacă un singur flux nu ajunge în anumite vârfuri, facem polling până la un anumit prag.
În plus, am constatat că pentru acest profil de încărcare, orice agregare, când înregistrările sunt adunate în pachete — este o problemă. Răul clasic este INSERT ... VALUES și apoi 1000 de înregistrări. Pentru că în acel moment apare un vârf de scriere pe suport, iar toate celelalte încercând să scrie pe disc vor aștepta.
Pentru a scăpa de astfel de anomalii, pur și simplu nu agregați nimic, nu bufferizați deloc. Și dacă se întâmplă totuși o bufferizare pe disc (din fericire, Stream API în Node.js permite să aflăm acest lucru) — amânați această conexiune. Atunci când primiți evenimentul că este din nou liber — scrieți în el din coada acumulată. Până atunci, luați următorul, liber din pool și scrieți în el.
Până la implementarea acestei abordări pentru scrierea datelor, aveam aproximativ 4K operațiuni de scriere, iar prin această metodă am redus încărcătura de 4 ori. Acum a crescut din nou de 6 ori datorită noilor baze observabile — până la 100MB/s. Și acum păstrăm jurnalele pentru ultimele 3 luni într-un volum de aproximativ 10-15TB, sperând că, după trei luni, orice problemă poate fi rezolvată de orice dezvoltator.
Înțelegem problemele
Dar a aduna toate aceste date este bine, util, relevant, dar nu este suficient — trebuie să le înțelegem. Pentru că sunt milioane de planuri diferite pe zi.
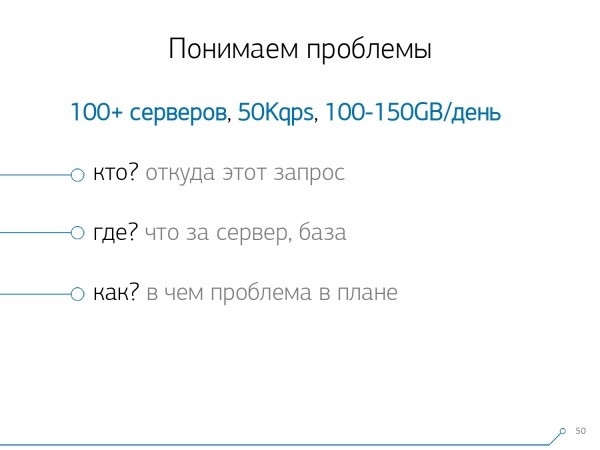
Dar milioane sunt greu de gestionat, trebuie mai întâi să facem «mai puțin». Și, în primul rând, trebuie să ne decidem cum vom organiza acest «mai puțin».
Am identificat trei puncte cheie:
- este el. această solicitare a fost trimisă de
Adică din ce aplicație a venit: interfață web, backend, sistem de plată sau altceva. - unde acest lucru s-a întâmplat
Pe ce server specific. Pentru că dacă aveți mai multe servere pentru aceeași aplicație, și brusc unul «s-a blocat» (pentru că «discul s-a stricat», «memoria a cedat», din alte motive), atunci trebuie să ne adresăm la serverul specific. - cum propunerea în care problema s-a manifestat
Pentru a înțelege «cine» ne-a trimis solicitarea, folosim un instrument standard — setarea unei variabile de sesiune: SET application_name = '{bl-host}:{bl-method}'; — capturăm numele gazdei logicii de afaceri de unde vine solicitarea și numele metodei sau aplicației care a inițiat-o.
După ce am transmis «gazda» solicitării, trebuie să o scriem în log — pentru aceasta configurăm variabila log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Cui îi pasă, poate , ce înseamnă totul. Așadar, în log vedem:
- timp
- identificatorii procesului și tranzacției
- numele bazei
- IP-ul celui care a trimis această solicitare
- și numele metodei
În continuare, am realizat că nu este foarte interesant să privim corelația între o solicitare pe diferite servere. Rareori se întâmplă să aveți o aplicație care «pică» în același mod aici și acolo. Dar chiar și atunci când este același — verificați oricare dintre aceste servere.
Așadar, tăierea «un server — o zi» s-a dovedit a fi suficientă pentru orice analiză.
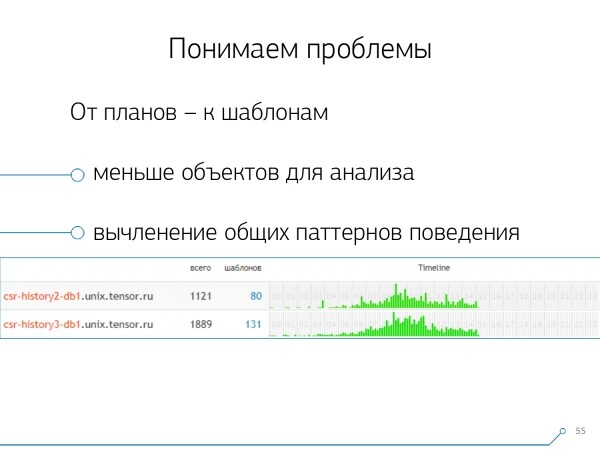
Primul unghi de analiză — acesta este «modelul» — o formă scurtată de prezentare a planului, curățată de toate indicatorii numerici. Al doilea unghi — aplicația sau metoda, iar al treilea — un nod specific al planului care ne-a cauzat probleme.
Când am trecut de la instanțe specifice la modele, am obținut imediat două avantaje:
- reducerea semnificativă a numărului de obiecte de analizat
Nu mai trebuie să analizăm problema pe baza a mii de solicitări sau planuri, ci pe zeci de modele. - cronologia
Astfel, sintetizând „faptele” în cadrul unui anumit unghi, putem reflecta apariția lor pe parcursul zilei. Și aici poți înțelege că, dacă ai un anumit tipar care apare, de exemplu, la fiecare o oră, iar ar trebui să fie o dată pe zi, merită să te gândești ce s-a întâmplat — cine și de ce l-a provocat, poate că nu ar trebui să fie aici. Aceasta este încă o metodă non-numerică, pur vizuală, de analiză.
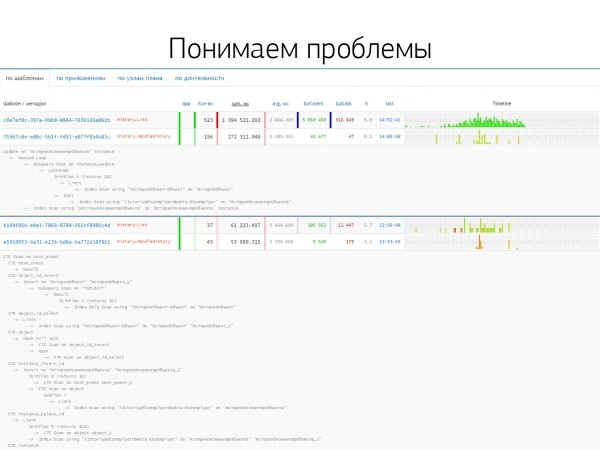
Celelalte metode se bazează pe indicatorii pe care îi extragem din plan: de câte ori a apărut un astfel de model, timpul total și mediu, câte date au fost citite de pe disc și câte din memorie…
Pentru că, de exemplu, ajungi pe pagina de analiză a unui host, te uiți — ceva pare să citească prea mult de pe disc. Discul de pe server nu face față — dar cine citește de pe el?
Și poți sorta după orice coloană și decide cu ce te vei ocupa acum — cu încărcarea pe procesor sau pe disc, sau cu numărul total de solicitări… Ai sortat, ai verificat „cele mai relevante”, ai reparat — ai lansat o nouă versiune a aplicației.
Și imediat poți vedea aplicații diferite care funcționează cu același model de tip solicitare SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, procesare… Și te gândești de ce procesarea ar trebui să citească utilizatorul, dacă acesta nu interacționează cu el.
Metoda inversă — este să vezi direct din aplicație ce face. De exemplu, frontend-ul — acesta, acesta și acesta, iar încă acesta o dată pe oră (tocmai timeline-ul ajută). Și imediat apare întrebarea — pare că nu este treaba frontend-ului să facă ceva o dată pe oră…
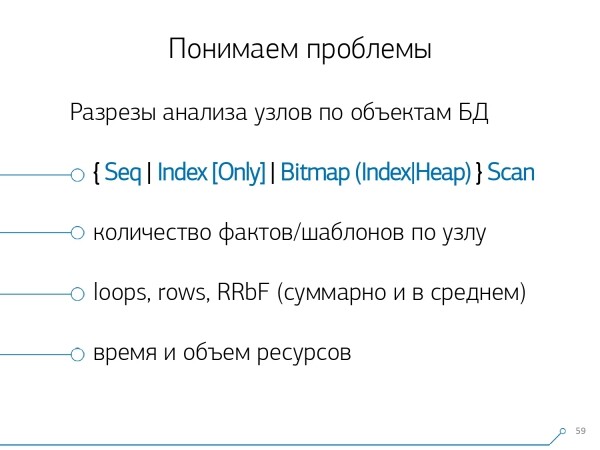
După un timp, am realizat că ne lipsește statistica agregată pe nodurile planului.. Am selectat din planuri doar acele noduri care fac ceva cu datele din tabelele în sine (le citesc/scriu pe baza indicelui sau nu). Practic, în comparație cu imaginea anterioară, se adaugă doar un singur aspect — câte înregistrări ne-a adus acest nod, dar câte a filtrat (Rows Removed by Filter).
Nu ai un index adecvat pe tabel, faci o solicitare către acesta, ocolește indexul, pică în Seq Scan… ai filtrat toate înregistrările, cu excepția uneia. Dar de ce ai nevoie de 100M de înregistrări filtrate într-o zi, nu e mai bine să aplici un index?
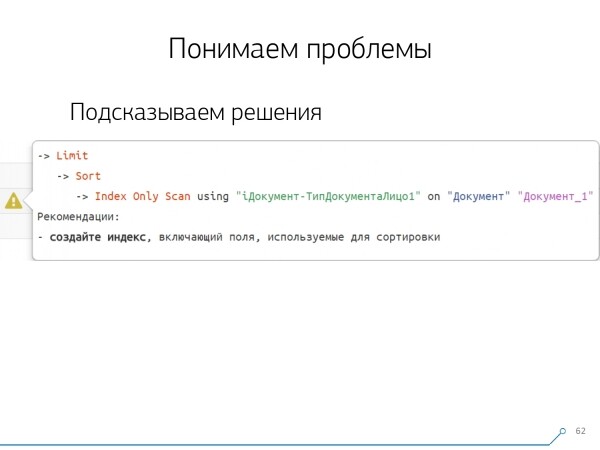
După ce am analizat toate planurile pe noduri, am realizat că există anumite structuri tipice în planuri, care cu o probabilitate foarte mare arată suspect. Ar fi bine ca dezvoltatorul să primească un sfat: "Prieten, aici citești mai întâi după index, apoi sortezi și apoi tai" - de obicei, acolo se află o singură înregistrare.
Toți cei care au scris interogări cu un astfel de model s-au confruntat, cu siguranță, cu următoarea situație: "Dă-mi ultima comandă pentru Vasia, data acesteia". Și dacă nu aveți un index pe dată sau în indexul folosit nu există data, atunci acesta este exact tipul de "capcană" în care veți cădea.
Dar știm că acestea sunt "capcane" - așa că de ce să nu-i sugerăm imediat dezvoltatorului ce ar trebui să facă? Prin urmare, deschizând acum planul, dezvoltatorul nostru vede instantaneu o imagine frumoasă cu sugestii, unde i se spune direct: „Ai probleme aici și aici, iar acestea se rezolvă așa și așa.”
Ca rezultat, volumul experienței necesare pentru a rezolva problemele la început și acum a scăzut considerabil. Așa că avem acest instrument.
Sursa: habr.com
