

Ziiiiiing! E 3 dimineața, visezi un vis minunat, iar brusc — sună telefonul. În această săptămână ai tură de lucru și, se pare, s-a întâmplat ceva. Sistemul automatizat te cheamă să investighezi ce s-a întâmplat. Acesta este un moment important în gestionarea sistemelor informatic moderne, dar să vedem cum putem face notificările mai convenabile pentru oameni.
Întâlniți filosofia monitorizării, născută în urma câtorva decenii de ture în diferite echipe de monitorizare. A fost profund influențată de adevărata biblie a lui Rob Evascu (philosofia mea a alertelor), inclusă în cartea despre , și cartea lui John Allspaw (Considerații pentru configurarea notificărilor).
, și — mulțumesc pentru ajutorul la editarea postării.
Ce este CASE?
Am decis să inventez un acronim frumos, așa cum au sau . O numesc metoda CASE. Aceasta descrie patru puncte la care ar trebui să fim atenți când lucrăm cu monitorizarea automată:
- (legibilitate în funcție de context)
- (aplicabilitate)
- (focus pe simptome)
- (evaluare)
Dacă folosești metoda CASE, abordezi notificările cu un anumit cinism și nu trezești oamenii noaptea. Trebuie să evaluezi constant monitorizarea pentru utilitate și eficacitate. Când o persoană primește o notificare, va avea modele mentale mai bune și mai multă încredere.
Pentru a fi mai ușor de ținut minte, imaginează-ți că ai nevoie de un CASE [adică un caz, un motiv — nota traducătorului], pentru a justifica fiecare alertă. :sunglasses:
Și de ce toate acestea?
. Din multe motive. Și metoda CASE nu va elimina toate acestea. Dar cu ea, noaptea te vei trezi doar datorită notificărilor de mai bună calitate. Această metodă acoperă diferite procese organizaționale care vor ajuta, de asemenea, în această privință.
Frumusețea metodelor RED și USE este că nu doar știm cum să lucrăm, ci și comunicăm între noi într-o limbă comună. Sper că, odată cu metoda CASE, va fi mai ușor să discutăm despre notificările care protejează sistemele noastre, dar care nu le oferă liniște colegilor.
Esența este că trebuie să creăm într-o organizație o cultură în care notificările sunt tratate cu un oarecare dispreț sănătos. Notificările pot fi generate pentru motive întemeiate, dar nu este sigur că mai târziu nu-și vor pierde valoarea. De ce am configurat această notificare? Când au fost revizuite criteriile sale? Cu ajutorul CASE se pot găsi răspunsuri la aceste întrebări.
Context-Heavy — legat de context
3 dimineața — nu este cel mai bun moment pentru a citi mesaje pline de cuvinte inteligente. Pentru a reacționa eficient, e nevoie de informație. Ideal, aceasta ar trebui să fie informația despre o problemă specifică, astfel încât contextul să fie imediat clar, și notificările ar trebui configurate astfel încât să fie posibil acest lucru. Asta face parte din "observare" și "orientare" din . Această configurare merită timpul investit, deoarece a distrage constant atenția cuiva este și mai costisitor. Haideți să ne respectăm unii pe alții.
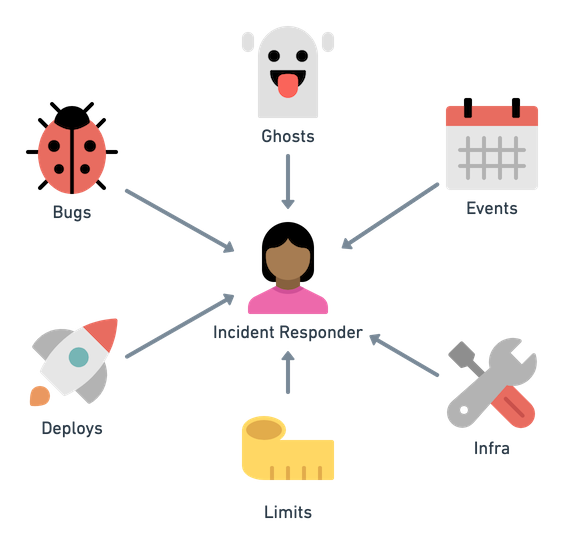
Problemele au multe surse. În special, fantome.
Cum îl ajutăm pe cel de serviciu? În primul rând, cel de serviciu vede notificarea, așa că toate ipotezele se bazează pe ea. Apoi se uită la instrucțiuni și tablouri de bord, dar există întotdeauna date pentru notificarea specifică, nu doar informații generale? Olspo recomandă „să ne gândim la cum putem interpreta sau reacționa la notificare” (slide 29). O notificare bună este orientată spre cel de serviciu, nu este setată doar pe un prag.
Așadar, iată câteva idei pentru a îmbunătăți contextul notificărilor:
- Arată utilizatorului ceva util și creat special, nu doar instrucțiuni obișnuite sau un tablou de bord. În trecut, împreună cu colegii, foloseam tablouri de bord pentru investigații, configurate pentru notificări specifice. Acest lucru ajută, dacă problema este cunoscută, dar în alte cazuri doar complică lucrurile. Aici trebuie să găsim un echilibru.
- Povestește despre istoria notificării: este nouă? Se activează frecvent? Este sezonieră?
- Arată modificările recente în starea sistemului. A schimbat ceva recent? (De exemplu, o desfășurare sau activarea/dezactivarea unei funcționalități.)
- Arată relațiile și oferă informații pentru modelul mental: dependențele sistemului trebuie să fie clar vizibile, de preferat cu indicații despre funcționalitate.
- Conectează rapid utilizatorul cu echipa: vede incidentele curente sau poate afla cine altcineva din companie a primit notificarea? Programul activată?
În ideal, programul de gestionare a incidentelor oferă sugestii despre cum să îmbunătățești contextul notificărilor în timpul investigațiilor de incidente. Întotdeauna există loc de îmbunătățire!
Actionabil — valoare practică
Trebuie să facă ceva în răspuns la notificare? Dacă nu trebuie să facă nimic sau nu este clar ce trebuie să facă, de ce a fost trezit? Trebuie evitate notificările care deranjează operatorii și nu necesită acțiuni.
Ce trebuie să facem?
În trecut, când sistemele erau simple și echipele erau mici, configuram monitorizarea doar pentru a fi la curent cu ce se întâmplă. O notificare că sarcina pe un cluster a crescut ne va oferi context dacă mai apoi serviciul funcționează cu erori. La scară mare, astfel de notificări doar complică lucrurile, deoarece sistemele noastre funcționează întotdeauna într-o stare de degringoladă de diferite grade de severitate. Acest lucru duce rapid la și, desigur, la pierderea sensibilității. De aceea, operatorul ignoră sau chiar filtrează astfel de notificări și nu reacționează întotdeauna așa cum ar trebui. Nu cădeți în această capcană! Nu configurați toate notificările laolaltă, doar pentru a le trimite ulterior pe e-mail într-un folder uitat de Dumnezeu.
Iată cum arată o notificare cu valoare practică:
- Notificarea necesită acțiune, nu doar informează despre noutăți.
- Această acțiune este dificilă sau riscantă de automatizat. Dacă acțiunea poate fi automatizată, atunci automatizați-o, nu mai deranjați oamenii!
- Notificarea conține recomandări urgente sub formă de (SLA) sau (RTO). Atunci operatorul poate activa programul de gestionare a incidentelor în organizație.
Vreau să precizez: nu spun că notificările trebuie să vină doar pentru cele mai importante SLO (obiective de nivel de serviciu) pentru API. Monitorizarea SLO este constant fragmentată și distribuită și necesită un abordare uniformă pentru toate serviciile. Este clar că veți monitoriza cele mai importante SLO pentru clienții care vă plătesc. Dar SLO-urile infrastructurii, cum ar fi bazele de date, trebuie de asemenea monitorizate. În curând va trebui să te ocupi de clienții interni și să îi susții. Și așa mai departe, la nesfârșit.
Bazat pe simptome — accent pe simptome
Îți place sau nu, dar lucrezi într-un sistem distribuit (Kavaj). Ca rezultat, folosești diferite tactici pentru a izola serviciile și a le proteja de defecțiuni (Treynor et al.) 3. Și chiar dacă un garbage collection prelungit sau o cerere lentă către baza de date indică probleme, nu trebuie să te repezi să le remediezi dacă utilizatorii nu vor avea probleme în curând.
Acestea sunt semnale importante, și ele pot avea o valoare practică, dar dacă nu deranjează utilizatorii, nu sunt atât de urgente încât să distragă atenția personalului de serviciu. Notificările bazate pe cauză sunt instantanee ale modelelor noastre mentale despre o defecțiune sistemică. Este mai bine să urmărim simptomele importante decât să încercăm să enumerăm toate cauzele posibile ale defecțiunii.
Pentru ca notificările să aibă o valoare practică, concentrează-te pe , care sunt importanți pentru utilizatori. Evashiuk numește acest „monitorizare pentru utilizatori”. Amintește-ți că această filozofie trebuie aplicată în întreaga organizație. Dacă un serviciu are probleme urgente adânc în infrastructură, echipa corespunzătoare se va ocupa de ele. Protejarea sistemelor de astfel de defecțiuni este o întrebare complet separată (Treynor et al., secțiunea despre strategii pentru minimizarea dependențelor critice).
Simptomele nu sunt atât de volatile
Richard Cook reamintește că în sistemele complexe există o mulțime de defecte, slăbiciuni și probleme.A încerca să enumeri toate cauzele posibile este o muncă Sisifică. Îți descrii problemele, iar ele se schimbă constant. Cindy Shridharan consideră că „sistemele nu trebuie să fie în fiecare secundă în stare perfectă” și este mai bine să folosești o abordare mai umană ( („Observarea sistemelor distribuite”), 7).
Evită notificările pe baza incidentului
De obicei, pentru a remedia incidentele, se configurează notificări pe baza cauzelor. Și aceste notificări limitate referitoare la evenimentul în sine creează un fals sentiment de siguranță, deoarece sistemul găsește mereu noi modalități de a se defecta.
Nu te înșela cu notificările despre cauze. Mai bine gândește-te:
- De ce notificarea bazată pe simptome nu a observat problema?
- Va fi util să îmbunătățești contextul pentru utilizator?
- Cum să îmbunătățim instrumentele de monitorizare pentru a diagnostica mai repede, decât să acumulăm notificări despre ceea ce s-a întâmplat?
Instrumentele de monitorizare pentru diagnosticare vor ajuta doar dacă le veți percepe ca pe un mod de a trece de la simptom la soluție. Fără acest feedback, veți fi copleșit de notificări tardive și diagrame despre defectele anterioare - fără cuvânt despre cele viitoare. Pentru organizație, aceasta este o oportunitate excelentă de a trece din apărare în atac. Iar dezvoltatorii și managerii de produse vor avea aceleași așteptări și obiective clare. Cazul - CASE (:wink:) - este clar pentru fiecare notificare.
Notificările bazate pe cauză sunt tolerabile într-un număr moderat.
Uneori, sistemul nostru aproape nu ne lasă nicio alegere în privința notificărilor bazate pe cauză. Alteori, colaboratorii înțeleg perfect că un simptom va duce inevitabil la o defecțiune, ceea ce înseamnă că are o valoare practică. Poate că pur și simplu nu sunteți sigur ce se întâmplă și setați notificările pentru a fi precauți. Să sperăm că această acțiune este temporară, până când vom modifica sistemul pentru a aborda problema performanței scăzute.
Țineți cont de celelalte componente ale CASE-ului atunci când faceți față astfel de situații. Dacă este temporar, nu înseamnă că nu trebuie să gândiți.
Evaluated - evaluare
Orice modificare în sistem (cod nou, infrastructură nouă, orice nou) extinde gama de defecțiuni (Cook, 3). Este această notificare încă funcțională, așa cum era de așteptat? Modelele mentale clare și actuale ale sistemelor și experiența în răspunsul la anumite notificări susțin – sunt caracteristici cheie Defectele din sisteme evoluează constant și trebuie să ne menținem la curent cu ele.
Este necesar să evaluăm constant calitatea fiecărei notificări pentru a funcționa așa cum era de așteptat. Stimați lideri! Echipele dumneavoastră le va fi mult mai ușor dacă îi ajutați să stabilească acest proces! Iată câteva idei pentru evaluare:
- Windows VPS pentru lucru la distanță , sau alte metode de testare a notificărilor. Echipa poate face asta singură, fără a implica un sistem de management al incidentelor greoi!
- Activați colectarea datelor despre toate notificările legate de incidente în programul de gestionare a incidentelor. Marcați-le ca utile, dăunătoare, inadecvate, neclare etc. Utilizați-le ca feedback.
- Notificările corecte se declanșează rar și sunt verificate cu atenție. Asigurați-vă că toate linkurile funcționează, indicând contextul corespunzător etc.
- Dacă o notificare nu se declanșează niciodată sau se declanșează prea des, există o problemă. Remediați-o sau eliminați-o. Fiți atenți la pasivitate sau activitate excesivă!
- Configurați timere pentru notificări cu termen de valabilitate. Dacă termenul a expirat, evaluați notificarea folosind metoda CASE și actualizați timpul. Verificați periodic termenul de valabilitate, la fel ca la alimente.
- Simplificați procesul de îmbunătățire a notificărilor. Utilizați monitorizarea prin cod și stocați notificările într-un depozit Git. Cererile de pull contribuie la implicarea echipei și veți avea un istoric al notificărilor anterioare. Astfel, veți renunța la teama de a modifica notificările sau de a cere permisiunea celor responsabili pentru ele.
- Organizați feedback pentru notificări, chiar dacă este vorba doar de , astfel încât persoanele de serviciu să marcheze notificările ca fiind inutile sau intruzive. Încorporați în notificare un link sau un apel la acțiune și revizuiți regulat feedbackul.
- Stabiliți o regulă în echipă — lăsați persoanele de serviciu să lucreze la simplificarea serviciului atunci când volumul de muncă este mic. Lăsați după voi lucrurile puțin mai bune decât erau înainte.
Concluzie
Consider că metoda CASE ajută dezvoltatorii și organizațiile să discute despre configurarea și trimiterea notificărilor automate. Un dezvoltator poate începe evaluarea notificărilor folosind metoda CASE, iar apoi se poate alătura întreaga organizație cu alți dezvoltatori, conducerea și programele de gestionare a incidentelor pentru a menține notificările în stare bună. Acest lucru nu necesită instrumente speciale sau procese complexe.
Întreaga industrie ar trebui să reflecteze asupra factorului uman în timpul serviciului fără a compromite servicii de primă clasă pentru clienți. Toate aceste instrumente și practici pot și trebuie îmbunătățite. Sper că metoda CASE va ajuta în acest sens.
Bucurați-vă de notificările îmbunătățite!
Sursa: habr.com
