

Bună ziua.
Am decis să împărtășesc descoperirea mea — rodul gândirii, experimentării și greșelilor.
Pe scurt: aceasta nu este o descoperire, desigur — totul ar trebui să fie de mult cunoscut celor ce se ocupă de procesarea aplicată a datelor și de optimizarea oricăror sisteme, nu doar a SGBD-urilor.
Și: da, știu, scriu articole interesante despre cercetările lor, (UPD.: în comentarii a fost menționat un proiect foarte interesant: )
Pe de altă parte: la o primă vedere, nu văd o mențiune largă, răspândire a unei astfel de abordări în internet, printre specialiștii IT, DBA.
Deci, să ajungem la subiect.
Să presupunem că avem o sarcină: să configurăm un anumit sistem de servicii pentru a deservi o anumită muncă.
Despre această muncă - se știe: care este, în ce constă calitatea acestei lucrări și ce criteriu este folosit pentru măsurarea acestei calități.
De asemenea, să presupunem că, mai mult sau mai puțin, știm cum se desfășoară lucrarea în (sau cu) acest sistem de servicii.
"Mai mult sau mai puțin" - asta înseamnă că există posibilitatea de a pregăti (sau de a obține) un instrument, utilitar, serviciu care poate sintetiza și aplica sistemului o sarcină de testare suficient de adecvată pentru ceea ce va fi în producție, în condiții destul de comparable cu cele din producție.
Și să presupunem că este cunoscut setul de parametri de reglare ai acestui sistem de servicii, pe care putem să îi ajustăm, în sensul productivității acestei lucrări.
Și, care este problema - nu există o înțelegere suficient de completă a acestui sistem de servicii, una care să permită expertului să stabilească configurația acestuia, pentru viitoarea sarcină, pe această platformă și să obțină productivitatea necesară a lucrării sistemului.
Ei bine. Aproape mereu așa se întâmplă.
Ce se poate face în acest caz.
Primul lucru care îmi vine în minte: să mă uit în documentația acestui sistem. Să înțeleg - care sunt intervalele acceptabile pentru valorile parametrilor de reglare. Și, de exemplu, prin metoda coborârii coordonatelor, să aleg valorile pentru parametrii sistemului, în teste.
Adică, să configurăm sistemul cu un anumit set de valori ale parametrilor săi de ajustare.
Să aplicăm o sarcină de testare pe el, folosind acest instrument-utilitar, generator de sarcină.
Și să monitorizăm dimensiunea - reacția, sau metrica calității funcționării sistemului.
O a doua gândire ar putea fi concluzia că - acest lucru durează foarte mult.
Adică: dacă sunt multe parametre de configurare, dacă intervalele lor de valori sunt mari, dacă fiecare test de sarcină separat durează mult timp, atunci: da, totul poate dura o perioadă inacceptabil de lungă.
Și aici putem înțelege și ne amintim.
Putem afla, în setul de valori al parametrilor de configurare ai sistemului de servicii - un vector, ca o secvență de anumite valori.
Fiecare asemenea vector, în condiții egale (atâta timp cât acest vector nu influențează) corespunde unei valori bine definite a metricii - indicatorul calității funcționării sistemului, sub sarcina de testare.
Adică.
Să desemnăm vectorul configurației sistemului, ca  , unde
 ; unde
 — numărul parametrilor de configurare ai sistemului, câți sunt acești parametri.
Și valoarea metricii, corespunzătoare acestuia  o vom desemna ca
 , atunci, obținem o funcție:

Și, atunci: totul se reduce imediat la, în cazul meu: algoritmii de căutare a extremelor funcției, aproape uitați de pe băncile studențești.
Bine, dar aici apare o întrebare organizațional-practică: care algoritm să utilizăm.
- Adică - pentru a codifica cât mai puțin manual.
- Și pentru a funcționa, adică, să găsească extremul (dacă există), cel puțin - mai repede decât metoda coborârii coordonatelor.
Primul moment sugerează că trebuie să ne uităm în direcția unor medii în care astfel de algoritmi - sunt deja implementați, și există, într-un fel, gata de utilizare în cod.
Bine, eu cunosc python și cran-r
Al doilea moment indică că trebuie să citim despre algoritmii propriu-ziși, care există, care sunt cerințele lor, caracteristicile în lucrul lor.
Și ce oferă, pot avea efecte secundare utile - rezultate, fie direct, de la algoritm.
Fie că pot fi obținute la finalizarea lucrării algoritmului.
Aici depinde mult de condițiile de intrare.
De exemplu, dacă, din anumite motive, este necesar să obținem rezultatul mai repede, trebuie să ne orientăm spre algoritmele de coborâre a gradientului, alegând unul dintre ele.
Sau, dacă timpul nu este atât de important, putem folosi metodele de optimizare stohastică, de exemplu, algoritmul genetic.
Propun să luăm în considerare funcționarea unei astfel de abordări în configurarea sistemului, folosind un algoritm genetic, în următoarea, așa-zisă: lucrare de laborator.
Sursele:
- Să presupunem că există, ca sistem de servicii:
oracle xe 18c - Să presupunem că acesta - gestionează activitatea de tranzacții și scopul este de a obține o capacitate de procesare a subd cât mai mare posibil, în tranzacții/s.
- Tranzacțiile - sunt foarte diverse, din punctul de vedere al modului de lucru cu datele și al contextului de lucru.
Să stabilim că aceste tranzacții nu prelucrează un număr mare de date tabelare.
În sensul că nu generează date undo mai mult decât redo și nu prelucrează procente mari de rânduri din tabele mari.
Acestea sunt tranzacții care modifică o singură linie într-o tabelă mai mult sau mai puțin mare, cu un număr mic de indecși pe această tabelă.
În această situație: productivitatea subd în procesarea tranzacțiilor va fi, cu precizarea, determinată de calitatea procesării bazei de date redo.
Precizarea - dacă vorbim strict despre setările subd.
Pentru că, în general, pot exista, de exemplu, blocaje tranzacționale între sesiuni sql, din cauza designului muncii utilizatorului cu datele tabelare și/sau modelului tabelar.
Care, desigur, vor afecta negativ metrica tps și acesta va fi un factor exogen, în raport cu subd: așa a fost creat modelul tabelar și munca cu datele în el încât apar blocaje.
Prin urmare, pentru a avea un experiment curat, să excluzem acest factor, voi detalia mai jos cum anume.
- Să presupunem, pentru claritate, că 100% din comenzile sql trimise la subd: sunt comenzi dml.
Să presupunem că caracteristicile muncii utilizatorului cu subd: sunt aceleași, în teste.
Adică: numărul de sesiuni sql, datele tabelare, modul în care sesiuni sql interacționează cu acestea. - Subd funcționează în
FORCE LOGGING,ARCHIVELOGmoduri. Modul flashback-database este dezactivat, la nivel de subd. - Lgo-Redo: sunt situate într-un sistem de fișiere separat, pe un "disk" separat;
Toată cealaltă parte a componentelor fizice ale bdd: într-un alt fs, separat, pe un "disk" diferit:
Mai multe detalii, despre structura componentei fizice a laboratorului bdd
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Inițial, în aceste condiții de sarcină, am dorit să folosesc SGBD-ul pentru tranzacții.
Are o caracteristică minunată, o voi cita pe autoare:
La baza SLOB se află „metoda SLOB”. Metoda SLOB urmărește să testeze platformele
fără conflicte de aplicație. Nu se poate obține performanța maximă a hardware-ului
folosind codul aplicației care, de exemplu, este constrâns de blocarea aplicației sau chiar
partajarea blocurilor bazei de date Oracle. Așa e—există o suprasarcină atunci când se partajează datele
în blocurile de date! Dar SLOB—în implementarea sa implicită—este imun la asemenea conflicte.
Această declarație: este conformă, așa este.
E convenabil să reglezi gradul de paralelism al sesiunilor SCL, acesta este cheia -t lansării utilitarului runit.sh din cadrul SLOB-ului
Procentul de comenzi DML este reglat în funcție de numărul de SCL-uri pe care le trimite în SGBD, fiecare sesiune SCL, parametrul UPDATE_PCT
Separat și foarte convenabil: SLOB însuși, înainte și după sesiunea de sarcină — pregătește statspak sau instantanee AWR (ceea ce este configurat să pregătească).
Cu toate acestea, s-a descoperit că SLOB nu susține execuția sesiunilor SCL cu o durată mai mică de 30 de secunde.
Prin urmare, mai întâi am codificat propria variantă de încărcător, una simplă, de muncitor, și apoi așa a rămas în funcțiune.
Voi clarifica despre încărcător — ce face și cum, pentru claritate.
În esență, încărcătorul arată astfel:
Codul lucrătorului
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotracе/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Lansarea lucrătorilor se face astfel:
Lansare lucrători
echo "încep testul, durata: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "aștept..." >> "$v_logfile"
wait
Iar tabelele pentru lucrători sunt pregătite astfel:
Crearea tabelelor
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Adică, pentru fiecare lucrător (practic: o sesiune SQL separată în baza de date) se creează un tabel separat, cu care lucrează lucrătorul.
Acest lucru asigură lipsa blocărilor tranzacționale între sesiunile SQL ale lucrătorilor.
Fiecare lucrător: face același lucru, cu tabelul său, toate tabelele sunt identice.
Toți lucrătorii își desfășoară activitatea în aceeași perioadă de timp.
Și anume - o perioadă suficient de lungă, astfel încât, de exemplu, să se producă cu siguranță, și nu o dată, schimbarea jurnalului.
Și, în conformitate cu aceasta, au apărut cheltuieli și efecte asociate.
În cazul meu - am configurat durata de funcționare a lucrătorilor la 8 minute.
Un fragment din raportul statspack, cu descrierea activității bazei de date sub sarcină.
Bază de date    ID DB    Instanță     Nr. Inst  Timp Pornire   Versiune     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NU

Nume gazdă             Platformă                CPU-uri Cores Socket-uri   Memorie (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-biți           2     2       1         15.6

Snapshot       ID Snap     Timp Snap      Sesiuni Curs/Sesiune Comentariu
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Început Snap:       1630 07-Sep-20 23:12:27       55        .7
  Sfârșit Snap:       1631 07-Sep-20 23:20:29       62        .6
   Timp scurs:       8.03 (min) Activitate medie sesiune:       8.4
   Timp DB:      67.31 (min)      CPU DB:      15.01 (min)

Dimensiuni Cache            Început        Sfârșit
~~~~~~~~~~~       ---------- ----------
    Cache Buffer:     1,392M              Dimensiunea blocului standard:         8K
     Pool Partajat:       288M                  Cache Jurnal:   103,424K

Profil de Încărcare              Pe secundă    Pe tranzacție    Pe execuție    Pe apel
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      Timp DB(s):                8.4                0.0        0.00        0.20
       CPU DB(s):                1.9                0.0        0.00        0.04
       Dimensiune redo:        7,685,765.6              978.4
   Citiri logice:           60,447.0                7.7
   Schimbări de blocuri:           47,167.3                6.0
  Citiri fizice:                8.3                0.0
 Scrieri fizice:              253.4                0.0
      Apeluri utilizator:               42.6                0.0
          Parse-uri:               23.2                0.0
     Parse-uri dure:                1.2                0.0
W/A MB procesate:                1.0                0.0
          Logări:                0.5                0.0
        Execuții:           15,756.5                2.0
       Întoarceri:                0.0                0.0
    Tranzacții:            7,855.1
Revenind la formularea lucrării de laborator.
Vom varia, în condiții egale, valorile unor parametrii ai sistemului de baze de date de laborator:
- Dimensiunea grupurilor de jurnal DB. intervalul de valori: [32, 1024] MB;
- Numărul grupurilor de jurnal DB. intervalul de valori: [2,32];
log_archive_max_processesintervalul de valori: [1,8];commit_loggingsunt acceptate două valori:batch|immediate;commit_waitsunt acceptate două valori:wait|nowait;log_bufferintervalul de valori: [2,128] MB.log_checkpoint_timeoutintervalul de valori: [60,1200] secundedb_writer_processesintervalul de valori: [1,4]undo_retentionintervalul de valori: [30;300] secundetransactions_per_rollback_segmentintervalul de valori: [1,8]disk_asynch_iosunt acceptate două valori:true|false;filesystemio_optionssunt acceptate următoarele valori:none|setall|directIO|asynch;db_block_checkingsunt acceptate următoarele valori:OFF|LOW|MEDIUM|FULL;db_block_checksumsunt acceptate următoarele valori:OFF|TYPICAL|FULL;
O persoană cu experiență în administrarea bazelor de date Oracle poate deja să spună - ce și ce valori trebuie setate din parametrii menționați și valorile lor admise, pentru a obține o productivitate ridicată a sistemului de baze de date pentru activitatea cu datele specificate, prin codul aplicativ menționat mai sus.
Dar.
Scopul lucrării de laborator este de a demonstra că algoritmul de optimizare este, de fapt, relativ rapid.
Rămâne doar să consultăm documentația pentru sistemul configurabil, exact atât cât este necesar pentru a descoperi: ce parametri și în ce intervale ar trebui modificați.
De asemenea, va trebui să codificăm codul care va implementa interacțiunea cu sistemul configurabil al algoritmului de optimizare ales.
Astfel, acum să vorbim despre cod.
Am menționat anterior despre cran-r, adică: toate manipulările cu sistemul configurabil sunt orchestrate sub formă de script R.
Sarcina, analiza, selecția în funcție de valoarea metricii, vectorii stării sistemului: acest lucru este un pachet GA ()
Pachetul, în acest caz, nu este foarte potrivit, în sensul că așteaptă vectori (chromozomi, dacă ne referim la terminologia pachetului) exprimați ca numere cu virgulă mobilă.
iar vectorul meu, din valorile parametrilor de configurare, constă din 14 valori - numere întregi și valori de tip string.
Problema este, desigur, ușor de ocolit, prin atribuirea unor valoari de tip string unor anumite numere.
Astfel, în final, secțiunea principală a scriptului R arată astfel:
Apel GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Aici, prin intermediul lower și upper atributelor subprogramului ga se definește, în esență, domeniul spațiului de căutare, în interiorul căruia va fi efectuată căutarea unui vector (sau vectori) pentru care se va obține o valoare maximă a funcției de fitness.
Subprogramul ga realizează căutarea maximizând funcția de fitness.
Astfel, se dovedește că, în acest caz, este necesar ca funcția de fitness, înțelegând vectorul ca un set de valori pentru parametrii SGBD-ului, să obțină o metrică de la SGBD.
Adică: câte tranzacții pe secundă gestionează SGBD-ul, având în vedere configurarea dată a SGBD-ului și sarcina dată pe SGBD.
Adică, desfășurând, trebuie ca în cadrul funcției de fitness să se realizeze următoarea complexitate:
- Prelucrarea vectorului de intrare de numere - transformarea acestuia în valori pentru parametrii SGBD-ului.
- Încercarea de a crea un anumit număr de grupuri redo, de dimensiune specificată. Unde, de altfel, încercarea poate fi eșuată.
Grupurile jurnal existente în baza de date, într-un anumit număr și de o anumită dimensiune, trebuie eliminate pentru a menține puritatea experimentului. - Dacă punctul anterior a avut succes: setarea bazei de valori pentru parametrii de configurare (din nou: poate fi o eroare)
- Dacă punctul anterior a avut succes: oprirea bazei de date, repornirea bazei de date pentru ca valorile parametrilor recent setate să intre în vigoare. (din nou: poate fi o eroare)
- Dacă punctul anterior a avut succes: efectuarea unui test de încărcare. obținerea de metrici de la baza de date.
- Restaurarea bazei de date la starea inițială, adică ștergerea grupurilor de jurnal suplimentare, revenirea la configurația inițială a bazei de date.
Codul funcției de fitness
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Astfel, întregul lucru: se desfășoară în funcția de fitness.
Subprogramul ga, care procesează vectorii, sau mai degrabă se poate spune - cromozomii.
În care, cel mai important pentru noi este: selecția cromozomilor cu astfel de gene, pentru care funcția de fitness returnează valori mari.
Acesta este, de fapt, procesul de căutare a setului optim de cromozomi vectori, în spațiul de căutare N-dimensional.
O explicație foarte clară și detaliată , cu exemple de cod R, ale algoritmului genetic.
Sublinez două aspecte tehnice.
Apelurile auxiliare, din funcția evaluate, de exemplu, oprirea-reînceperea, setarea valorii parametrului SGBD, se fac pe baza cran-r funcției system2
Prin care: se invoacă un anumit script bash sau o comandă.
De exemplu:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," a eșuat cu: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Al doilea aspect - linia evaluate funcției, cu păstrarea unei valori specifice a metricii și vectorului de ajustare corespunzător, în fișierul de log:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Este important, deoarece, din acest set de date, se poate obține informații suplimentare despre care dintre componentele vectorului de ajustare influențează mai mult sau mai puțin valoarea metricii.
Adică: se poate realiza o analiză a importanței atributelor.
Deci, ce poate rezulta.
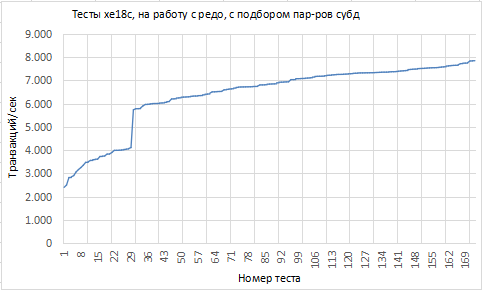
Sub formă de grafic, dacă ordonăm testele în funcție de creșterea metricii, imaginea este următoarea:
Unele date corespunzătoare valorilor extreme ale metricii:
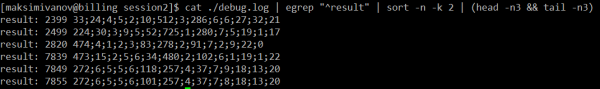
Aici, în captura de ecran cu rezultatele, menționez: valorile vectorului de ajustare - sunt date în termeni de cod al funcției de fitness, nu în termenii listei de numere a parametrilor/range-urilor valorilor parametrilor, care au fost formulate mai sus în text.
Ei bine. Este mult sau puțin, ~8000 tps: este o întrebare separată.
În cadrul lucrării de laborator - acest număr nu este important, ci dinamica, cum se schimbă această valoare.
Dinamica este bună aici.
Este evident că, cel puțin un factor, care influențează semnificativ valoarea metricii, algoritmul ga, prin analizarea vectorilor-cromozomi: a acoperit.
Judging by the quite vigorous dynamics of the curve values, there is at least one more factor that, although significantly smaller, still has an influence.
Here we need a attribute-importance analysis to understand which attributes (in this case, the components of the tuning vector) and how strongly they affect the metric value.
From this information, we can understand which factors were affected by changes in significant attributes.
Executați attribute-importance This can be done in various ways.
For these purposes, I like the algorithm randomForest of the same name R package ()
randomForest, as I understand its operation and its approach to evaluating attribute importance, builds a certain model of the response variable's dependency on the attributes.
In our case, the response variable is the metric obtained from the DBMS during load testing: tps;
And the attributes are the components of the tuning vector.
So, it randomForest evaluates the importance of each attribute of the model with two numbers: %IncMSE — how the presence/absence of this attribute in the model changes the MSE-quality of this model (Mean Squared Error);
And IncNodePurity is a number that reflects how well, based on the values of this attribute, the dataset with observations can be split, so that one part contains data with one value of the explained metric and the other part with another value of the metric.
So, i.e.: how much of a classifying attribute it is (the most clear explanation in Russian for random forest I have seen ).
Working-class R code for processing a dataset with load testing results:
x=NULL
v_data_file=paste('tmp/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
You can manually fine-tune the hyperparameters of the algorithm and, based on the model quality, choose a more accurate model that performs predictions on the validation dataset.
You can write some function for this work (by the way, again, based on some optimization algorithm).
You can use the R package caret, it doesn't matter.
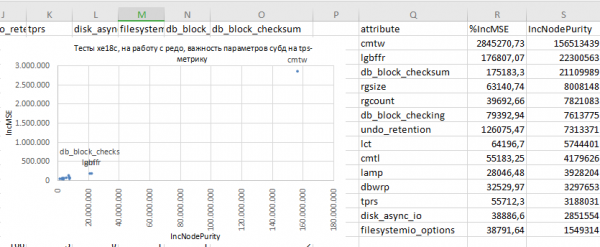
În acest caz, se obține un rezultat pentru evaluarea importanței atributelor:
Așadar, putem trece la reflecții globale:
- Astfel, cel mai semnificativ, în aceste condiții de testare, s-a dovedit a fi parametrul
commit_wait
Tehnic, acesta definește modul de executare a operațiunii I/O de scriere a datelor redo din log-buffer-ul bazei de date în grupul curent de jurnal: sincron sau asincron.
Valoarenowaitîn care se obține practic o creștere verticală multiplă a valorii metricii TPS: activarea modului asincron I/O în grupurile redo.
O întrebare separată este dacă este necesar sau nu să se procedeze astfel în baza de date de producție. Aici mă limitez doar la constatare: acesta este un factor semnificativ. - Este logic că dimensiunea log-buffer-ului bazei de date se dovedește a fi un factor semnificativ.
Cu cât dimensiunea log-buffer-ului este mai mică, cu atât capacitatea sa de buffersizare este mai mică, se întâmplă mai des depășiri și/sau imposibilitatea de a aloca un spațiu liber pentru o porțiune de noi date redo.
Și, prin urmare: întârzierile asociate cu alocarea spațiului în log-buffer și/sau deversarea datelor redo din acesta în grupurile redo.
Aceste întârzieri, bineînțeles, ar trebui să afecteze și afectează capacitatea de procesare a tranzacțiilor de către bază. - Parametru
db_block_checksum: ei bine, este, în general, de asemenea, clar — procesarea tranzacțiilor duce la generarea de blocuri dirty în cache-ul buffer-ului bazei de date.
Acestea, în condițiile activării verificării checksum-urilor blocurilor de date, baza trebuie să le proceseze — să calculeze aceste checksum-uri din corpul blocului de date, să le compare cu ceea ce este scris în header-ul blocului de date: corespunde/nu corespunde.
Această muncă, din nou, nu poate să nu întârzie procesarea datelor, așa că parametrul și mecanismul care definește acest parametru devin semnificative.
De aceea, furnizorul oferă, în documentația pentru acest parametru, diferite valori pentru acesta și subliniază că, da, va exista un impact, dar, diferite valori, până la „dezactivat” și un impact diferit, puteți alege.
Și, în concluzie generală.
Abordarea, în general, se dovedește a fi destul de funcțională.
Aceasta permite, în etapele timpurii ale testării de încărcare a unui sistem de servicii, pentru alegerea configurației optime a acestuia sub sarcină fără a fi necesară o cunoaștere profundă a particularităților de configurare a sistemului sub sarcină.
Dar nu exclude complet — măcar la nivelul înțelegerii: trebuie să cunoști "butonii de reglare" și intervalele acceptabile de rotație ale acestor butoane.
Apoi, abordarea poate găsi relativ repede configurația optimă a sistemului.
Și, la finalizarea testării, se poate obține informații despre natura relației dintre metrica calității funcționării sistemului și valorile parametrilor ajustabili ai sistemului.
Acest lucru, desigur, ar trebui să contribuie la crearea acestei înțelegeri profunde a sistemului, a funcționării sale, cel puțin în condițiile date.
Practic, aceasta înseamnă: o scădere a costurilor pentru a înțelege sistemul configurabil, comparativ cu costurile pentru pregătirea acestei testări a funcționării sistemului.
În mod special, subliniez: în această abordare, este esențial ca gradul de adecvare a testării sistemului să fie în concordanță cu condițiile de funcționare pe care le va avea în producție.
Vă mulțumesc pentru atenție, timp.
Sursa: habr.com
