

Adevărat vorbind, Ivan râdea adesea de eforturile zadarnice ale colegilor din departamentul de monitorizare. Aceștia depuneau eforturi enorme pentru a implementa metricile cerute de conducerea companiei. Erau atât de ocupați încât nu voiau să facă nimic altceva.
Dar conducerea nu se mulțumea cu atât – continua să comande metrici noi și noi, încetând foarte repede să utilizeze ceea ce fusese realizat anterior.
În ultima vreme, toată lumea vorbea doar despre LeadTime – timpul de livrare a caracteristicilor de business. Metrica a arătat o cifră nebunească – 200 de zile pentru livrarea unei sarcini. Cum toată lumea a suspinat, a oftat și a ridicat mâinile spre cer!
După un timp, agitația s-a stins treptat și conducerea a dat comanda pentru crearea unei alte metrici.
Ivan era perfect conștient că și noua metrică va muri liniștit într-un colț întunecat.
Adevărat, se gândea Ivan, a ști numărul nu înseamnă nimic pentru nimeni. 200 de zile sau 2 zile – nu este nicio diferență, pentru că din număr nu se poate determina cauza și înțelege dacă este bine sau rău.
Aceasta este capcana tipică a metricilor: pare că noua metrică va dezvălui esența ființei și va explica un secret ascuns. Toți speră în asta, dar dintr-un motiv sau altul, nimic nu se întâmplă. De fapt, secretul nu trebuie căutat în metrici!
Pentru Ivan, acesta era un pas deja parcurs. El înțelegea că pentru măsurători, iar toate secretele trebuie căutate în , adică în ceea ce formează această metrică.
Pentru un magazin online, obiectul de influență va fi clienții săi, care aduc bani, iar pentru DevOps – echipele care creează și distribuie pachete folosind un pipeline.
Odată, așezat confortabil pe un fotoliu în hall, Ivan a decis să își petreacă timpul gândindu-se bine cum și-ar dori să vadă metricile DevOps, având în vedere că obiectul de influență sunt echipele.
Scopul metricilor DevOps
Este clar că tuturor le-ar plăcea să reducă timpul de livrare. 200 de zile – nu este deloc acceptabil.
Dar cum, aceasta este întrebarea?
În companie lucrează sute de echipe, iar prin pipeline-ul DevOps trec zilnic mii de pachete. Timpul real de livrare va arăta ca o distribuție. Fiecare echipă va avea propriul său timp și propriile sale particularități. Cum dintre această amestecătură poți găsi ceva?
Răspunsul a venit de la sine – trebuie să găsim echipele problematice și să înțelegem ce se întâmplă cu ele și de ce durează atât de mult, iar de la echipele "bune" să învățăm cum să facem totul rapid. Și pentru aceasta este necesar să măsurăm timpul petrecut de echipe pe fiecare dintre standurile DevOps:
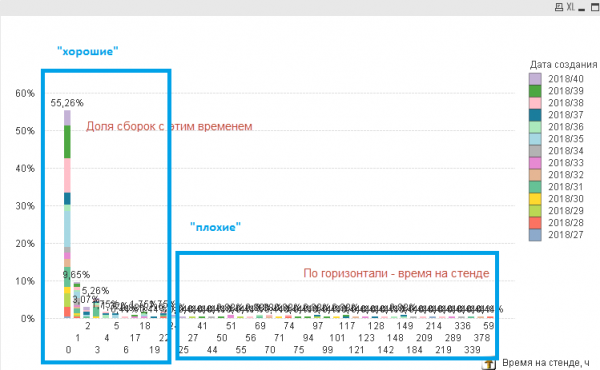
"Scopul sistemului va fi clasificarea echipelor pe baza timpului de trecere a standurilor, adică, în final, ar trebui să obținem o listă cu echipele selectate în funcție de timp, nu doar o cifră.
Dacă aflăm cât timp a fost cheltuit în total pe stand și cât timp a fost pierdut între standuri, putem găsi echipele, să le sunăm și să ne lămurim mai în detaliu despre motivele și să le remediem", s-a gândit Ivan.
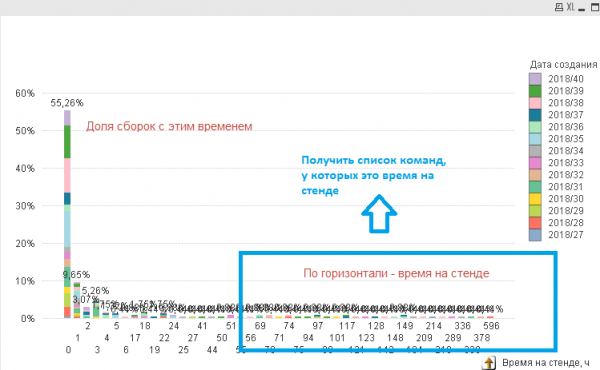
Cum să calculăm timpul de livrare pentru DevOps
Pentru a face calculele, a fost necesar să ne adâncim în procesul DevOps și în esența acestuia.
În companie se utilizează un număr limitat de sisteme, iar informațiile pot fi obținute doar din acestea și nu din alte surse.
Toate sarcinile din companie erau înregistrate în Jira. Când o sarcină era preluată pentru lucru, se crea un branch pentru ea, iar după realizare se făcea un commit în BitBucket și un Pull Request. La acceptarea PR-ului (Pull Request), automat se crea un pachet și se salva în depozitul Nexus.

Apoi, pachetul era desfășurat pe mai multe standuri cu ajutorul Jenkins pentru a verifica corectitudinea instalării, testare automată și manuală:
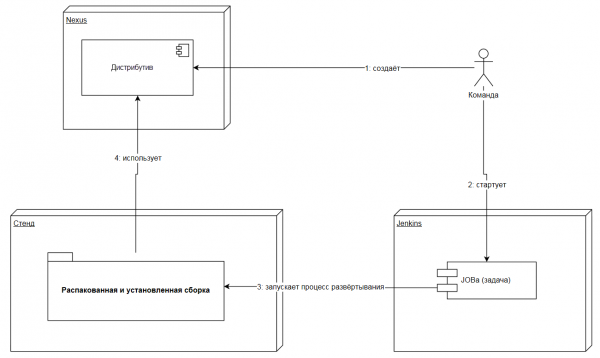
Ivan a detaliat din ce sisteme se poate obține ce informație pentru a calcula timpul pe standuri:
- Din Nexus – Timpul de creare a pachetului și numele folderului în care se afla codul echipei.
- Din Jenkins – Timpul de start, durata și rezultatul execuției fiecărei jobs, numele standului (în parametrii job-ului), etapele (pașii job-ului), linkul către pachetul din Nexus.
- Ivan a decis să nu includă Jira și BitBucket în pipeline, deoarece acestea se refereau mai mult la etapa de dezvoltare, nu la desfășurarea pachetului final pe standuri.
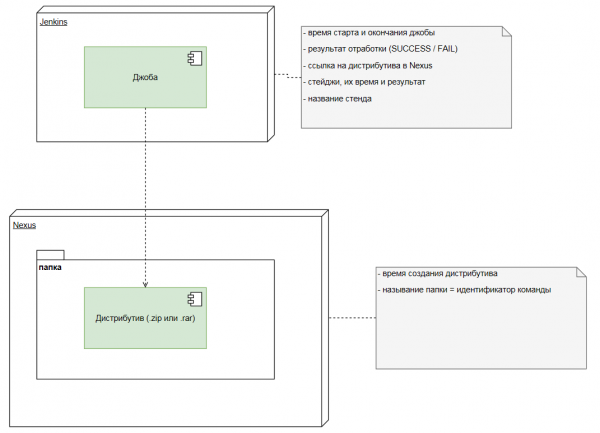
Pe baza informațiilor disponibile, a fost desenată următoarea schemă:
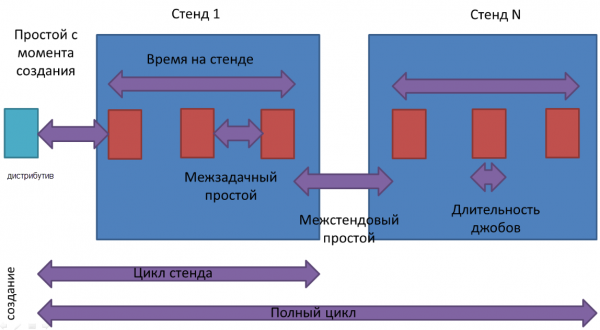
Știind cât timp se creează pachetele și cât timp este cheltuit pe fiecare dintre ele, putem calcula cu ușurință costurile totale pentru parcurgerea întregului pipeline DevOps (ciclul complet).
Iată ce metrice DevOps a obținut Ivan în final:
- Numărul de pachete create
- Procentul pachetelor care au "intrat" pe stand și au "trecut" standul
- Timpul petrecut pe stand (ciclul standului)
- Ciclul complet (timpul total pe toate standurile)
- Durata job-urilor
- Timpul de nefuncționare între standuri
- Timpul de nefuncționare între lansările job-urilor pe același stand
Pe de o parte, metricile caracterizau foarte bine pipeline-ul DevOps în ceea ce privește timpul, pe de altă parte, au fost considerate foarte simple.
Încântat de munca bine făcută, Ivan a pregătit o prezentare și a mers să o prezinte conducerii.
S-a întors cu o expresie întunecată și cu mâinile lăsate.
— Este un fiasco, frate — a zâmbit colegul ironic...
Continuarea se citește în articolul „».
Sursa: habr.com
