

Salutare tuturor.
Sunt administrator Linux, m-am mutat din Rusia în Australia cu o viză profesională în 2015, dar acest articol nu va fi despre cum să dăm unui purcel un tractor. Există deja suficiente articole de genul acesta (totuși, dacă va fi interes, voi scrie și despre asta). Așadar, aș dori să povestesc despre cum, la locul meu de muncă în Australia ca inginer linux-ops, am fost inițiatorul migrației de la un sistem de monitorizare la altul. În mod specific — de la Nagios la Icinga2.
Articolul este parțial tehnic și parțial despre comunicarea cu oamenii și problemele legate de diferențele culturale și metodele de lucru.
Din păcate, eticheta „code” nu evidențiază codul Puppet și YAML, așa că a trebuit să folosesc „plaintext”.
Nimic nu prezicea problemele în dimineața zilei de 21 decembrie 2016. Ca de obicei, citeam Habr ca un anonim nesemnat în primele jumătate de oră ale zilei de lucru, consumând cafea și am dat peste .
Deoarece în compania mea se folosea Nagios, am creat rapid un tichet în Redmine și am trimis linkul în chat-ul comun, deoarece am considerat că este important. Inițiativa poate fi pedepsită chiar și în Australia, așa că inginerul șef a pus această problemă în sarcina mea, din moment ce eu am descoperit-o.
Captură de ecran din Redmine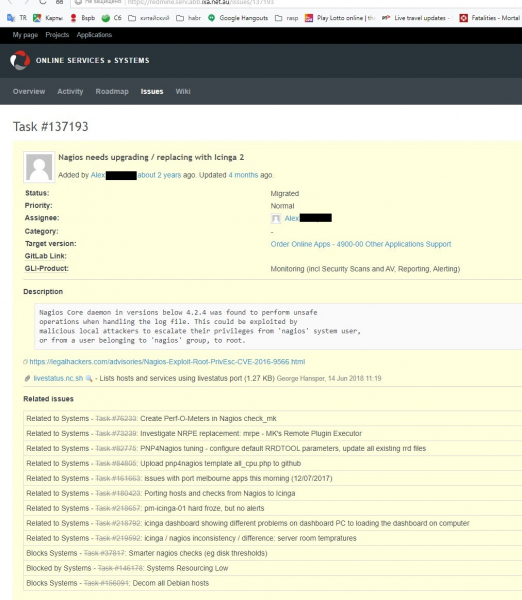
În departamentul nostru, înainte de a-ți expune opinia, este obiceiul să propui cel puțin o alternativă, chiar dacă alegerea este evidentă, așa că am început prin a căuta pe Google ce sisteme de monitorizare sunt actuale în acest moment, deoarece în Rusia, la ultima mea slujbă, aveam propriul meu sistem personalizat, foarte primitiv, dar totuși funcțional și realizând toate sarcinile atribuite. Python, Politehnica din Sankt Petersburg și metroul sunt grozave. Nu, metroul este slab. Aceasta este părerea mea personală (11 ani de muncă) și merită un articol separat, dar nu acum.
Un pic despre regulile de introducere a modificărilor în configurația infrastructurii la locul meu de muncă actual. Noi folosim Puppet, Gitlab și principiul Infrastructure as Code, așa că:
- Nicio modificare manuală prin SSH prin modificarea manuală a fișierelor pe mașinile virtuale. În cei trei ani de muncă, am fost tras la răspundere de multe ori, ultima dată acum o săptămână și nu cred că a fost ultima dată. Ei bine, în adevăr — a modifica o linie în configurație, a reporni serviciul și a verifica dacă problema s-a rezolvat — sunt 10 secunde. A crea o nouă ramură în Gitlab, a urca modificările, a aștepta să finalizeze r10k pe Puppetmaster, a rula Puppet —environment=mybranch și a mai aștepta câteva minute pentru a finaliza toate acestea — cel puțin 5 minute.
- Orice modificare se face prin crearea unei cereri de fuziune în Gitlab și este necesară aprobarea de la cel puțin un membru al echipei. Modificările semnificative necesită aprobarea a două sau trei persoane, conform deciziei liderului de echipă.
- Toate modificările, într-un fel sau altul, sunt textuale (deoarece manifestele Puppet, scripturile și datele Hiera sunt text), fișierele binare sunt extrem de nerecomandate, iar aprobarea acestor fișiere necesită motive întemeiate.
Așadar, variantele pe care le-am considerat:
- Munin — dacă în infrastructură sunt mai mult de 10 servere, administrarea devine un coșmar (din . Nu am avut o dorință deosebită să verific asta, așa că am crezut pe cuvânt).
- Zabbix — am analizat de mult timp, încă în Rusia, dar atunci era excesiv pentru sarcinile mele. Aici — a trebuit să renunț din cauza utilizării Puppet ca manager de configurație și Gitlab ca sistem de control al versiunilor. La acel moment, din câte am înțeles — Zabbix stochează întreaga configurație într-o bază de date, motiv pentru care nu era clar cum să gestionăm configurația în condițiile actuale și cum să urmărim modificările.
- Prometheus — ceea ce vom ajunge în cele din urmă, judecând după starea din departament, dar atunci nu am reușit să gestionez asta și nu am putut demonstra un exemplu funcțional (Proof of Concept), așa că a trebuit să renunț.
- Au fost și câteva alte variante, care fie necesitau o recompunere completă a sistemului, fie erau în stadii incipiente / abandonate și din acest motiv au fost respinse.
În final, m-am oprit pe Icinga2 din trei motive:
1 — compatibilitate cu Nrpe (serviciul client care execută verificări prin comenzi de la Nagios). Acest lucru a fost foarte important, deoarece, la acel moment, aveam 135 (acum, în 2019, 165) mașini virtuale cu o mulțime de servicii/verificări personalizate și a refacerea tuturor acestora ar fi fost o adevărată bătaie de cap.
2 — toate fișierele de configurare sunt text, ceea ce permite modificarea acestora cu ușurință, crearea de merge requests cu posibilitatea de a vedea ce a fost adăugat sau șters.
3 — este un proiect OpenSource viu și în dezvoltare. Oamenii noștri iubesc OpenSource și contribuie în mod activ prin crearea de Pull Requests și Issues pentru a rezolva problemele.
Așadar, să începem, Icinga2.
Primul lucru cu care m-am confruntat a fost inerția colegilor. Toată lumea era obișnuită cu Nagios/NadjiOS (deși nici aici nu au putut ajunge la un compromis cu privire la pronunțare) și interfața CheckMK. La Icinga, interfața arăta complet diferit (asta a fost un dezavantaj), dar oferă posibilitatea de a personaliza flexibil ceea ce trebuie să vadă prin filtre pentru aproape orice parametru (asta a fost un avantaj, dar am avut o luptă serioasă pentru el).
Filtre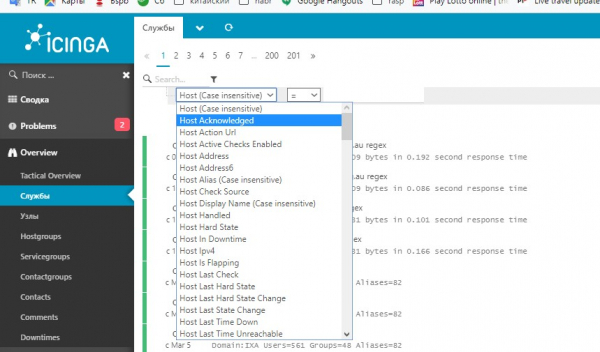
Evaluați raportul dintre dimensiunea barei de derulare și dimensiunea câmpului de derulare.
Al doilea — toți erau obișnuiți să vadă întreaga infrastructură pe un singur monitor, deoarece CheckMk permitea lucrul cu mai multe gazde Nagios, dar interfața Icinga nu putea face asta (de fapt, putea, dar despre asta mai jos). O alternativă era un program numit Thruk, dar designul său provoca grețuri tuturor membrilor echipei, cu excepția unuia — cel care l-a propus (nu eu).
Să aruncăm Thruk la gunoi — decizia unanima a echipei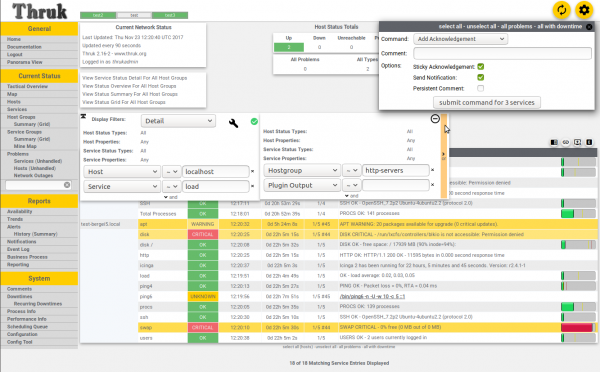
După câteva zile de brainstorming, am propus ideea de monitorizare în cluster, unde există un master host în zona de producție și doi subordonați — unul în dev/test și unul extern, situat la un alt furnizor, cu scopul de a monitoriza serviciile noastre din perspectiva clientului sau a unui observator extern. Această configurație permitea vizualizarea tuturor problemelor într-un singur web-interfață și funcționa destul de bine, dar Puppet... Problema cu Puppet era că master host-ul trebuia acum să cunoască toate host-urile și serviciile/verificările din sistem și trebuia să le distribuie între zone (dev-test, staging-prod, ext), dar transmiterea modificărilor prin API-ul Icinga durează câteva secunde, în timp ce compilarea catalogului Puppet pentru toate serviciile pentru toate host-urile durează câteva minute. Aceasta mi se reproșează și acum, deși am explicat de mai multe ori cum funcționează totul și de ce durează atât de mult.
Al treilea — o mulțime de SnowFlakes (fulgi de zăpadă) — lucruri care ies din sistemul general, deoarece au ceva special, astfel încât regulile generale nu se aplică. Se soluționa printr-o abordare directă — dacă există alerte, dar de fapt totul este în regulă, înseamnă că trebuie să cercetăm mai în profunzime și să înțelegem de ce îmi generează alerte, deși nu ar trebui. Sau invers — de ce Nagios panică, iar Icinga nu.
Al patrulea — Nagios a funcționat aici timp de trei ani înainte de mine și încrederea în el a fost inițial mai mare decât în sistemul meu trendy, așa că de fiecare dată când Icinga ridica panică — nimeni nu făcea nimic până când Nagios nu se agita pe aceeași problemă. Dar foarte rar Icinga dădea alerte reale mai devreme decât Nagios și consider că acesta este un defect serios, pe care îl voi explica în secțiunea «Concluzii».
Ca urmare, punerea în funcțiune a durat mai mult de 5 luni (era planificată pentru 28 iunie 2018, de fapt — 3 decembrie 2018), în principal din cauza «parity check» — acea nebunie când există mai multe servicii în Nagios despre care nimeni nu a auzit nimic în ultimii câțiva ani, dar ÎN ACEST MOMENT, au generat crit fără niciun motiv și a trebuit să explic de ce nu sunt pe panoul meu și a trebuit să le adaug în Icinga, pentru a finaliza «parity check» (Toate serviciile/verificările în Nagios corespund serviciilor/verificărilor în Icinga).
Implementare:
Întâi este războiul între Code și Data, în stil Puppet. Toate datele, absolut toate, trebuie să fie în Hiera și nimic altceva. Tot codul se află în fișierele .pp. Variabilele, abstrațiile, funcțiile — totul merge în pp.
În concluzie — avem o mulțime de mașini virtuale (165 la momentul scrierii articolului) și 68 de aplicații web, care trebuie monitorizate pentru funcționalitate și pentru valabilitatea certificatelor SSL. Dar din cauza unor probleme istorice, informațiile pentru monitorizarea aplicațiilor sunt preluate dintr-un repository gitlab separat, iar formatul datelor nu s-a schimbat din vremea Puppet 3, ceea ce creează complicații suplimentare în configurare.
Codul Puppet pentru aplicații, aveți grijă la ochi
define profiles::services::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # adaugă notificări pentru grupul implicit (sisteme) + orice grup definit în int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Alege un regex pentru verificare

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/{}' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Împărțim o aplicație pe domenii dacă există două sau mai multe
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Transformăm adresa IP într-un array dacă nu este, pentru că askizzy are 2 ips și este un array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Îmbină zona implicită (unde aplicația este definită) și zonele suplimentare, dacă există
      $web_ipaddress.each | String $ip_address | {            # Pentru fiecare IP (dacă avem mai multe)
        $suffix = length($web_ipaddress) ? {                  # Dacă avem mai mult de unu - adaugă IP ca un suffix la acest hostname pentru a evita duplicarea resurselor
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Folosind ultimul octet cauzează o coliziune între nginx-vip 203.15.70.94 și ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Dacă este un host pentru ext - prefixul devine 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Codul de configurare al găzduirii și serviciilor arată, de asemenea, groaznic:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # va fi activat când ne mutăm complet la icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Vă rugăm să vă asigurați că node-ul are setat fact-ul $location (int, pm, ext)')
    }
  }

  file { '\/etc\/icinga2\/conf.d\/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"\/etc\/icinga2\/conf.d\/${file_name}":
      ensure => present,
      source => "puppet:\/\/modules\/profiles\/services\/monitoring\/default_config\/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # Acesta este pentru invazia spațială când va fi gata.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Împărțind listele de site-uri după grupurile de hosturi - docker_host\/gluster_host\/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Împărțind listele de grupuri după hosturi
      # Este acest host în array-ul $hosts_has_large_disks ? Dacă da setăm host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Îmbinând variabilele separat

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Toate hosturile sunt gestionate de API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Împărțind hosturile API după zone
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Împărțind listele de site-uri după grupurile de hosturi - docker_host\/gluster_host\/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Împărțind listele de grupuri după hosturi
          # Este acest host în array-ul $hosts_has_large_disks ? Dacă da setăm host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}\/${zone}\/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### SFÂRȘITUL HOSTURILOR ####

####   SERVICII   ####

  $services.each | String $service_group, Hash $s_list |{             # Grup de servicii și lista de servicii din acel grup
    $service_list = $s_list['checks']                                 # Lista de verificări efective, separat de setările SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # setările globale ale serviciilor + setările grupului de servicii
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Dacă suprascriem check_timeout-ul implicit, dar nu nrpe_timeout, facem nrpe_timeout același cu check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga va converti 1m în 60 automat!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Implicit folosim nrpe și toate comenzile sunt efectuate prin nrpe. Deci vars.nrpe_command = $service_name este o valoare implicită
      # Dacă este o comandă Icinga pe partea server-ului - nu avem nevoie de 'nrpe_command'
      # dar nu strică să avem acea variabilă și codul este mai scurt

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Asamblarea $vars din setările globale ale serviciilor, setările grupului de servicii, setările acestei verificări particulare și să nu uităm de setările nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick este necesar peste tot, altfel devine "Valoarea '' nu poate fi convertită în Numeric"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Atribuiți grupul implicit (sisteme) dacă nu sunt definite alte grupuri.

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Acest lucru trebuie îmbinat separat, deoarece îmbinarea ca parte a MERGED_DATA suprascrie array-urile în loc să le îmbine, așa că pierdem unele valori "assign" și "ignore"

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### SFÂRȘITUL SERVICIILOR ####

#### ALTE LUCRURI PLIINE ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Îmbinând setările de notificare pentru utilizatori cu alte setări
  $users_oncall = deep_merge($users, $oncall)
  # Magie. Nu atingeți.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles\/os\/redhat\/centos7\/sudoers\/icinga.erb',
  }

}
Încă lucrez la acest cod și continui să-l îmbunătățesc pe măsură ce am ocazia. Cu toate acestea, exact acest tip de cod a permis utilizarea unei sintaxe simple și clare în Hiera:
Date
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Toate verificările sunt împărțite în grupuri, fiecare grup având setări implicite despre unde și cât de des să ruleze aceste verificări, ce notificări să fie trimise și cui.
În fiecare verificare poate fi suprascrisă orice opțiune și toate acestea se combină, în cele din urmă, cu setările implicite ale tuturor verificărilor în ansamblu. De aceea, în config.pp este scris un astfel de cod — acolo are loc îmbinarea tuturor setărilor implicite cu setările grupurilor și apoi cu fiecare verificare individuală.
De asemenea, o schimbare foarte importantă a fost posibilitatea de a utiliza funcții în setări, de exemplu, funcția de substituție a portului, adresei și URL-ului pentru verificarea http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Acest lucru înseamnă — dacă în definiția gazdei există o variabilă http_port — folosește-o, altfel 443. De exemplu, interfața web jabber rulează pe 9090, iar Unifi — pe 7443.
http_vhost înseamnă ignorarea DNS-ului și preluarea acestei adrese.
Dacă în gazdă este specificat un uri — atunci să se urmeze acesta, altfel să se ia „\/”.
Cu http_ssl a fost o poveste amuzantă — acest lucru refuza să fie oprit la cerere. Am stat mult timp blocat în acest rând, până când mi-a venit în minte că variabila din definiția gazdei:
http_ssl: falseSe încadrează în expresie
if(host.vars.http_ssl) { return false } else { return true }cum false iar în final obținem
if(false) { return false } else { return true }adică, verificarea ssl este întotdeauna activă. S-a rezolvat prin înlocuirea sintaxei:
http_ssl: noConclusions:
Pro:
- Acum avem un singur sistem de monitorizare, nu două, cum a fost în ultimele 7-8 luni, sau unul, învechit și vulnerabil.
- Structura datelor gazdelor / serviciilor (verificărilor) este acum (din punctul meu de vedere) mult mai lizibilă și mai clară. Pentru alții, acest lucru nu a fost atât de evident, așa că a fost necesar să creez câteva pagini în wiki-ul local pentru a explica cum funcționează totul și ce trebuie corectat.
- Există posibilitatea de configurare flexibilă a verificărilor prin intermediul variabilelor și funcțiilor, de exemplu pentru verificarea http_regexp, modelul căutat, codul de returnare, url și portul pot fi definite în setările gazdei.
- Există câteva panouri (dashboards), pentru fiecare dintre ele putând defini o listă proprie de alerte afișate și gestiona totul prin Puppet și merge requests.
Dezavantaje:
- Inerția membrilor echipei — Nagios a funcționat, a funcționat și a funcționat, iar această Isinga a ta tot timpul dă erori și se blochează. Și cum se poate verifica istoricul? Ah, bleah, nu se actualizează… (Problema reală — istoricul alertelor nu se actualizează automat, doar pe F5)
- Inerția sistemului — atunci când fac clic pe „actualizează” (check now) în interfața web — rezultatul execuției depinde de vremea de pe Marte, în special pe serviciile complexe care necesită zeci de secunde pentru a se finaliza. Un astfel de rezultat este o chestiune normală.

- În general, pe baza statisticilor de funcționare timp de șase luni a celor două sisteme alături, Nagios a funcționat întotdeauna mai repede decât Icinga și asta mă enervează foarte mult. Cred că acolo s-a stricat ceva cu temporizatoarele iar verificarea la fiecare cinci minute, de fapt, se face la cinci minute și treizeci sau cam așa ceva.
- Dacă repornesc serviciul în orice moment (systemctl restart icinga2) — toate verificările care erau în curs de desfășurare la acel moment vor genera o alertă critical pe ecran și din exterior pare că s-a prăbușit totul ().
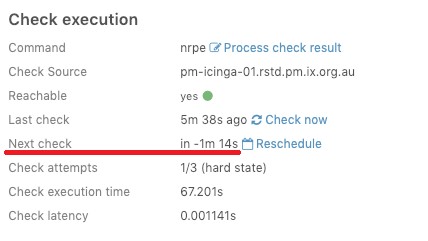
Dar în general — funcționează.
Sursa: habr.com
