

Salut, Habr! Vă prezint traducerea autorului articolului .
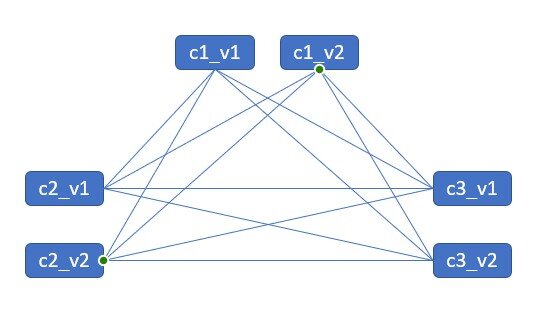
În vremurile în care lumea IT trece treptat la microservicii și instrumente precum Kubernetes, devine din ce în ce mai evident o singură problemă. Această problemă este versiunilor microserviciilor. Totuși, comunitatea IT consideră că situația de astăzi este semnificativ mai bună decât tehnologiile din generația anterioară. Cu toate acestea, gestionarea versiunilor microserviciilor este o problemă destul de complexă. Unul dintre dovezile acestui lucru pot fi articolele precum .
Dacă citind acest text nu înțelegeți încă problema, permiteți-mi să explic. Să presupunem că produsul dvs. constă din 10 microservicii. Acum să presupunem că pentru fiecare dintre aceste microservicii apare o versiune nouă. Doar o versiune – sper că toți putem fi de acord că acesta este un fapt destul de trivial și nesemnificativ. Acum, însă, să ne uităm din nou la produsul nostru. Cu o singură versiune nouă pentru fiecare componentă, acum avem 2^10 – sau 1024 permutări despre cum putem compune produsul nostru.
Dacă mai există neînțelesuri, permiteți-mi să detaliez matematica. Deci, avem 10 microservicii, fiecare primește o actualizare. Asta înseamnă că obținem 2 versiuni posibile pentru fiecare microserviciu (fie vechea, fie noua). Acum, pentru fiecare dintre componentele produsului, putem folosi oricare dintre aceste două versiuni. Din punct de vedere matematic, este același lucru cu a avea un număr binar de 10 cifre. De exemplu, să zicem că 1 este versiunea nouă, iar 0 este versiunea veche – atunci o permutare posibilă poate fi reprezentată ca 1001000000 – unde prima și a patra componente sunt actualizate, dar toate celelalte nu. Din matematică știm că un număr binar de 10 cifre poate avea 2^10 sau 1024 valori. Asta înseamnă că am confirmat amploarea numărului cu care ne confruntăm.
Să continuăm raționamentul mai departe – ce se va întâmpla dacă avem 100 de microservicii și fiecare are 10 versiuni posibile? Întreaga situație devine destul de neplăcută – acum avem 10^100 permutări – un număr gigantic. Cu toate acestea, prefer să descriu această situație exact așa, pentru că acum nu ne ascundem în spatele cuvintelor precum „kubernetes”, ci ne confruntăm cu problema așa cum este.
De ce mă fascinează atât de mult această problemă? Parțial pentru că, lucrând anterior în domeniul NLP și AI, am discutat mult despre problema exploziei combinaționale acum 5-6 ani. Doar că, în loc de versiuni, aveam cuvinte separate, iar în loc de produse aveam propoziții și paragrafe. Și, deși problemele din NLP și AI rămân în mare parte nerezolvate, trebuie să recunoaștem că, în ultimii câțiva ani, s-a realizat un progres substanțial. (în opinia mea, progresul ar fi putut fi maimare, dacă oamenii din industrie ar acorda puțin mai puțin atenție învățării automate și puțin mai multor tehnici alternative — dar acesta este deja un subiect off-topic).
Revenind la lumea DevOps și microserviciilor. În fața noastră se află o problemă uriașă, care se ascunde ca un elefant într-un muzeu de curiozități — pentru că ceea ce aud adesea este „ia kubernetes și helm, și totul va fi bine!” Dar nu, lucrurile nu vor fi bine dacă le lăsăm așa. Mai mult, soluția analitică a acestei probleme nu pare acceptabilă din cauza complexității. La fel ca în NLP, ar trebui să ne abordăm întâi această problemă prin restrângerea domeniului de căutare — în acest caz, prin excluderea permutărilor învechite.
Unul dintre lucrurile care poate ajuta — am scris anul trecut De asemenea, este important de menționat că un proces CI/CD bine structurat ajută mult la reducerea variațiilor. Totuși, starea actuală a CI/CD nu este suficient de bună pentru a rezolva problema permutărilor fără un instrumentar suplimentar pentru contabilizarea și urmărirea componentelor.
Ceea ce ne trebuie — este un sistem de experimente în etapa de integrare, unde am putea defini factorul de risc pentru fiecare componentă, precum și să avem un proces automatizat de actualizare a diferitelor componente și testare fără intervenția operatorului — pentru a vedea ce funcționează și ce nu.
Un astfel de sistem de experimente ar putea arăta astfel:
- Dezvoltatorii scriu teste (acesta este un pas critic — pentru că altfel nu avem un criteriu de evaluare — este ca și cum am avea nevoie de marcare a datelor în învățarea automată).
- Fiecare componentă (proiect) primește propriul său sistem CI — acest proces este bine structurat în ziua de azi, iar întrebarea de a crea un sistem CI pentru o componentă individuală este, în mare parte, rezolvată.
- „Sistemul inteligent de integrare” colectează rezultatele diferitelor sisteme CI și adună componentele proiectelor într-un produs final, lansează testarea și, în final, calculează cea mai scurtă cale pentru a obține funcționalitatea dorită a produsului pe baza componentelor existente și a factorilor de risc. Dacă actualizarea nu este posibilă, acest sistem informează dezvoltatorii despre componentele disponibile și despre care dintre acestea se produce o eroare. Repet, sistemul de teste este critic — deoarece sistemul de integrare folosește testele ca și criteriu de evaluare.
- Un sistem CD, care apoi primește date din „Sistemul inteligent de integrare” și efectuează efectiv actualizarea. Această etapă finalizează ciclul.
În concluzie, una dintre cele mai mari probleme pentru mine în prezent este lipsa unei „Sisteme inteligente de integrare” care să conecteze diferitele componente într-un produs și, astfel, să permită urmărirea modului în care produsul este structurat în ansamblu. M-ar interesa părerile comunității în legătură cu acest subiect (spoiler — în prezent lucrez la un proiect , care ar putea deveni o astfel de sistem inteligent de integrare).
Un ultim lucru pe care vreau să-l menționez este că pentru mine un monolit nu este acceptabil pentru orice proiect de dimensiuni medii. Mă îndoiesc serios de încercările de a accelera timpul de implementare și calitatea dezvoltării întorcându-ne la un monolit. În primul rând, monolitul are o problemă similară cu gestionarea componentelor — printre diferitele biblioteci din care este format, totuși, toate acestea nu sunt atât de evidente și se manifestă în principal în timpul pe care îl petrec dezvoltatorii. O consecință a problemei monolitului este imposibilitatea reală de a aduce modificări în cod — și o viteză de dezvoltare extrem de lentă.
Microserviciile îmbunătățesc situația, totuși, arhitectura microserviciilor se confruntă cu problema exploziei combinatoriale în etapa de integrare. Da, în ansamblu, am mutat aceeași problemă — de la etapa de dezvoltare la etapa de integrare. Totuși, din punctul meu de vedere, abordarea microservicelor duce totuși la rezultate mai bune, iar echipele obțin rezultate mai repede (probabil în principal datorită reducerii dimensiunii unității de dezvoltare — sau batch size). Totuși, trecerea de la monolit la microservicii nu a adus încă o îmbunătățire suficientă a procesului — explozia combinațiilor de versiuni ale microserviciilor reprezintă o problemă enormă, iar noi avem un mare potențial de a îmbunătăți situația pe măsură ce o rezolvăm.
Sursa: habr.com
