

Bună ziua tuturor! Sunt dezvoltator de CV la KROK. Deja de 3 ani implementăm proiecte în domeniul CV. De-a lungul acestui timp am făcut multe, spre exemplu: am monitorizat șoferii pentru a ne asigura că în timpul condusului nu beau, nu fumează, nu vorbesc la telefon, se concentrează pe drum și nu visează cu ochii deschiși sau privesc spre nori; am observat persoanele care conduc pe benzile dedicate și care ocupă mai multe locuri de parcare; am vegheat asupra faptului că angajații poartă căști, mănuși etc.; am identificat angajații care doreau să acceseze un obiectiv; am numărat tot ce se putea număra.
La ce vreau să ajung cu asta?
În procesul implementării proiectelor, am acumulat multe experiențe, multe provocări, iar cu unele dintre probleme voi fiți fie familiarizați, fie vă veți familiariza în viitor.
Să modelăm o situație
Să ne imaginăm că ne-am angajat într-o companie tânără "N", ale cărei activități sunt legate de ML. Lucrăm la un proiect de ML (DL, CV), apoi, din diverse motive, ne mutăm la alt loc de muncă, în general facem o pauză, și ne întoarcem fie la rețeaua noastră, fie la alta.
- Ajunge momentul adevărului, trebuie să ne amintim cum am ramas, ce hiperparametrii am testat și, cel mai important, la ce rezultate au dus. Pot exista multe variante despre cum a fost stocată informația pentru toate execuțiile: în minte, în configurații, în notițe, în medii de lucru în cloud. Am avut ocazia să văd un variantă în care hiperparametrii erau stocați sub formă de linii comentate în cod, așa că imaginația a zburdat. Și acum imaginați-vă că nu v-ați întors la propriul vostru proiect, ci la proiectul unei persoane care a părăsit compania și a lăsat în urmă un cod și un model denumit model_1.pb. Pentru a completa tabloul și a transmite întreaga durere, să presupunem că sunteți și un specialist începător.
- Să mergem mai departe. Pentru a rula codul, noi și toți cei care vor lucra cu el trebuie să creăm un mediu. Adesea, se întâmplă ca și acest mediu să nu fi fost lăsat moștenire din diverse motive. Aceasta poate deveni de asemenea o sarcină complicată. Nu ne dorim să pierdem timp pentru acest pas, nu-i așa?
- Antrenăm modelul (de exemplu, un detector de mașini). Ajungem la momentul în care devine chiar decent — este timpul să salvăm rezultatul. Să-l numim car_detection_v1.pb. Apoi, antrenăm încă unul — car_detection_v2.pb. După o vreme, colegii noștri sau noi înșine continuăm să învățăm și să învățăm, folosind arhitecturi diferite. În cele din urmă, se formează o mulțime de artefacte, informațiile despre care trebuie să le adunăm cu răbdare (dar vom face asta mai târziu, pentru că avem deocamdată lucruri mai prioritare).
- Ei bine, asta e tot! Avem un model! Putem să ne apucăm de antrenarea următorului model, de dezvoltarea unei arhitecturi pentru rezolvarea unei noi sarcini sau putem merge să bem o cană de ceai? Dar cine se va ocupa de implementare?
Identificăm problemele
Lucrul la un proiect sau produs este efortul multor oameni. Cu timpul, oamenii vin și pleacă, proiectele se înmulțesc, iar ele devin mai complexe. Într-un fel sau altul, situațiile din ciclul descris mai sus (și nu numai) în diverse combinații vor apărea de la o iterație la alta. Toate acestea se transformă în pierderi de timp, confuzie, nervi, poate - nemulțumirea clientului, și în final - pierderi financiare. Deși toți noi, de obicei, pășim pe aceleași greble, cred că nimeni nu vrea să trăiască aceste momente din nou și din nou.
Așadar, am parcurs un ciclu de dezvoltare și vedem că sunt probleme ce trebuie rezolvate. Pentru asta, este nevoie de:
- a stoca rezultatele în mod convenabil;
- a face simplu procesul de integrare a noilor angajați;
- a simplifica procesul de desfășurare a mediului de dezvoltare;
- a configura procesul de versiune a modelelor;
- a avea un mod convenabil de validare a modelelor;
- a găsi un instrument pentru gestionarea stării modelelor;
- a găsi o metodă de livrare a modelelor în producție.
Se pare că trebuie să inventăm un flux de lucru care să permită gestionarea ușoară și convenabilă a acestui ciclu de viață? Această practică are un nume: MLOps.
MLOps, sau DevOps pentru învățarea automată, permite echipelor de specialiști în prelucrarea și analiza datelor și IT-ului să colaboreze, precum și să accelereze dezvoltarea și desfășurarea modelelor prin monitorizare, verificare și un sistem de gestionare pentru modelele de învățare automată.
Poți , ce cred băieții de la Google despre toate acestea. Din articol reiese că MLOps este un concept destul de amplu.
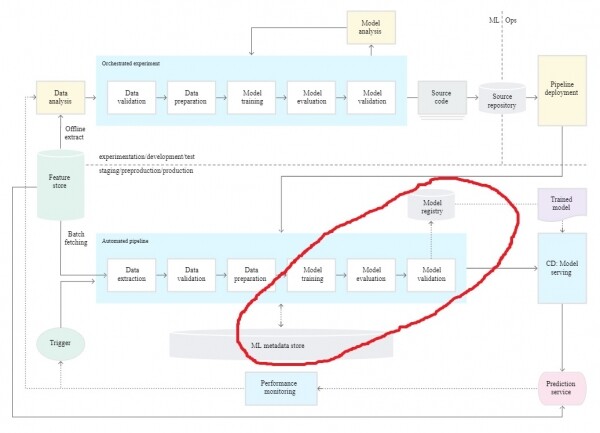
În continuare, în articolul meu, voi descrie doar o parte a procesului. Pentru implementare, voi folosi instrumentul MLflow, deoarece este un proiect open-source, necesită doar un cod mic pentru conectare și are integrare cu framework-uri ML populare. Puteți căuta pe internet alte instrumente, cum ar fi Kubeflow, SageMaker, Trains etc., și poate găsi pe cel care se potrivește mai bine nevoilor dumneavoastră.
"Construim" MLOps pe exemplul utilizării instrumentului MLFlow
MLFlow este o platformă cu sursă deschisă pentru gestionarea ciclului de viață al modelelor ML ().
MLflow include patru componente:
- MLflow Tracking – se ocupă de înregistrarea rezultatelor și a parametrilor care au dus la aceste rezultate;
- MLflow Project – permite ambalarea codului și reproducerea acestuia pe orice platformă;
- MLflow Models – se ocupă de implementarea modelelor în producție;
- MLflow Registry – permite stocarea modelelor și gestionarea stării acestora într-un depozit centralizat.
MLflow operează cu două entități:
- rularea – este ciclul complet de învățare, parametrii și metricile pe care dorim să le înregistrăm;
- experiment – este „tema” care unește rulările.
Toți pașii exemplului sunt implementați pe sistemul de operare Ubuntu 18.04.
1. Desfășurăm serverul
Pentru a putea gestiona cu ușurință proiectul nostru și a obține toate informațiile necesare, vom desfășura un server. Serverul de urmărire MLflow are două componente principale:
- backend store – se ocupă de stocarea informațiilor despre modelele înregistrate (suportă 4 baze de date: mysql, mssql, sqlite și postgresql);
- artifact store – se ocupă de stocarea artefactelor (suportă 7 tipuri de stocare: Amazon S3, Azure Blob Storage, Google Cloud Storage, server FTP, server SFTP, NFS, HDFS).
Ca artifact store pentru simplificare, să luăm serverul sftp.
- creăm un grup
$ sudo groupadd sftpg - adăugăm utilizator și îi setăm o parolă
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - corectăm câteva setări de acces
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - adăugăm câteva linii în /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - reporniți serviciul
$ sudo systemctl restart sshd
Ca backend store să luăm postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Creează un utilizator nou: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Introduceți numele rolului de adăugat: mlflow_user
Introduceti parola pentru rolul nou: mlflow
Introduceti-o din nou: mlflow
Rolul nou va fi superuser? (y/n) n
Rolul nou va avea permisiunea de a crea baze de date? (y/n) n
Rolul nou va avea permisiunea de a crea alte roluri? (y/n) n
# Creează baza de date mlflow_bd deținută de mlflow_user
$ createdb -O mlflow_user mlflow_db
Pentru a rula serverul, este necesar să instalăm următoarele pachete Python (îți recomand să creezi un mediu virtual separat):
pip install mlflow
pip install pysftp
Pornim serverul nostru
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Adăugăm tracking-ul
Pentru a ne asigura că rezultatele antrenamentelor noastre nu se pierd, pentru ca viitoarele generații de dezvoltatori să înțeleagă ce s-a întâmplat, iar colegii mai vechi și tu să puteți analiza procesul de învățare în liniște, trebuie să adăugăm tracking. Tracking-ul se referă la salvarea parametrilor, metricilor, artefactelor și oricăror informații suplimentare despre desfășurarea antrenamentului, în cazul nostru, pe server.
Pentru exemplu, am creat un mic pe Keras pentru segmentarea tuturor elementelor din . Pentru a adăuga tracking-ul, am creat fișierul mlflow_training.py.
Iată liniile în care se întâmplă cele mai interesante lucruri:
def run(self, epochs, lr, experiment_name):
        # obține id-ul experimentului, creând un experiment în absența sa
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # creând un "run" și obținând id-ul său
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # indicăm că dorim să salvăm rezultatele pe un server la distanță
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Aici, self.remote_server este un mic wrapper pentru metodele mlflow.tracking. MlflowClient (l-am creat pentru comoditate), prin care creez un experiment și un flux pe server. Ulterior, specific unde ar trebui să se salveze rezultatele execuției (mlflow.set_tracking_uri(self.tracking_uri)). Activez logarea automată mlflow.keras.autolog(). În prezent, MLflow Tracking suportă logarea automată pentru TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Dacă nu ați găsit framework-ul sau biblioteca dorită, puteți să logați explicit. Începem antrenamentul. Înregistrăm etichetele și parametrii de intrare pe serverul remote.
Câteva rânduri și aveți, ca toți cei interesați, acces la informațiile despre toate execuțiile. Cool?
3. Organizăm proiectul
Acum vom face astfel încât să lansarea proiectului să fie cât mai simplă. În acest scop, vom adăuga un fișier MLproject și conda.yaml în rădăcina proiectului.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lista de categorii din setul de date coco'}
        epochs: {type: int, help: 'numărul de epoci în antrenament'}

        lr: {type: float, default: 0.001, help: 'rata de învățare'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'exemplu resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'adresa serverului'}
        experiment_name: {type: str, default: 'My_experiment', help: 'numele experimentului remote și local'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
Proiectul MLflow are mai multe proprietăți:
- Nume — numele proiectului dumneavoastră;
- Medii — în cazul meu, conda_env indică faptul că pentru execuție se folosește Anaconda și descrierea dependențelor se află în fișierul conda.yaml;
- Puncte de intrare — indică ce fișiere și cu ce parametrii putem lansa (toți parametrii la lansarea antrenamentului se loghează automat)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Ca mediu de execuție, puteți utiliza docker, pentru mai multe informații, consultați .
4. Lansăm antrenamentul
Clonăm proiectul și mergem în directorul proiectului:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Pentru a lansa, trebuie să instalați bibliotecile
pip install mlflow
pip install pysftp
Deoarece în exemplul meu folosesc conda_env, pe computerul dumneavoastră ar trebui să fie instalată Anaconda (dar acest lucru poate fi ocolit instalând toate pachetele necesare manual și experimentând cu parametrii de lansare).
Toți pașii pregătitori sunt finalizați și putem începe să lansăm antrenamentul. Din rădăcina proiectului:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .După introducerea comenzii, va fi creat automat un mediu conda și va începe antrenamentul.
În exemplul de mai sus, am transmis numărul de epoci pentru antrenament, categoriile pe care dorim să le segmentăm (lista completă poate fi consultată ) și adresa serverului nostru remote.
Lista completă a parametrilor disponibili poate fi consultată în fișierul MLproject.
5. Evaluăm rezultatele antrenamentului
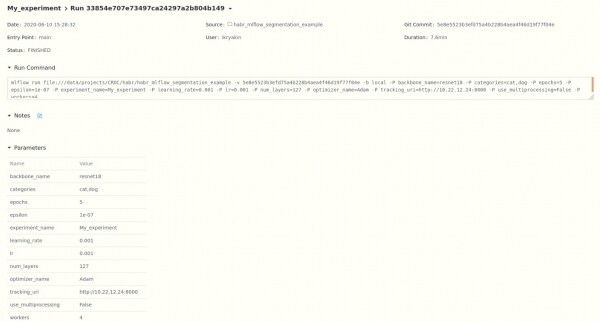
După finalizarea antrenamentului, putem accesa în browser adresa serverului nostru
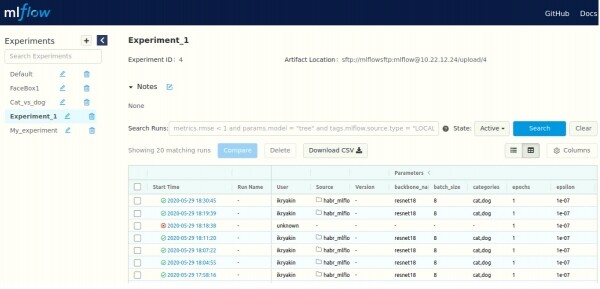
Aici vedem lista tuturor experimentelor (în colțul din stânga sus), precum și informații despre lansări (în mijloc). Putem vizualiza informații mai detaliate (parametrii, metrice, artefacte și unele informații suplimentare) pentru fiecare lansare.
Pentru fiecare metrică putem observa istoricul modificărilor
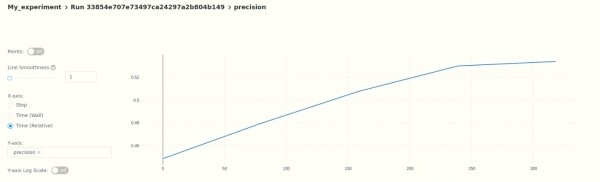
Adică, în prezent, putem analiza rezultatele în mod "manual", de asemenea, puteți seta și validare automată folosind API-ul MLflow.
6. Înregistrăm modelul
După ce am analizat modelul nostru și am decis că este gata pentru utilizare, trecem la înregistrarea acestuia, alegând lansarea dorită (așa cum este prezentat în punctul anterior) și mergem mai jos.
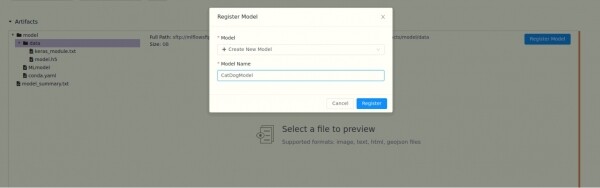
După ce am dat un nume modelului nostru, acesta primește o versiune. Când salvăm un alt model cu același nume, versiunea va fi crescută automat.
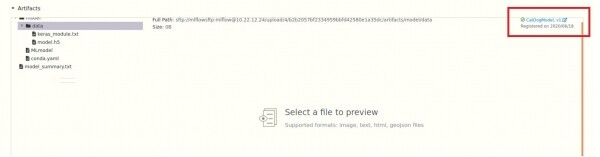
Pentru fiecare model putem adăuga o descriere și alege unul dintre cele trei stări (Staging, Production, Archived), ulterior putem accesa aceste stări prin API, ceea ce, împreună cu versiunea, oferă flexibilitate suplimentară.
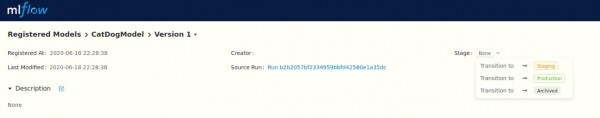
De asemenea, avem acces convenabil la toate modelele
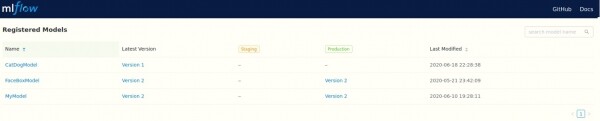
și versiunile lor
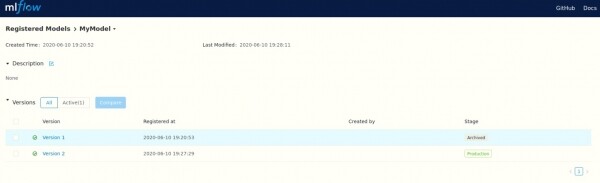
La fel ca în punctul anterior, toate operațiunile pot fi efectuate folosind API-ul.
7. Implementăm modelul
În acest stadiu, avem deja un model antrenat (keras). Iată un exemplu de cum îl putem folosi:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Aici, self.registry este din nou un mic wrapper peste mlflow.tracking.MlflowClient, pentru comoditate. Esența este că mă adresez unui server de la distanță și caut acolo un model cu numele specificat, și anume, cea mai recentă versiune de producție. Apoi, descărăm artefactul local în folderul .\/model și construim modelul din acest director mlflow.keras.load_model(local_path). Acum putem folosi modelul nostru. Dezvoltatorii CV (ML) pot continua să îmbunătățească modelul și să publice versiuni noi.
În concluzie
Am creat un sistem care permite:
- stocarea centralizată a informațiilor despre modelele ML, procesul și rezultatele antrenamentului;
- dezvoltarea rapidă a unui mediu de dezvoltare;
- urmărirea și analiza progresului în lucrul cu modelele;
- gestionarea ușoară a versiunilor și a stării modelelor;
- deploarea facilă a modelelor obținute.
Acest exemplu este unul de început și servește ca punct de plecare pentru construirea propriului sistem, care poate include automatizarea evaluării rezultatelor și înregistrarea modelelor (punctele 5 și 6, respectiv) sau ar putea să adăugați versiuni ale seturilor de date, sau poate altceva? Am încercat să transmit ideea că aveți nevoie de MLOps în general, MLflow este doar un mijloc pentru atingerea scopului.
Scrieți ce probleme v-ați întâlnit, pe care nu le-am menționat?
Ce ați adăuga în sistem pentru a satisface nevoile dumneavoastră?
Ce instrumente și abordări folosiți pentru a rezolva toate sau unele probleme?
P.S. Voi lăsa câteva linkuri:
proiect github —
MLflow —
Emailul meu de lucru, pentru întrebări — ikryakin@croc.ru
În compania noastră, organizăm periodic diferite evenimente pentru specialiștii IT, cum ar fi: pe 8 iulie la ora 19:00 (ora Moscovei) va avea loc un miting online pe tema CV-urilor. Dacă ești interesat, poți participa; înregistrarea este deschisă. .
Sursa: habr.com
