

Introducere
Cu ceva timp în urmă, am fost însărcinat să dezvolt un cluster tolerant la defecte pentru , care funcționează în mai multe centre de date interconectate prin fibră optică într-un singur oraș și capabil să suporte defectarea (de exemplu, pierderea alimentării) a unui centru de date. Ca software responsabil pentru toleranța la defecte, am ales , deoarece este soluția oficială de la RedHat pentru crearea clusterelor tolerate la defecte. Este avantajos deoarece RedHat oferă suport pentru aceasta și, în plus, soluția este versatilă (modulară). Cu ajutorul său, se poate asigura toleranța la defecte nu doar pentru PostgreSQL, ci și pentru alte servicii, fie utilizând module standard, fie creându-le pentru nevoile specifice.
Pentru această soluție, s-a ivit o întrebare rezonabilă: cât de tolerant va fi clusterul tolerant la defecte? Pentru a investiha acest lucru, am dezvoltat un laborator de testare care imită diverse defecte la nodurile clusterului, așteaptă restabilirea funcționalității, restaurează nodul defectat și continuă testarea în ciclu. Inițial, acest proiect a fost numit hapgsql, dar cu vremea m-am plictisit de un nume cu o singură vocală. Așadar, bazele de date tolerate la defecte (și IP-urile float care le indică) le-am început să le numesc krogan (un personaj dintr-un joc video care are toate organele vitale duplicate), iar nodurile, clusterele și proiectul în sine — tuchanka (planeta unde locuiesc kroganii).
Acum conducerea a aprobat . README-ul va fi tradus în curând în limba engleză (deoarece se așteaptă ca principalii consumatori să fie dezvoltatorii de Pacemaker și PostgreSQL), iar vechea variantă a README-ului în rusă am decis să o prezint (parțial) sub formă de acest articol.
Clusterele sunt desfășurate pe mașini virtuale . Vor fi desfășurate în total 12 mașini virtuale (în total 36GiB), care formează 4 clustere tolerate la defecte (variante diferite). Primele două clustere constau din două servere PostgreSQL, care sunt amplasate în diferite centre de date, și un server comun witness c quorum device (amplasat pe o mașină virtuală ieftină în al treilea centru de date), care rezolvă incertitudinea 50%/50%, oferindu-și votul pentru una dintre părți. Al treilea cluster este în trei centre de date: un master, două slave, fără quorum device. Clust erul patru este format din patru servere PostgreSQL, câte două pentru fiecare centru de date: un master și celelalte replica, și utilizează de asemenea witness c quorum device. Clusterul patru rezistă la defecțiunea a două servere sau a unui centru de date. Această soluție poate fi, dacă este necesar, extinsă la un număr mai mare de replici.
Serviciul de timp exact de asemenea este reconfigurat pentru disponibilitate ridicată, dar utilizează metoda ntpd (orphan mode). Serverul general witness funcționează ca un server NTP central, furnizând timpul său tuturor clusterelor, astfel sincronizând toate serverele între ele. Dacă witness se defectează sau devine izolat, atunci unul dintre serverele din cluster va începe să ofere timpul său (în interiorul clusterului). Un proxy de cache HTTP proxy de asemenea este ridicat pe witness, cu ajutorul căruia celelalte mașini virtuale au acces la repozitoarele Yum. În realitate, servicii precum timpul exact și proxy-ul vor fi cu siguranță găzduite pe servere dedicate, însă în stand acestea sunt plasate pe witness doar pentru a economisi numărul de mașini virtuale și spațiu.
Versiuni
v0. Funcționează cu CentOS 7 și PostgreSQL 11 pe VirtualBox 6.1.
Structura clusterelor
Toate clusterele sunt destinate găzduirii în mai multe centre de date, fiind unite într-o rețea plată și trebuie să reziste la defecțiunea sau izolarea de rețea a unui centru de date. Prin urmare, nu este posibil să se utilizeze pentru a proteja de split-brain tehnologia standard Pacemaker, care se numește STONITH (Shoot The Other Node In The Head) sau fencing. Conceputul este: dacă nodurile din cluster încep să suspecteze că ceva nu este în regulă cu un nod, nu răspunde sau se comportă incorect, acestea îl deconectează forțat prin dispozitive „externe”, cum ar fi un card de control IPMI sau un UPS. Dar aceasta va funcționa doar în cazurile în care, în cazul unei defecțiuni unice a serverului, IPMI sau UPS continuă să funcționeze. Aici este prevăzută o protecție împotriva unei defecțiuni mult mai catastrofale, când întregul centru de date se defectează (de exemplu, rămâne fără energie). În cazul unei astfel de defecțiuni, toate stonith-dispozitivele (IPMI, UPS etc.) nu vor funcționa nici ele.
În schimb, sistemul se bazează pe ideea de vot. Toate nodurile au drept de vot, iar funcționează doar cele care văd mai mult de jumătate din toate nodurile. Această cantitate „jumătate + 1” se numește cvorum. Dacă nu se adună cvorumul, nodul decide că se află în izolare de rețea și trebuie să își dezactiveze resursele, adică este o astfel de protecție împotriva split-brain. Dacă software-ul care răspunde de acest comportament nu funcționează, atunci va trebui să intervină un watchdog, de exemplu, bazat pe IPMI.
Dacă numărul de noduri este par (cluster în două centre de date), atunci poate apărea așa-numita incertitudine 50%/50% (fifty-fifty), când izolarea de rețea împarte clusterul exact în două. Prin urmare, pentru un număr par de noduri se adaugă quorum device — un demon nepretențios care poate fi pornit pe cea mai ieftină mașină virtuală din al treilea centru de date. Acesta își dă votul unuia dintre segmente (pe care îl vede), astfel rezolvând incertitudinea 50%/50%. Serverul pe care va fi pornit dispozitivul de cvorum l-am numit witness (terminologie din repmgr, mi-a plăcut).
Resursele pot fi mutate dintr-un loc în altul, de exemplu, de pe servere defecte pe cele funcționale sau la comanda administratorilor de sistem. Pentru ca clienții să știe unde se află resursele de care au nevoie (unde să se conecteze?), se folosesc IP-uri flotante (float IP). Acestea sunt IP-uri pe care Pacemaker le poate muta între noduri (totul se află într-o rețea plată). Fiecare dintre ele simbolizează o resursă (serviciu) și va fi situat acolo unde trebuie să te conectezi pentru a accesa acest serviciu (în cazul nostru BD).
Tuchanka1 (schema cu compactare)
Structura
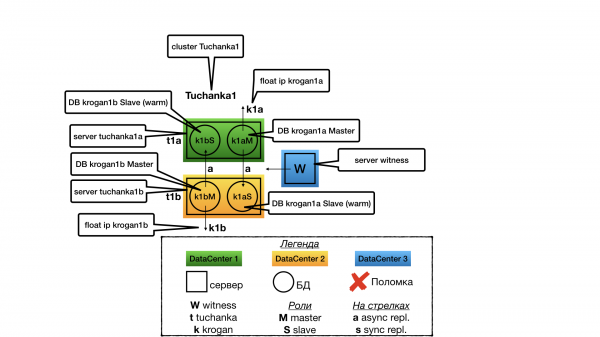
Ideea a fost că avem multe baze de date mici cu o sarcină scăzută, pentru care nu este rentabil să întreținem un server slave dedicat în modul hot standby pentru tranzacții read only (nu este nevoie de o astfel de risipă de resurse).
În fiecare centru de date există un server. Fiecare server are două instanțe PostgreSQL (în terminologia PostgreSQL, acestea se numesc clustere, dar pentru a evita confuzia, le voi numi instanțe, în analogie cu alte baze de date, iar clusterele le voi numi doar clustere Pacemaker). O instanță funcționează în modul master, și doar ea oferă servicii (doar la ea se face referință cu IP flotant). Cealaltă instanță funcționează ca slujitor pentru al doilea centru de date și va oferi servicii doar dacă masterul său va cădea. Deoarece, în majoritatea timpului, doar o instanță din două (masterul) va oferi servicii (va executa cereri), toate resursele serverului sunt optimizate pentru master (se alocă memorie pentru cache shared_buffers etc.), dar astfel încât și a doua instanță să aibă suficiente resurse (chiar și pentru o funcționare suboptimală prin cache-ul sistemului de fișiere) în cazul unei defecțiuni a unuia dintre centrele de date. Slujitorul nu oferă servicii (nu execută cereri read only) în timpul funcționării normale a clustere, pentru a evita o competiție pentru resurse cu masterul pe aceeași mașină.
În cazul a două noduri, toleranța la defecțiuni este posibilă doar în cazul replicării asincrone, deoarece în cazul replicării sincrone, căderea slujitorului va duce la oprirea masterului.
Defecțiunea witness
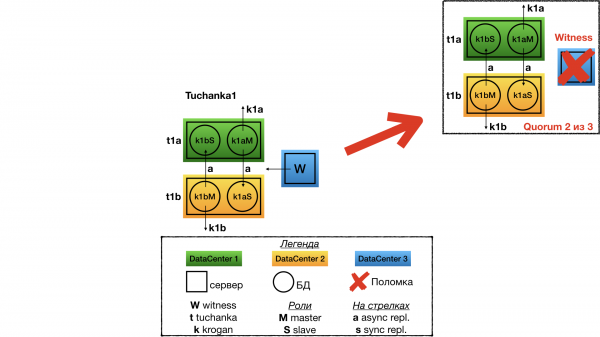
Defecțiunea witness (quorum device) o voi lua în considerare doar pentru clusterul Tuchanka1, cu toate celelalte va fi aceeași poveste. În cazul unei defecțiuni a witness-ului, structura clusterului nu se va schimba, totul va continua să funcționeze la fel ca și până acum. Însă cvorumul va deveni 2 din 3, astfel încât orice defecțiune ulterioară va deveni fatală pentru cluster. Oricum, va trebui reparat urgent.
Defecțiunea Tuchanka1
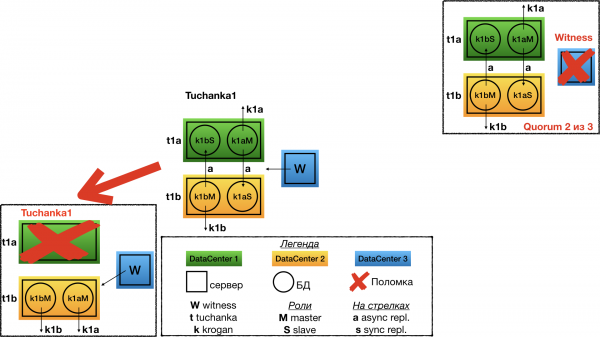
Defecțiunea unuia dintre centrele de date pentru Tuchanka1. În acest caz witness își dă votul celui de-al doilea nod de la al doilea centru de date. Acolo, fostul slujitor se transformă în master, rezultatul fiind că ambele mastere funcționează pe un singur server, iar ambele au referințe la IP-urile lor flotante.
Tuchanka2 (clasic)
Structura
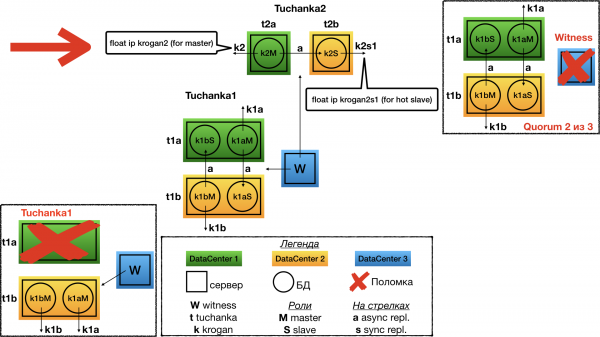
Schema clasică din două noduri. Pe unul funcționează masterul, pe celălalt slujitorul. Ambele pot executa cereri (slujitorul doar read only), de aceea ambele au referințe la IP flotant: krogan2 — pentru master, krogan2s1 — pentru slujitor. Toleranța la defecțiuni va exista atât pentru master, cât și pentru slujitor.
În cazul a două noduri, toleranța la defecțiuni este posibilă doar în cazul replicării asincrone, deoarece în cazul replicării sincrone, căderea slujitorului va duce la oprirea masterului.
Defecțiunea Tuchanka2
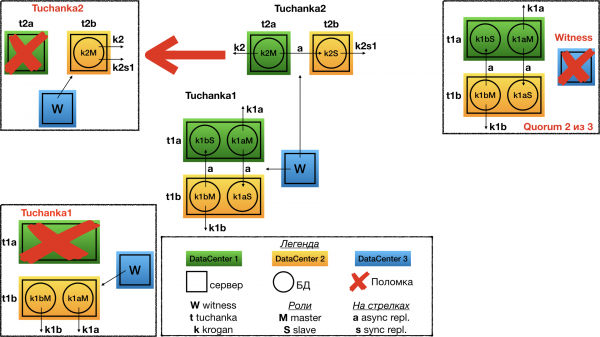
În cazul unei defecțiuni a unuia dintre centrele de date witness votează pentru al doilea. Pe singurul centru de date funcțional va fi ridicat un master, iar ambele IP float: cel master și cel de lucru îi vor indica. Desigur, instanța trebuie să fie configurată astfel încât să aibă suficiente resurse (limite pentru conexiuni etc.) pentru a gestiona în mod simultan toate conexiunile și cererile de la IP-urile float master și slave. Asta înseamnă că în condiții normale de funcționare, ar trebui să aibă un rezervor suficient de limite.
Tuchanka4 (multe slave)
Structura
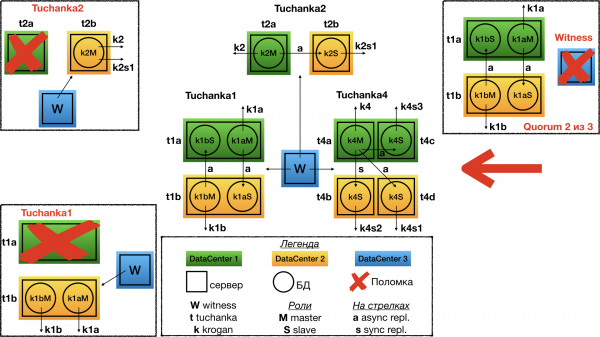
Este deja o altă extremă. Există baze de date care primesc foarte multe cereri de tip read-only (situația tipică a unui site cu încărcare mare). Tuchanka4 este o situație în care slavele pot fi trei sau mai multe pentru a gestiona aceste cereri, dar totuși nu prea multe. La un număr foarte mare de slave, va trebui să se inventeze un sistem ierarhic de replicare. În cel mai simplu caz (în imagine), în fiecare dintre cele două centre de date se află câte două servere, pe fiecare dintre ele câte o instanță PostgreSQL.
O altă caracteristică a acestui sistem este că aici se poate organiza deja o replicare sincronă. Aceasta este configurată pentru a replica, dacă este posibil, într-un alt centru de date, și nu pe o replică în același centru de date cu masterul. La master și la fiecare slave se indică un IP float. Ideal ar fi ca între slave să se efectueze un balansare a cererilor folosind un sql proxy, de exemplu, pe partea clientului. Fiecare tip de client poate necesita un tip diferit sql proxy, și doar dezvoltatorii clienților știu cine ce are nevoie. Această funcționalitate poate fi implementată fie cu un demon extern, fie cu o bibliotecă client (connection pool) etc. Toate acestea depășesc subiectul clusterului de baze de date tolerant la defecțiuni (toleranța la defecțiuni SQL proxy poate fi implementat independent, împreună cu toleranța la defecțiuni a clientului).
Defecțiunea Tuchanka4
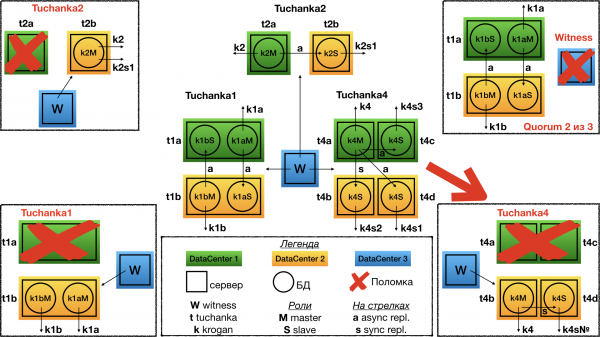
În cazul defecțiunii unui centru de date (adică a două servere), martorul votează pentru al doilea. Drept rezultat, în al doilea centru de date funcționează două servere: pe unul funcționează masterul, iar acesta indică IP-ul float master pentru primirea cererilor read-write; iar pe cel de-al doilea server funcționează un slave cu replicare sincronă, care este indicat de unul dintre IP-urile float slave (pentru cererile read-only).
Primul lucru de menționat: nu toate IP-urile float slave vor fi funcționale, ci doar unul. Și pentru a funcționa corect cu acesta, va fi necesar ca sql proxy redirigează toate cererile către singurul IP float rămas; iar dacă sql proxy nu, atunci se pot enumera toate IP-urile float ale sclavilor prin virgulă în URL pentru conectare. În acest caz, libpq conexiunea va fi la primul IP funcțional, așa cum este implementat în sistemul de testare automată. Este posibil ca în alte biblioteci, de exemplu, JDBC, să nu funcționeze așa și să fie necesar sql proxy. Așa s-a realizat deoarece pentru IP-urile float ale sclavilor există o interdicție de a se ridica simultan pe același server, astfel încât acestea să se distribuie uniform pe serverele sclav, dacă sunt mai multe.
Al doilea: chiar și în cazul unei defecțiuni a centrului de date, va rămâne o replicare sincronă. Și chiar dacă va avea loc o a doua defecțiune, adică în centrul de date rămas va ieși din funcțiune unul dintre cele două servere, clusterul, deși va înceta să ofere servicii, va păstra totuși informațiile despre toate tranzacțiile confirmate, pentru care a dat o confirmare de commit (nu va exista pierdere de informații în cazul unei a doua defecțiuni).
Tuchanka3 (3 centre de date)
Structura
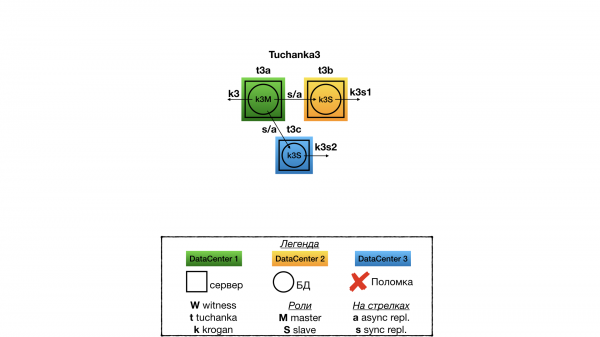
Acesta este un cluster pentru situația în care există trei centre de date complet funcționale, în fiecare dintre care există un server Bază de Date complet funcțional. În acest caz quorum device nu este necesar. Într-un centru de date funcționează masterul, iar în celelalte două — sclavii. Replicarea este sincronă, tip ANY (slave1, slave2), adică clientului îi va veni o confirmare a commitului atunci când oricare dintre sclavi răspunde întâi că a acceptat commitul. Resursele sunt indicate de un IP float pentru master și două pentru sclavi. Spre deosebire de Tuchanka4, toate cele trei IP-uri float sunt rezistente la erori. Pentru balansarea interogărilor SQL read-only se poate folosi sql proxy (cu o rezistență la erori separată), fie să aloce un IP float sclav unei jumătăți din clienți, iar celeilalte jumătăți — al doilea.
Defecțiunea Tuchanka3
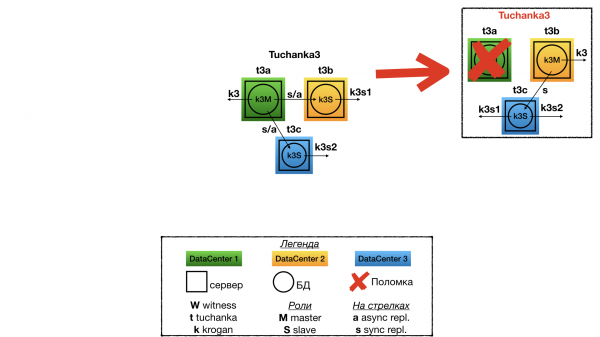
În cazul unei defecțiuni a unuia dintre centrele de date, rămân două. În unul este ridicat masterul și IP-ul float de la master, iar în celălalt — sclavul și ambele IP-uri float ale sclavilor (pe instanță trebuie să existe un rezervor dublu pentru resurse, pentru a accepta toate conexiunile de la ambele IP-uri float ale sclavilor). Între master și sclav există replicare sincronă. De asemenea, clusterul va păstra informații despre tranzacțiile confirmate și aprobate (nu va exista pierdere de informații) în cazul distrugerii a două centre de date (dacă acestea nu sunt distruse simultan).
Am decis să nu includ o descriere detaliată a structurii fișierelor și desfășurării. Cei care doresc să experimenteze pot citi toate acestea în README. Prezentăm doar descrierea testării automate.
Sistem de testare automată
Pentru a verifica rezistența la defecțiuni a clusterele prin simularea diferitelor defecte, a fost realizat un sistem de testare automată. Aceasta este pornită printr-un script test/failure. Scriptul poate accepta ca parametri numerele clustere pe care doriți să le testați. De exemplu, această comandă:
test/failure 2 3va testa doar al doilea și al treilea cluster. Dacă parametrii nu sunt specificați, toate clusterele vor fi testate. Toate clusterele sunt testate simultan, iar rezultatul este afișat în panoul tmux. Tmux folosește un server tmux dedicat, așadar scriptul poate fi pornit din tmux-ul implicit, ceea ce va duce la un tmux înnodat. Vă recomand să folosiți un terminal într-o fereastră mare și cu un font mic. Înainte de a începe testarea, toate mașinile virtuale sunt restaurate la un snapshot de la finalizarea scriptului. setup.
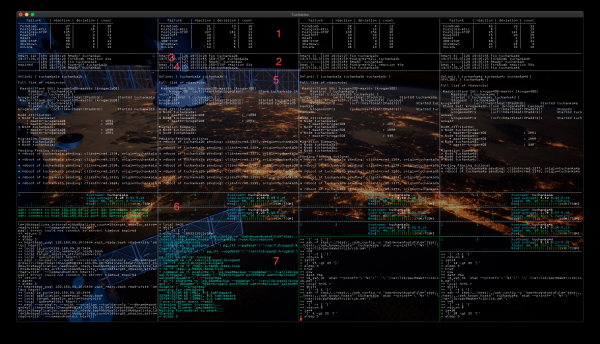
Terminalul este împărțit în coloane în funcție de numărul clustere testate, implicit (în captură de ecran) acestea sunt patru. Conținutul coloanelor îl voi explica folosind exemplul Tuchanka2. Panourile din captură sunt numerotate:
- Aici este afișată statistica testelor. Coloanele:
- failure — numele testului (funcția din script) care simulează o defecțiune.
- reaction — media aritmetică a timpului în secunde în care clusterul și-a restabilit funcționalitatea. Este măsurat de la începutul execuției scriptului care simulează defecțiunea până în momentul în care clusterul își restabilește funcționalitatea și poate continua să ofere servicii. Dacă timpul este foarte mic, de exemplu, șase secunde (aceasta se întâmplă în clustere cu mai mulți muncitori (Tuchanka3 și Tuchanka4)), înseamnă că defecțiunea a avut loc pe un muncitor asincron și nu a afectat în niciun fel funcționalitatea, nu au fost schimbări de stare ale clusterului.
- deviation — arată variabilitatea (precizia) valorii reaction prin metoda „deviației standard”.
- count — câte ori a fost executat acest test.
- Un jurnal scurt permite evaluarea activității curente a clusterului. Afișează numărul iterației (testului), un timestamp și numele operației. O execuție prea lungă (>5 minute) sugerează o problemă.
- heart (inimă) — timpul curent. Pentru evaluarea vizuală a funcționării maestrului în tabelul său se scrie constant timpul curent folosind IP-ul float al maestrului. În caz de succes, rezultatul este afișat în acest panou.
- bătăi (puls) — „timpul curent”, care a fost anterior înregistrat de script heart în maestru, acum este citit din servitor prin intermediul IP-ului său float. Permite evaluarea vizuală a funcționării servitorului și replicării. În Tuchanka1 nu există servitori cu IP float (nu există servitori care oferă servicii), dar există două instanțe (Bază de Date), așa că aici nu va fi afișat bătăi, iar heart a doua instanță.
- Monitorizarea stării clusterului cu ajutorul utilitarului
pcs mon. Afișează structura, distribuția resurselor pe noduri și alte informații utile. - Aici este afișată monitorizarea sistemului din fiecare mașină virtuală a clusterului. Poate exista mai multe astfel de panouri — câte mașini virtuale sunt în cluster. Două grafice Încărcarea CPU (în mașinile virtuale sunt câte două procesoare), numele mașinii virtuale, Încărcarea sistemului (denumită Load Average, deoarece este mediată pe 5, 10 și 15 minute), date despre procese și distribuția memoriei.
- Urmarirea scriptului care efectuează testarea. În caz de defectare — întreruperea bruscă a funcționării sau ciclu infinit de așteptare — aici se va putea observa cauza acestui comportament.
Testarea se desfășoară în două etape. Mai întâi, scriptul trece prin toate tipurile de teste, alegând aleatoriu o mașină virtuală la care să aplice acest test. Apoi se execută un ciclu infinit de testare, mașinile virtuale și defectarea fiind alese aleatoriu de fiecare dată. Finalizarea bruscă a testului scriptului (panoul de jos) sau ciclu infinit de așteptare pentru ceva (> 5 minute timp de execuție pentru o operațiune, se poate observa în urmărire) indică faptul că unul dintre teste a eșuat pe acest cluster.
Fiecare test este compus din următoarele operațiuni:
- Lansarea unei funcții care emulează o pană.
- Gata? — așteptarea restabilirii funcționării clusterului (când toate serviciile sunt disponibile).
- Se afișează timpul de așteptare pentru restabilirea clusterului (reaction).
- Fixare — clusterul „se repară”. După care ar trebui să revină la o stare complet funcțională și pregătit pentru o nouă pană.
Iată lista testelor cu descrierea a ceea ce fac:
- ForkBomb: creează "Out of memory" folosind o bombă fork.
- OutOfSpace: umple discul de stocare. Însă testul este mai mult simbolic, având în vedere încărcătura neglijabilă creată în timpul testării; în cazul umplerii discului de stocare, PostgreSQL de obicei nu se defectează.
- Postgres-KILL: oprește PostgreSQL cu comanda
killall -KILL postgres. - Postgres-STOP: suspendă PostgreSQL cu comanda
killall -STOP postgres. - PowerOff: „oprește” virtuala cu comanda
VBoxManage controlvm "virtuală" poweroff. - Reset: repornește virtuala cu comanda
VBoxManage controlvm "virtuală" reset. - SBD-STOP: suspendă demonul SBD cu comanda
killall -STOP sbd. - ShutDown: trimite comanda către virtuală prin SSH
systemctl poweroff, sistemul finalizează corect operațiunile. - UnLink: izolare de rețea, comanda
VBoxManage controlvm "virtuală" setlinkstate1 off.
Finalizarea testului fie prin intermediul comenzii standard tmux "kill-window" Ctrl-b &, fie cu comanda "detach-client" Ctrl-b d: acest lucru finalizează testarea, tmux se închide, virtualele se opresc.
Probleme identificate în timpul testării
În acest moment demonul watchdog sbd gestionează oprirea demonilor monitorizați, dar nu și suspendarea lor. Și, ca urmare, defecțiunile nu sunt gestionate corect, ceea ce duce la suspendarea doar Corosync și Pacemaker, dar fără a suspenda sbd. Pentru verificare Corosync este deja disponibil , acceptat în ramura master. Au promis (în PR#83) că va exista ceva similar și pentru Pacemaker, sper că la RedHat 8 vor face. Dar astfel de „defecțiuni” sunt teoretice, ușor de imitat artificial cu ajutorul, de exemplu,
killall -STOP corosync, dar niciodată întâlnite în viața reală.În Pacemaker versiunea pentru CentOS 7 sunt setate greșit sync_timeout u quorum device, ca rezultat , pe care masterul ar fi trebuit să se mute. S-a remediat prin creșterea sync_timeout u quorum device în timpul desfășurării (în scriptul
setup/setup1). Această corectare nu a fost acceptată de dezvoltatori Pacemaker, în schimb, au promis să reproiecteze infrastructura astfel (într-un viitor oarecare), astfel încât acest timeout să fie calculat automat.Dacă în configurarea bazei de date se specifică că în
LC_MESSAGES(mesajele text) se poate folosi Unicode, de exemplu,ru_RU.UTF-8, atunci la lansare postgres într-un mediu în care localele nu sunt UTF-8, de exemplu, într-un mediu gol (aici pacemaker+pgsqlms(paf) se lansează postgres), atunci . Dezvoltatorii PostgreSQL nu au convenit ce să facă în acest caz. Se poate ocoli, trebuie să se setezeLC_MESSAGES=en_US.UTF-8la configurarea (crearea) unei instanțe DB.Dacă este setat wal_receiver_timeout (în mod implicit 60s), atunci în testul PostgreSQL-STOP pe master în clusterele tuchanka3 și tuchanka4 . Replicarea este acolo sincronizată, astfel că nu se oprește doar slave-ul, ci și noul master. Se poate evita prin setarea wal_receiver_timeout=0 la configurarea PostgreSQL.
Rareori am observat suspendarea replicării la PostgreSQL în testul ForkBomb (supraîncărcarea memoriei). . Am întâlnit asta doar în clusterele tuchanka3 și tuchanka4, unde, din cauza replicării sincronizate, masterul a rămas suspendat. Problema s-a rezolvat de la sine, după un timp îndelungat (aproape două ore). Este necesară o cercetare suplimentară pentru a remedia această problemă. Ca simptome, seamănă cu o eroare anterioară, care este cauzată de o altă problemă, dar are consecințe similare.
Imaginea kroganului este preluată de la cu permisiunea autorului:
Sursa: habr.com
