

Vreau să împărtășesc cu voi prima mea experiență de succes în restaurarea completă a funcționalității bazei de date Postgres. Am intrat în contact cu SGBD Postgres acum șase luni, iar înainte de aceasta nu aveam deloc experiență în administrarea bazelor de date.
Lucrez ca inginer semi-DevOps într-o mare companie IT. Compania noastră se ocupă cu dezvoltarea de software pentru servicii foarte solicitate, iar eu răspund de funcționarea, întreținerea și desfășurarea aplicațiilor. Mi s-a dat o sarcină standard: să actualizez aplicația pe un server. Aplicația este scrisă în Django, iar în timpul actualizării se execută migrațiile (modificarea structurii bazei de date), iar înainte de acest proces facem un dump complet al bazei de date prin programul standard pg_dump, pentru orice eventualitate.
În timpul realizării dump-ului a apărut o eroare neașteptată (versiunea Postgres – 9.5):
pg_dump: Eșec la extragerea conținutului tabelului “ws_log_smevlog”: PQgetResult() a eșuat.
pg_dump: Mesaj de eroare de la server: ERROR: pagină invalidă în blocul 4123007 al relației base/16490/21396989
pg_dump: Comanda a fost: COPY public.ws_log_smevlog [...]
pg_dump: [arhitectură paralelă] un proces worker a eșuat neașteptat
Eroare „pagină invalidă în bloc” indicând probleme la nivelul sistemului de fișiere, ceea ce este foarte grav. Pe diverse forumuri s-au sugerat următoarele: FULL VACUUM cu opțiunea zero_damaged_pages pentru a rezolva această problemă. Ei bine, să încercăm...
Pregătirea pentru restaurare
ATENȚIE! Asigurați-vă că faceți o copie de siguranță a Postgres înainte de orice încercare de a restaura baza de date. Dacă aveți o mașină virtuală, opriți baza de date și faceți un snapshot. Dacă nu aveți posibilitatea de a face un snapshot, opriți baza și copiați conținutul directorului Postgres (inclusiv fișierele wal) într-un loc sigur. Cel mai important în tot acest proces este să nu agravați situația. Citiți .
Deoarece în general baza mea a funcționat, m-am limitat la un dump obișnuit al bazei de date, dar am exclus tabela cu datele corupte (opțiunea -T, —exclude-table=TABLE în pg_dump).
Serverul era fizic, nu a fost posibil să fac un snapshot. Backup-ul a fost realizat, să trecem mai departe.
Verificarea sistemului de fișiere
Înainte de a încerca restaurarea bazei de date, trebuie să ne asigurăm că totul este în regulă cu sistemul de fișiere. Și în cazul unor erori, să le corectăm, deoarece, în caz contrar, am putea agrava doar situația.
În cazul meu, sistemul de fișiere cu baza de date era montat în „/srv” iar tipul era ext4.
Oprim baza de date: systemctl stop postgresql@9.5-main.service și verificăm că sistemul de fișiere nu este folosit de nimeni și că poate fi demontat cu comanda lsof:
lsof +D /srv
A trebuit să opresc și baza de date redis, deoarece și aceasta era utilizată „/srv”. Apoi am demontat /srv (umount).
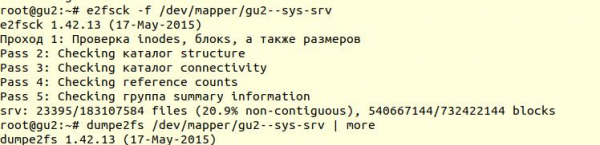
Verificarea sistemului de fișiere a fost efectuată cu utilitarul e2fsck cu opțiunea -f (Forțează verificarea, chiar dacă sistemul de fișiere este marcat ca fiind curat):
Apoi, cu ajutorul utilitarului dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) poți verifica că de fapt s-a efectuat verificarea:
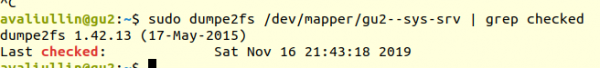
e2fsck spune că nu s-au găsit probleme la nivelul sistemului de fișiere ext4, iar asta înseamnă că putem continua încercările de recuperare a bazei de date, mai precis să revenim la vacuum full (firește, trebuie să remontăm sistemul de fișiere și să repornim baza de date).
Dacă ai un server fizic, asigură-te să verifici starea discurilor (prin smartctl -a /dev/XXX) sau a controller-ului RAID, pentru a te asigura că problema nu este la nivel hardware. În cazul meu, RAID-ul s-a dovedit a fi "fizic", așa că am cerut administratorului local să verifice starea RAID-ului (serverul era la câteva sute de kilometri distanță de mine). El a spus că nu sunt erori, ceea ce înseamnă că putem începe recuperarea.
Încercarea 1: zero_damaged_pages
Ne conectăm la baza de date prin psql cu un cont de superutilizator. Avem nevoie de un superutilizator, deoarece opțiunea zero_damaged_pages poate fi modificată doar de el. În cazul meu, acesta este postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Opțiune zero_damaged_pages este necesară pentru a ignora erorile de citire (din site-ul postgrespro):
Atunci când se detectează un cap de pagină corupt, Postgres Pro de obicei raportează o eroare și întrerupe tranzacția curentă. Dacă parametrul zero_damaged_pages este activat, în schimb, sistemul emite un avertisment, resetează pagina coruptă în memorie și continuă procesarea. Această comportare distruge datele, adică toate rândurile din pagina coruptă.
Activăm opțiunea și încercăm să facem vacuum full pe tabel:
VACUUM FULL VERBOSE 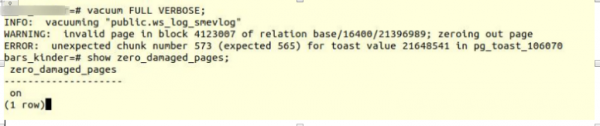
Din păcate, eșec.
Ne-am confruntat cu o eroare similară:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mecanismul de stocare a "datelor lungi" în Postgres, dacă acestea nu se încadrează într-o singură pagină (implicit 8kB).
Încercarea 2: reindex
Primul sfat de pe google nu a ajutat. După câteva minute de căutare, am găsit al doilea sfat – să fac reindex a tabelului deteriorat. Acest sfat l-am întâlnit în multe locuri, dar nu inspira încredere. Să facem reindexare:
reindexare tabel ws_log_smevlog 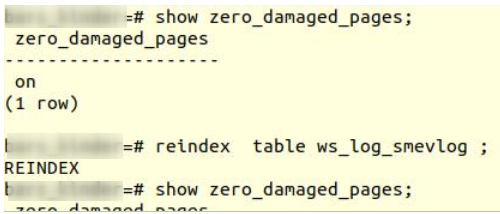
reindex s-a încheiat fără probleme.
Cu toate acestea, nu a ajutat, VACUUM FULL s-a încheiat cu o eroare similară. Fiind obișnuit cu eșecurile, am început să caut sfaturi online și am dat peste o destul de interesantă .
Încercarea 3: SELECT, LIMIT, OFFSET
În articolul de mai sus, s-a sugerat să se verifice tabela rând cu rând și să se elimine datele problematice. În primul rând, trebuie să revizuiesc toate rândurile:
for ((i=0; i/dev/null || echo $i; doneîn cazul meu, tabela conținea 1 628 991 rânduri! Ar fi trebuit să mă ocup de , dar aceasta este o temă pentru o discuție separată. Era sâmbătă, am lansat această comandă în tmux și am mers să dorm:
for ((i=0; i/dev/null || echo $i; doneDimineața am decis să verific cum stau lucrurile. Spre surprinderea mea, am descoperit că în 20 de ore au fost scanate doar 2% din date! Nu voiam să aștept 50 de zile. O altă eșec total.
Dar nu am renunțat. M-am întrebat de ce scanarea dura atât de mult. Din documentație (iarăși pe postgrespro) am aflat:
OFFSET indică sări peste un anumit număr de rânduri înainte de a începe să returneze rândurile.
Dacă sunt specificate atât OFFSET, cât și LIMIT, sistemul sare mai întâi peste rândurile OFFSET și apoi începe să contorizeze rândurile pentru limita LIMIT.Când aplicați LIMIT, este important să folosiți și clauza ORDER BY, astfel încât rândurile rezultatelor să fie returnate într-o anumită ordine. Altfel, pot fi returnate submulțimi imprevizibile de rânduri.
Este evident că comanda scrisă mai sus a fost greșită: în primul rând, nu era order by, rezultatul ar fi putut fi greșit. În al doilea rând, Postgres trebuia mai întâi să scaneze și să sară peste rândurile OFFSET, iar odată cu creșterea OFFSET performanța ar scădea și mai mult.
Încercarea 4: a lua un dump în format text
Apoi, mi-a venit în minte o idee care părea genială: să iau un dump în format text și să analizez ultima linie înregistrată.
Dar pentru început, să ne familiarizăm cu structura tabelului ws_log_smevlog:
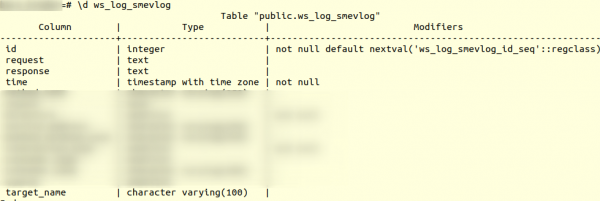
În cazul nostru, avem o coloană "id", care conținea un identificator unic (contor) pentru rând. Planul era următorul:
- Începem să facem un dump în format text (sub formă de comenzi SQL)
- La un moment dat, salvarea dump-ului s-ar fi întrerupt din cauza unei erori, dar fișierul text ar fi fost totuși salvat pe disc
- Ne uităm la sfârșitul fișierului text, astfel găsim identificatorul (id) ultimei linii care a fost salvată cu succes
Am început să fac dump-ul în format text:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpDump-ul, așa cum era de așteptat, s-a întrerupt cu aceeași eroare:
pg_dump: Mesajul de eroare de la server: ERROR: pagină invalidă în blocul 4123007 din baza de date relation base/16490/21396989 Apoi, prin tail am vizualizat sfârșitul dump-ului (tail -5 ./my_dump.dump) am descoperit că dump-ul s-a întrerupt la linia cu id 186 525. „Asta înseamnă că problema este la linia cu id 186526, este coruptă, trebuie să o șterg!” - m-am gândit. Dar, făcând o interogare în baza de date:
«select * from ws_log_smevlog where id=186529s-a descoperit că această linie este în regulă... Liniile cu indecșii 186530 - 186540 au funcționat de asemenea fără probleme. O altă „idee genială” a eșuat. Mai târziu am înțeles de ce s-a întâmplat asta: când se șterg sau se modifică datele din tabel, ele nu sunt șterse fizic, ci marcate ca „tupluri moarte”, apoi intervine autovacuum și marchează aceste linii ca șterse și permite reutilizarea acestora. Pentru înțelegerea, dacă datele din tabel se schimbă și autovacuum este activat, atunci ele nu sunt păstrate secvențial.
Încercarea 5: SELECT, FROM, WHERE id=
Eșecurile ne fac mai puternici. Nu trebuie niciodată să renunți, trebuie să mergi până la capăt și să crezi în tine și în abilitățile tale. De aceea am decis să încerc o altă variantă: să vizualizez toate înregistrările din baza de date pe rând. Ținând cont de structura tabelului meu (vezi mai sus), avem un câmp id, care este unic (cheie primară). În tabel avem 1.628.991 de linii și id ele sunt numerotate, ceea ce înseamnă că putem pur și simplu să le parcurgem una câte una:
for ((i=1; i/dev/null || echo $i; doneDacă cineva nu înțelege, comanda funcționează astfel: parcurge linie cu linie tabelul și trimite stdout în /dev/null, dar dacă comanda SELECT eșuează, se afișează textul erorii (stderr este trimis în consolă) și se afișează linia care conține eroarea (datorită ||, care semnifică faptul că select a întâmpinat probleme (codul de returnare al comenzii nu este 0)).
Am avut noroc, pentru că am avut indici creați pe câmp id:
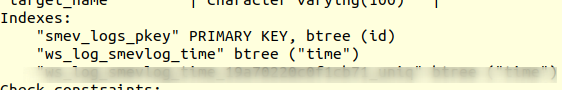
Și asta înseamnă că găsirea unei linii cu id-ul dorit nu ar trebui să dureze mult. În teorie, ar trebui să funcționeze. Așa că, să lansăm comanda în , demonul și mergem la somn.
Dimineața am descoperit că au fost vizualizate aproximativ 90 000 de înregistrări, ceea ce reprezintă puțin peste 5%. Un rezultat excelent, în comparație cu metoda precedentă (2%)! Dar nu voiam să aștept 20 de zile...
Încercarea 6: SELECT, FROM, WHERE id >= și id <
Clientul avea alocat un server excelent pentru baza de date: un server dual-processor Intel Xeon E5-2697 v2, și aveam la dispoziție nu mai puțin de 48 de fire! Sarcina pe server era medie, astfel că puteam prelua fără probleme aproximativ 20 de fire. De asemenea, aveam suficientă memorie RAM: nu mai puțin de 384 de gigabyte!
Prin urmare, comanda trebuia să fie paralelizată:
for ((i=1; i/dev/null || echo $i; doneAici puteam scrie un script frumos și elegant, dar am ales cea mai rapidă metodă de paralelizare: să împart manual intervalul 0-1628991 în segmente de 100 000 de înregistrări și să lansez separat 16 comenzi de tipul:
for ((i=N; i/dev/null || echo $i; doneDar asta nu este tot. Teoretic, conectarea la baza de date ia și ceva timp și resurse sistemice. Să conectez 1 628 991 nu era foarte rațional, ești de acord? Așadar, hai să extragem 1000 de linii la o singură conectare în loc de una. În cele din urmă, comanda s-a transformat în aceasta:
for ((i=N; i=$i and id/dev/null || echo $i; doneDeschidem 16 feronieruri în sesiunea tmux și lansăm comenzile:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
După o zi, am primit primele rezultate! Anume (valorile XXX și ZZZ nu au fost salvate):
EROARE:  numărul de chunk lipsă 0 pentru valoarea toast 37837571 în pg_toast_106070
829000
EROARE:  numărul de chunk lipsă 0 pentru valoarea toast XXX în pg_toast_106070
829000
EROARE:  numărul de chunk lipsă 0 pentru valoarea toast ZZZ în pg_toast_106070
146000
Asta înseamnă că avem trei înregistrări cu erori. ID-urile primelor și celor de-a doua înregistrări problematice se aflau între 829 000 și 830 000, iar ID-ul celei de-a treia era între 146 000 și 147 000. Apoi, trebuia să găsim valoarea exactă a ID-urilor înregistrărilor problematice. Pentru aceasta, vom analiza intervalul nostru cu înregistrările problematice cu pas de 1 și identificăm ID-urile:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  chunk number 2 neașteptat (așteptat 0) pentru valoarea toast 37837843 în pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  chunk number ZZZ neașteptat (așteptat 0) pentru valoarea toast XXX în pg_toast_106070
146911
Final fericit
Am găsit înregistrările problematice. Ne conectăm la baza de date prin psql și încercăm să le ștergem:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Spre surprinderea mea, înregistrările s-au șters fără nicio problemă chiar și fără opțiunea zero_damaged_pages.
Apoi m-am conectat la baza de date, am făcut VACUUM FULL (cred că nu era necesar), și, în cele din urmă, am reușit să fac o copie de rezervă cu ajutorul pg_dump. Copia de rezervă a fost creată fără erori! Problema a fost rezolvată într-un mod atât de simplu. Bucuria a fost infinită, după atâtea eșecuri am reușit să găsesc o soluție!
Mulțumiri și concluzii
Aceasta a fost prima mea experiență în restaurarea unei baze de date Postgres reale. Această experiență o voi ține minte mult timp.
Și, în final, aș dori să mulțumesc companiei PostgresPro pentru documentația tradusă în limba rusă și pentru , care m-au ajutat foarte mult în timpul analizei problemei.
Sursa: habr.com
