

Compania noastră se ocupă cu managementul infrastructurilor și suportul tehnic 24/7 pentru proiecte web încă din 2008: avem peste 400 de clienți, reprezentând aproximativ 15% din comerțul electronic din Rusia. Prin urmare, arhitectura suportată este foarte diversă. Dacă ceva cedează, trebuie să reparăm în termen de 15 minute. Dar pentru a înțelege că a avut loc o avarie, este necesar să monitorizăm proiectul și să reacționăm la incidente. Dar cum facem acest lucru?
Consider că în cadrul organizației, o sistemă de monitorizare corectă este crucială. Dacă nu ar exista probleme, discursul meu ar consta într-o singură teza: „Vă rog, instalați Prometheus + Grafana și pluginurile 1, 2, 3”. Din păcate, acum nu mai funcționează așa. Problema principală este că toată lumea continuă să creadă în ceva care a existat în 2008, din perspectiva componentelor software.
În ceea ce privește organizarea sistemului de monitorizare, îmi asum riscul de a spune că… nu există proiecte cu monitorizare competentă. Situația este atât de gravă că, dacă ceva cedează, există riscul ca acest lucru să rămână neobservat – toată lumea este convinsă că „totul este monitorizat”.
Este posibil ca totul să fie monitorizat. Dar cum?
Toți ne-am întâlnit cu o poveste asemănătoare: un devops sau un administrator lucrează, iar echipa de dezvoltatori vine și spune – „Am lansat, acum monitorizează”. Ce să monitorizez? Cum funcționează?
Bine. Monitorizăm pe vechiul sistem. Dar acesta s-a schimbat, și ne dăm seama că monitorizam serviciul A, care a devenit serviciul B, care interacționează cu serviciul C. Dar echipa de dezvoltatori îți spune: „Instalează software-ul, trebuie să monitorizeze tot!”
Așa că, ce s-a schimbat? – Totul s-a schimbat!
Anul 2008. Totul era minunat.
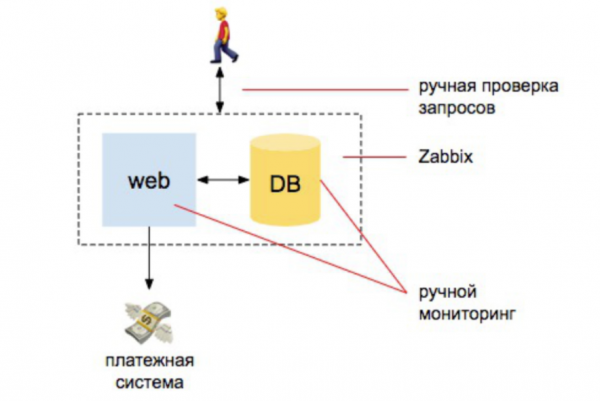
Există câțiva dezvoltatori, un server, un server de baze de date. De aici începe totul. Avem o informație oarecare, instalăm zabbix, Nagios, cacti. Apoi configurăm alerte clare pentru CPU, activitatea hard disk-urilor, spațiul pe disk. Facem câteva verificări manuale, cum ar fi că site-ul răspunde, că comenzile ajung în baza de date. Și asta e tot – suntem mai mult sau mai puțin protejați.
Comparând volumul de muncă pe care un administrator îl realiza pentru a asigura monitorizarea, 98% din aceasta era automată: persoana care se ocupă de monitorizare trebuie să înțeleagă cum să instaleze Zabbix, să-l configureze și să seteze alertele. Iar 2% sunt pentru verificările externe: dacă site-ul răspunde și face cereri către baza de date, dacă au venit noi comenzi.
2010. Crește sarcina de lucru
Începem să scalăm serverele web, adăugăm un motor de căutare. Vrem să ne asigurăm că catalogul de produse conține toate produsele. Și că căutarea produselor funcționează. Că baza de date funcționează, că comenzile sunt procesate, că site-ul răspunde extern și răspunde din diverse servere și utilizatorul nu este deconectat de pe site, în timp ce acesta este rebalansat pe un alt server, etc. Numărul entităților crește.
Însă entitatea legată de infrastructură rămâne în continuare cea mai mare în mintea managerului. Ideea că persoana care se ocupă de monitorizare este aceea care va instala Zabbix și va putea să-l configureze rămâne în continuare.
Însă apar și sarcini legate de efectuarea de verificări externe, crearea unui set de scripturi pentru cererile motorului de căutare, un set de scripturi pentru a verifica dacă căutarea se schimbă pe parcursul indexării, un set de scripturi care verifică dacă produsele sunt transmise serviciului de livrare, etc.
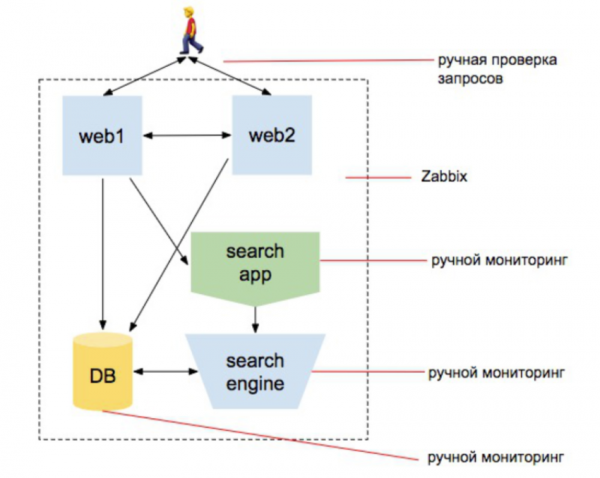
Observați: am scris de 3 ori «set de scripturi». Adică persoana responsabilă de monitorizare nu mai este doar cea care instalează Zabbix. Este cineva care începe să codeze. Dar în mintea echipei încă nu s-au petrecut schimbări.
În schimb, lumea se schimbă, devenind din ce în ce mai complexă. Se adaugă un strat de virtualizare, mai multe sisteme noi. Acestea încep să interacționeze între ele. Cine a spus „se simte a microservicii?” Dar fiecare serviciu încă arată ca un site de sine stătător. Putem să ne adresăm lui și să înțelegem că oferă informațiile necesare și funcționează de la sine. Și dacă ești administrator, dedicat unui proiect care evoluează timp de 5-7-10 ani, aceste cunoștințe se acumulează: apare un nou nivel — l-ai conștientizat, apare un alt nivel — l-ai conștientizat…
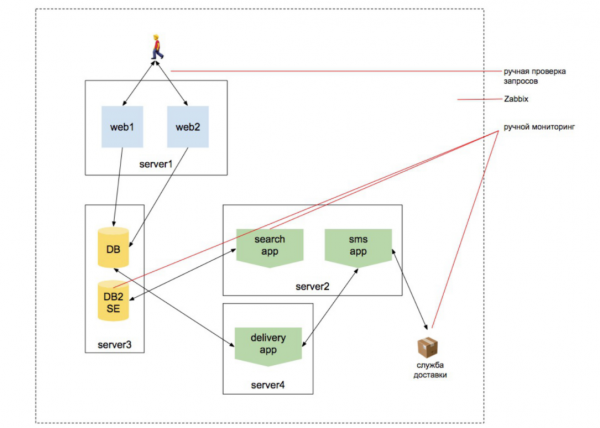
Dar rar cineva întreține un proiect timp de 10 ani.
Rezumat monitorizare
Să presupunem că ai ajuns într-un nou startup care a angajat imediat 20 de dezvoltatori, a creat 15 microservicii, iar tu ești administratorul căruia i se spune: „Construiește CI/CD. Te rog.” Ai construit CI/CD și, brusc, auzi: „Ne este greu să lucrăm cu producția în „kub”, fără să înțelegem cum va funcționa aplicația în el. Fă-ne un sandbox în acest același „kub”.
Faci un sandbox în acest kub. Imediat ți se spune: „Vrem o bază de date de stage, care să se actualizeze zilnic din producție, pentru a înțelege că acest lucru funcționează pe baza de date, dar fără a afecta baza de date de producție.”
Tu trăiești în toate acestea. Mai sunt 2 săptămâni până la lansare, și ți se spune: „Acum trebuie să monitorizăm totul...” Adică, să monitorizăm infrastructura cluster, să monitorizăm arhitectura microserviciilor, să monitorizăm interacțiunea cu serviciile externe...
Iar colegii scot din cap schema obișnuită și spun: „Dar aici totul este clar! Pune un program care să monitorizeze totul.” Da-da: Prometheus + Grafana + pluginuri.
Și adaugă pe deasupra: „Ai două săptămâni, fă să fie totul sigur.”
În multele proiecte pe care le vedem, pe monitorizare este desemnată o singură persoană. Imaginează-ți că vrem să angajăm pe cineva pentru 2 săptămâni, care să se ocupe de monitorizare, și îi facem un CV. Ce abilități ar trebui să aibă această persoană, având în vedere tot ce am spus până acum?
- Trebuie să înțeleagă monitorizarea și specificul funcționării infrastructurii hardware.
- Trebuie să cunoască specificul monitorizării Kubernetes (toată lumea vrea în „kub”, deoarece se poate abstractiza de tot, poate să se ascundă, căci administratorul se va ocupa de rest) – infrastructura sa și să știe cum să monitorizeze aplicațiile din interior.
- Trebuie să înțeleagă că serviciile comunică între ele într-un mod special și să cunoască specificitatea interacțiunii dintre acestea. Este complet real să vezi un proiect în care unele servicii comunică sincron, deoarece nu se poate altfel. De exemplu, backend-ul merge prin REST, prin gRPC la serviciul catalog, primește lista de produse și se returnează înapoi. Nu poți aștepta aici. Iar cu celelalte servicii, lucrează asincron. Trimiți o comandă la serviciul de livrare, trimiți un e-mail etc.
Probabil că deja ai obosit de toate acestea? Dar administratorul care trebuie să monitorizeze, a obosit și mai mult. - El trebuie să fie capabil să planifice și să planifice corect – deoarece volumul de muncă devine din ce în ce mai mare.
- Prin urmare, el trebuie să dezvolte o strategie pentru serviciul creat, pentru a înțelege cum să-l monitorizeze în mod specific. Are nevoie de cunoștințe despre arhitectura proiectului și evoluția sa, precum și de înțelegerea tehnologiilor utilizate în dezvoltare.
Să ne amintim un caz absolut normal: o parte din servicii sunt pe php, o altă parte pe Go, și o parte pe JS. Acestea funcționează între ele într-un fel. De aici provine termenul „microserviciu”: au apărut atât de multe sisteme separate, încât dezvoltatorii nu pot înțelege proiectul în ansamblu. O parte din echipă scrie servicii pe JS, care funcționează de sine stătător și nu știu cum funcționează restul sistemului. Cealaltă parte scrie servicii pe Python și nu se implică în modul în care funcționează celelalte servicii, fiind izolate în domeniul lor. A treia parte scrie servicii pe php sau alte tehnologii.
Toți acești 20 de oameni sunt împărțiți în 15 servicii, și există doar un singur administrator care trebuie să înțeleagă totul. Stop! Abia am împărțit sistemul în 15 microservicii, pentru că 20 de oameni nu pot înțelege întreaga sistem.
Dar trebuie cumva monitorizat...
Ce urmează? La final, există o persoană care reușește să înțeleagă tot ceea ce o echipă întreagă de dezvoltatori nu poate percepe, și în același timp, el trebuie să știe și să fie capabil să îndeplinească ceea ce am menționat mai sus – infrastructura hardware, infrastructura Kubernetes etc.
Ce să mai spunem... Houston, avem o problemă.
Monitorizarea unui proiect software modern este un proiect software în sine.
Din falsa convingere că monitorizarea este un software, ajungem să credem în minuni. Și minuni, din păcate, nu există. Nu poți instala Zabbix și aștepta să funcționeze totul. Nu are sens să instalezi Grafana și să speri că totul va fi bine. Mai mult de 90% din timp va fi dedicat organizării verificărilor funcționării serviciilor și interacțiunii dintre acestea, verificați cum funcționează sistemele externe. De fapt, majoritatea timpului se va duce nu pe scrierea scripturilor, ci pe dezvoltarea software-ului. Și acest lucru ar trebui să fie realizat de o echipă care înțelege funcționarea proiectului.
Dacă, în această situație, o singură persoană este lăsată cu monitorizarea, va avea loc o catastrofă. Așa cum se întâmplă în toată lumea.
De exemplu, există mai multe servicii care comunică între ele prin Kafka. A sosit o comandă, am trimis mesajul despre comandă în Kafka. Există un serviciu care ascultă informațiile despre comandă și gestionează livrarea bunurilor. Există un alt serviciu care ascultă informațiile despre comandă și trimite un e-mail utilizatorului. Apoi apar încă o mulțime de servicii și începem să ne amestecăm.
Și dacă mai oferiți asta administratorului și dezvoltatorilor în etapa în care a mai rămas puțin timp până la lansare, va trebui ca persoana să înțeleagă întregul protocol. Adică, un proiect de o asemenea amploare durează semnificativ timp, iar în dezvoltarea sistemului trebuie să se țină cont de acest aspect.
Dar foarte des, în special în contextul startup-urilor, vedem cum monitorizarea este amânată. „Acum vom face un Proof of Concept, vom lansa cu el, să se prăbușească – suntem dispuși să facem sacrificii. Apoi vom monitoriza totul”. Când (sau dacă) proiectul începe să aducă bani, afacerea vrea să dezvolte și mai multe funcționalități — pentru că a început să funcționeze, deci trebuie să continuăm! Și vă aflați în punctul în care, mai întâi, trebuie să monitorizați tot ce a fost anterior, ceea ce nu durează 1% din timp, ci semnificativ mai mult. Și, de altfel, pentru monitorizare vor fi necesari dezvoltatori, iar este mai ușor să-i direcționați spre noi funcționalități. În cele din urmă, se scriu noi funcționalități, totul se complică, și vă aflați într-un deadlock nesfârșit.
Cum puteți monitoriza un proiect, începând de la început, și ce trebuie să faceți dacă ați primit un proiect care trebuie monitorizat, dar nu știți cu ce să începeți?
În primul rând, trebuie să planificați.
O digresiune lirică: foarte des se începe cu monitorizarea infrastructurii. De exemplu, avem Kubernetes. Vom începe prin a instala Prometheus cu Grafana, vom adăuga plugin-uri pentru monitorizarea „kubectl”. Nu doar dezvoltatorii, ci și administratorii au o practică neplăcută: „Vom instala acest plugin, iar pluginul probabil știe cum să facă asta”. Oamenii preferă să înceapă cu lucruri simple și clare, nu cu acțiuni importante. Și monitorizarea infrastructurii este o acțiune simplă.
Pentru început, decideți ce și cum doriți să monitorizați, apoi alegeți instrumentul, deoarece alte persoane nu pot gândi pentru voi. Și ar trebui să o facă? Alte persoane s-au gândit pentru ele însele, la un sistem universal — sau deloc, când acest plugin a fost scris. Și că acest plugin are 5000 de utilizatori nu înseamnă că aduce vreo valoare. Poate că veți deveni 5001, doar pentru că au fost anterior 5000 de oameni.
Dacă ați început să monitorizați infrastructura și backend-ul aplicației dumneavoastră nu mai răspunde, toți utilizatorii vor pierde conexiunea cu aplicația mobilă. Va apărea o eroare. Oamenii vor veni la voi și vor spune: «Aplicația nu funcționează, cu ce vă ocupați?» — «Monitorizăm.» — «Cum monitorizați dacă nu vedeți că aplicația nu funcționează?!»
- Consider că trebuie să începeți monitorizarea exact de la punctul de intrare al utilizatorului. Dacă utilizatorul nu vede că aplicația funcționează — totul este pierdut, aceasta este o eșec. Și sistemul de monitorizare ar trebui să ofere o alertă cu privire la acest lucru înainte de toate.
- Și apoi putem monitoriza infrastructura. Sau putem face acest lucru în paralel. Monitorizarea infrastructurii este mai simplă — aici putem, în sfârșit, să instalăm Zabbix.
- Și acum trebuie să mergem în rădăcinile aplicației pentru a înțelege unde nu funcționează lucrurile.
Ideea mea principală este că monitorizarea ar trebui să meargă în paralel cu procesul de dezvoltare. Dacă ați desprins echipa de monitorizare pentru alte sarcini (crearea CI/CD, medii sandbox, reorganizarea infrastructurii), monitorizarea va începe să întârzie și este posibil să nu recuperați niciodată dezvoltarea (sau, mai devreme sau mai târziu, va trebui să o opriți).
Totul pe niveluri
Iată cum văd organizarea sistemului de monitorizare.
1) Nivelul aplicației:
- monitorizarea logica de afaceri a aplicației;
- monitorizarea metricilor de sănătate ale serviciilor;
- monitorizarea integrării.
2) Nivelul infrastructurii:
- monitorizarea nivelului de orchestration;
- monitorizarea software-ului de sistem;
- monitorizarea nivelului hardware.
3) Din nou, nivelul aplicației — dar ca produs ingineresc:
- colectarea și observarea jurnalelor aplicației;
- APM;
- tracing.
4) Alertare:
- organizarea sistemului de notificare;
- organizarea sistemului de rotație;
- organizarea «bazei de cunoștințe» și workflow-ul pentru gestionarea incidentelor.
Este important: ajungem la alertare nu după, ci imediat! Nu trebuie să începem monitorizarea și să ne gândim «cumva mai târziu» la cine vor ajunge alertele. Căci care este scopul monitorizării: a înțelege unde în sistem ceva nu funcționează corect și a informa persoanele competente despre acest lucru. Dacă lăsăm asta la final, persoanele competente vor afla că ceva nu este în regulă doar cu apelul «la noi nimic nu funcționează».
Nivelul aplicației — monitorizarea logicii de afaceri
Aici este vorba despre verificarea existenței faptului că aplicația funcționează pentru utilizator.
Acest nivel ar trebui să fie realizat în etapa de dezvoltare. De exemplu, avem un Prometheus ipotetic: acesta se conectează la un server care se ocupă cu verificările, apelează endpoint-ul, iar endpoint-ul se duce și verifică API-ul.
Atunci când se solicită frecvent monitorizarea paginii principale pentru a verifica dacă site-ul funcționează, programatorii oferă un endpoint pe care îl poți apela de fiecare dată când vrei să te asiguri că API-ul funcționează. Și programatorii, în acel moment, scriu și /api/test/helloworld
Singura modalitate de a te asigura că totul funcționează? — Nu!
- Crearea acestor verificări este, în esență, sarcina dezvoltatorilor. Testele unitare trebuie să fie scrise de programatorii care scriu cod. Pentru că, dacă le vei da administratorului «Frate, iată-ți lista protocoalelor API pentru cele 25 de funcții, te rog, monitorizează tot!» — nu va funcționa nimic.
- Dacă faci print “hello world”, nimeni nu va ști niciodată că API-ul ar trebui și chiar funcționează. Fiecare modificare a API-ului ar trebui să conducă la o modificare a verificărilor.
- Dacă ai deja această problemă – oprește caracteristicile și alocă dezvoltatori care să scrie aceste verificări, sau împacă-te cu pierderile, acceptă că nimic nu este verificat și se va prăbuși.
Sfaturi tehnice:
- Asigură-te că organizezi un server extern pentru realizarea verificărilor — trebuie să fii sigur că proiectul tău este accesibil pentru lumea exterioară.
- Organizează verificarea pe întregul protocol API, nu doar pe endpoint-uri individuale.
- Creează un endpoint Prometheus cu rezultatele verificărilor.
Nivelul aplicației — monitorizarea metricilor de sistem
Acum este vorba despre metricile de sistem externe ale serviciilor.
Am decis că toate „pârghile” aplicației sunt monitorizate prin intermediul unor verificări externe, pe care le apelăm dintr-un sistem de monitorizare extern. Dar acestea sunt exact „pârghile” pe care le „vede” utilizatorul. Vrem să ne asigurăm că serviciile funcționează. Aici povestea este mai bună: în K8s există verificări de integritate, astfel încât măcar „cubul” să se convingă că serviciul funcționează. Dar jumătate din verificările pe care le-am văzut sunt același print „Hello World”. Asta înseamnă că acesta este apelat o singură dată după desfășurare, iar răspunsul spune că totul este bine — și atât. Un serviciu, dacă își expune API-ul prin REST, are o mulțime de puncte de acces, aceași API, care trebuie monitorizate, pentru că vrem să știm că funcționează. Iar noi îl monitorizăm deja din interior.
Cum să implementăm corect din punct de vedere tehnic: fiecare serviciu publică un endpoint despre starea sa curentă de funcționare, iar în graficele Grafana (sau orice altă aplicație) vedem starea tuturor serviciilor.
- Fiecare modificare a API-ului trebuie să genereze o modificare a verificărilor.
- Creează un nou serviciu imediat cu metrici de sănătate.
- Admin-ul poate veni la dezvoltatori și să ceară „scrieți-mi câteva funcționalități, astfel încât să înțeleg totul și să adaug informații despre acesta în sistemul meu de monitorizare”. Dar dezvoltatorii, de obicei, răspund: „Nu vom adăuga nimic cu două săptămâni înainte de lansare”.
Să știe managerii de dezvoltare că vor fi astfel de pierderi, să știe și conducerea managerilor de dezvoltare. Pentru că, atunci când totul cade, cineva tot va suna și va cere să se monitorizeze „serviciul care pică constant” (c). - Apropo, alocați dezvoltatorii pentru a scrie plugin-uri pentru Grafana — aceasta va fi o ajutor bun pentru admini.
Nivelul aplicației — Monitorizare integrativă
Monitorizarea integrativă se concentrează pe monitorizarea comunicării între sistemele critice pentru afaceri.
De exemplu, există 15 servicii care comunică între ele. Acestea nu mai sunt site-uri separate. Adică, nu putem apela serviciul de unul singur, să obținem /helloworld și să înțelegem că serviciul funcționează. Deoarece serviciul de procesare a comenzilor trebuie să trimită informații despre comandă prin bus — din bus, serviciul de management al stocurilor trebuie să primească acest mesaj și să lucreze cu el mai departe. Iar serviciul de trimitere a e-mail-urilor trebuie să prelucreze acest lucru într-un fel, și așa mai departe.
Prin urmare, nu putem înțelege, încercând fiecare serviciu în parte, că totul funcționează. Pentru că avem un fel de bus prin care totul interacționează și comunică.
Astfel, această etapă ar trebui să reprezinte etapa de testare a serviciilor în raport cu alte servicii. Nu putem organiza monitorizarea comunicației prin monitorizarea brokerului de mesaje. Dacă există un serviciu care furnizează date și un serviciu care le primește, când monitorizăm brokerul, vom vedea doar datele care circulă în ambele direcții. Chiar dacă reușim cumva să monitorizăm interacțiunea acestor date — cum ar fi că un producător publică date, cineva le citește, acest flux continuă să meargă în Kafka — tot nu ne va oferi informații, dacă un serviciu a trimis un mesaj într-o versiune, iar alt serviciu nu s-a așteptat la această versiune și l-a ratat. Nu vom afla asta, deoarece serviciile ne vor spune că totul funcționează.
Cum recomand să facem:
- Pentru comunicarea sincronă: endpoint-ul efectuează cereri către serviciile conectate. Adică, luăm acest endpoint, apelăm un script în interiorul serviciului care trece prin toate punctele și spune 'pot apela acolo și acolo, pot apela acolo...'
- Pentru comunicarea asincronă: mesajele de intrare — endpoint-ul verifică bus-ul pentru mesaje de test și returnează starea procesării.
- Pentru comunicarea asincronă: mesajele de ieșire — endpoint-ul trimite mesaje de test pe bus.
De obicei, se întâmplă așa: avem un serviciu care trimite date pe bus. Venim la acest serviciu și cerem să ne povestească despre sănătatea sa de integrare. Și dacă serviciul trebuie să publice un mesaj mai departe (WebApp), atunci produce acest mesaj de test. Iar dacă apelăm serviciul de partea OrderProcessing, el publică mai întâi ceea ce poate publica independent, iar dacă există lucruri dependente — atunci citește un set de mesaje de test de pe bus, înțelege ce poate procesa, informează despre asta și, dacă este necesar, le publică mai departe, iar despre aceasta spune — totul este ok, sunt activ.
De multe ori auzim întrebarea „cum putem testa asta pe date reale?” De exemplu, este vorba despre același serviciu de comenzi. Comenzile trimit mesaje către depozit, unde produsele sunt contabilizate: nu putem testa asta pe date reale, deoarece „produsele mele vor fi contabilizate!” Soluția: în etapa inițială, planificați tot acest test. Aveți teste unitare care fac simulări. Așadar, faceți asta la un nivel mai profund, unde va trece canalul de comunicație, care nu va afecta funcționarea afacerii.
Nivelul infrastructurii
Monitorizarea infrastructurii - ceea ce este considerat deja monitorizarea în sine.
- Monitorizarea infrastructurii poate și trebuie să fie pornită ca un proces separat.
- Nu trebuie să începeți cu monitorizarea infrastructurii într-un proiect funcțional, chiar dacă aveți foarte multe dorințe. Este o problema comună pentru toți DevOps-ii. „Mai întâi voi monitoriza clusterul, voi monitoriza infrastructura” - adică, mai întâi va monitoriza ceea ce este la bază și nu se va ocupa de aplicație. Deoarece aplicația este un lucru neclar pentru DevOps. Au primit-o și el nu înțelege cum funcționează. Dar infrastructura o înțelege și începe cu aceasta. Însă nu - întotdeauna trebuie să monitorizăm aplicația la început.
- Nu exagerați cu numărul de alerte. Având în vedere complexitatea sistemelor moderne, alertele vin constant, iar cu această avalanșă de alerte trebuie cumva să conviețuim. Dacă o persoană on-call, după ce se uită la o sută de alerte, decide „nu vreau să mă gândesc la asta”. Alertele ar trebui să notifice doar despre lucruri critice.
Nivelul aplicației ca unitate de afaceri
Punctele cheie:
- ELK. Acesta este standardul din industrie. Dacă dintr-un anumit motiv nu agregați loguri, începeți să faceți asta imediat.
- APM. APM-urile externe ca o modalitate rapidă de a acoperi monitorizarea aplicației (NewRelic, BlackFire, Datadog). Puteți să instalați temporar această soluție pentru a înțelege ce se întâmplă în sistem.
- Tracing. În zecile de microservicii trebuie să urmăriți totul, deoarece cererea nu mai trăiește de una singură. Să adăugați ulterior este foarte greu, așa că este mai bine să planificați tracing-ul în dezvoltare - acesta este un instrument și o muncă a dezvoltatorilor. Dacă nu l-ați implementat încă - implementați-l! Consultați Jaeger/Zipkin.
Alertare
- Organizarea sistemului de alertare: în condițiile monitorizării unei mulțimi de lucruri, trebuie să existe un sistem unitar de trimitere a alertelor. Se poate folosi Grafana. În Occident, toată lumea folosește PagerDuty. Alerta trebuie să fie clară (de exemplu, de unde a venit…). Și este de dorit să controlați dacă alertările ajung efectiv.
- Organizarea sistemului de gardă: alertele nu trebuie să ajungă la toată lumea (altfel, toți vor reacționa în grup sau nimeni nu va reacționa). Cei de gardă trebuie să fie și dezvoltatorii: definiți zonele de responsabilitate, creați instrucțiuni clare și specificați exact cui să sune luni și miercuri, iar cui — marți și vineri (altfel, nu vor suna pe nimeni, chiar și în cazul unei mari probleme — se vor teme să trezească, să deranjeze: oamenii nu iubesc să sune și să trezească alte persoane, mai ales noaptea). Și explicați că apelul pentru ajutor nu este un semn de necompetență („cer ajutor — înseamnă că sunt un lucrător slab”), încurajați cererile de ajutor.
- Organizarea „bazei de cunoștințe” și a fluxului de lucru pentru gestionarea incidentelor: pentru fiecare incident sever trebuie planificat un postmortem, ca măsură temporară trebuie documentate acțiunile ce vor rezolva incidentul. Și implementați practica că alertele repetitive sunt o greșeală; trebuie remediată în cod sau în lucrările infrastructurale.
Stiva tehnologică
Să presupunem că stiva noastră este următoarea:
- colectare de date — Prometheus + Grafana;
- analiza jurnalelor — ELK;
- pentru APM sau Tracing — Jaeger (Zipkin).

Alegerea opțiunilor nu este critică. Pentru că, dacă de la început ați înțeles cum să monitorizați sistemul și ați scris un plan, mai departe începeți să alegeți instrumentele conform cerințelor voastre. Problema este ce ați ales să monitorizați la început. Deoarece, posibil, instrumentul pe care l-ați ales inițial nu este deloc potrivit pentru cerințele voastre.
Câteva aspecte tehnice pe care le observ peste tot în ultima vreme:
Prometheus este integrat în Kubernetes — cine a gândit asta?! Dacă clusterul vostru pică, ce veți face? Dacă aveți un cluster complex în interior, ar trebui să funcționeze un sistem de monitorizare în interiorul clusterului, și unul — exterior, care va colecta date din interiorul clusterului.
În interiorul clusterului colectăm jurnalele și tot ce este necesar. Dar sistemul de monitorizare trebuie să fie extern. Foarte des în clusterul unde există Prometheus, care este instalat intern, există și sisteme care efectuează verificări externe ale funcționării site-ului. Și dacă conexiunile către lumea externă cad și aplicația nu funcționează? Așadar, în interior totul este bine, dar pentru utilizatori nu devine mai ușor.
Conclusions
- Dezvoltarea monitorizării nu este doar instalarea utilitarilor, ci dezvoltarea unui produs software. 98% din monitorizarea de astăzi este codare. Codare în servicii, codare a verificărilor externe, verificarea serviciilor externe și a tot ce face parte din acestea.
- Nu economisiți timp pentru dezvoltatori pe monitorizare: aceasta poate ocupa până la 30% din munca lor, dar merită.
- DevOps, nu vă faceți griji că nu reușiți să monitorizați ceva, deoarece unele lucruri sunt cu totul altă mentalitate. Nu ați fost programatori, iar munca de monitorizare este exact treaba lor.
- Dacă proiectul funcționează deja și nu este monitorizat (iar voi sunteți manager) – alocați resurse pentru monitorizare.
- Dacă produsul este deja în producție și sunteți DevOps care a fost rugat să «configureze monitorizarea» – încercați să explicați conducerii ce am scris aici.
Aceasta este o versiune extinsă a prezentării de la conferința Saint Highload++.
Dacă sunteți interesați de ideile și reflecțiile mele pe tema IT și subiecte conexe, iată unde puteți 🙂
Sursa: habr.com
