

Este binecunoscut că competența unui CTO este verificată abia la a doua încercare de a ocupa acest rol. Pentru că este o diferență între a lucra câțiva ani într-o companie, evoluând împreună cu aceasta și, având aceeași cultură de fond, primind treptat mai multe responsabilități. Și este cu totul altceva să ajungi direct pe postul de CTO într-o companie cu un bagaj de legacy și o mulțime de probleme, meticulos măturate sub covor.
În acest sens, experiența lui Leon Fierer, pe care a împărtășit-o la , nu este neapărat unică, dar, coroborată cu vechimea și numărul diverselor roluri pe care le-a îndeplinit în cei 20 de ani, este foarte utilă. Mai jos aveți cronologia evenimentelor din 90 de zile și multe povești amuzante care sunt plăcute de auzit atunci când se întâmplă altcuiva, dar nu sunt chiar atât de amuzante când le trăiești personal.
Leon povestește foarte colorat în rusă, așa că, dacă aveți 35-40 de minute, vă recomand să vizionați video-ul. Versiunea textuală pentru a economisi timp este mai jos.
Prima versiune a raportului a fost o descriere bine structurată a muncii cu oamenii și procesele, conținând recomandări utile. Dar nu transmitea toate surprizele întâlnite pe parcurs. Prin urmare, am schimbat formatul și am prezentat problemele întâlnite în noua companie, ca un spirit dintr-o cutie, și metodele de soluționare a acestora într-o ordine cronologică.
Cu o lună înainte de
Așa cum se întâmplă adesea în poveștile frumoase, aceasta a început cu alcool. Ne aflam într-un bar cu cunoștințe, și așa cum se întâmplă în rândul IT-iștilor, fiecare își plângea de milă pentru problemele sale. Unul dintre ei recent își schimbase locul de muncă și povestea despre dificultățile întâmpinate atât cu tehnologiile, cât și cu oamenii și echipa. Cu cât îl ascultam mai mult, cu atât mai mult înțelegeam că ar trebui pur și simplu să mă angajeze, pentru că exact aceste probleme le-am rezolvat în ultimii 15 ani. Așa i-am spus, iar a doua zi ne-am întâlnit deja într-un cadru de lucru. Compania se numea Teaching Strategies.
Teaching Strategies este lider pe piața programelor educaționale pentru copiii de vârstă foarte fragedă — de la naștere până la trei ani. Compania tradițională „pe hârtie” există de aproape 40 de ani, iar versiunea sa digitală SaaS are 10 ani. Recent, a început procesul de adaptare a tehnologiilor digitale la standardele companiei. „Noua” versiune a fost lansată în 2017 și era aproape ca cea veche, doar că funcționa mai prost.
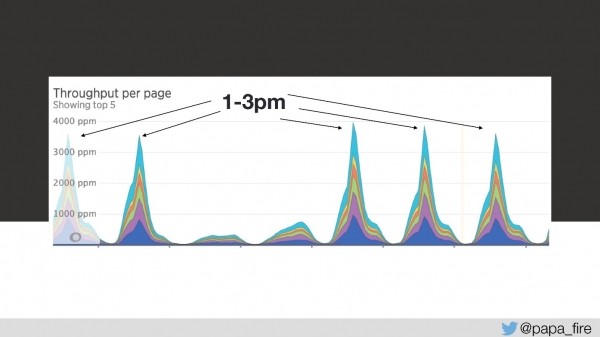
Interesant este faptul că traficul la această companie este foarte previzibil – zi de zi, an de an, se poate prezice foarte clar câți oameni vor veni și când. De exemplu, între orele 13 și 15, toți copiii din grădinițe se duc la somn, iar educatorii încep să introducă informații. Și așa se întâmplă în fiecare zi, cu excepția weekendurilor, pentru că în weekend aproape nimeni nu lucrează.
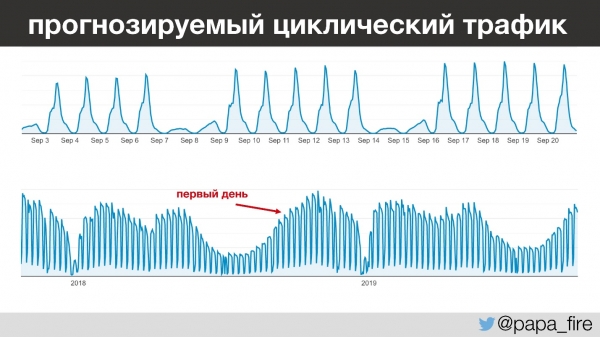
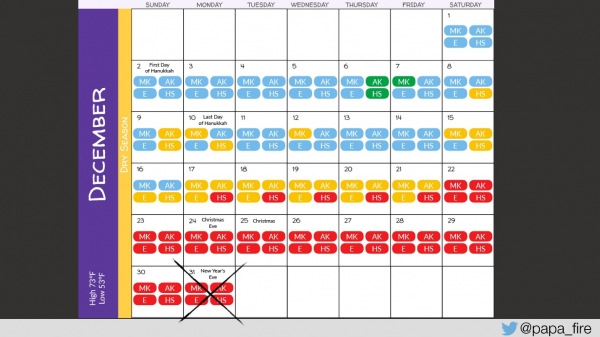
Privind puțin înainte, trebuie să menționez că am început activitatea mea în perioada cu cel mai mare trafic anual, ceea ce este interesant din diverse motive.
Platforma, care părea că are doar 2 ani, avea un stack aparte: ColdFusion și SQL Server 2008. ColdFusion, dacă nu știți, și probabil că nu știți, este un fel de PHP enterprise, care a apărut la mijlocul anilor 90, și de atunci eu nu am mai auzit de el. De asemenea, erau: Ruby, MySQL, PostgreSQL, Java, Go, Python. Dar monolitul principal funcționa pe ColdFusion și SQL Server.
Probleme
Cu cât discutam mai mult cu angajații companiei despre muncă și despre problemele întâlnite, cu atât mai mult înțelegeam că problemele nu erau doar de natură tehnică. Bine, tehnologia era veche – dar au fost probleme cu echipa și cu procesele, iar compania începea să înțeleagă asta.
În mod tradițional, tehnicienii stăteau în colț și se ocupau de treaba lor. Dar din ce în ce mai mult businessul a început să treacă prin versiunea digitală. Așadar, în ultimul an înainte de a începe eu, în companie au apărut noi: consiliu de administrație, CTO, CPO și director QA. Adică, compania a început să investească în domeniul tehnologic.
Urmele unui moșteniri dificile erau prezente nu doar în sisteme. În companie existau procese legacy, oameni legacy, cultură legacy. Toate acestea trebuiau schimbate. M-am gândit că nu va fi plictisitor, așa că am decis să încerc.
Cu două zile înainte
Cu două zile înainte de a începe noua muncă, am venit la birou, am completat ultimele formalități, m-am întâlnit cu echipa și am descoperit că echipa se lupta cu o problemă. Aceasta consta în faptul că timpul mediu de încărcare a paginilor a crescut la 4 secunde, adică s-a dublat.
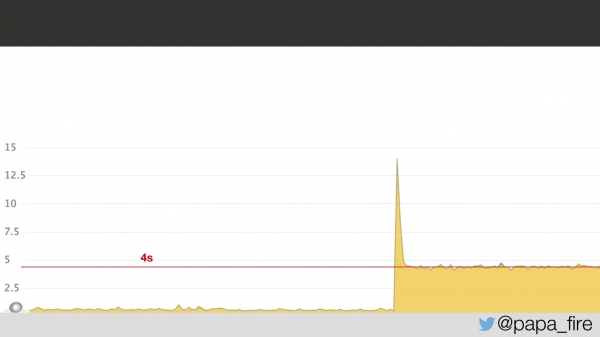
Judecând după grafic, este evident că s-a întâmplat ceva, dar nu se știe ce. S-a dovedit că problema era în latența rețelei în data center: 5 ms latență în data center s-au transformat în 2 secunde pentru utilizatori. De ce s-a întâmplat asta, nu știam, dar în orice caz, s-a aflat că problema era în data center.
Ziua întâi
Au trecut două zile, iar în prima mea zi de muncă am descoperit că problema nu a dispărut.
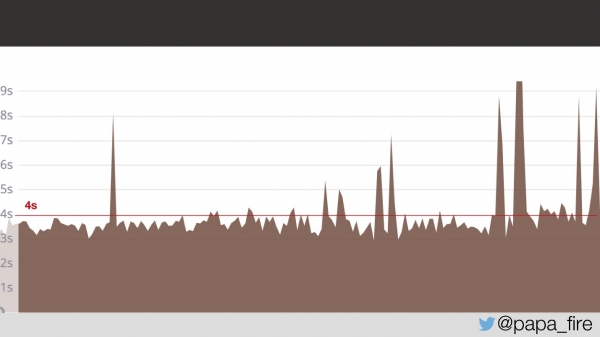
Pagini ale utilizatorilor se încărcau în medie în 4 secunde. Întreb dacă au găsit care este problema.
— Da, am deschis un tichet.
— Și?
— Ei bine, încă nu ne-au răspuns.
Atunci am realizat că tot ce mi s-a spus până acum este doar vârful aisbergului, cu care trebuie să lupt.
Există un citat bun care se potrivește foarte bine acestei situații:
„Uneori, pentru a schimba tehnologia, trebuie să schimbi organizația.”
Dar, având în vedere că am început lucrul în cel mai aglomerat moment al anului, trebuia să mă uit la ambele opțiuni de rezolvare a problemei: atât pe termen scurt, cât și pe termen lung. Și să încep cu ceea ce este critic chiar acum.
Ziua a treia
Așadar, încărcarea durează 4 secunde, iar între 13 și 15 sunt cei mai mari vârfuri.
În a treia zi, în acest interval de timp, viteza de încărcare arăta așa:
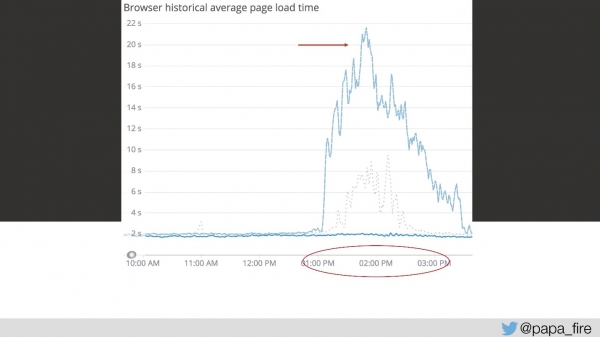
Din punctul meu de vedere, nu funcționa nimic. Din perspectiva tuturor celorlalți, funcționa puțin mai încet decât de obicei. Dar așa ceva nu se întâmplă fără un motiv — este o problemă serioasă.
Am încercat să conving echipa, iar răspunsul a fost că trebuie doar mai multe servere. Aceasta este, desigur, o soluție a problemei, dar nu este întotdeauna singura și cea mai eficientă. Am întrebat de ce lipsesc serverele, care este volumul de trafic. Am extrapolat datele și am obținut că avem aproximativ 150 de cereri pe secundă, ceea ce se încadrează în limite rezonabile.
Dar nu trebuie să uităm că înainte de a obține răspunsul corect, trebuie să punem întrebarea corectă. Întrebarea mea următoare a fost: câte servere frontend avem. Răspunsul m-a „derutat puțin” — aveam 17 servere frontend!
— Mă abțin să întreb, dacă împărțim 150 la 17, obținem aproximativ 8? Vreți să spuneți că fiecare server procesează 8 cereri pe secundă, iar dacă mâine vor fi 160 de cereri pe secundă, ne vor trebui încă 2 servere?
Desigur, nu aveam nevoie de servere suplimentare. Soluția se afla în codul însuși, de fapt la suprafață:
var currentClass = classes.getCurrentClass();
return currentClass;
Era o funcție getCurrentClass(), deoarece totul pe site funcționează în contextul unei clase — corect. Și pentru această funcție, pe fiecare pagină, erau 200+ cereri.
Soluția a fost foarte simplă, nu a fost nevoie să rescriem nimic: pur și simplu să nu cerem aceeași informație de mai multe ori.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Am fost foarte bucuros, pentru că am crezut că, după doar trei zile, am găsit problema principală. Cât de naiv am fost, aceasta era doar una dintre problemele foarte multe.
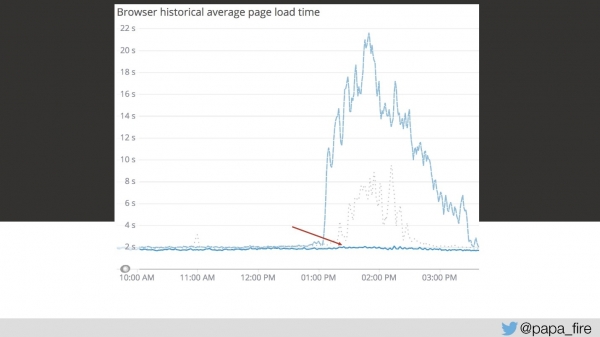
Dar soluția acestei prime probleme a dus la o scădere a graficului considerabil.
În același timp, ne ocupam de alte optimizări. Erau multe lucruri evidente care necesitau reparare. De exemplu, în aceeași zi, am descoperit că în sistem exista un cache (la început m-am gândit că toate cererile vin direct din baza de date). Când mă gândesc la cache, îmi imaginez standardele Redis sau Memcached. Dar așa gândisem doar eu, pentru că în acel sistem erau folosite MongoDB și SQL Server pentru caching — același din care tocmai fuseseră citite datele.
Ziua a zecea
În prima săptămână, m-am ocupat de probleme care trebuiau rezolvate imediat. Pe la sfârșitul celei de-a doua săptămâni, am venit pentru prima dată la stand-up pentru a discuta cu echipa, pentru a vedea ce se întâmplă și cum decurge întregul proces.
Din nou, s-a descoperit ceva interesant. Echipa era formată din: 18 dezvoltatori; 8 testeri; 3 manageri; 2 arhitecți. Și toți participau la ritualurile comune, adică mai mult de 30 de oameni veneau la stand-up în fiecare dimineață și își raportau activitățile. Este clar că întâlnirea nu dura 5 sau 15 minute. Nimeni nu asculta, deoarece toți lucrau la sisteme diferite. În această formă, 2-3 bilete pe oră la sesiunea de grooming erau deja un rezultat bun.
Primul lucru pe care l-am făcut a fost să împărțim echipa în mai multe pe linii de produs. Pentru diferite secțiuni și sisteme am alocat echipe separate, care includeau dezvoltatori, testeri, manageri de produs și analiști de afaceri.
În rezultat am obținut:
- Reducerea stand-up-urilor și întâlnirilor.
- Cunoștințe de domeniu ale produsului.
- Sentiment de apartenență. Când înainte, oamenii erau tot timpul rotanți între sisteme, știau că vor trebui să lucreze la bug-urile altora, dar nu la ale lor.
- Colaborarea între echipe. Nu este nevoie să spunem că QA nu a comunicat mult cu programatorii, produsul își făcea treaba, etc. Acum au un punct comun de responsabilitate.
În principal, ne-am concentrat pe eficiență, performanță și calitate — acestea erau problemele pe care încercam să le rezolvăm prin transformarea echipei.
Ziua a unsprezecea
În timpul modificării structurii echipei, am descoperit cum se calculează PovestePuncte. 1 SP era egal cu o zi, iar fiecare tichet conținea SP atât pentru dezvoltare, cât și pentru QA, adică cel puțin 2 SP.
Cum am descoperit asta?
Am găsit un bug: într-unul dintre rapoarte, unde se introduce data de început și de sfârșit a perioadei pentru care este nevoie de raport, nu era considerată ultima zi. Asta înseamnă că undeva în interogare era <, nu <=. Mi s-a spus că asta înseamnă trei Story Points, adică 3 zile.
După asta am:
- Revizuit sistemul de evaluare a Story Points. Acum, corectarea bug-urilor minore, care pot fi trecute rapid prin sistem, ajunge mai repede la utilizator.
- Am început să unificăm tichetele legate pentru dezvoltare și testare. În trecut, fiecare tichet, fiecare bug era un ecosistem închis, nelegat de altceva. Modificarea a trei butoane pe o singură pagină putea fi trei tichete diferite cu trei procese QA diferite în loc de un singur test automat pe pagină.
- Am început să colaborăm cu dezvoltatorii la abordarea estimării efortului. Trei zile pentru a schimba un buton — nu este deloc amuzant.
Ziua a douăzecea
Pe la mijlocul primei luni, situația s-a stabilizat puțin, m-am obisnuit cu ceea ce se întâmplă în principal, și am început să mă gândesc la viitor și la soluții pe termen lung.
Obiective pe termen lung:
- Platformă gestionată. Sute de cereri pe fiecare pagină — nu este serios.
- Tendințe previzibile. Au existat vârfuri periodice de trafic, care la prima vedere nu corelau cu alte metrici — trebuia să înțelegem de ce se întâmplă asta și să învățăm să prezicem.
- Extinderea platformei. Afacerile cresc constant, vin din ce în ce mai mulți utilizatori, crește traficul.
În trecut s-a spus adesea: „Hai să rescriem totul în [limbaj/framework], totul va funcționa mai bine!”
În cele mai multe cazuri, acest lucru nu funcționează, este bine dacă ceea ce a fost rescris va funcționa în general. Prin urmare, a trebuit să creăm un roadmap — o strategie concretă care ilustrează pas cu pas cum vor fi atinse obiectivele de afaceri (ce vom face și de ce), care:
- reflectă misiunea și obiectivele proiectului;
- prioritizează obiectivele principale;
- conține un program pentru atingerea acestora.
Până acum, nimeni nu a discutat cu echipa despre scopul pentru care se fac schimbările. Pentru aceasta sunt necesari indicatori de succes corecți. Pentru prima dată în istoria companiei, am stabilit KPI pentru echipa tehnică, iar acești indicatori au fost legați de organizare.
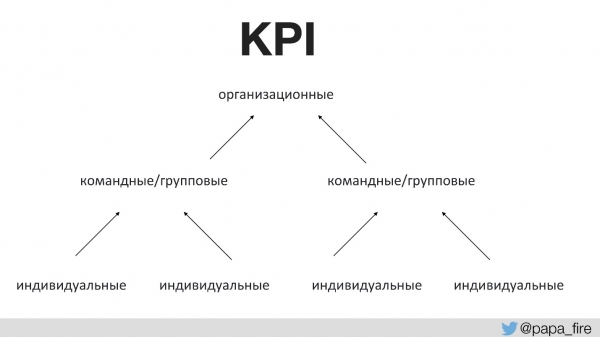
Cu alte cuvinte, KPI-urile organizaționale sunt susținute de echipe, iar KPI-urile echipelor sunt susținute de cele individuale. În caz contrar, dacă KPI-urile tehnologice nu se aliniază cu cele organizaționale, atunci fiecare trage pătură în direcția sa.
De exemplu, unul dintre KPI-urile organizaționale este creșterea cotei de piață prin produse noi.
Cu ce se poate susține obiectivul de a avea mai multe produse noi?
- În primul rând, dorim să dedicăm mai mult timp dezvoltării de produse noi în loc să reparăm defectele. Aceasta este o soluție logică, care poate fi măsurată ușor.
- În al doilea rând, dorim să susținem creșterea volumului de tranzacții, deoarece cu cât cota de piață este mai mare, cu atât sunt mai mulți utilizatori și, prin urmare, mai mult trafic.
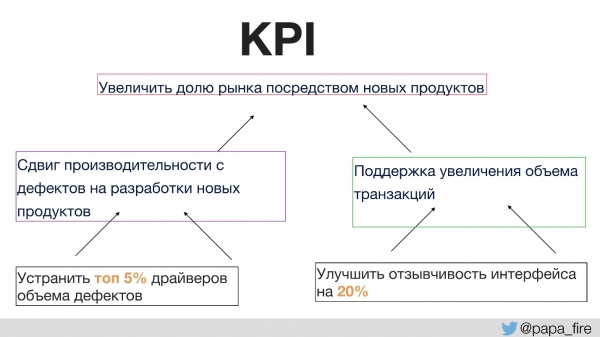
Atunci KPI-urile individuale, care pot fi îndeplinite în cadrul grupului, vor fi, de exemplu, în locul de unde provin cele mai multe defecte. Dacă ne concentrăm exact pe această secțiune, putem face astfel încât defectele să scadă semnificativ, iar timp pentru dezvoltarea de produse noi și pentru susținerea KPI-urilor organizaționale să crească din nou.
Astfel, fiecare decizie, inclusiv rescrierea codului, trebuie să susțină obiectivele specifice pe care compania ni le-a stabilit (creșterea organizației, funcții noi, angajarea de personal).
În timpul acestui proces a apărut un lucru interesant, care a fost o noutate nu doar pentru tehnicieni, ci pentru întreaga companie: toate ticheturile trebuie să fie orientate spre cel puțin un KPI. Adică, dacă product ownerul spune că dorește să creeze o nouă funcționalitate, prima întrebare care trebuie pusă este: „Care KPI susține această funcționalitate?” Dacă nu există niciunul, atunci ne pare rău — se pare că este o funcționalitate inutilă.
Ziua treizeci
La sfârșitul lunii, am descoperit un alt detaliu: nimeni din echipa mea de Ops nu a văzut vreodată contractele pe care le încheiem cu clienții. Te poți întreba de ce ar fi important să vezi contractele.
- În primul rând, pentru că în contracte sunt stipulate SLA-urile.
- În al doilea rând, SLA-urile sunt toate diferite. Fiecare client a venit cu cerințele sale, iar departamentul de vânzări semna fără să se uite.
Un alt detaliu interesant - în contractul cu unul dintre cei mai mari clienți se preconizează că toate versiunile software-ului acceptate de platformă trebuie să fie n-1, adică nu ultima versiune, ci penultima.
Este clar cât de departe eram de n-1, având în vedere că platforma rula pe ColdFusion și SQL Server din 2008, care a fost complet oprit din suport în iulie.
Ziua patruzeci și cincea
Pe la mijlocul celei de-a doua luni, am avut suficient timp liber pentru a mă așeza și a realiza valoarestreammapping întregul proces. Acestea sunt pașii necesari care trebuie urmați, de la crearea produsului până la livrarea acestuia consumatorului, și trebuie să fie detaliați cât mai bine.
Împarți procesul în bucăți mici și observi ce durează prea mult timp, ce poate fi optimizat, îmbunătățit etc. De exemplu, cât timp durează o cerere de la produs, trecerea prin grooming, până ajunge la ticket-ul pe care dezvoltatorul îl poate prelua, QA etc. Te uiți atât de în detaliu la fiecare pas în parte și te gândești ce poate fi optimizat.
Când am făcut asta, mi-au sărit în ochi două lucruri:
- un procentaj ridicat de returnare a ticketelor din QA înapoi la dezvoltatori;
- recenziile pull request-urilor durau prea mult timp.
Problema era că acestea erau evaluări de genul: pare că durează mult, dar nu suntem siguri cât de mult.
„Nu poți îmbunătăți ceea ce nu poți măsura.”
Cum poți justifica cât de serioasă este problema? Se pierde zile sau ore din cauza ei?
Pentru a măsura acest lucru, am adăugat câteva etape în procesul Jira: „gata pentru dezvoltare” și „gata pentru QA”, pentru a măsura cât timp așteaptă fiecare ticket și de câte ori se întoarce la o etapă specifică.
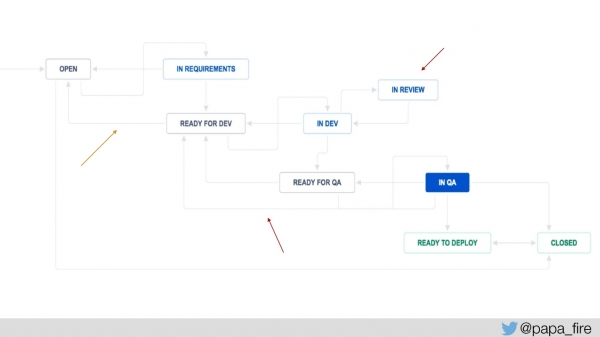
De asemenea, am adăugat „în revizuire”, pentru a ști cât timp, în medie, ticket-urile sunt în revizuire, și de acolo ne-am adaptat. Aveam deja metrici sistemice, acum am adăugat metrici noi și am început să măsurăm:
- Eficiența procesului: performanța și planificat/livrat.
- Calitatea procesului: numărul de defecte, defectele din partea QA.
Asta chiar ajută să înțelegem ce merge bine și ce nu.
Ziua cincizeci
Toate acestea sunt, desigur, bine și interesante, dar spre sfârșitul celei de-a doua luni s-a întâmplat ceea ce, practic, era previzibil, deși nu m-am așteptat la o asemenea amploare. Oamenii au început să plece, deoarece conducerea s-a schimbat. Au venit oameni noi care au început să schimbe totul, iar cei vechi au fost concediați. De obicei, într-o companie care există de câțiva ani, toți sunt prieteni și se cunosc între ei.
Acest lucru era de așteptat, dar ceea ce a fost surprinzător a fost amploarea concedierilor. De exemplu, într-o săptămână, doi lideri de echipă au depus simultan cereri de demisie. Așa că a trebuit să nu doar să uit de alte probleme, ci să mă concentrez pe crearea echipei. Aceasta este o problemă de lungă durată și greu de rezolvat, dar trebuia abordată, deoarece voiam să păstrez oamenii care au rămas (sau majoritatea lor). Trebuia să reacționez cumva la faptul că oamenii au plecat, pentru a menține moralul în echipă.
În teorie, este bine: vine o nouă persoană, care are un mandat complet, care poate evalua abilitățile echipei și poate înlocui cadrele. De fapt, nu poți aduce pur și simplu oameni noi din foarte multe motive. E întotdeauna nevoie de un echilibru.
- Între vechi și nou. Trebuie să păstrăm oamenii vechi, care pot să se schimbe și să susțină misiunea. Dar, în același timp, trebuie să aducem sânge proaspăt, despre care vom vorbi un pic mai târziu.
- Experiență. Am vorbit mult cu juniori buni, care erau entuziasmați și voiau să vină la noi. Dar nu îi puteam angaja, deoarece nu aveam suficienți seniori care să-i susțină pe juniori și să fie mentori pentru ei. Trebuia întâi să adunăm conducerea și abia apoi tinerii.
- Biciul și zahărul.
Nu am un răspuns bun la întrebarea care este echilibrul corect, cum să-l menținem, câți oameni să păstrăm și cât de mult să apăsăm. Este un proces pur individual.
Ziua cincizeci și una
Am început să observ echipa, pentru a înțelege cine este cu mine, și mi-am amintit din nou:
„Cele mai multe probleme sunt probleme cu oamenii”.
Am descoperit că în echipă, atât la dezvoltatori, cât și la Ops, sunt trei mari probleme:
- Satisfacția față de situația actuală.
- Lipsa de responsabilitate — pentru că nimeni nu a legat vreodată rezultatele muncii executanților de impactul asupra afacerii.
- Frica de schimbare.
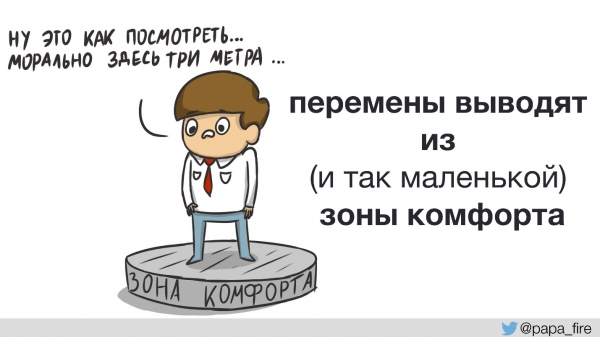
Schimbările te scot întotdeauna din zona de confort, iar cu cât oamenii sunt mai tineri, cu atât mai mult îi deranjează schimbările, pentru că nu înțeleg de ce și nu înțeleg cum. Răspunsul cel mai frecvent pe care l-am auzit a fost: „Așa nu am făcut niciodată”. Mai mult, ajungea până la abuzul total — cele mai mici modificări nu trecute fără ca cineva să se revolte. Și nu avea importanță cât de mult aceste modificări îi afectau pe ei, oamenii spuneau: „De ce? Nu va funcționa”.
Dar nu poți să devii mai bun fără a schimba nimic.
Am avut o conversație complet absurdă cu un angajat, îi explicam ideile mele de optimizare, la care mi-a replicat:
— A, n-ai văzut ce a fost anul trecut la noi!
— Și ce dacă?
— Acum este mult mai bine decât era.
— Deci, nu poate fi și mai bine?
— De ce să fie?
O întrebare bună — de ce? Ca și cum, dacă acum e mai bine decât era, înseamnă că totul este suficient de bine. Asta duce la lipsa responsabilității, ceea ce este, în principiu, absolut normal. Așa cum am spus, echipa tehnică a fost puțin retrasă. În companie se credea că ar trebui să fie, dar nimeni nu a stabilit vreodată standarde. În suportul tehnic nu au văzut niciodată SLA, așa că pentru echipă era destul de „acceptabil” (și asta m-a uimit cel mai mult):
- 12 secunde pentru încărcare;
- 5-10 minute de nefuncționare la fiecare lansare;
- remedierea problemelor critice durează zile și săptămâni;
- lipsa unui program de gardă 24/7 / on-call.
Nimeni nu a încercat vreodată să întrebe de ce nu am face asta mai bine și nimeni nu a înțeles vreodată că nu ar trebui să fie așa.
Ca bonus, a fost o altă problemă: lipsa de experiență. Seniorii au plecat, iar echipa tânără rămasă a crescut în regimul anterior și a fost intoxicată de acesta.
Pe deasupra, oamenii se temeau să nu eșueze, să nu pară inapți. Acest lucru se manifestă prin faptul că, în primul rând, în niciun caz nu cer ajutor.. De câte ori am discutat în grup și individual, și am spus: „Întrebați dacă nu știți cum să faceți ceva”. Am încredere în mine și știu că pot rezolva orice problemă, dar va dura timp. Așa că, dacă pot întreba pe cineva care știe cum să o rezolve în 10 minute, o voi face. Cu cât ai mai puțin experiență, cu atât te temi mai mult să întrebi, pentru că te gândești că te vor considera incompetent.
Această frică de a pune întrebări se manifestă în forme interesante. De exemplu, întrebi: „Ce mai e cu această sarcină?” —„Mai am câteva ore, sunt aproape gata”. În ziua următoare întrebi din nou, primești răspuns că totul e bine, dar a apărut o mică problemă, va fi gata până la sfârșitul zilei. Mai trece o zi și până nu îl presezi, lucrurile continuă așa. Persoana vrea să rezolve sarcina singură, crede că dacă nu reușește, va fi o mare eșec.
Exact de aceea dezvoltatorii supraestimează estimările. A fost o glumă când discutam o anumită sarcină, mi s-a dat o cifră care m-a surprins foarte tare. La ce mi s-a spus că în estimări, dezvoltatorul include și timpul în care tick-ul va reveni din QA, deoarece acolo vor găsi erori, și timpul necesar pentru PR, și timpul în care persoanele care ar trebui să-l revizuiască vor fi ocupate — adică tot ce este posibil.
În al doilea rând, persoanele care se tem să pară incompetente, analizează excesiv. Când spui ce trebuie să se facă, începe: „Nu, dar ce-ar fi dacă ne-am gândi aici?” În acest sens, compania noastră nu este unică, aceasta este o problemă standard a tinerilor.
Ca răspuns, am introdus următoarele practici:
- Regula de 30 de minute. Dacă în jumătate de oră nu poți rezolva problema, cere ajutorul cuiva. Aceasta funcționează cu succes variabil, deoarece oamenii tot nu cer ajutor, dar măcar procesul a început.
- Excluzând tot ce nu este esențial, în estimarea timpului de executare a sarcinii, adică să consideri doar cât timp va dura scrierea codului.
- Învățare continuă pentru cei care analizează excesiv. Este vorba doar de munca constantă cu oamenii.
Ziua şaizeci
În timp ce mă ocupam de toate acestea, a venit momentul să mă ocup de buget. Desigur, am găsit multe lucruri interesante în ceea ce privește cheltuielile noastre. De exemplu, aveam un întreg rack într-un centru de date dedicat, pe care se afla un server FTP folosit de un singur client. Se pare că „... am fost în proces de mutare și el a rămas, nu l-am schimbat”. A fost acum 2 ani.
Un interes deosebit l-a reprezentat factura pentru serviciile cloud. Sunt sigur că motivul principal pentru factura mare la serviciile cloud este că dezvoltatorii au pentru prima dată în viață acces nelimitat la servere. Nu trebuie să ceară: „Îmi dați, vă rog, un server de test?”, pot să le ia singuri. Pe lângă asta, dezvoltatorii întotdeauna doresc să construiască un sistem atât de cool încât Facebook să se facă de râs față de Netflix.
Dar dezvoltatorii nu au experiența achiziționării serverelor și abilități în a determina dimensiunea corespunzătoare a serverelor, deoarece nu le-a fost necesar până acum. Și, de obicei, nu înțeleg complet diferența dintre scalabilitate și performanță.
Rezultatele inventarului:
- Am ieșit dintr-un centru de date.
- Am reziliat contractul cu 3 servicii de logare. Deoarece aveam 5 – fiecare dezvoltator care începea să experimenteze lua unul nou.
- Am închis 7 sisteme AWS. Din nou, proiectele morții nu erau oprite, ele continuau să funcționeze.
- Am redus cheltuielile pentru software de 6 ori.
Ziua șaptezeci și cinci
Timpul trecea și, după două luni și jumătate, urma să mă întâlnesc cu consiliul de administrație. Consiliul nostru de administrație nu este mai bun și nici mai rău decât altele, el, ca toate consiliile de administrație, vrea să știe tot. Oamenii investesc bani și vor să înțeleagă în ce măsură ceea ce facem se încadrează în KPI-urile stabilite.
Consiliul de administrație primește multe informații în fiecare lună: numărul de utilizatori, creșterea acestora, ce servicii folosesc și cum, performanța și productivitatea, în sfârșit, viteza medie de încărcare a paginii.
Problema este că eu consider că media este un rău pur. Dar explicarea acestui lucru consiliului de administrație este foarte greu. Sunt obișnuiți să opereze cu numere agregate și nu, de exemplu, cu dispersia timpului de încărcare în secunde.
În legătură cu aceasta, au fost momente interesante. De exemplu, am spus că trebuie să împărțim traficul între serverele web separate în funcție de tipul de conținut.
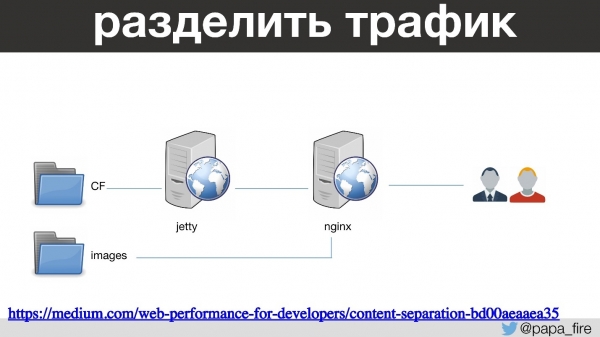
Adică, ColdFusion trece prin Jetty și nginx și încarcă paginile. Iar imaginile, JS și CSS sunt gestionate printr-un nginx separat cu configurațiile sale. Aceasta este o practică destul de standard, despre care am cu câțiva ani în urmă. Ca rezultat, imaginile se încarcă mult mai repede, iar … viteza medie de încărcare a crescut cu 200 ms.
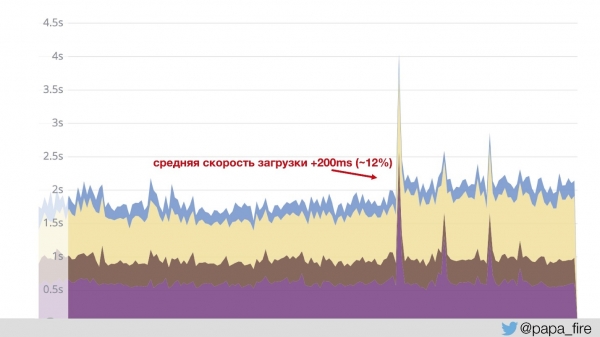
Asta s-a întâmplat pentru că graficul este construit pe baza datelor care vin de la Jetty. Asta înseamnă că conținutul rapid nu este luat în calcul — media a sărit în sus. Ne-a fost clar, am râs, dar cum să explicăm consiliului de administrație de ce am făcut ceva și a devenit mai rău cu 12%?
Ziua optzeci și cinci
La sfârșitul celei de-a treia luni, am realizat că un lucru pe care nu l-am anticipat deloc — este timpul. Tot ceea ce am vorbit necesită timp.
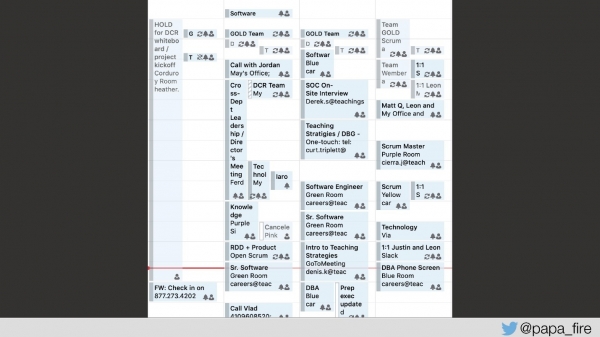
Acesta este calendarul meu adevărat pentru săptămână — pur și simplu o săptămână de lucru, nu foarte aglomerată. Nu am suficient timp pentru toate. Așa că, din nou, trebuie să angajăm oameni care să ne ajute să facem față problemelor.
Concluzie
Acesta nu este totul. În această poveste, eu nu am ajuns încă la cum am lucrat cu produsul și am încercat să ne sincronizăm pe aceeași lungime de undă, sau cum am integrat suportul tehnic, sau cum am rezolvat alte probleme tehnice. De exemplu, am aflat complet întâmplător că pe cele mai mari tabele din baza de date nu folosim SEQUENCE. Avem o funcție personalizată nextID, și aceasta nu este utilizată în tranzacție.
A mai fost un milion de lucruri asemănătoare despre care s-ar putea vorbi îndelung. Dar cel mai important, despre ce mai merită spus, este cultura.
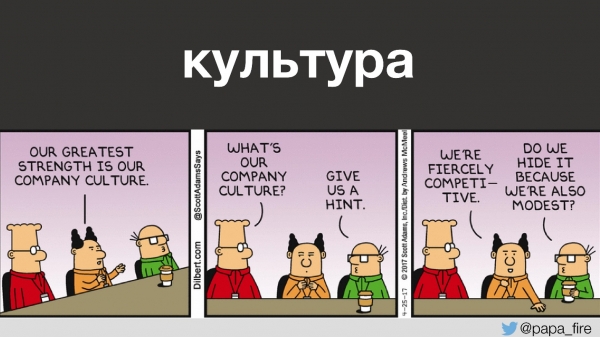
Anume cultura sau absența acesteia duce la toate celelalte probleme. Încercăm să construim o cultură în care oamenii:
- nu se tem de eșecuri;
- învăță din greșeli;
- colaborează cu alte echipe;
- demonstrează inițiativă;
- își asumă responsabilitatea;
- întâmpină rezultatul ca pe un obiectiv;
- sărbătoresc succesul.
Cu asta, tot restul va veni.
Leon Fire , și pe .
În ceea ce privește legacy, există două strategii: să evităm cu orice preț lucrul cu el sau să înfruntăm curajos dificultățile însoțitoare. Noi suntem pe a doua cale, schimbând procesele și abordările. Alăturați-vă nouă pe , și , și să implementăm împreună cultura DevOps.
Sursa: habr.com
