

Au trecut zilele în care nu trebuia să-ți facă griji cu privire la optimizarea performanței bazelor de date. Timpul nu stă pe loc. Fiecare antreprenor din domeniul tehnologiilor avansate vrea să creeze următorul Facebook, străduindu-se în același timp să colecteze toate datele la care poate avea acces. Aceste date sunt necesare afacerii pentru a îmbunătăți învățarea modelului, care ajută la generarea de venituri. În aceste condiții, programatorii trebuie să creeze API-uri care să permită lucrul rapid și fiabil cu volume enorme de informație.
Dacă ai lucrat deja de ceva timp la proiectarea părților de server ale aplicațiilor sau bazelor de date, ai scris probabil cod pentru a face cereri cu paginare. De exemplu — așa:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Așa e?
Dar dacă ai efectuat paginarea exact așa, regret să spun că ai făcut-o departe de cel mai eficient mod.
Vrei să mă contrazici? . , și folosește deja tehnicile despre care vreau să vorbesc astăzi.
Numiți măcar un dezvoltator de backend care nu a folosit OFFSET și LIMIT pentru a face cereri cu paginare. În MVP (Minimum Viable Product, produs minimal viabil) și în proiectele care folosesc volume mici de date, această abordare este destul de aplicabilă. Este, așadar, "pur și simplu funcționează".
Dar dacă trebuie să creezi de la zero sisteme fiabile și eficiente, trebuie să te ocupi din timp de eficiența execuției cererilor către bazele de date utilizate în aceste sisteme.
Astăzi vom discuta despre problemele care sunt asociate cu implementările pe scară largă (din păcate așa este) ale mecanismelor de execuție a cererilor cu paginare, și despre cum să obținem o performanță înaltă în execuția unor astfel de cereri.
Ce este în neregulă cu OFFSET și LIMIT?
Așa cum am menționat, OFFSET și LIMIT se comportă excelent în proiectele în care nu trebuie să lucrezi cu volume mari de date.
Problema apare atunci când baza de date crește la dimensiuni atât de mari încât nu mai poate fi stocată în memoria serverului. Dar în același timp, trebuie să folosești cereri cu paginare pentru a lucra cu această bază de date.
Pentru ca această problemă să apară, trebuie să existe o situație în care SGBD-ul să recurgă la o operațiune ineficientă de scanare completă a tabelului (Full Table Scan) la executarea fiecărei interogări cu paginare (în același timp, pot avea loc operațiuni de inserare și ștergere a datelor, iar datele învechite nu ne interesează!).
Ce este „scanarea completă a tabelului” (sau „vizualizarea secvențială a tabelului”, Sequential Scan)? Aceasta este o operațiune în timpul căreia SGBD-ul citește secvențial fiecare linie din tabel, adică datele conținute în acesta, și le verifică pentru a se conforma unei condiții date. Este bine cunoscut faptul că acest tip de scanare a tabelului este cel mai lent. Motivul este că, în timpul executării sale, au loc multe operațiuni de intrare/ieșire, implicând subsistemul de disc al serverului. Situația este agravată de întârzierile asociate cu lucrul cu datele stocate pe discuri și de faptul că transferul de date de pe disc în memorie este o operațiune consumatoare de resurse.
De exemplu, aveți înregistrări despre 100000000 de utilizatori și executați o interogare cu structura OFFSET 50000000. Aceasta înseamnă că SGBD-ul va trebui să încarce toate aceste înregistrări (iar acestea nu ne sunt necesare!), să le plaseze în memorie și abia apoi să ia, să zicem, 20 de rezultate, despre care este raportat în LIMIT.
Să spunem că ar putea arăta astfel: „selectați liniile de la 50000 la 50020 din 100000”. Asta înseamnă că, pentru a executa interogarea, sistemul va trebui mai întâi să încarce 50000 de linii. Vedeți cât de multă muncă inutilă trebuie să efectueze?
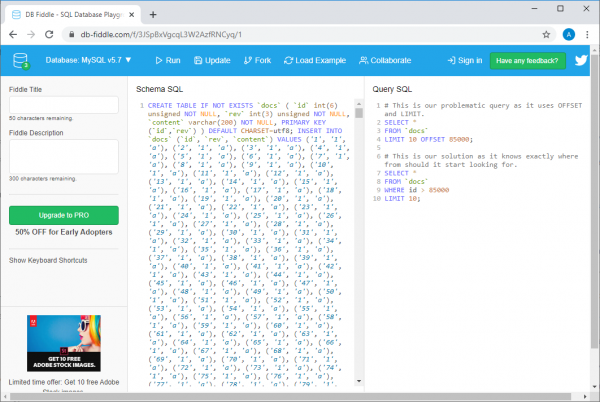
Dacă nu credeți — aruncați o privire la exemplul pe care l-am creat, folosind facilitățile .
Exemplu pe db-fiddle.com
Acolo, în stânga, în câmpul Schema SQL, există un cod care execută inserția în baza de date a 100000 de linii, iar în dreapta, în câmpul Query SQL, sunt prezentate două interogări. Prima, lentă, arată astfel:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
Iar a doua, care reprezintă o soluție eficientă pentru aceeași problemă, astfel:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Pentru a executa aceste interogări, este suficient să apăsați butonul Run în partea de sus a paginii. După ce am făcut asta, vom compara informațiile despre timpul de execuție al interogărilor. Se dovedește că executarea unei interogări ineficiente durează, cel puțin, de 30 de ori mai mult decât execuția celei de-a doua (de la o rulare la alta, acest timp variază, de exemplu, sistemul poate raporta că execuția primei interogări a durat 37 ms, iar a celei de-a doua — 1 ms).
Și dacă vor fi mai multe date, atunci totul va arăta și mai rău (pentru a verifica acest lucru, aruncați o privire la comentariul meu cu 10 milioane de rânduri).
Ceea ce am discutat tocmai acum ar trebui să vă ofere o înțelegere mai bună a modului în care, de fapt, sunt procesate interogările către bazele de date.
Rețineți că cu cât valoarea este mai mare OFFSET cu atât interogarea va dura mai mult.
Ce ar trebui să folosiți în locul combinației OFFSET și LIMIT?
În locul combinației OFFSET și LIMIT ar trebui să folosiți o structură construită după următoarea schemă:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Aceasta este executarea unei interogări cu paginare pe baza cursorului (Cursor based pagination).
În loc să păstrați local curentele OFFSET și LIMIT și să le transmiteți cu fiecare interogare, ar trebui să păstrați ultima cheie primară obținută (de obicei, aceasta este ID) și LIMIT, ca urmare, vor rezulta interogări asemănătoare cu cea de mai sus.
De ce? Este vorba despre faptul că, specificând în mod explicit identificatorul ultimei linii citite, îi spuneți SGBD-ului dumneavoastră de unde să înceapă căutarea datelor necesare. În plus, căutarea, datorită utilizării cheii, se va desfășura eficient, sistemul nu va trebui să se distragă cu rândurile aflate dincolo de intervalul specificat.
Să aruncăm o privire asupra următoarei comparații a performanței diferitelor interogări. Iată o interogare ineficientă.
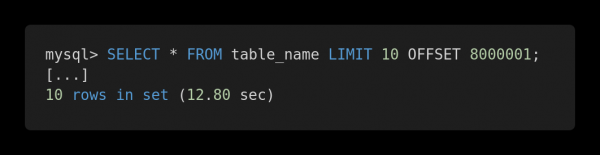
Cerere lentă
Iată însă — versiunea optimizată a acestei interogări.
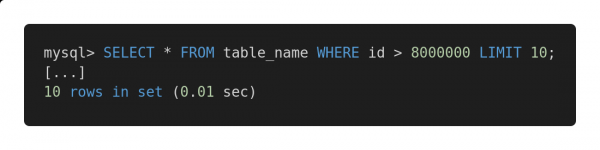
Interogare rapidă
Ambele interogări returnează exact același volum de date. Dar execuția primei durează 12,80 secunde, iar a celei de-a doua — 0,01 secundă. Simțiți diferența?
Posibile probleme
Pentru a asigura o funcționare eficientă a metodei propuse de executare a interogărilor, este necesar să existe în tabel o coloană (sau coloane) care să conțină indici unici, aranjați secvențial, cum ar fi un identificator întreg. În anumite situații specifice, acest lucru poate determina succesul aplicării unor astfel de interogări pentru a îmbunătăți viteza de lucru cu baza de date.
Desigur, atunci când construim interogări, trebuie să ținem cont de caracteristicile arhitecturii tabelelor și să alegem mecanismele care performează cel mai bine pe tabelele existente. De exemplu, dacă trebuie să lucrăm cu cantități mari de date corelate în interogări, s-ar putea să vă intereseze articolul.
Dacă ne confruntăm cu problema absenței unei chei primare, de exemplu, dacă există un tabel cu o relație "mulți-la-mulți", abordarea tradițională, care preconizează utilizarea OFFSET și LIMIT, ne va fi garantat potrivită. Dar aplicarea sa poate conduce la executarea unor interogări potențial lente. În astfel de cazuri, aș recomanda utilizarea unei chei primare cu auto-incrementare, chiar dacă aceasta este necesară doar pentru organizarea interogărilor cu paginare.
Dacă sunteți interesat de acest subiect — , și — câteva materiale utile.
Concluzii
Concluzia principală pe care o putem face este că, indiferent de dimensiunile bazelor de date despre care discutăm, este necesar să analizăm viteza de execuție a interogărilor. În vremurile noastre, scalabilitatea soluțiilor este extrem de importantă, iar dacă proiectăm totul corect de la începutul lucrului la un sistem, acest lucru poate scuti dezvoltatorul de numeroase probleme în viitor.
Cum analizați și optimizați interogările către bazele de date?
Sursa: habr.com
