

LINQ a fost introdus în .NET ca un nou limbaj puternic pentru manipularea datelor. LINQ to SQL, ca parte a acestuia, permite comunicarea destul de convenabilă cu bazele de date, de exemplu, prin Entity Framework. Totuși, utilizându-l frecvent, dezvoltatorii uită să verifice ce interogare SQL exact va genera providerul queryable, în cazul dumneavoastră - Entity Framework.
Să analizăm două aspecte principale printr-un exemplu.
Pentru aceasta, în SQL Server vom crea o bază de date Test, iar în aceasta vom crea două tabele folosind următoarea interogare:
Crearea tabelelor
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Acum să umplem tabela Ref folosind următorul script:
Umplerea tabelei Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
În mod similar, să umplem tabela Customer folosind următorul script:
Umplerea tabelei Customer
USE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
Astfel, am obținut două tabele, una cu peste 1 milion de rânduri de date, iar cealaltă cu peste 10 milioane de rânduri de date.
Acum, în Visual Studio, trebuie să creăm un proiect de testare Visual C# Console App (.NET Framework):
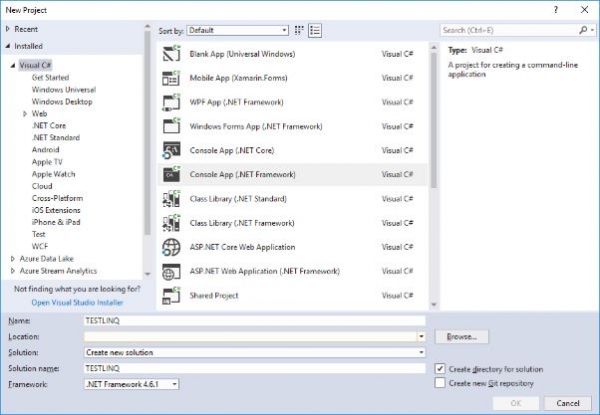
Apoi, trebuie să adăugăm o bibliotecă pentru Entity Framework pentru a interacționa cu baza de date.
Pentru a-l adăuga, vom da clic dreapta pe proiect și vom alege din meniul contextual Manage NuGet Packages:
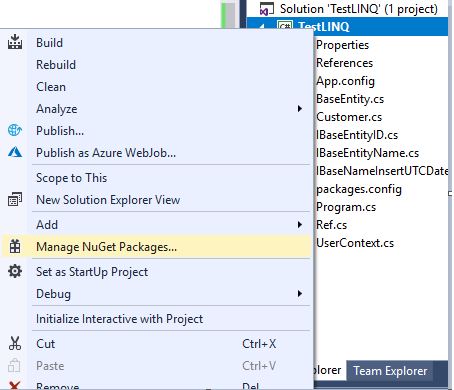
Apoi, în fereastra de gestionare a pachetelor NuGet care apare, în câmpul de căutare vom introduce cuvântul „Entity Framework” și vom alege pachetul Entity Framework și îl vom instala:
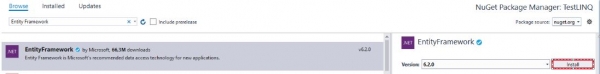
Ulterior, în fișierul App.config, după închiderea elementului configSections, trebuie să adăugăm următorul bloc:
În connectionString trebuie să introducem șirul de conexiune.
Acum vom crea în fișiere separate 3 interfețe:
- Implementarea interfeței IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementarea interfeței IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementarea interfeței IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Și în fișiere separate vom crea clasa de bază BaseEntity pentru cele două entități, care va conține câmpurile comune:
Implementarea clasei de bază BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Apoi, în fișiere separate vom crea cele două entități:
- Implementarea clasei Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementarea clasei Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer : BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Acum vom crea în fișierul separat contextul UserContext:
Implementarea clasei UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Am obținut o soluție gata pentru a efectua teste de optimizare cu LINQ to SQL prin EF pentru MS SQL Server:
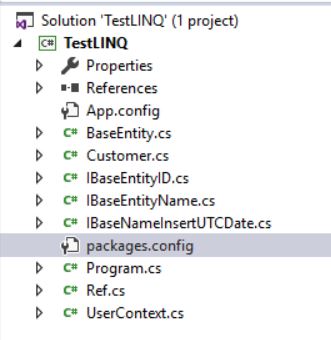
Acum, în fișierul Program.cs vom introduce următorul cod:
Fișierul Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Apoi, să lansăm proiectul nostru.
La sfârșitul execuției, va fi afișat pe consolă:
Interogarea SQL generată
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Adică, în general, interogarea LINQ a generat un SQL destul de bun pentru SGBD MS SQL Server.
Acum, să schimbăm condiția AND în OR în interogarea LINQ:
Interogarea LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Și din nou să lansăm aplicația noastră.
Execuția va eșua cu o eroare legată de depășirea timpului de execuție de 30 de secunde:
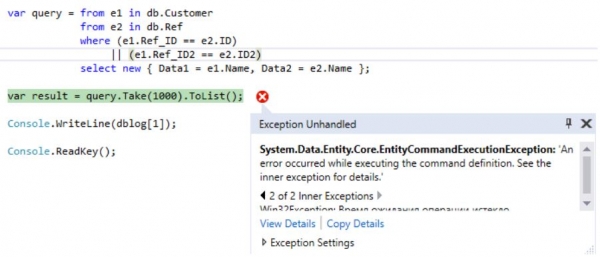
Dacă ne uităm ce interogare a fost generată de LINQ:
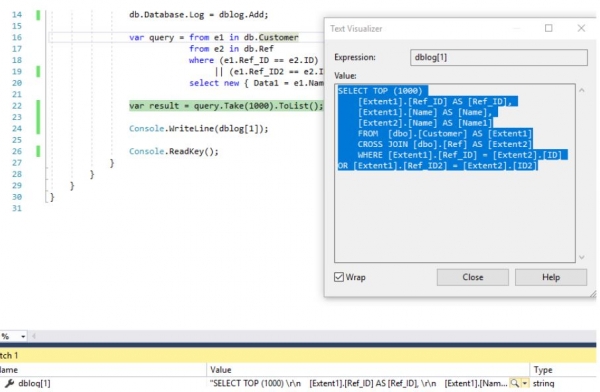
, putem observa că selecția se face prin produsul cartesians al două mulțimi (tabele):
Interogarea SQL generată
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Să rescriem interogarea LINQ astfel:
Interogarea LINQ optimizată
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Atunci vom obține următoarea interogare SQL:
Interogare SQL
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Din păcate, în interogările LINQ condiția de unire poate fi doar una, așa că este posibil să se facă o interogare echivalentă prin două interogări pentru fiecare condiție, urmate de unirea lor prin Union pentru a elimina duplicatele din rânduri.
Da, în general interogările vor fi neechivalente având în vedere că pot fi returnate duplicate complete ale rândurilor. Totuși, în viața reală, duplicatele complete nu sunt necesare și se evită.
Acum să comparăm planurile de execuție ale acestor două interogări:
- pentru CROSS JOIN, timpul mediu de execuție este de 195 secunde:

- pentru INNER JOIN-UNION, timpul mediu de execuție este mai mic de 24 secunde:

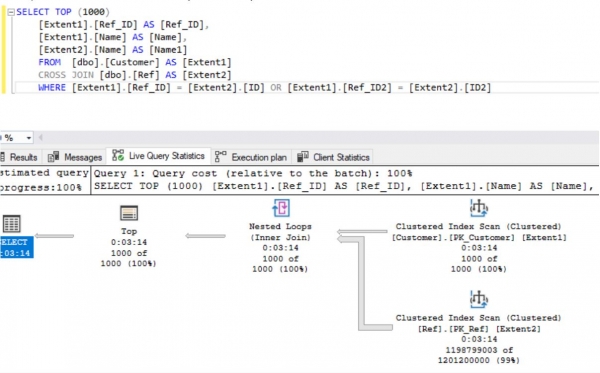
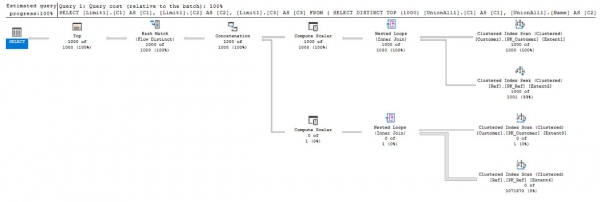
După cum se poate observa din rezultate, pentru două tabele cu milioane de înregistrări, interogarea LINQ optimizată funcționează de câteva ori mai repede decât cea neoptimizată.
Pentru varianta cu AND în condițiile interogării LINQ de tip:
Interogarea LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
aproape întotdeauna va fi generată o interogare SQL corectă, care se va executa în medie în aproximativ 1 secundă:
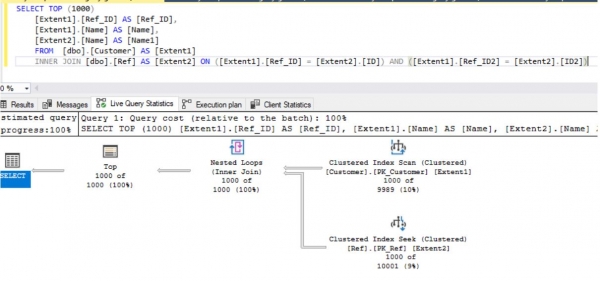
De asemenea, pentru manipulările LINQ to Objects, în loc de interogarea de tip:
Interogare LINQ (varianta 1)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1 == e2.Key1)
                               && (e1.Key2 == e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
se poate utiliza o interogare de tip:
Interogare LINQ (varianta 2)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
unde:
Definirea a două array-uri
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, iar tipul Para este definit astfel:
Definirea tipului Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Astfel, am analizat unele aspecte ale optimizării interogărilor LINQ pentru MS SQL Server.
Din păcate, chiar și cei mai experimentați și renumiți dezvoltatori .NET uită că este esențial să înțeleagă ce se întâmplă în spatele instrucțiunilor pe care le utilizează. Altfel, ei devin doar configuratori și pot lăsa o bombă cu efect întârziat pentru viitor, atât atunci când se scalează soluția de programare, cât și în cazul unor schimbări minore în condițiile externe ale mediului.
De asemenea, a fost realizat un mic rezumat și .
Sursele pentru testare - proiectul în sine, crearea tabelelor în baza de date TEST, precum și popularea acestor tabele se află .
De asemenea, în acest repository, în folderul Plans, se găsesc planurile de executare a interogărilor cu condiții OR.
Sursa: habr.com
