

În procesul de tranziție de la o aplicație monolitică la o arhitectură de microservicii, ne confruntăm cu probleme noi.
Într-o aplicație monolitică, de obicei, este suficient să identifici în ce parte a sistemului a apărut o eroare. Cel mai probabil, problema rezidă în codul monolitului sau în baza de date. Dar când începem să căutăm problemele într-o arhitectură de microservicii, lucrurile nu mai sunt atât de evidente. Trebuie să găsim întreaga cale parcursă de cerere, de la început până la sfârșit, și să o extragem din sute de microservicii. Mai mult, multe dintre acestea au propriile lor stocări, unde pot apărea atât erori logice, cât și probleme de performanță și disponibilitate.
Am căutat mult timp un instrument care să mă ajute să fac față acestor probleme (am scris despre asta pe Habr: , ), dar în cele din urmă am creat propria soluție open source. În acest articol, discut despre avantajele abordării service mesh și împărtășesc un nou instrument pentru implementarea acesteia.
Tracing-ul distribuit este o soluție comună pentru problema identificării erorilor în sistemele distribuite. Dar ce se întâmplă dacă în sistem nu este implementată o astfel de abordare pentru colectarea informațiilor despre interacțiunile de rețea, sau, mai rău, în partea sistemului aceasta funcționează corect, iar în alta nu, deoarece nu a fost adăugată în serviciile mai vechi? Pentru a determina cauza rădăcină exactă a problemei, este necesar să avem o imagine de ansamblu completă a ceea ce se întâmplă în sistem. Este esențial să înțelegem care microservicii sunt implicate în căile critice pentru afacere.
Aici poate interveni abordarea service mesh, care se ocupă de întreaga mașinărie de colectare a informațiilor de rețea la un nivel inferior decât cel în care funcționează serviciile în sine. Această abordare ne permite să interceptăm tot traficul și să-l analizăm în timp real. Și aplicațiile nu trebuie să știe nimic despre acest lucru.
Abordarea service mesh
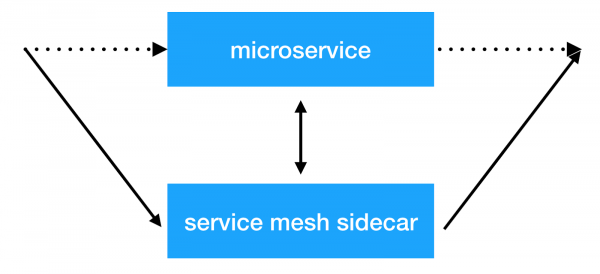
Ideea principală a abordării service mesh este adăugarea unui alt strat infrastructural deasupra rețelei, care ne va permite să gestionăm orice interacțiune dintre servicii. Cele mai multe implementări funcționează astfel: fiecărui microserviciu îi este adăugat un container sidecar suplimentar cu un proxy transparent, prin care trece tot traficul de intrare și ieșire al serviciului. Acesta este locul în care putem efectua echilibrarea clientului, aplica politici de securitate, stabili limite pentru numărul de solicitări și colecta informații importante despre interacțiunile serviciilor în producție.
Soluții
Există deja câteva implementări ale acestei abordări: și . Acestea oferă numeroase posibilități din cutie. Dar, în același timp, vine și cu un overhead mare pe resurse. Mai mult, cu cât clusterul în care funcționează un astfel de sistem este mai mare, cu atât sunt necesare mai multe resurse pentru a susține noua infrastructură. La Avito, folosim clustere Kubernetes în care se află mii de instanțe de servicii (iar numărul acestora continuă să crească rapid). În implementarea actuală, Istio consumă ~300Mb de memorie RAM pentru fiecare instanță de serviciu. Din cauza numărului mare de funcționalități, echilibrarea transparentă influențează, de asemenea, timpul total de răspuns al serviciilor (până la 10ms).
În cele din urmă, ne-am uitat la ce anume ne este necesar în prezent și am decis că motivul principal pentru care am început să implementăm astfel de soluții a fost capacitatea de a colecta informații de tracing din întreaga sistemă într-un mod transparent. De asemenea, ne-am dorit să avem control asupra interacțiunii serviciilor și să efectuam diverse manipulări cu antetele care sunt transmise între servicii.
În cele din urmă, am ajuns la soluția noastră: .
Netramesh
— este o soluție service mesh ușoară, cu capacitate de scalare infinită, indiferent de numărul de servicii din sistem.
Obiectivele principale ale noii soluții erau overhead-ul mic pe resurse și performanța ridicată. Dintre funcționalitățile de bază, am dorit imediat capacitatea de a trimite transparent span-uri de tracing în sistemul nostru Jaeger.
Astăzi, majoritatea soluțiilor cloud sunt implementate în Golang. Și, desigur, există motive întemeiate pentru aceasta. Este convenabil și destul de simplu să scrii aplicații de rețea în Golang care funcționează asincron cu introducerea și ieșirea și se scalează în funcție de necesități pe nuclee. De asemenea, este foarte important că performanța obținută este suficientă pentru a rezolva această sarcină. De aceea, am ales și noi Golang.
Performanță
Ne-am concentrat eforturile pe atingerea unei performanțe maxime. Pentru soluția care este desfășurată lângă fiecare instanță de serviciu, este necesar un consum redus de memorie RAM și timp de procesor. Și, desigur, întârzierea la răspuns trebuie să fie de asemenea mică.
Să vedem ce rezultate am obținut.
RAM
Netramesh consumă ~10Mb fără trafic și 50Mb la maxim cu o sarcină de până la 10000 RPS pe o instanță.
Istio envoy proxy consumă întotdeauna ~300Mb în clusterele noastre cu mii de instanțe. Acest lucru nu permite scalarea lui pe întregul cluster.
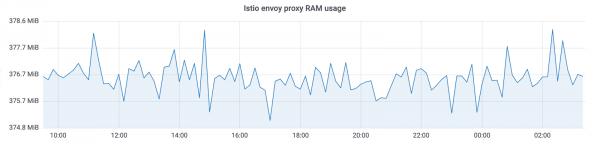
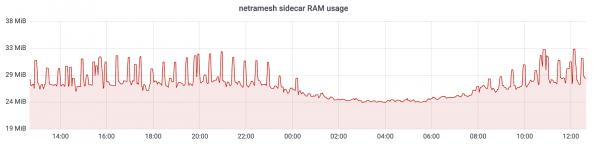
Cu Netramesh, am obținut o reducere a consumului de memorie de ~10 ori.
CPU
Utilizarea CPU este relativ constantă sub sarcină. Aceasta depinde de numărul de cereri pe unitate de timp către sidecar. Valorile în vârful de 3000 de cereri pe secundă sunt:
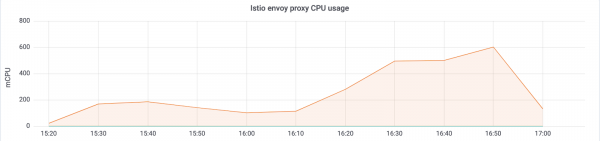
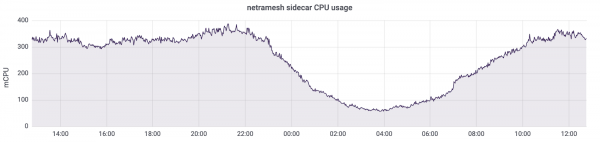
Există un alt aspect important: Netramesh este o soluție fără control plane și, fără sarcină, nu consumă timp de procesor. Cu Istio, sidecar-urile actualizează întotdeauna endpoint-urile serviciilor. Ca urmare, putem vedea următoarea imagine fără sarcină:
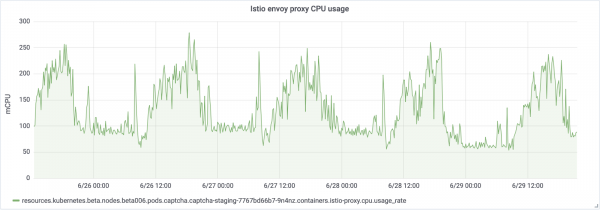
Folosim HTTP/1 pentru interacțiunea între servicii. Timpul de răspuns crescut al Istio la proxying prin envoy a fost de până la 5-10ms, ceea ce este destul de mult pentru serviciile care sunt pregătite să răspundă în milisecunde. Cu Netramesh, acest timp a scăzut la 0.5-2ms.
Scalabilitate
O cantitate mică de resurse consumate de fiecare proxy permite amplasarea acestuia lângă fiecare serviciu. Netramesh a fost creat intenționat fără un component de control plane pentru a păstra ușurința fiecărui sidecar. Adesea, în soluțiile service mesh, control plane-ul distribuie informațiile de service discovery în fiecare sidecar. Odată cu aceasta vin și informațiile despre timeout-uri, setările de balansare. Toate acestea permit realizarea multor lucruri utile, dar, din păcate, măresc dimensiunea sidecar-urilor.
Service discovery

Netramesh nu adaugă niciun mecanism suplimentar pentru service discovery. Tot traficul este proxy-izat în mod transparent prin netra sidecar.
Netramesh suportă protocolul aplicație HTTP/1. Pentru definirea sa, se folosește o listă de porturi configurabilă. De obicei, în sistem există mai multe porturi prin care se realizează interacțiunea prin HTTP. De exemplu, pentru interacțiunea serviciilor și solicitărilor externe, folosim 80, 8890, 8080. În acest caz, acestea pot fi definite prin intermediul unei variabile de mediu. NETRA_HTTP_PORTS.
Dacă utilizați Kubernetes ca orchestrator și mecanismul său de entitate Service pentru interacțiunea intra-cluster între servicii, mecanismul rămâne exact același. Mai întâi, microserviciul primește adresa IP a serviciului prin kube-dns și deschide o nouă conexiune către acesta. Această conexiune este stabilită mai întâi cu netra-sidecar local și toate pachetele TCP ajung inițial în netra. Ulterior, netra-sidecar stabilește conexiunea cu punctul inițial de destinare. NAT pe IP-ul podului de pe nod rămâne exact la fel ca și fără netra.
Tracing distribuit și propagarea contextului
Netramesh oferă funcționalitatea necesară pentru a trimite span-uri de tracing despre interacțiunea HTTP. Netra-sidecar parsează protocolul HTTP, măsoară întârzierile cererilor, extrage informațiile necesare din header-ele HTTP. În cele din urmă, obținem toate trace-urile într-un sistem Jaeger unic. Pentru o configurare fină, se pot folosi de asemenea variabile de mediu, oferite de biblioteca oficială. .
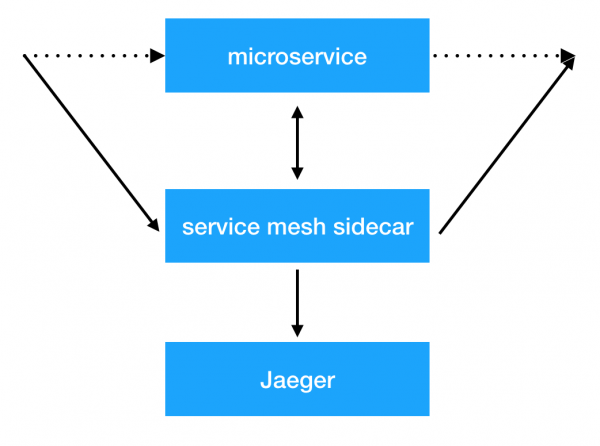
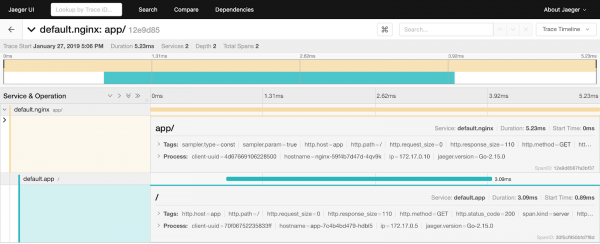
Dar există o problemă. Până când serviciile nu vor genera și nu vor propaga un header special uber, nu vom vedea span-urile de tracing conectate în sistem. Și aceasta este ceea ce avem nevoie pentru a găsi rapid cauza problemelor. Aici Netramesh are din nou o soluție. Proxile citesc header-ele HTTP și, dacă nu conțin uber trace id, îl generează. Netramesh de asemenea stochează informații despre solicitările de intrare și de ieșire în sidecar și le asociază prin îmbogățirea solicitărilor de ieșire cu header-ele necesare. Tot ce trebuie să facă serviciile este să propaga un singur header. X-Request-Id, care poate fi configurat printr-o variabilă de mediu. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Pentru gestionarea dimensiunii contextului în Netramesh, se pot stabili următoarele variabile de mediu: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (timpul în care contextul va fi păstrat) și NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (frecvența curățării contextului).
De asemenea, este posibil să combinați mai multe căi în sistemul dumneavoastră prin etichetarea acestora cu un marcator de sesiune special. Netra permite stabilirea HTTP_HEADER_TAG_MAP pentru a transforma anteturile HTTP în etichete corespunzătoare de tracere. Aceasta poate fi deosebit de utilă pentru testare. După ce ați finalizat un test funcțional, puteți observa ce parte a sistemului a fost afectată, filtrând după cheia de sesiune corespunzătoare.
Determinarea sursei cererii
Pentru a stabili de unde provine cererea, puteți utiliza funcționalitatea de adăugare automată a antetului sursei. Folosind variabila de mediu NETRA_HTTP_X_SOURCE_HEADER_NAME puteți specifica numele antetului care va fi setat automat. Prin NETRA_HTTP_X_SOURCE_VALUE puteți specifica valoarea care va fi setată pentru antetul X-Source în toate cererile ieșite.
Aceasta permite distribuirea uniformă a acestui antet util pe întreaga rețea. Acesta poate fi utilizat ulterior în servicii și adăugat în jurnalele de activitate, metrici.
Rutarea traficului și detaliile Netramesh
Netramesh este format din două componente principale. Prima, netra-init, stabilește reguli de rețea pentru interceptarea traficului. Aceasta folosește pentru a intercepta tot traficul sau o parte a acestuia către sidecar, care este a doua componentă principală a Netramesh. Puteți configura ce porturi anume trebuie interceptate pe sesiunile TCP de intrare și ieșire: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
De asemenea, instrumentul dispune de o caracteristică interesantă - rutare probabilistică. Dacă utilizați Netramesh exclusiv pentru colectarea de etichete de tracere, atunci în medii de producție puteți economisi resurse și activa rutarea probabilistică folosind variabilele NETRA_INBOUND_PROBABILITY și NETRA_OUTBOUND_PROBABILITY (de la 0 la 1). Valoarea implicită este 1 (se intercepta tot traficul).
După interceptarea cu succes, sidecar-ul netra acceptă o nouă conexiune și folosește SO_ORIGINAL_DST opțiunea socket-ului pentru a obține punctul de destinație inițial. Apoi, Netra deschide o nouă conexiune către adresa IP inițială și stabilește o comunicație TCP bidirecțională între părți, ascultând tot traficul trecut. Dacă portul este definit ca HTTP, Netra încearcă să-l parcurgă și să-l urmărească. Dacă parcurgerea HTTP eșuează, Netra revine la TCP și proxy-ează transparent bytes.
Construirea unui grafic de dependențe
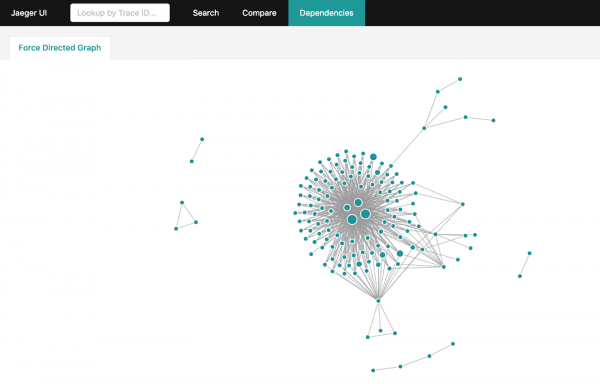
După obținerea unei cantități mari de informații de tracing în Jaeger, dorim să obținem un grafic complet al interacțiunilor din sistem. Dar dacă sistemul dvs. este suficient de încărcat și se acumulează miliarde de tracing span-uri pe zi, aggregarea lor devine o sarcină mai complicată. Există o metodă oficială pentru aceasta: . Cu toate acestea, va dura câteva ore să construim graficele complete și va necesita descărcarea întregului dataset din Jaeger pentru ultimele 24 de ore.
Dacă folosiți Elasticsearch pentru stocarea tracing span-urilor, puteți utiliza , care va construi un grafic similar în câteva minute, folosind caracteristicile și capabilitățile Elasticsearch.
Cum să folosiți Netramesh
Netra poate fi pur și simplu adăugat la orice serviciu care funcționează sub un orchestrator. Puteți viziona un exemplu .
În prezent, Netra nu oferă posibilitatea de a implementa automat sidecar-uri pentru servicii, dar există planuri pentru realizarea acestui lucru.
Viitorul Netramesh
Scopul principal este de a obține costuri minime de resurse și o performanță ridicată, oferind funcționalități esențiale pentru observabilitate și controlul interacțiunilor între servicii.
În viitor, Netramesh va suporta alte protocoale la nivel de aplicație pe lângă HTTP. În curând va fi disponibilă posibilitatea de rutare L7.
Utilizați Netramesh dacă vă confruntați cu probleme similare și contactați-ne cu întrebări și sugestii.
Sursa: habr.com
