

Până de curând, în Odnoklassniki se aflau aproximativ 50 TB de date, prelucrate în timp real, stocate în SQL Server. Asigurarea unui acces rapid, de încredere și rezistent la defecte la un astfel de volum de date, utilizând o bază de date SQL, este practic imposibilă. De obicei, în aceste cazuri se folosește una dintre soluțiile NoSQL, însă nu totul poate fi transferat în NoSQL: unele entități necesită garanții pentru tranzacții ACID.
Acest lucru ne-a dus la utilizarea unei soluții de tip NewSQL, adică a unui sistem de gestionare a bazelor de date care oferă rezistență la defecțiuni, scalabilitate și rapiditate, asemănătoare sistemelor NoSQL, dar păstrând în același timp garanțiile ACID cunoscute din sistemele clasice. Există puține sisteme industriale funcționale din această nouă categorie, așa că am implementat noi un astfel de sistem și l-am pus în exploatare industrială.
Cum funcționează și ce am realizat — citeste mai departe.
Astăzi, audiența lunară a 'Odnoklassniki' depășește 70 de milioane de vizitatori unici. Noi cele mai mari rețele sociale din lume și în top douăzeci de site-uri pe care utilizatorii își petrec cel mai mult timp. Infrastructura 'OK' gestionează sarcini foarte mari: peste un milion de solicitări HTTP pe secundă pe fronturi. Părțile parcului de servere, în număr de peste 8000, sunt amplasate aproape una de cealaltă - în patru centre de date din Moscova, ceea ce permite să se asigure o întârziere de rețea de mai puțin de 1 ms între ele.
Folosim Cassandra din 2010, începând cu versiunea 0.6. Astăzi, avem în exploatare câteva zeci de clustere. Cel mai rapid cluster gestionează peste 4 milioane de operații pe secundă, iar cel mai mare stochează 260 TB.
Totuși, toate acestea sunt clustere NoSQL obișnuite, folosite pentru stocarea Noi am dorit să înlocuim principala soluție de stocare consistentă, Microsoft SQL Server, care a fost utilizată încă de la înființarea 'Odnoklassniki'. Stocarea consta în peste 300 de servere SQL Server Standard Edition, care conțineau 50 TB de date - entități de afaceri. Aceste date sunt modificate în cadrul tranzacțiilor ACID și necesită .
Pentru distribuirea datelor pe noduri SQL Server, am folosit atât partitonare verticală, cât și orizontală. (sharding). Din punct de vedere istoric, am utilizat un sistem simplu de sharding al datelor: fiecărei entități îi era asociat un token — o funcție pe baza ID-ului entității. Entitățile cu același token erau plasate pe un singur server SQL. Relația de tip master-detail era implementată astfel încât token-urile înregistrării principale și celei derivate să coincidă întotdeauna și să se afle pe același server. În rețelele sociale, aproape toate înregistrările sunt generate în numele utilizatorului — ceea ce înseamnă că toate datele utilizatorului din cadrul unei subsisteme funcționale erau stocate pe un singur server. Așadar, în cadrul unei tranzacții de afaceri, aproape întotdeauna erau implicate tabele de pe un singur server SQL, ceea ce permitea asigurarea coerenței datelor prin tranzacții ACID locale, fără a fi necesară utilizarea distribuite.
Datorită sharding-ului și pentru a accelera funcționarea SQL:
- Nu folosim constrângeri Foreign key, deoarece în cazul sharding-ului ID-ul entității ar putea fi pe un alt server.
- Nu folosim proceduri stocate și trigger-e din cauza încărcării suplimentare pe CPU-ul SGBD.
- Nu folosim JOIN-uri din cauza tuturor celor menționate mai sus și a numărului mare de citiri aleatorii de pe disc.
- În afara tranzacției, pentru a reduce blocările, utilizăm nivelul de izolare Read Uncommitted.
- Executăm doar tranzacții scurte (în medie sub 100 ms).
- Nu folosim UPDATE-uri și DELETE-uri multi-row din cauza numărului mare de blocări — actualizăm doar câte o înregistrare.
- Executăm întotdeauna interogările doar pe indecși — interogarea cu un plan de vizualizare completă a tabelului pentru noi înseamnă o suprasarcină a DB-ului și eșecul acestuia.
Acești pași ne-au permis să extragem aproape maximum de performanță din serverele SQL. Totuși, problemele deveneau din ce în ce mai multe. Să le examinăm.
Probleme cu SQL
- Deoarece am folosit sharding personalizat, adăugarea de noi shardi era realizată manual de către administratori. În tot acest timp, replicile scalabile ale datelor nu deservesc solicitările.
- Pe măsură ce numărul de înregistrări din tabel crește, viteza inserției și modificării scade; adăugarea de indecși pe un tabel existent reduce drastic viteza, iar crearea și recrearea indecșilor se face cu timp de nefuncționare.
- Prezența unui număr mic de Windows pentru SQL Server în producție îngreunează gestionarea infrastructurii.
Însă problema principală este —
Redundanță
Serverele SQL clasice au o disponibilitate slabă. Să presupunem că aveți un singur server de baze de date, iar acesta se defectează o dată la trei ani. În această perioadă, site-ul nu funcționează timp de 20 de minute, ceea ce poate fi acceptabil. Dacă aveți 64 de servere, site-ul nu funcționează deja o dată la fiecare trei săptămâni. Și dacă aveți 200 de servere, site-ul nu funcționează săptămânal. Aceasta este o problemă.
Ce se poate face pentru a îmbunătăți disponibilitatea serverului SQL? Wikipedia ne sugerează să construim : unde, în cazul defectării oricărei componente, există o copie redundantă.
Aceasta necesită un parc costisitor de echipamente: numeroase duplicări, fibră optică, stocare partajată, iar activarea rezervelor funcționează nesigur: aproximativ 10% din activări se termină cu eșecul nodului de rezervă urmând nodul principal.
Dar principalul dezavantaj al unui astfel de cluster de înaltă disponibilitate este lipsa totală de accesibilitate în cazul defectării centrului de date în care se află. „Odnoklassniki” are patru centre de date, iar noi trebuie să asigurăm funcționarea în caz de avarie totală în unul dintre ele.
Pentru aceasta, am putea aplica , integrată în SQL Server. Această soluție este mult mai costisitoare din cauza prețului software-ului și suferă de probleme bine cunoscute cu replicarea — întârzieri imprevizibile ale tranzacțiilor în cazul replicării sincronice și întârzieri în aplicarea replicărilor (și, ca urmare, modificări pierdute) în cazul celei asincrone. Răspunsul implicit la aceste probleme face ca această variantă să fie complet neaplicabilă pentru noi.
Toate aceste probleme necesitau o soluție radicală și am început analiza detaliată a lor. Aici trebuie să ne familiarizăm cu ceea ce face, în principal, SQL Server — tranzacțiile.
O tranzacție simplă
Să examinăm cea mai simplă tranzacție, din perspectiva unui programator SQL aplicativ: adăugarea unei fotografii într-un album. Albumele și fotografiile sunt stocate în tabele diferite. Albumul are un contor al fotografiilor publice. Atunci, această tranzacție se împarte în următorii pași:
- Blokăm albumul pe cheie.
- Creăm o înregistrare în tabelul fotografiilor.
- Dacă fotografia are statut public, atunci incrementăm contorul fotografiilor publice din album, actualizăm înregistrarea și facem commit tranzacției.
Sau sub formă de pseudocod:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Observăm că cel mai frecvent scenariu pentru o tranzacție de afaceri este citirea datelor din baza de date în memoria serverului de aplicații, modificarea acestora și salvarea noilor valori înapoi în baza de date. De obicei, în cadrul unei astfel de tranzacții, actualizăm mai multe entități, mai multe tabele.
La executarea unei tranzacții, poate apărea modificarea concurentă a acelorași date dintr-un alt sistem. De exemplu, un sistem anti-spam poate decide că un utilizator este suspect și, prin urmare, toate fotografiile acestui utilizator nu mai trebuie să fie publice, trebuie trimise pentru moderare, ceea ce înseamnă să schimbăm photo.status într-o altă valoare și să ajustăm contorii corespunzători. Este evident că, dacă această operație va fi efectuată fără garanții de atomicitate și de izolare a modificărilor concurente, ca în , rezultatul nu va fi cel necesar — ori contorul fotografiilor va arăta o valoare greșită, ori nu toate fotografiile vor fi trimise pentru moderare.
O astfel de logică, care manipulează diverse entități de afaceri într-o singură tranzacție, a fost scrisă de foarte multe ori pe parcursul existenței Odnoklassniki. Din experiența migrațiilor către NoSQL cu știm că cele mai mari dificultăți (și pierderi de timp) sunt cauzate de necesitatea de a dezvolta cod menit să mențină consistența datelor. Prin urmare, cerința principală pentru noul magazin de date a fost asigurarea pentru logica aplicației a tranzacțiilor ACID reale.
Alte cerințe, la fel de importante, au fost:
- În cazul unei defecțiuni a centrului de date, atât citirea, cât și scrierea în noul magazin trebuie să fie disponibile.
- Menținerea vitezei actuale de dezvoltare. Cu alte cuvinte, lucrând cu noul magazin, cantitatea de cod ar trebui să fie aproximativ aceeași, fără necesitatea de a adăuga ceva în magazin, de a dezvolta algoritmi pentru rezolvarea conflictelor, de a menține indecși secundari etc.
- Viteza de operare a noului magazin de date trebuie să fie suficient de mare atât pentru citirea datelor, cât și pentru procesarea tranzacțiilor, ceea ce înseamnă în mod eficient inadecvarea soluțiilor academice riguroase, universale, dar lent eficiente, precum .
- Scalare automatizată în timp real.
- Folosirea serverelor obișnuite și ieftine, fără a fi necesară achiziția de echipamente exotice.
- Posibilitatea de a dezvolta stocarea cu ajutorul echipei de dezvoltare a companiei. Cu alte cuvinte, prioritatea era dată soluțiilor interne sau bazate pe cod deschis, de preferat pe Java.
Soluții, soluții
Analizând posibilitățile, am ajuns la două opțiuni de arhitectură:
Prima opțiune este să luăm orice server SQL și să implementăm fiabilitatea necesară, mecanismul de scalare, un cluster rezistent la erori, rezolvarea conflictelor și tranzacții ACID distribuite, fiabile și rapide. Am evaluat această opțiune ca fiind destul de dificilă și consumatoare de timp.
A doua opțiune este să folosim un stocaj NoSQL gata pregătit, cu scalare implementată, un cluster rezistent la erori, rezolvarea conflictelor și să implementăm tranzacții și SQL noi. La prima vedere, chiar și sarcina de a implementa SQL, să nu mai vorbim de tranzacțiile ACID, pare un proiect de lungă durată. Dar apoi am realizat că setul de funcționalități SQL pe care îl utilizăm în practică este departe de ANSI SQL la fel de departe precum departe de ANSI SQL. Privind mai atent CQL, am realizat că este destul de apropiat de ceea ce avem nevoie.
Cassandra și CQL
Așadar, ce găsim interesant la Cassandra, ce caracteristici are?
În primul rând, este posibil să creăm tabele care suportă diverse tipuri de date, iar SELECT sau UPDATE pot fi realizate pe baza cheii primare.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Pentru a asigura consistența datelor replicilor, Cassandra folosește . În cel mai simplu caz, aceasta înseamnă că, atunci când se plasează trei replici ale aceleași înregistrări pe noduri diferite ale unui cluster, înregistrarea este considerată reușită dacă majoritatea nodurilor (adică două din trei) confirmă succesul acestei operațiuni de scriere. Datele înregistrării sunt considerate consistente dacă, la citire, majoritatea nodurilor au fost interogate și au confirmat acestea. Astfel, cu trei replici disponibile, se garantează consistența completă și instantanee a datelor în cazul defectării unei noduri. Această abordare ne-a permis să implementăm un schema și mai fiabilă: să trimitem întotdeauna cereri către toate cele trei replici, așteptând răspuns de la cele două cele mai rapide. Răspunsul întârziat al celei de-a treia replici este astfel ignorat. Nodul care întârzîie la răspuns poate avea probleme grave — blocări, colectare de gunoi în JVM, recuperare de memorie directă în nucleul Linux, defecțiuni hardware, deconectare de la rețea. Cu toate acestea, acest lucru nu afectează operația clientului și datele.
Abordarea în care ne adresăm la trei noduri, dar primim răspuns de la două, se numește : cererea pentru replicile în plus este trimisă înainte de a 'cădea'.
Un alt avantaj al Cassandra este Batchlog — un mecanism care garantează fie aplicarea completă, fie nerăspunderea completă a setului de modificări aduse de dvs. Aceasta ne permite să soluționăm A în ACID — atomicitatea din cutie.
Ceea ce este cel mai apropiat de tranzacții în Cassandra este așa-numitele «». Însă de tranzacțiile 'real' ACID sunt departe: de fapt, aceasta este posibilitatea de a efectua pe datele unei singure înregistrări, folosind consensul printr-un protocol greu de Paxos. Prin urmare, viteza acestor tranzacții nu este mare.
Ce ne-a lipsit în Cassandra
Deci, ne-a fost necesar să implementăm tranzacții reale ACID în Cassandra. Cu ajutorul cărora am putea implementa cu ușurință două alte funcționalități utile ale DBMS tradiționale: indici consistenți rapizi, ceea ce ne-ar permite să efectuăm interogări de date nu doar după cheia primară și un generator obișnuit de ID-uri monotone autonumerotate.
C*One
Astfel s-a născut noua bază de date C*One, formată din trei tipuri de noduri server:
- Stocarea — servere Cassandra (aproape) standard, responsabile pentru stocarea datelor pe discurile locale. Pe măsură ce sarcina și volumul de date cresc, numărul lor poate fi ușor scalat până la zeci și sute.
- Coordonatorii de tranzacții — asigură execuția tranzacțiilor.
- Clienții — serverele de aplicații care implementează operațiuni de afaceri și inițiază tranzacții. Acești clienți pot fi mii.
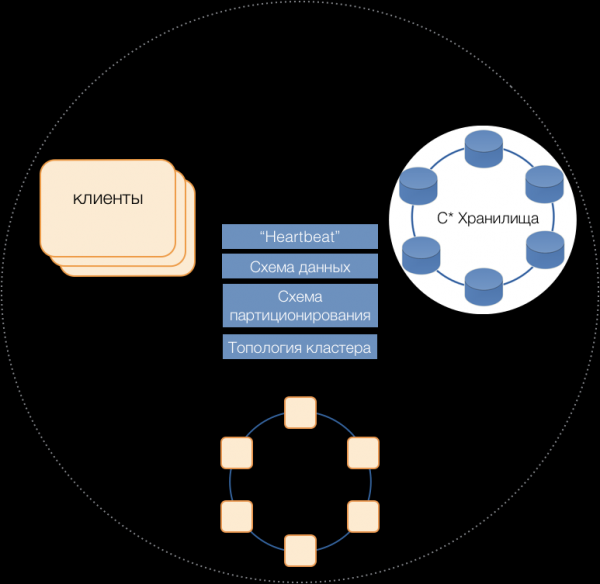
Serverele de toate tipurile fac parte dintr-un cluster comun, folosesc un protocol intern de mesagerie Cassandra pentru a comunica între ele și pentru a schimba informații despre cluster. Prin intermediul Heartbeat, serverele își notifică reciproc despre defecțiuni, mențin o schemă unitară de date — tabele, structura lor și replicarea; schema de partiționare, topologia clusterului, etc.
Clienți
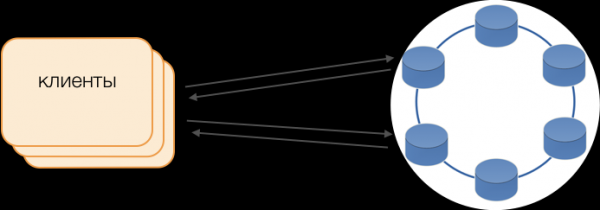
În locul driverelor standard se folosește modul Fat Client. Această nodă nu stochează date, dar poate acționa ca un coordonator al execuției cererilor, adică Clientul își îndeplinește singur funcția de coordonator pentru cererile sale: interoghează replicile stocării și rezolvă conflictele. Acest lucru este nu doar mai fiabil și mai rapid decât un driver standard, care necesită comunicarea cu un coordonator extern, ci permite și gestionarea transmiterii cererilor. În afara unei tranzacții deschise pe client, cererile sunt direcționate către stocări. Dacă clientul a deschis o tranzacție, atunci toate cererile din cadrul tranzacției sunt direcționate către coordonatorii de tranzacții.
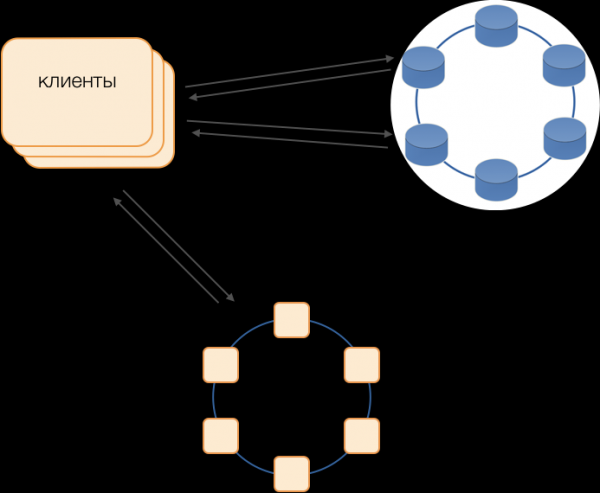
Coordonatorul tranzacțiilor C*One
Coordonatorul — ceea ce am implementat pentru C*One de la zero. El se ocupă cu gestionarea tranzacțiilor, blocajelor și ordinii de aplicare a tranzacțiilor.
Pentru fiecare tranzacție deservită, coordonatorul generează un timestamp: fiecare următoare este mai mare decât cea a tranzacției anterioare. Deoarece în Cassandra sistemul de rezolvare a conflictelor se bazează pe timestamp-uri (dintre două înregistrări conflictuale, cea cu timestamp-ul mai recent este considerată actuală), conflictul va fi întotdeauna rezolvat în favoarea tranzacției următoare. Astfel am implementat — o metodă ieftină de rezolvare a conflictelor într-un sistem distribuit.
Blocajele
Pentru a asigura izolația am ales să folosim cea mai simplă metodă — blocaje pesimiste pe cheia primară a înregistrării. Cu alte cuvinte, în cadrul tranzacției, înregistrarea trebuie mai întâi blocată, apoi citită, modificată și salvată. Numai după un commit de succes, înregistrarea poate fi deblocată, pentru ca tranzacțiile concurente să o poată utiliza.
Implementarea unei astfel de blocări este simplă într-un mediu nedistribuit. Într-un sistem distribuit, există două abordări principale: fie se implementează o blocare distribuită în cluster, fie se distribuie tranzacțiile astfel încât tranzacțiile care implică o înregistrare să fie întotdeauna gestionate de același coordonator.
În cazul nostru, datele sunt deja distribuite în grupuri de tranzacții locale în SQL, așa că s-a decis atribuirea coordonatorilor grupurilor de tranzacții locale: un coordonator efectuează toate tranzacțiile cu tokenul de la 0 la 9, al doilea - cu tokenul de la 10 la 19, și așa mai departe. Drept urmare, fiecare dintre instanțele coordonatorului devine liderul grupului de tranzacții.
Atunci, blocările pot fi implementate sub forma unui simplu HashMap în memoria coordonatorului.
Defecțiuni ale coordonatorilor
Deoarece un singur coordonator gestionează exclusiv un grup de tranzacții, este foarte important să se determine rapid dacă acesta a picat, pentru a asigura reluarea încercării de execuție a tranzacției în termenul limită. Pentru a realiza acest lucru rapid și fiabil, am aplicat un protocol de tip heartbeat cu quorum legat pe toate nodurile:
În fiecare centru de date sunt amplasate minimum două noduri de coordonator. Perioada de timp, fiecare coordonator trimite un mesaj heartbeat celorlalți coordonatori, informându-i despre funcționarea sa și despre mesajele heartbeat pe care le-a primit ultima dată de la ceilalți coordonatori din cluster.
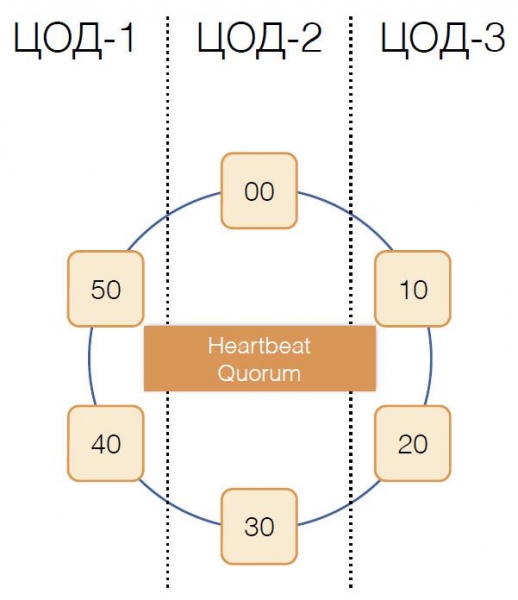
Primind informații similare de la ceilalți în mesajele lor heartbeat, fiecare coordonator decide pentru sine care noduri din cluster funcționează și care nu, bazându-se pe principiul quorum-ului: dacă nodul X a primit de la majoritatea nodurilor din cluster informația că a primit mesajele de la nodul Y, înseamnă că Y funcționează. Și invers, imediat ce majoritatea raportează că nu mai primesc mesaje de la nodul Y, înseamnă că Y a eșuat. Este interesant că, dacă quorum-ul informează nodul X că nu mai primește mesaje de la el, înseamnă că însuși nodul X se va considera că a picat.
Mesajele heartbeat sunt trimise cu o frecvență mare, aproximativ de 20 de ori pe secundă, cu un interval de 50 ms. În Java este greu să garantăm un timp de răspuns al aplicației de 50 ms din cauza pauzelor comparabile cauzate de colectorul de gunoi. Am reușit să obținem un timp de răspuns astfel utilizând colectorul de gunoi G1, care permite specificarea unei ținte pentru durata pauzelor GC. Totuși, uneori, destul de rar, pauzele colectorului depășesc 50 ms, ceea ce poate duce la detectarea falsă a unei defecțiuni. Pentru a evita acest lucru, coordonatorul nu semnalează defecțiunea nodului îndepărtat la pierderea primului mesaj heartbeat de la acesta, ci doar dacă mai multe mesaje consecutive sunt pierdute. Astfel, am reușit să realizăm detectarea defecțiunii nodului coordonator în 200 ms.
Însă, este insuficient să înțelegem rapid care nod a încetat să funcționeze. Trebuie să facem ceva în legătură cu asta.
Rezervare
Schema clasică presupune, în cazul unei defecțiuni a master-ului, inițierea alegerii unui nou master folosind unul dintre faimoși. Totuși, aceste algoritmi au probleme bine cunoscute legate de convergența în timp și de durata procesului de alegere. Am reușit să evităm astfel de întârzieri suplimentare printr-o schemă de substituție a coordonatorilor într-o rețea complet interconectată:
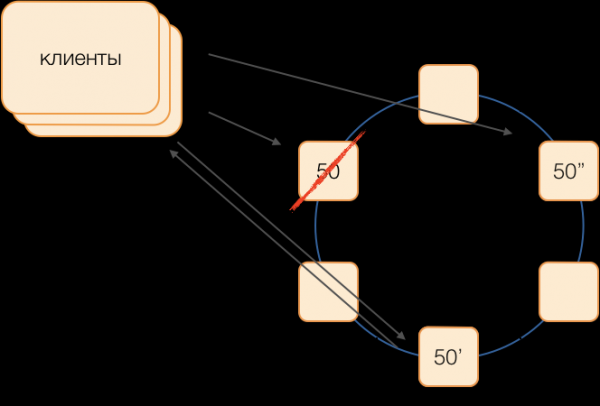
Să presupunem că dorim să efectuăm o tranzacție în grupul 50. Să stabilim din timp schema de substituție, adică ce noduri vor executa tranzacțiile grupului 50 în cazul defecțiunii coordonatorului principal. Scopul nostru este de a menține funcționalitatea sistemului în cazul unei defecțiuni a unui centru de date. Să stabilim că primul rezerv este un nod dintr-un alt centru de date, iar al doilea rezerv este un nod dintr-un al treilea. Această schemă este aleasă o singură dată și nu se schimbă până când nu se schimbă topologia cluster-ului, adică până nu intră noduri noi (ceea ce se întâmplă foarte rar). Ordinea alegerii unui nou master activ în cazul defecțiunii celui vechi va fi întotdeauna următoarea: primul rezerv va deveni master activ, iar dacă și acesta încetează să funcționeze, al doilea rezerv.
Această schemă este mai fiabilă decât algoritmul universal, deoarece pentru activarea unui nou master este suficient să determinăm faptul că vechiul a eșuat.
Dar cum își vor da seama clienții care dintre maeștri lucrează în prezent? În 50 ms nu este posibil să trimitem informații la mii de clienți. Există posibilitatea ca un client să trimită o cerere de deschidere a unei tranzacții, fără să știe că acel maestru nu mai funcționează, iar cererea să rămână blocată pe timeout. Pentru a evita acest lucru, clienții trimit speculativ cereri de deschidere a unei tranzacții atât către maestrul grupului, cât și către toți rezervi. Dar doar acel maestru care este activ în acel moment va răspunde la cerere. Toată comunicarea ulterioară în cadrul tranzacției va avea loc doar cu maestrul activ.
Maeștrii de rezervă care primesc cereri pentru tranzacții care nu le aparțin le plasează în coada tranzacțiilor nenăscute, unde rămân pentru un timp. Dacă maestrul activ moare, noul maestru preia cererile de deschidere a tranzacțiilor din coada sa și răspunde clientului. Dacă clientul a reușit deja să deschidă o tranzacție cu vechiul maestru, atunci al doilea răspuns este ignorat (și, evident, acea tranzacție nu se va finaliza și va fi repetată de client).
Cum funcționează tranzacția
Să presupunem că un client a trimis coordonatorului o cerere de deschidere a unei tranzacții pentru o anumită entitate cu o anumită cheie primară. Coordonatorul blochează această entitate și o plasează în tabelul de blocare în memorie. Dacă este necesar, coordonatorul citește această entitate din stocare și salvează datele obținute în starea tranzacției în memoria coordonatorului.
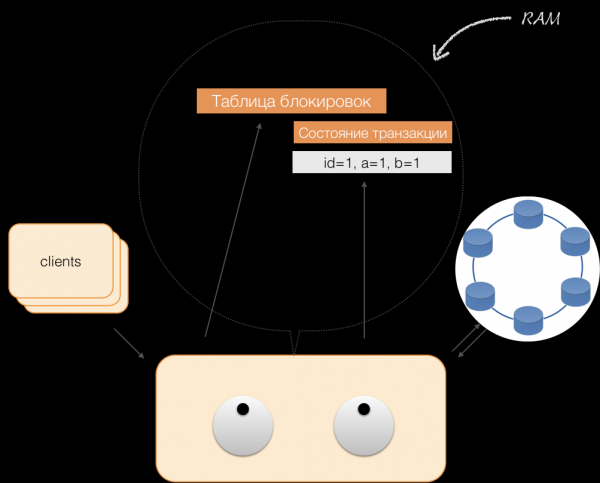
Când clientul dorește să modifice datele în tranzacție, trimite coordonatorului o cerere de modificare a entității, iar acesta plasează noile date în tabelul stării tranzacțiilor din memorie. La acest punct, înregistrarea a fost finalizată — nu se efectuează o înregistrare în stocare.
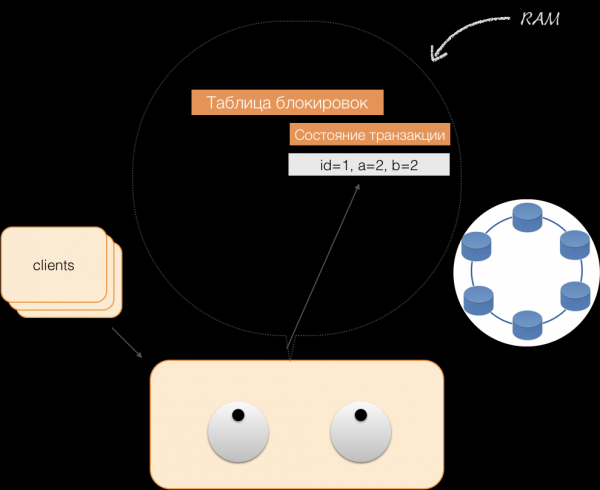
Când clientul solicită datele sale modificate în cadrul unei tranzacții active, coordonatorul acționează astfel:
- dacă ID-ul este deja prezent în tranzacție, datele sunt preluate din memorie;
- dacă ID-ul nu este în memorie, datele lipsă sunt citite din nodurile de stocare, combinate cu cele deja existente în memorie, iar rezultatul este returnat clientului.
Astfel, clientul poate citi propriile modificări, iar ceilalți clienți nu văd aceste modificări, deoarece sunt stocate doar în memoria coordonatorului, în nodurile Cassandra încă nu există.
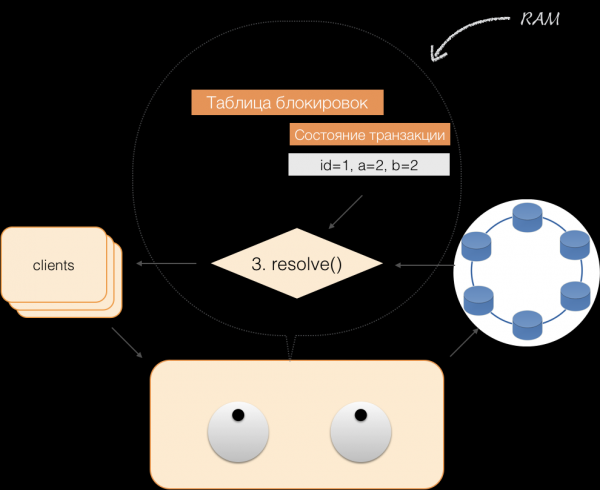
Când un client trimite un commit, starea care era în memorie la serviciu este salvată de coordonator în batch-ul înregistrat, iar sub formă de batch înregistrat este trimisă către depozitele Cassandra. Depozitele fac tot ce este necesar pentru ca acest pachet să fie aplicat atomic (întreaga) și returnează un răspuns coordonatorului, care apoi deblochează și confirmă succesul tranzacției clientului.
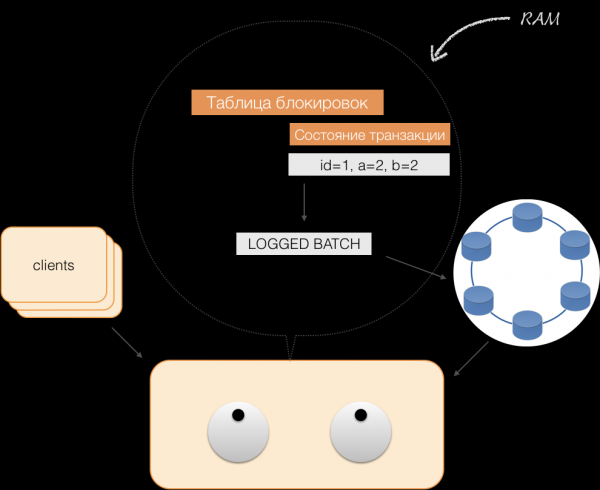
Iar pentru a anula, coordonatorului îi este suficient doar să elibereze memoria ocupată de starea tranzacției.
Ca rezultat al îmbunătățirilor descrise mai sus, am realizat principiile ACID:
- Atomicitate. Aceasta este o garanție că nicio tranzacție nu va fi înregistrată parțial în sistem, vor fi fie executate toate suboperațiile sale, fie nu va fi executată niciuna. La noi, acest principiu este respectat datorită batch-ului înregistrat în Cassandra.
- Consistență. Fiecare tranzacție reușită, prin definiție, înregistrează doar rezultate valide. Dacă după deschiderea tranzacției și executarea unei părți din operații se constată că rezultatul este invalid, se efectuează o anulare.
- Izolarea. În timpul executării unei tranzacții, tranzacțiile paralele nu ar trebui să influențeze rezultatul acesteia. Tranzacțiile concurente sunt izolate prin blocări pesimiste pe coordonator. Pentru citiri în afara tranzacției, se respectă principiul izolării la nivelul Read Committed.
- Durabilitate. Indiferent de problemele de la nivelurile inferioare - deconectarea sistemului, eșecul echipamentului - modificările efectuate de o tranzacție finalizată cu succes trebuie să rămână salvate după reluarea funcționării.
Citește după indecși
Să luăm un tabel simplu:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Acesta are un ID (cheie primară), un proprietar și o dată de modificare. Trebuie să facem o cerere foarte simplă - să selectăm datele în funcție de proprietar cu data de modificare „în ultimele 24 de ore”.
SELECT *
WHERE owner=?
AND modified>?
Pentru ca o astfel de cerere să fie procesată rapid, într-o bază de date SQL clasică, trebuie construit un index pe coloanele (owner, modified). Acest lucru îl putem face destul de ușor, deoarece acum avem garanțiile ACID!
Indecși în C*One
Există un tabel de bază cu fotografii, în care ID-ul înregistrării este cheia primară.
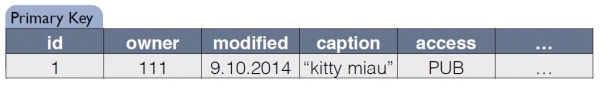
Pentru index, C*One creează un nou tabel care este o copie a tabelului original. Cheia se potrivește cu expresia index, incluzând, de asemenea, cheia primară a înregistrării din tabelul original:
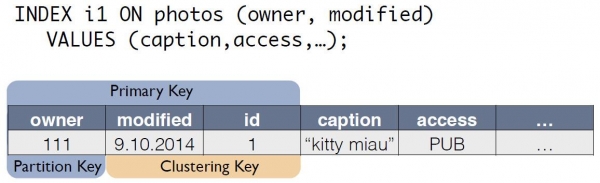
Acum, interogarea pentru „proprietar în ultimele 24 de ore” poate fi rescrisă ca un select dintr-un alt tabel:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Coerența datelor din tabelul original photos și din indexul i1 este menținută automat de coordonator. Pe baza doar a schemei de date, atunci când se primește o modificare, coordonatorul generează și reține modificarea nu doar a tabelului principal, ci și a modificărilor copiilor. Nu se efectuează nicio acțiune suplimentară cu tabelul indexului, jurnalele nu sunt citite, blocările nu sunt utilizate. Adică, adăugarea indecșilor consumă aproape resurse minime și nu influențează practic viteza de aplicare a modificărilor.
Cu ajutorul ACID, am reușit să implementăm indecși „ca în SQL”. Aceștia au coerență, pot scala, funcționează rapid, pot fi compuși și integrați în limbajul de interogări CQL. Pentru a susține indecșii, nu este necesar să se facă modificări în codul aplicației. Totul este simplu, ca în SQL. Și ceea ce este cel mai important, indecșii nu afectează viteza de execuție a modificărilor din tabelul original al tranzacțiilor.
Ce am obținut
Am dezvoltat C*One acum trei ani și l-am lansat în exploatare industrială.
Ce am obținut în final? Să evaluăm acest lucru prin exemplul subsistemului de procesare și stocare a fotografiilor, unul dintre cele mai importante tipuri de date din rețeaua socială. Nu este vorba despre corpurile fotografiilor, ci despre tot felul de metainformații. În prezent, în „Odnoklassniki” sunt aproximativ 20 miliarde astfel de înregistrări, sistemul procesează 80 de mii de interogări de citire pe secundă, până la 8 mii de tranzacții ACID pe secundă, legate de modificarea datelor.
Când am folosit SQL cu replication factor = 1 (dar în RAID 10), metainformația fotografiilor a fost stocată pe un cluster de înaltă disponibilitate format din 32 de mașini cu Microsoft SQL Server (plus 11 de rezervă). De asemenea, au fost alocate 10 servere pentru stocarea backup-urilor. În total, 50 de mașini costisitoare. În această situație, sistemul a funcționat la o sarcină nominală, fără rezerve.
După migrarea la noul sistem, am obținut un factor de replicare = 3 — câte o copie în fiecare centru de date. Sistemul este format din 63 de noduri de stocare Cassandra și 6 mașini coordonatoare, totalizând 69 de servere. Aceste mașini sunt însă semnificativ mai ieftine, costul total fiind de aproximativ 30% din costul sistemului SQL. În același timp, încărcătura se menține la un nivel de 30%.
Odată cu implementarea C*One, s-au redus și întârzierile: în SQL, operația de scriere dura aproximativ 4,5 ms. În C*One — aproximativ 1,6 ms. Durata tranzacției, în medie, este mai mică de 40 ms, commit-ul se realizează în 2 ms, durata citirii și scrierii — în medie 2 ms. Percentilul 99 este de doar 3-3,1 ms, iar numărul de timeout-uri s-a redus de 100 de ori — totul datorită aplicării pe scară largă a speculațiilor.
Până în prezent, cea mai mare parte a nodurilor SQL Server a fost scoasă din folosință, noile produse fiind dezvoltate doar cu utilizarea C*One. Am adaptat C*One pentru a funcționa în norul nostru. , ceea ce a permis accelerarea desfășurării de noi clustere, simplificând configurarea și automatizând exploatarea. Fără codul sursă, ar fi fost semnificativ mai complicat și mai dificultos.
În prezent, lucrăm la migrarea altor stocări în nor — dar aceasta este deja o altă poveste.
Sursa: habr.com
