

Un alt utilizator vrea să scrie o nouă bucată de date pe hard disk, dar nu are suficient spațiu liber pentru asta. Nici nu vrea să șteargă ceva, deoarece „toate sunt foarte importante și necesare”. Și ce ar trebui să facem în acest caz?
Această problemă nu este întâlnită doar de el. Pe hard disk-urile noastre se află terabytes de informație, iar această cantitate nu pare să scadă. Dar cât de unică este aceasta? La urma urmei, toate fișierele sunt doar seturi de biți de lungimi specifice și, cel mai probabil, noul fișier nu se deosebește foarte mult de cel care este deja stocat.
E clar că a căuta bucăți de informație deja stocate pe hard disk este o sarcină care, dacă nu este eșuată, atunci cel puțin nu este eficientă. Pe de altă parte, dacă diferența este mică, putem ajusta un pic...
TL;DR — o a doua încercare de a explica o metodă ciudată de optimizare a datelor prin fișiere JPEG, acum într-o formă mai ușor de înțeles.
Despre biți și diferențe
Dacă luăm două bucăți complet aleatorii de date, în medie, jumătate din biții conținuți coincid. Adevărat, printre posibilitățile pentru fiecare pereche (’00, 01, 10, 11′) exact jumătate au valori coincidente, aici e simplu.
Dar bineînțeles, dacă pur și simplu luăm două fișiere și ajustăm unul la altul, ne vom pierde unul din ele. Dacă salvăm modificările, vom reinventa simplement , care există și fără noi, chiar dacă nu este folosită de obicei în aceleași scopuri. Putem încerca să încorporăm o secvență mai mică într-una mai mare, dar chiar și așa, riscăm pierderea unor segmente critice de date în urma unei utilizări necugetate.
Între ce și ce putem elimina atunci diferența? Adică, fișierul nou înregistrat de utilizator — este doar o secvență de biți, cu care nu putem face nimic de la sine. Atunci trebuie să găsim pe hard disk astfel de biți, încât să-i putem modifica fără a fi necesar să stocăm diferența, pentru a putea suporta pierderea lor fără consecințe grave. Și are sens să modificăm nu doar fișierul pe sistemul de fișiere, ci și unele informații mai puțin sensibile din interiorul lui. Dar ce anume și cum?
Metodele de ajustare
Fișierele comprimate cu pierderi vin în ajutor. Toate aceste jpeg, mp3 și altele, deși sunt compresii cu pierderi, conțin o multitudine de biți disponibili pentru modificări sigure. Se pot folosi tehnici avansate care modifică discret componentele acestora în diferite zone de codare. Așteaptă. Tehnici avansate… modificare invizibilă… biți între altele… este aproape ca !
Și într-adevăr, înglobarea unei informații în alta este reminiscentă a metodelor sale. De asemenea, impresionează discreția modificărilor efectuate pentru simțurile umane. Aici drumurile se despard — iarăși, în ceea ce privește secretul: sarcina noastră se reduce la introducerea de către utilizator a unei informații suplimentare pe hard disk-ul său, care de fapt îl va afecta. O va uita.
Prin urmare, deși putem folosi aceste metode, trebuie să facem unele modificări. Și mai departe, voi explica și arăta acestea prin exemplul uneia dintre metodele existente și ale unui format de fișier popular.
Despre șacali
Dacă tot comprimăm, să comprimăm cele mai comprimabile din lume. Este vorba, desigur, despre fișierele JPEG. Nu numai că există o mulțime de instrumente și metode existente pentru înglobarea datelor în ele, dar este și cel mai popular format grafic de pe această planetă.
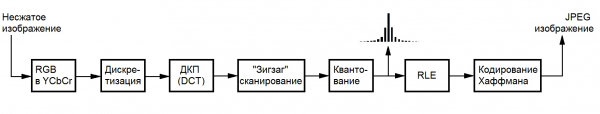
Cu toate acestea, pentru a nu ne ocupa de câini, trebuie să ne limităm aria de activitate la fișierele acestui format. Nimeni nu iubește pătratele uniforme care apar din cauza comprimării excesive, așa că trebuie să ne limităm la lucrul cu fișiere deja comprimate, evitând recodificarea. Mai precis — cu coeficienți întregi, care rămân după operațiile de pierdere a datelor — DCT și cuantizare, care sunt frumos reprezentate în schema de codare (mulțumim bibliotecii naționale Bauman):
Există multe metode posibile de optimizare a fișierelor jpeg. Există optimizare fără pierderi (jpegtran), există optimizări „„, care, de fapt, aduc ceva, dar pe noi nu ne interesează. Căci, dacă utilizatorul e dispus să înglobeze o informație în alta pentru a crește spațiul liber pe disc, atunci el și-a optimizat imaginile de multă vreme sau pur și simplu nu vrea să facă asta din teama de a pierde calitate.
F5
Pentru astfel de condiții se pot aplica o serie întreagă de algoritmi, cu care se poate familiariza. . Cel mai avansat dintre ei este algoritmul scris de Andreas Westfeld, care lucrează cu coeficientii componentei de luminozitate, deoarece ochiul uman este cel mai puțin sensibil la schimbările acesteia. Mai mult, el folosește o metodă de încorporare bazată pe codarea matricii, care permite realizarea unor modificări mai puține la încorporarea aceleași cantități de informație, cu cât dimensiunea containerului utilizat este mai mare.
Modificările se reduc la scăderea valorii absolute a coeficientilor cu unul în anumite condiții (adică, nu întotdeauna), ceea ce permite utilizarea F5 pentru optimizarea stocării datelor pe hard disk. Asta pentru că, după această modificare, coeficientul va ocupa, cel mai probabil, un număr mai mic de biți după efectuarea codării Huffman din cauza distribuției statistice a valorilor în JPEG, iar noile zerouri vor aduce beneficii la codificarea lor folosind RLE.
Modificările necesare se reduc la eliminarea părții responsabile pentru confidențialitate (permutarea parolei), care permite economisirea de resurse și timp de execuție, și la adăugarea unui mecanism de lucru cu mai multe fișiere în loc de unul câte unul. Detalii suplimentare despre procesul de modificare ar putea fi de puțin interes pentru cititor, așa că trecem la descrierea implementării.
Tehnologii avansate
Pentru a demonstra funcționalitatea unei astfel de abordări, am implementat o metodă în C pur și am realizat o serie de optimizări atât pentru viteza de execuție cât și pentru memoria utilizată (nu vă imaginați câte cântăresc aceste imagini fără compresie, chiar și până la DCT). Portabilitatea a fost obținută prin utilizarea unei combinații de biblioteci. , și , pentru care le mulțumim. Toate acestea sunt compilate cu 'make', așa că utilizatorii Windows care doresc să evalueze ar trebui să instaleze un Cygwin sau să se familiarizeze cu Visual Studio și bibliotecile pe cont propriu.
Implementarea este disponibilă sub forma unei utilitare de consolă și a unei biblioteci. Cei interesați de utilizarea celei din urmă pot consulta README-ul din repository-ul de pe GitHub, la care voi atașa un link la sfârșitul postării.
Cum se folosește?
Cu prudență. Imaginile folosite pentru ambalare sunt selectate prin căutare folosind expresii regulate în directorul rădăcină specificat. La finalizare, fișierele pot fi mutate, redenumite și copiate după dorință în interiorul acestuia, pot fi schimbate sistemele de fișiere și operare etc. Totuși, este important să fiți extrem de atenți și să nu modificați conținutul direct. Pierderea valorii chiar și unui singur bit poate duce la imposibilitatea recuperării informației.
La finalizarea activității, utilitarul lasă un fișier special de arhivă, conținând toate informațiile necesare pentru despachetare, inclusiv date despre imaginile utilizate. Acesta cântărește aproximativ câțiva kilobiți și nu are un impact semnificativ asupra spațiului pe disc ocupat.
Se poate analiza capacitatea posibilă folosind flag-ul ‘-a’: ‘./f5ar -a [folder căutare] [expresie regulată compatibilă Perl]’. Ambalarea se face cu comanda ‘./f5ar -p [folder căutare] [expresie regulată compatibilă Perl] [fișier ambalat] [nume arhivă]’, iar despachetarea cu ‘./f5ar -u [fișier arhivă] [nume fișier restaurat]’.
Demonstrarea funcționării
Pentru a arăta eficiența metodei, am încărcat o colecție de 225 de fotografii gratuite cu câini de pe serviciul și am găsit în documente un pdf mare de 45 de metri din volumul doi Knuth.
Secvența este destul de simplă:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Citind fișierul comprimat... ok
Inceperea arhivei... ok
Analizând capacitatea bibliotecii... finalizată în 17.0s
Capacitate garantată detectată de 48439359 bytes
Capacitate posibilă detectată de până la 102618787 bytes
Comprimând... finalizată în 39.4s
Salvând arhiva... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Inceperea arhivei... ok
Citind fișierul arhivă... ok
Umplerea arhivei cu fișiere... finalizată în 1.4s
Descompunând... finalizată în 21.0s
Scrierea datelor extrase... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Capturi de ecran pentru pasionați
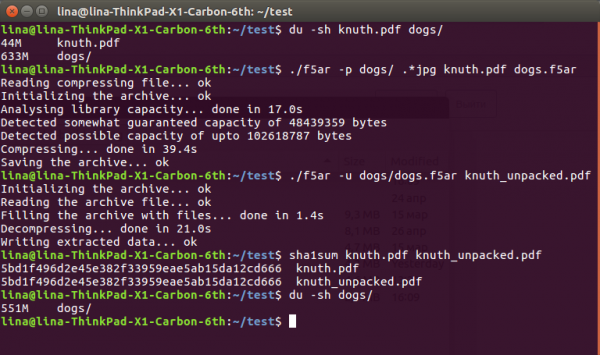
Fișierul despachetat poate fi și trebuie citit:
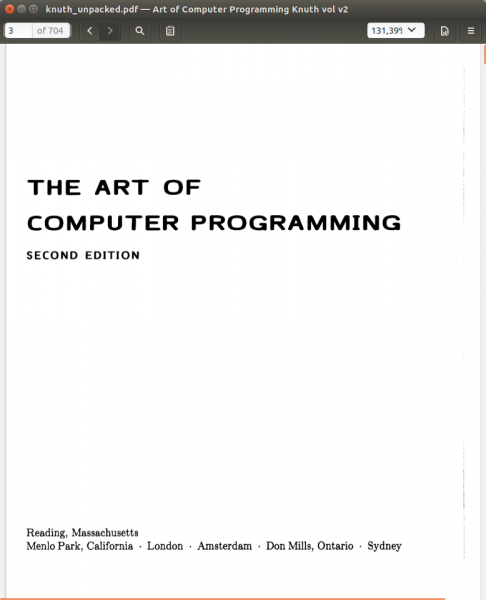
După cum se poate observa, de la 633 + 36 == 669 megabytes de date pe hard disk am ajuns la un 551 mai plăcut. Această diferență radicală se explică prin reducerea coeficientilor, care afectează comprimarea lor ulterioară fără pierderi: o scădere de doar 1 poate tăia câțiva bytes din fișierul final. Cu toate acestea, rămân pierderi de date, chiar dacă extrem de mici, cu care va trebui să ne împăcăm.
Din fericire, ele sunt complet invizibile pentru ochi. Sub spoiler (deoarece habrastorage nu suportă fișiere mari), cititorul poate evalua diferența atât vizual, cât și intensitatea acesteia, obținută prin scăderea valorilor componentei modificate din original: , , (cu cât culoarea este mai atenuată, cu atât diferența din bloc este mai mică).
În concluzie
Privind toate aceste dificultăți, achiziționarea unui hard disk sau încărcarea tuturor în cloud poate părea o soluție mult mai simplă a problemei. Dar chiar dacă trăim într-o eră minunată, nu există nicio garanție că mâine vom putea accesa internetul și să încărcăm toate datele noastre suplimentare. Sau să mergem într-un magazin și să cumpărăm un alt hard disk de o mie de terabaiți. Dar putem folosi oricând ceea ce avem deja acasă.
->
Sursa: habr.com
