

Primul prototip de stocare de obiecte a fost văzut în lume în 1996. După 10 ani, Amazon Web Services va lansa Amazon S3, iar lumea va începe treptat să devină obsedată de spațiul de adresare plat. Datorită lucrului cu meta datele și capacității sale de a se scalda fără a ceda sub încărcare, stocarea de obiecte a devenit rapid un standard pentru majoritatea serviciilor de stocare a datelor în cloud și nu numai. O altă caracteristică importantă este adaptabilitatea sa bună pentru stocarea arhivelor și a fișierelor folosite rar. Toți cei care erau implicați în stocarea datelor erau încântați și purtau noua tehnologie în brațe.
Dar bârfa populară era plină de zvonuri că stocarea de obiecte este doar pentru marii furnizori de cloud, iar dacă nu aveți nevoie de soluții de la acești capitaliști condamnați, atunci a face una proprie va fi foarte greu. S-au scris multe despre desfășurarea propriei infrastructuri cloud, dar informațiile despre crearea unor soluții compatibile S3 sunt destul de puține.
De aceea, astăzi ne vom ocupa de opțiunile „Așa cum fac cei mari, nu CEPH și un feronier mai mare”, vom desfășura una dintre ele, iar pentru a verifica dacă totul funcționează, vom folosi Veeam Backup & Replication. Acesta anunță suport pentru lucrul cu stocările compatibile S3, iar această afirmație o vom verifica.
Dar cum stau ceilalți?
Propun să începem cu o mică revizuire a pieței și opțiunilor de stocare de obiecte. Liderul recunoscut și standardul este Amazon S3. Cei doi cei mai apropiați concurenți sunt Microsoft Azure Blob Storage și IBM Cloud Object Storage.
Chiar și atât? Chiar nu există alți competitori? Sigur că există competitori, dar unii își urmează propriul drum, precum Google Cloud sau Oracle Cloud Object Storage, cu suport incomplet pentru API S3. Alții folosesc versiuni mai vechi ale API-ului, cum ar fi Baidu Cloud. Iar unii, precum Hitachi Cloud, necesită aplicarea unei logici speciale, ceea ce va provoca inevitabil dificultăți. În orice caz, toți sunt comparați cu Amazon, care poate fi considerat standardul din industrie.
În ceea ce privește soluțiile on-premise, opțiunile sunt mult mai variate, așa că haideți să stabilim criteriile importante pentru noi. În principiu, sunt suficiente doar două: suport pentru API S3 și utilizarea semnării v4. Sincer, ca viitor client, suntem interesați doar de interfețele de interacțiune, iar bucătăria interioară a stocării nu ne mai interesează atât de mult.
Sub aceste condiții simple se potrivesc foarte multe soluții. De exemplu, greoaiele corporative clasice:
- DellEMC ECS
- NetApp S3 StorageGrid
- Nutanix Buckets
- Pure Storage FlashBlade și StorReduce
- Huawei FusionStorage
Există o nișă pur software care funcționează din cutie:
- Red Hat Ceph
- SUSE Enterprise Storage
- Cloudian
Și chiar și cei care preferă să finiseze cu un pilon după asamblare nu au fost uitați:
- CEPH în forma sa pură
- Minio (versiunea pentru Linux, deoarece versiunea pentru Windows ridică multe întrebări)
Lista nu este deloc completă, se poate discuta în comentarii. Doar nu uitați să verificați performanța sistemului înainte de implementare, pe lângă compatibilitatea API. Ultimul lucru de care aveți nevoie este pierderea terabyte-urilor de date din cauza cererilor blocate. Așa că nu ezitați cu testele de încărcare. În general, tot software-ul matur care lucrează cu volume mari de date are cel puțin rapoarte de compatibilitate. În cazul Veeam are pentru testare reciprocă, care permite să afirmăm cu încredere de compatibilitatea totală a produselor noastre cu echipamentele specifice. Aceasta este o muncă bilaterală, nu întotdeauna rapidă, dar ne extindem constant soluțiile testate.
Construim standul nostru
Ar fi bine să discutăm puțin despre alegerea subiectului.
În primul rând, am vrut să găsesc o opțiune care să funcționeze imediat din cutie. Sau măcar cu o probabilitate maximă de a funcționa fără a face eforturi suplimentare. Dansurile cu tamburul și tinkering-ul consolei pe timpul nopții sunt foarte captivante, dar uneori îți dorești ca lucrurile să funcționeze imediat. De asemenea, fiabilitatea generală a acestor soluții este de obicei mai mare. Și da, ne-a dispărut spiritul aventurii, am încetat să mai escaladăm feroneria iubitelor noastre etc. (s).
În al doilea rând, dacă trebuie să fiu sincer, necesitatea de a lucra cu stocuri de obiecte apare la companii destul de mari, așa că acesta este exact cazul în care să te uiți la soluțiile de nivel enterprise nu doar că nu este rușinos, ci chiar încurajat. Oricum, până acum nu am cunoștințe despre vreun exemplu în care cineva a fost concediat pentru achiziționarea unor astfel de soluții.
Pe baza celor spuse anterior, alegerea mea a căzut pe Dell EMC ECS Community Edition. Este un proiect foarte interesant și consider că este necesar să vă povestesc despre el.
Primul lucru care îți vine în minte când vezi adăugarea Community Edition — că aceasta este o simplă copie a unui ECS complet, cu anumite restricții care sunt eliminate prin achiziționarea unei licențe. Așadar, nu este adevărat!
Rețineți:
!!!Community Edition este un proiect separat, creat pentru testare, fără suport tehnic din partea Dell!!
Și nu poate fi transformat într-un ECS complet, chiar dacă vă doriți foarte mult.
Să începem să discutăm
Mulți consideră că Dell EMC ECS este aproape cea mai bună soluție atunci când aveți nevoie de stocare de tip obiect. Toate proiectele sub marca ECS, inclusiv cele comerciale și corporative, se află pe . Un gest de bunăvoință din partea Dell. Și pe lângă software-ul care rulează pe serverele lor de marcă, există o versiune open-source care poate fi dezvoltată fie în cloud, fie pe o mașină virtuală, fie într-un container, fie pe orice hardware al dvs. În avans — există chiar și o versiune OVA, pe care o vom folosi.
Însuși DELL ECS Community Edition este o variantă mini a software-ului complet, care funcționează pe serverele de marcă Dell EMC ECS.
Am identificat patru diferențe principale:
- Nu există suport pentru criptare. Este trist, dar nu critic.
- Lipsește Fabric Layer. Această componentă se ocupă cu construirea de clustere, managementul resurselor, actualizările, monitorizarea și stocarea imaginilor Docker. Aici este cu adevărat dezamăgitor, dar Dell poate fi înțeles.
- Cele mai neplăcute consecințe ale punctului anterior: dimensiunea nodului nu poate fi extinsă după finalizarea instalării.
- Nu există suport tehnic. Acesta este un produs pentru testare, care nu este interzis să fie folosit în instalații mici, dar personal nu aș risca să stochez petaocte de date importante acolo. Dar din punct de vedere tehnic, nimeni nu vă poate împiedica să faceți acest lucru.
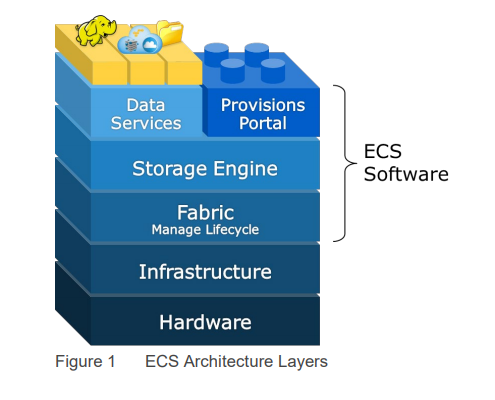
Și ce este în varianta mare?
Să facem o trecere rapidă prin soluțiile hardware, pentru a avea o imagine mai completă a ecosistemului.
Nu voi confirma sau infirma afirmația că DELL ECS este cea mai bună soluție de stocare de tip obiect on-prem, dar dacă aveți ceva de spus pe această temă, aș fi încântat să citesc în comentarii. Oricum, conform Dell EMC se află cu încredere în top cinci lideri ai pieței OBS. Deși soluțiile bazate pe cloud nu sunt incluse, dar aceasta este o discuție separată.
Din punct de vedere tehnic, ECS este un stocare de obiecte care oferă acces la date prin protocoale de stocare în cloud. Suportă AWS S3 și OpenStack Swift. Pentru bucket-urile activate pentru fișiere, ECS suportă NFSv3 pentru exportul pe fișiere.
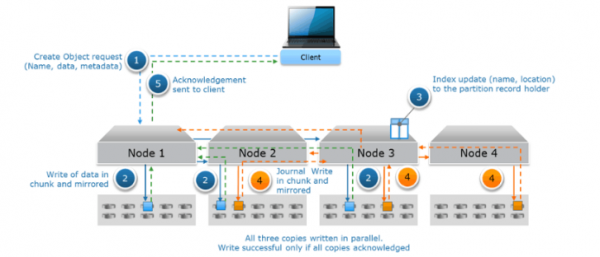
Procesul de scriere a informațiilor este destul de neobișnuit, mai ales în comparație cu sistemele clasice de stocare pe blocuri.
- Atunci când sosesc date noi, se creează un nou obiect, care are un nume, datele în sine și metadatele.
- Obiectele sunt împărțite în chunk-uri de 128 MB, și fiecare chunk este scris imediat pe trei noduri.
- Se actualizează fișierul index, care conține identificatorii și locurile de stocare.
- Fișierul jurnal (log de scriere) este actualizat și de asemenea scris pe trei noduri.
- Clientul primește un mesaj de confirmare pentru scrierea de succes.
Toate cele trei copii ale datelor sunt scrise în paralel. Scrierea este considerată reușită numai dacă toate cele trei copii au fost scrise cu succes.
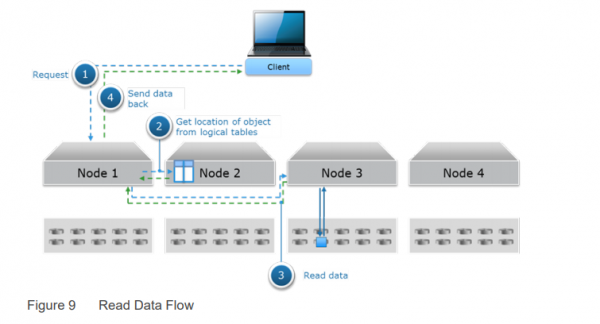
Citirea este mai simplă:
- Clientul solicită datele.
- În index se caută locul de stocare a datelor.
- Datele sunt citite de pe un nod și trimise clientului.
Există destul de multe servere, așa că să ne uităm la cel mai mic Dell EMC ECS EX300. Acesta începe de la 60TB, având posibilitatea de a crește până la 1,5PB. Iar fratele său mai mare, Dell EMC ECS EX3000, permite deja stocarea a nu mai puțin de 8,6PB pe rack.
Deploy
Din punct de vedere tehnic, Dell ECS CE poate fi desfășurat oricât de mare. În orice caz, nu am găsit limitări explicite. Totuși, tot scalarea este confortabil de realizat prin clonarea primului nod, pentru care avem nevoie de:
- 8 vCPU
- 64GB RAM
- 16GB pentru sistemul de operare
- 1TB direct pentru stocare
- Ultima versiune CentOS minimal
Aceasta este o variantă pentru cazul în care doriți să instalați totul singur de la început. Pentru noi, aceasta nu este o opțiune relevantă, deoarece voi folosi o imagine OVA pentru desfășurare.
Dar, în orice caz, cerințele sunt destul de drastice chiar și pentru un singur nod, iar dacă urmăm strict litera legii, ar trebui să avem patru astfel de noduri.
Cu toate acestea, dezvoltatorii ECS CE trăiesc în lumea reală și instalarea decurge cu succes chiar și cu un singur nod, iar cerințele minime sunt următoarele:
- 4 vCPU
- 16 GB RAM
- 16 GB pentru sistemul de operare
- 104 GB pentru stocare
Acestea sunt resursele necesare pentru desfășurarea imaginii OVA. Este mult mai uman și mai realist.
Nodul de instalare în sine poate fi obținut din surse oficiale. . Aici găsiți documentația detaliată pentru implementarea all-in-one, dar puteți citi în continuare pe site-ul oficial . Prin urmare, nu ne vom concentra prea mult pe desfășurarea OVA, totul este destul de simplu. Cel mai important este să nu uitați să extindeți discul la dimensiunea necesară sau să atașați cele necesare înainte de a-l porni.
Activăm mașina, deschidem consola și folosim cele mai bune credențiale implicite:
- login: admin
- parolă: ChangeMe
Apoi, lansăm sudo nmtui și configurăm interfața de rețea — IP/mască, DNS și gateway. Având în vedere că în CentOS minimal nu există net-tools, verificăm setările prin ip addr.
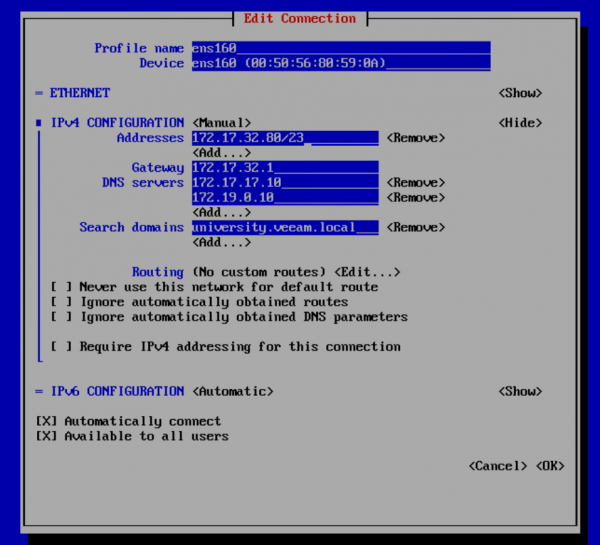
Și deoarece doar cei curajoși stăpânesc mările, facem yum update, după care reboot. De fapt, este destul de sigur, deoarece întreaga desfășurare se face prin playbooks, iar toate pachetele importante Docker sunt blocate pe versiunea curentă.
Acum este timpul să edităm scriptul de instalare. Fără feronerie sau UI pseudo-frumoase — totul prin editorul dvs. preferat de text. Tehnic, există două căi: puteți rula fiecare comandă manual sau puteți lansa configuratorul videploy. Acesta va deschide pur și simplu configurarea în vim și, la ieșire, va executa verificarea. Dar nu este interesant să ne simplificăm viața, așa că vom executa două comenzi în plus. Deși nu are sens, v-am avertizat =)
Deci, facem vim ECS-CommunityEdition/deploy.xml și aducem modificările optim-minime, astfel încât ECS să se activeze și să funcționeze. Lista parametrilor poate fi scurtată, dar am făcut-o astfel:
- licensed_accepted: true Puteți să nu o schimbați, atunci în timpul desfășurării veți fi întrebați explicit să o acceptați și vi se va arăta o frază drăguță. Poate este chiar o easter egg.

- Deblocați liniile autonames: și custom: Introduceți cel puțin un nume dorit pentru nod — hostname-ul va fi înlocuit cu acesta în timpul instalării.
- install_node: 192.168.1.1 Specificați IP-ul real al nodului. În cazul nostru, indicăm același IP ca în nmtui
- dns_domain: introduceți domeniul dvs.
- dns_servers: introduceți DNS-ul dvs.
- ntp_servers: puteți specifica orice. Eu am luat primul care mi-a ieșit în cale din pool 0.pool.ntp.org (acesta a fost 91.216.168.42)
- autonaming: custom Dacă nu deblocați, luna va fi denumită Luna.
- ecs_block_devices:
/dev/sdb
Dintr-un motiv necunoscut, aici poate apărea un dispozitiv de stocare bloc inexistent /dev/vda - storage_pools:
members:
192.168.1.1 Aici din nou specificăm IP-ul real al nodului - ecs_block_devices:
/dev/sdb Повторяем операцию вырезания несуществующих устройств.

De fapt, întregul fișier este foarte detaliat descris în , dar cine va citi asta într-un timp atât de agitat? Acolo este specificat că minim necesar este să indicați IP-ul și masca, însă în laboratorul meu, acel set a avut o funcționare slabă și a trebuit să extind la ceea ce am menționat mai sus.
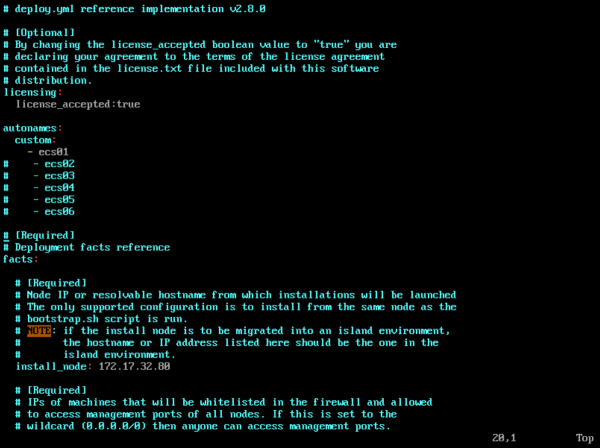
După ce ieși din editor, trebuie să rulezi update_deploy /home/admin/ECS-CommunityEdition/deploy.yml, și dacă totul a fost făcut corect, acest lucru va fi comunicat în mod explicit.
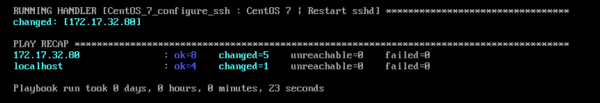
Apoi, tot va trebui să rulezi videploy, să aștepți actualizarea mediului și poți începe instalația cu comanda ova-step1, iar după executarea ei cu succes, comanda ova-step2. Important: nu opri manual rularea scripturilor! Unele etape pot dura mult timp, să nu fie realizate din prima tentativă și să pară că totul s-a stricat. În orice caz, așteaptă să se finalizeze scriptul în mod natural. La final, ar trebui să vezi un mesaj de genul acesta.
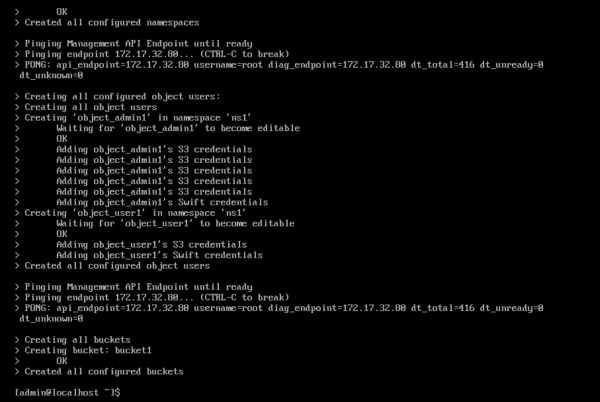
Acum, în sfârșit putem deschide panoul WebUI de control la IP-ul cunoscut. Dacă nu ai modificat nimic în etapa de configurare, atunci contul implicit va fi root/ChangeMe. Poți chiar să folosești imediat stocarea noastră compatibilă S3. Aceasta este disponibilă pe porturile 9020 pentru HTTP și 9021 pentru HTTPS. Din nou, dacă nu ai modificat nimic, access_key: object_admin1 și secret_key: ChangeMeChangeMeChangeMeChangeMeChangeMe.
Dar să nu ne grăbim prea tare și să începem cu pașii necesari.
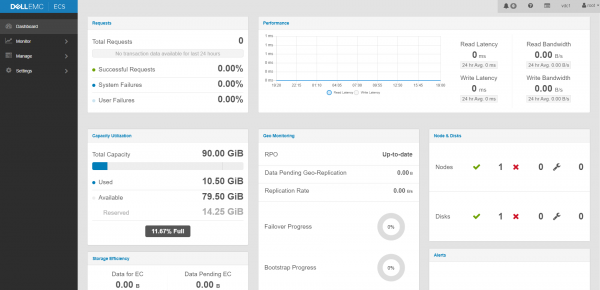
La prima autentificare, vei fi obligat să schimbi parola într-una adecvată, ceea ce este absolut corect. Principalul tablou de bord este extrem de intuitiv, așa că să facem ceva mai interesant decât să explicăm metricile evidente. De exemplu, să creăm un utilizator pe care îl vom folosi pentru acces la stocare. În lumea furnizorilor de servicii, aceste nume sunt denumite tenant. Se face în Manage > Users > New Object User.
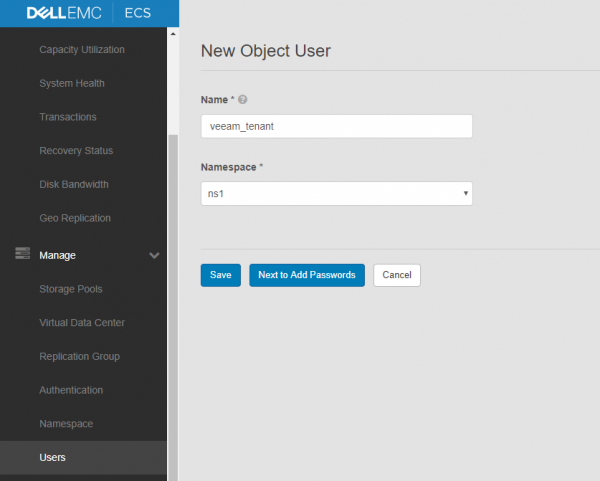
La crearea utilizatorului, ni se cere să indicăm namespace-ul. Tehnic, nimic nu ne oprește să creăm câte utilizatori dorim. Și invers. Acest lucru permite gestionarea resurselor independent pentru fiecare tenant.
Prin urmare, alegem funcțiile necesare și generăm cheile utilizatorului. Mie mi-ar fi suficient S3/Atmos. Și să nu uităm să salvăm cheia 😉.
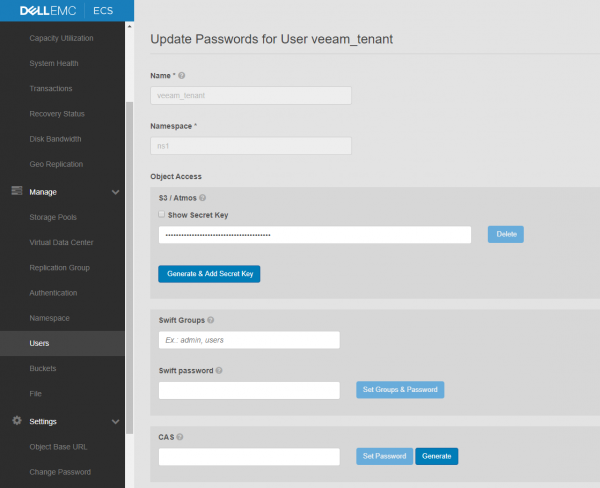
Utilizatorul a fost creat, acum trebuie să îi alocăm un bucket. Trecem în Manage > Bucket și completăm câmpurile necesare. Aici e totul simplu.
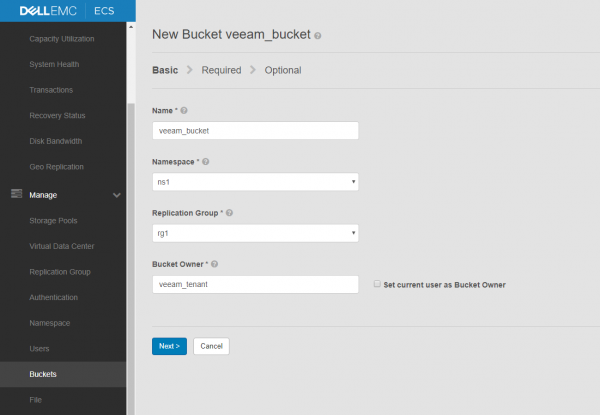
Acum suntem gata pentru utilizarea operativă a stocării noastre S3.
Configurăm Veeam
Așadar, după cum ne amintim, una dintre principalele aplicații ale stocării obiectelor este păstrarea pe termen lung a informațiilor la care se face rar apel. Un exemplu ideal este necesitatea de a stoca backup-uri pe o platformă externă. În Veeam Backup & Replication, această funcție se numește Capacity Tier.
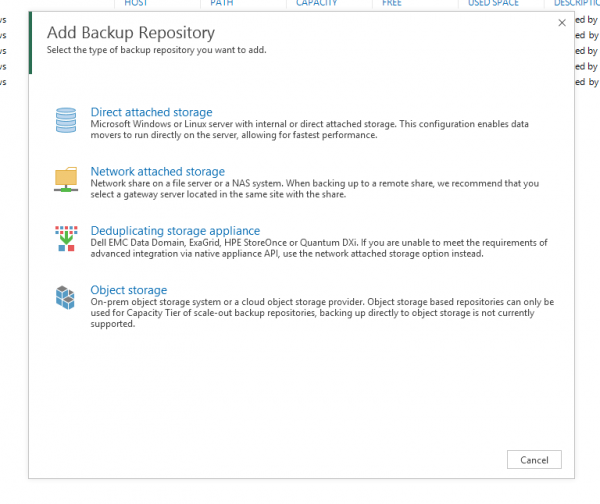
Să începem configurația prin adăugarea Dell ECS CE în interfața Veeam. În tab-ul Backup Infrastructure, lansăm asistentul pentru adăugarea unui nou repository și alegem opțiunea Object Storage.
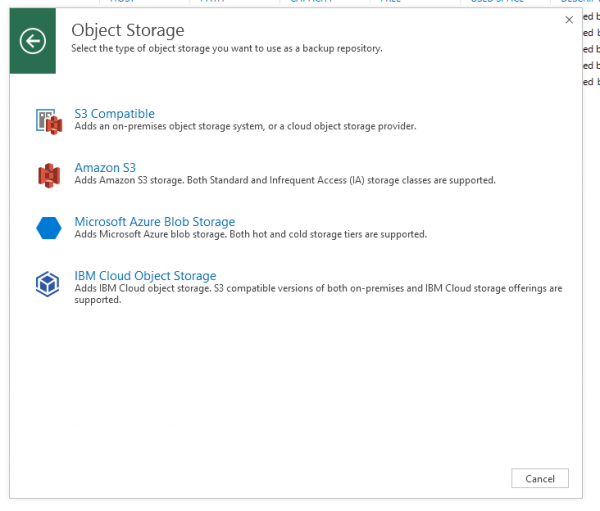
Alegem motivul pentru care am început totul — S3 Compatible.
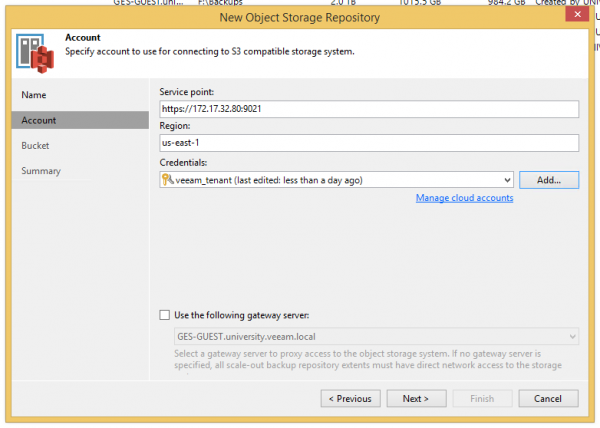
În fereastra care apare, scriem numele dorit și trecem la pasul Account. Aici trebuie să specificăm Service point sub forma , regiunea poate fi lăsată ca atare și să adăugăm utilizatorul creat. Un gateway server este necesar dacă stocarea dumneavoastră se află pe o platformă externă, dar aceasta este deja o temă pentru optimizarea infrastructurii și un articol separat, așa că aici putem să sărim cu încredere.
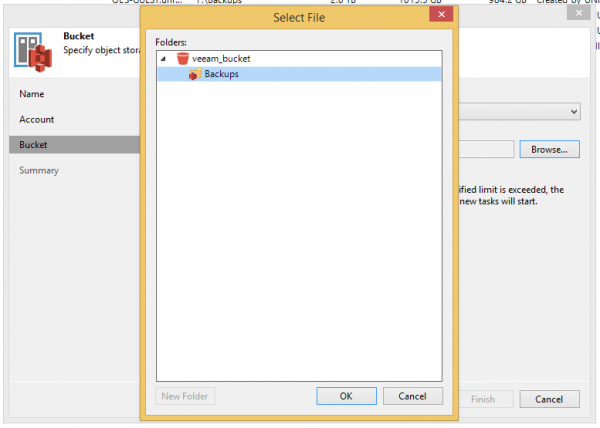
Dacă toate informațiile sunt corecte și configurate corect, va apărea un avertisment privind certificatul și apoi o fereastră cu bucket-ul, unde puteți crea un folder pentru fișierele noastre.
Parcurgem asistenta până la final și ne bucurăm de rezultat.
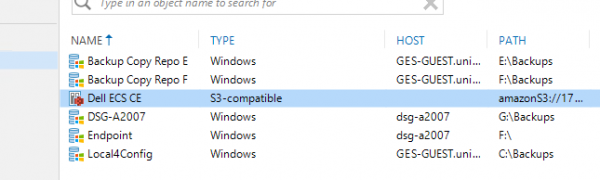
În pasul următor trebuie să creăm un nou Scale-out Backup Repository sau să adăugăm S3-ul nostru la unul existent — acesta va fi utilizat ca Capacity Tier pentru stocarea arhivă. În versiunea curentă nu există funcții pentru a utiliza stocări compatibile S3 direct ca un repository obișnuit. Există prea multe probleme destul de neclare care trebuie rezolvate pentru asta, dar totul este posibil.
Accesăm setările repository-ului și activăm Capacity Tier. Totul este transparent, dar există un detaliu interesant: dacă doriți ca toate datele să fie trimise pe stocarea obiectelor în cel mai scurt timp, pur și simplu setați 0 zile.
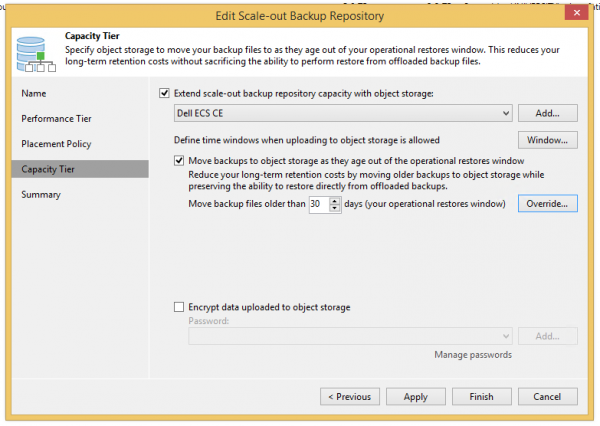
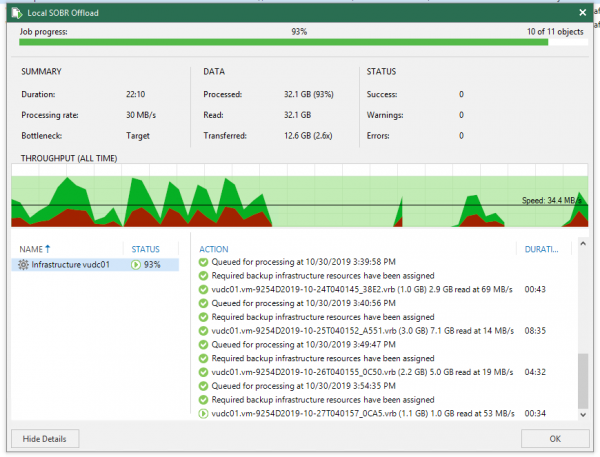
După parcurgerea asistentei, dacă nu doriți să așteptați, puteți apăsa ctrl+click dreapta pe repository, să inițiați forțat Tiering job și să observați cum graficurile încep să crească.
Asta e tot deocamdată. Consider că am reușit să ilustrez că stocările bloc nu sunt atât de înfricoșătoare cum se crede. Da, există o mulțime de soluții și opțiuni de implementare, dar într-un singur articol nu putem acoperi totul. Așa că hai să împărtășim experiențele în comentarii.
Sursa: habr.com
