

Dezvoltarea unui depozit este o activitate de durată și serioasă.
Multe în viața unui proiect depind de cât de bine este gândită modelul obiectual și structura bazei de date de la început.
Abordarea standard a fost și rămâne diverse variante de combinare a schemei „stea” cu a treia formă normalizată. De obicei, conform principiului: datele sursă — 3NF, vitrinele — stea. Această abordare, testată de timp și susținută de un număr mare de studii — este prima (și uneori singura) idee care îi vine în minte unui specialist în DWH atunci când se gândește la cum ar trebui să arate un depozit analitic.
Pe de altă parte, afacerea în general și cerințele clientului în particular au tendința de a se schimba rapid, iar datele — de a crește atât „în adâncime”, cât și „în lățime”. Aici apare principalul dezavantaj al stelei — limitările. flexibilitate.
Și dacă în viața dumneavoastră liniștită și confortabilă de dezvoltator DWH a apărut brusc:
- sarcina de a „face rapid ceva, iar apoi vom vedea”;
- a apărut un proiect în expansiune rapidă, cu conectarea de noi surse și reconfigurarea modelului de afaceri de cel puțin o dată pe săptămână;
- a apărut un client care nu își imaginează cum ar trebui să arate sistemul și ce funcții să îndeplinească în cele din urmă, dar este deschis la experimente și ajustări constante ale rezultatelor dorite pe parcurs;
- a intrat un manager de proiect cu vești bune: „Și acum avem Agile!”.
Sau dacă pur și simplu sunteți curios să aflați cum se pot construi depozite în alte moduri — vă invit să citiți mai departe!
Ce înseamnă „flexibilitate”
Pentru început, să ne stabilim ce proprietăți ar trebui să aibă un sistem pentru a putea fi numit „flexibil”.
Merită menționat că proprietățile descrise ar trebui să se refere exact la sistemul, nu la procesul dezvoltării sale. Așadar, dacă ați dorit să citiți despre Agile ca metodologie de dezvoltare, este mai bine să consultați alte articole. De exemplu, pe Habr există multe materiale interesante (atât și , sau ).
Acesta nu înseamnă că procesul de dezvoltare și structura HD nu sunt deloc interconectate. În general, dezvoltarea unui depozit de date cu o arhitectură flexibilă ar trebui să fie considerabil mai ușoară în cadrul Agile. Cu toate acestea, în practică, opțiunile pentru dezvoltarea unui DWH clasic conform lui Kimball și DataVault prin waterfall sunt întâlnite mult mai des decât coincidențele fericite ale flexibilității în cele două sale forme pe același proiect.
Așadar, ce capacități ar trebui să aibă un depozit flexibil? Pot fi evidențiate trei puncte:
- Livrare timpurie și îmbunătățiri rapide — aceasta înseamnă că, în ideal, primul rezultat de afaceri (de exemplu, primele rapoarte funcționale) ar trebui să fie obținut cât mai repede, adică înainte de a fi proiectat și implementat sistemul în întregime. Fiecare îmbunătățire ulterioară ar trebui, de asemenea, să necesite cât mai puțin timp posibil.
- Îmbunătățire iterativă — aceasta înseamnă că fiecare îmbunătățire ulterioară, în ideal, nu ar trebui să afecteze funcționalitatea deja existentă. Acest aspect devine adesea cel mai mare coșmar în proiectele mari — mai devreme sau mai târziu, anumite obiecte încep să se umple cu atât de multe legături, încât devine mai simplu să repeți complet logica într-o copie alături decât să adaugi un câmp în tabelul existent. Și dacă ești surprins că analiza impactului unei modificări asupra obiectelor existente poate necesita mai mult timp decât modificarea însăși — probabil că nu ai lucrat încă cu HD-uri mari în domeniile bancar sau telecom.
- Adaptare constantă la cerințele de afaceri în schimbare — structura generală a obiectelor ar trebui să fie proiectată nu doar având în vedere posibilitatea extinderii, ci și cu gândul la faptul că direcția acestei extensii nici măcar nu ți-ar fi putut trece prin minte în etapa de proiectare.
Și da, respectarea tuturor acestor cerințe într-un singur sistem este posibilă (evident, în anumite cazuri și cu anumite precizări).
Mai jos voi analiza două dintre cele mai populare metodologii de proiectare flexibilă pentru HD-uri — Modelul Anchor și Data Vault. În afara parantezelor rămân acele tehnici minunate, precum EAV, 6NF (în forma sa pură) și tot ceea ce ține de soluțiile NoSQL — nu pentru că acestea ar fi inferioare, și nici pentru că altfel articolul ar fi devenit similar cu un studiu mediu. Pur și simplu, toate acestea se referă la soluții dintr-o clasă ușor diferită — fie la tehnici pe care le puteți aplica în cazuri specifice, indiferent de arhitectura generală a proiectului dumneavoastră (precum EAV), fie la paradigme complet diferite de stocare a informațiilor (precum, de exemplu, bazele de date grafice și alte variante NoSQL).
Problemele abordării „clasice” și soluțiile acestora în metodologiile flexibile
Prin „abordarea clasică” mă refer la vechea stea bună (indiferent de implementarea specifică a straturilor de bază, să mă ierte adepții lui Kimball, Inmon și CDM).
1. Cardinalitatea strictă a relațiilor
Modelul se bazează pe o separare clară a datelor în dimensiuni (Dimension) și fapte (Fact). Și, Dumnezeule, este logic — deoarece analiza datelor, în cea mai mare parte a cazurilor, se reduce exact la analiza unor indicatori numerici specifici (fapte) în anumite dimensiuni (dimensiuni).
În același timp, relațiile între obiecte sunt stabilite sub formă de legături între tabele prin chei externe. Acest lucru pare destul de natural, dar conduce imediat la prima limitare a flexibilității — definirea rigidă a cardinalității relațiilor.
Aceasta înseamnă că în etapa de proiectare a tabelelor trebuie să stabiliți cu exactitate pentru fiecare pereche de obiecte legate dacă acestea pot fi considerate ca fiind multe-la-multe sau doar 1-la-multe, și „în ce direcție”. De acest lucru depinde direct în care dintre tabele va fi cheia primară și în care — externă. Schimbarea acestei relații la primirea unor cerințe noi va duce, cu mare probabilitate, la reproiectarea bazei de date.
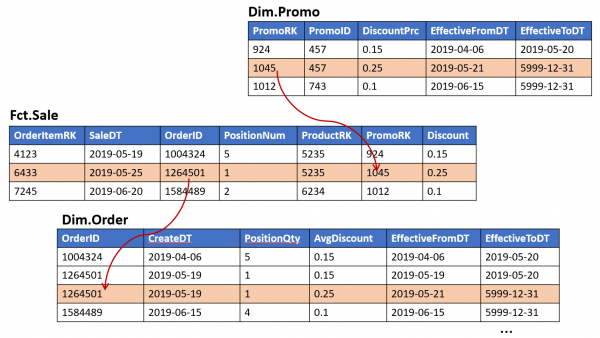
De exemplu, proiectând obiectul „bon fiscal”, v-ați bazat pe asigurările fermecătoare ale departamentului de vânzări, începând de la premisa că va exista posibilitatea ca o singură promoție să se aplice la mai multe poziții de bon (dar nu invers):
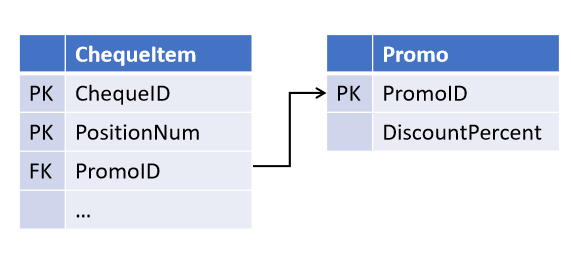
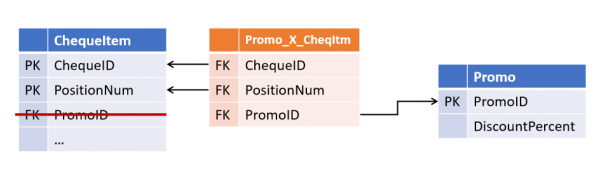
Și după ceva timp, colegii au introdus o nouă strategie de marketing în care aceeași poziție poate beneficia de mai multe promoții simultan. Și acum trebuie să modificați tabelele, dedicând legătura unui obiect separat.
(Toate obiectele derivate, în care se face join pe promovare, au nevoie și ele de ajustări).
Relații în Data Vault și Modelul Ancoră
Evitarea unei astfel de situații s-a dovedit a fi destul de simplă: nu trebuie să ai încredere în departamentul de vânzări, pentru asta este suficient să stochezi toate relațiile în tabele separate de la bun început și să le procesezi ca multe-la-multe.
Această abordare a fost propusă de Dan Linstedt ca parte a paradigmei Data Vault și susținută pe deplin de Lars Rönnbäck în Modelul Ancoră.
În cele din urmă, ajungem la prima caracteristică distinctivă a metodologiilor flexibile:
Relațiile dintre obiecte nu sunt stocate în atributele entităților părinte, ci reprezintă un tip separat de obiecte.
În Data Vault Aceste tabele de legătură sunt numite Link, iar în Modelul Ancoră — Tie. La prima vedere, ele sunt foarte asemănătoare, deși diferențele lor nu se limitează doar la denumire (despre ce va fi discutat mai jos). În ambele arhitecturi, tabelele de legătură pot lega orice număr de entități (nu neapărat 2).
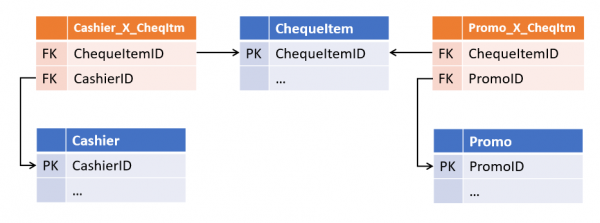
Această redundanță, la prima vedere, oferă o flexibilitate semnificativă în ajustări. Această structură devine tolerantă nu doar la schimbările cardinalităților relațiilor existente, ci și la adăugarea de noi — dacă acum, pentru o poziție de chitanță, apare și o legătură cu casierul care a înregistrat-o, apariția unei astfel de legături devine pur și simplu o extensie peste tabelele existente, fără a afecta orice obiecte sau procese existente.
2. Duplicarea datelor
A doua problemă rezolvată de arhitecturile flexibile este mai puțin evidentă și este specifică în primul rând măsurătorilor de tip SCD2 (măsurători care se schimbă lent de tipul doi), deși nu numai lor.
Într-un depozit clasic, o măsurătoare reprezintă de obicei un tabel care conține o cheie de tip surrogat (ca PK) și un set de chei de afaceri și atribute în coloane separate.
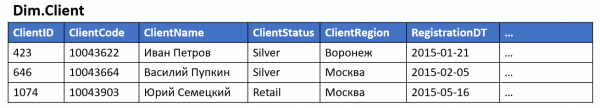
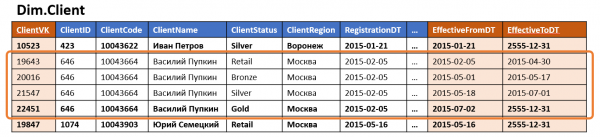
Dacă măsurătoarea suportă versiuni, la setul standard de câmpuri se adaugă limitele temporale ale valabilității versiunii, iar în sursă apare mai multe versiuni pe o singură linie în depozit (câte una pentru fiecare schimbare a atributelor versiunii).
Dacă o dimensiune conține măcar un atribut versatil care se schimbă frecvent, numărul versiunilor acestei dimensiuni va fi considerabil (chiar dacă celelalte atributuri nu sunt versiunare sau nu se schimbă niciodată), iar dacă există mai multe astfel de atribute, numărul versiunilor poate crește exponențial în funcție de numărul acestora. O astfel de dimensiune poate ocupa un spațiu de stocare semnificativ, chiar dacă cea mai mare parte a datelor stocate sunt pur și simplu duplicate ale valorilor atributelor nemodificate din alte rânduri.
De asemenea, foarte des se aplică și denormalizarea — o parte din atribute este stocată intenționat ca valoare, și nu ca referință la un dicționar sau alte dimensiuni. Această abordare accelerează accesul la date, reducând numărul joint-urilor atunci când se accesează dimensiunea.
De regulă, acest lucru duce la faptul că aceeași informație este stocată simultan în mai multe locuri. De exemplu, informațiile despre regiunea de reședință și apartenența la categoria clientului pot fi stocate simultan în dimensiunile „Client” și în faptele „Achiziție”, „Livrare” și „Apeluri la call center”, precum și în tabelul de legătură „Client — Manager de clienți”.
În general, cele descrise mai sus se aplică și dimensiunilor obișnuite (non-versionate), dar în cazul dimensiunilor versionate pot avea o altă amploare: apariția unei noi versiuni a unui obiect (în special retroactiv) nu duce doar la actualizarea tuturor tabelelor asociate, ci la apariția în cascadă a noilor versiuni ale obiectelor asociate — atunci când Tabelul 1 este folosit pentru construirea Tabelului 2, iar Tabelul 2 — pentru construirea Tabelului 3 și așa mai departe. Chiar dacă niciun atribut din Tabelul 1 nu participă la construirea Tabelului 3 (ci participă alte atribute din Tabelul 2, obținute din alte surse), actualizarea versiunii acestei construcții va duce la costuri suplimentare, iar la maxim — la versiuni inutile în Tabelul 3, care aici este „neimplicat” și așa mai departe în lanț.
3. Complexitate neliniară a modificărilor
În acest context, fiecare nouă vitrină, construită pe baza alteia, crește numărul locurilor în care datele pot „deveni incoerente” atunci când se fac modificări în ETL. Aceasta, la rândul său, duce la creșterea complexității (și duratei) fiecărei modificări ulterioare.
Dacă cele de mai sus se referă la sisteme cu procese ETL rareori modificate, atunci este posibil să trăiești în această paradigmă — este suficient să te asiguri că noile modificări sunt corect integrate în toate obiectele asociate. Dacă modificările se întâmplă frecvent, probabilitatea de a „uita” din întâmplare câteva legături crește semnificativ.
Dacă mai adăugăm și faptul că ETL „versionat” este semnificativ mai complex decât cel „neversionat”, evitarea erorilor în timpul modificărilor frecvente devine destul de dificilă.
Stocarea obiectelor și atributelor în Data Vault și Modelul Anchor
Abordarea propusă de autorii arhitecturilor flexibile poate fi formulată astfel:
Este necesar să separi ceea ce se schimbă de ceea ce rămâne constant. Cu alte cuvinte, trebuie să stochezi cheile separat de atribute.
În acest context, nu trebuie confundat neversionatul atribut cu neschimbabilul: primul nu păstrează istoricul schimbărilor sale, dar poate suferi modificări (de exemplu, în cazul corectării unei erori de introducere sau obținerii de date noi), iar al doilea — nu se schimbă niciodată.
Perspectivele asupra a ceea ce poate fi considerat neschimbabil în Data Vault și modelul ancoră diferă.
Din punct de vedere arhitectural Data Vault, ceea ce este neschimbabil poate fi considerat întregul set de chei — chei naturale (CUI-ul organizației, codul produsului în sistemul sursă etc.) și chei surrogate. Între timp, celelalte atribute pot fi împărțite pe grupe în funcție de sursă și/sau frecvența schimbărilor și pentru fiecare grupă trebuie să fie ținut un tabel separat cu un set independent de versiuni.
În paradigma Modelului Anchor se consideră neschimbabil doar cheia surrogat a entității. Tot ce este altceva (inclusiv cheile naturale) — este doar o situație particulară a atributelor sale. De asemenea, toate atributele sunt în mod implicit independente între ele, prin urmare, pentru fiecare atribut trebuie să fie creat un tabel separat.
În Data Vault tabelele care conțin cheile entităților se numesc Huburi (Hub). Huburile conțin întotdeauna un set fix de câmpuri:
- Chei naturale ale entității
- Cheie surrogat
- Referință la sursă
- Timpul adăugării înregistrării
Înregistrările din Huburi nu se schimbă niciodată și nu au versiuni.. Hub-urile arată foarte asemănător cu tabelele de tip ID-map, utilizate în unele sisteme pentru generarea de surrogate, însă se recomandă utilizarea unui hash bazat pe setul de chei de business ca surrogate în Data Vault. Această abordare simplifică încărcarea relațiilor și atributelor din surse (nu este necesar să te alături hub-ului pentru a obține surrogate, e suficient să calculezi hash-ul de la cheia naturală), dar poate provoca alte probleme (legate, de exemplu, de coliziunile, casele de litere și caracterele nelimitate în cheile de tip string etc.), prin urmare, nu este general acceptată.
Toate celelalte atribute ale entităților sunt stocate în tabele speciale, numite Sateliți (Satellit). Un hub poate avea mai mulți sateliți, care stochează diferite seturi de atribute.
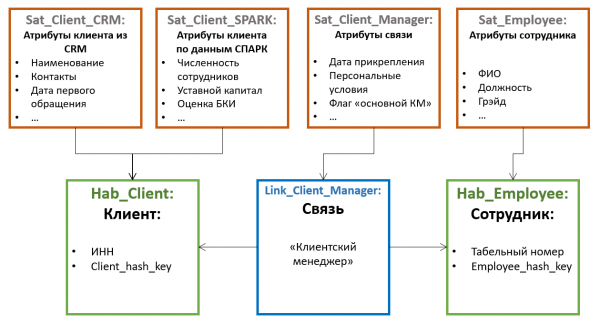
Distribuția atributelor între sateliți se face prin principiul modificării comune — într-un satelit pot fi stocate atribute ne-versionate (de exemplu, data nașterii și CNP-ul pentru persoane fizice), într-altul atribute versionate care se schimbă rar (de exemplu, numele de familie și numărul pașaportului), iar într-unul terț atribute care se schimbă frecvent (de exemplu, adresa de livrare, categoria, data ultimei comenzi etc.). Versionarea este gestionată la nivelul sateliților individuali, nu al entității în ansamblu, prin urmare, este recomandat ca distribuția atributelor să fie astfel, încât suprapunerea versiunilor într-un singur satelit să fie minimă (ceea ce reduce numărul total de versiuni stocate).
De asemenea, pentru a optimiza procesul de încărcare a datelor, atributele obținute din diverse surse sunt adesea externalizate în sateliți separați.
Sateliții se leagă de Hub prin cheia externă (ceea ce corespunde cardinalității 1-la-mulți). Aceasta înseamnă că valorile multiple ale atributelor (de exemplu, mai multe numere de telefon de contact pentru un singur client) sunt susținute de această arhitectură „în mod implicit”.
În Modelul Ancoră (Anchor Model) tabelele care stochează cheile se numesc Ancore (Anchor). Și ele stochează:
- Numai chei surrogate
- Referință la sursă
- Timpul adăugării înregistrării
Cheile naturale, din perspectiva Modelului Ancoră, sunt considerate atribute obișnuite. Această variantă poate părea mai complexă pentru înțelegere, dar oferă mult mai mult spațiu pentru identificarea obiectului.
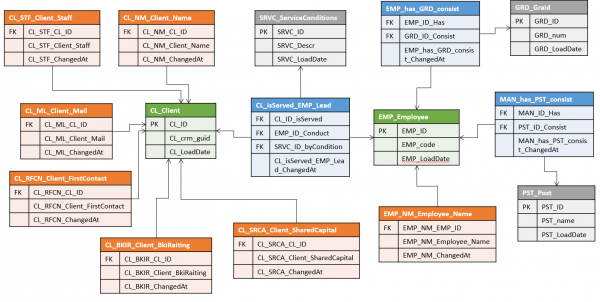
De exemplu, atunci când datele despre aceeași entitate pot proveni din diferite sisteme, fiecare dintre acestea utilizând o cheie naturală proprie. În Data Vault, acest lucru poate duce la construcții destul de voluminoase din mai multe hub-uri (câte unul pentru fiecare sursă + o versiune principală unificatoare), în modelul Ancoră, însă cheia naturală a fiecărei surse ajunge în atributul său și poate fi utilizată la încărcare independent de celelalte.
Dar aici se ascunde un moment viclean: dacă într-o entitate se unesc atribute din diferite sisteme, cel mai probabil există anumite reguli de „unire”, în conformitate cu care sistemul trebuie să înțeleagă că înregistrările din diferite surse corespund unei singure instanțe a entității.
În Data Vault Aceste reguli probabil că vor determina formarea „hub-ului surrogate” al entității principale și nu vor afecta hub-urile care stochează cheile naturale ale surselor și atributele lor originale. Dacă la un moment dat regulile de unire se schimbă (sau vine o actualizare a atributelor pe baza cărora se realizează), va fi suficient să se reformeze hub-urile surrogate.
În Modelul Ancoră însă, această entitate va fi cel mai probabil stocată în o singură ancoră. Aceasta înseamnă că toate atributele, indiferent de sursa din care provin, vor fi legate de același surogat. A separa înregistrările greșit unite și, în general, a urmări actualitatea unirii într-un astfel de sistem poate fi semnificativ mai greu, în special dacă regulile sunt destul de complexe și se schimbă frecvent, iar același atribut poate fi obținut din surse diferite (deși este cu siguranță posibil, deoarece fiecare versiune a atributului păstrează o legătură cu sursa sa).
În orice caz, dacă sistemul dumneavoastră preconizează implementarea funcționalității de deduplicare, unire a înregistrărilor și alte elemente MDM, este recomandat să analizați cu atenție aspectele stocării cheilor naturale în metodologiile flexibile. Probabil, construcția mai voluminoasă a Data Vault s-ar putea dovedi mai sigură din punct de vedere al erorilor de unire.
Modelul Ancoră preconizează, de asemenea, un tip suplimentar de obiect, numit Nod (Knot) fiind un tip special degenerat de ancoră, care poate conține un singur atribut. Nodurile sunt destinate stocării dicționarelor plate (de exemplu, sex, stare civilă, categorie de servicii clienți etc.). Spre deosebire de Ancoră, Nodul nu are tabele de atribute asociate., iar singurul său atribut (numele) este întotdeauna stocat într-o singură tabelă cu cheia. Nodurile sunt legate de Ancore prin tabelele de legătură (Tie), la fel cum ancorele sunt legate între ele.
Nu există un consens clar cu privire la utilizarea Nodurilor. De exemplu, , care promovează activ utilizarea modelului Ancoră în Rusia, consideră (nu fără temei) că pentru niciun dicționar nu se poate afirma cu certitudine că el întotdeauna va fi static și unidimensional, așa că pentru toate obiectele este mai bine să se utilizeze din capul locului o Ancoră completă.
O altă distincție importantă între Data Vault și modelul Ancoră constă în existența atributelor la legături.:
În Data Vault Legăturile sunt obiecte la fel de complete ca și Hub-urile și pot avea atribute proprii.. În Modelul Ancoră Legăturile sunt utilizate doar pentru a conecta Ancorele și nu pot avea atribute proprii.. Această distincție oferă abordări de modelare semnificativ diferite a faptelor, despre care vom discuta mai departe.
Stocarea faptelor
Până acum am discutat în principal despre modelarea dimensiunilor. Faptele sunt puțin mai complexe.
În Data Vault un obiect tipic pentru stocarea faptelor este Legătura (Link), în Satelitele căreia se adună indicatorii materiali.
Această abordare pare a fi intuitivă. Oferă acces simplu la indicatorii analizați și este, în general, similară cu o tabelă tradițională a faptelor (doar că indicatorii sunt stocați nu în tabelul propriu-zis, ci în unul „vecin”). Dar sunt și capcane: una dintre modificările tipice ale modelului - extinderea cheii faptului - necesită adăugarea unei noi chei externe în Link.. Acest lucru, la rândul său, „strică” modularitatea și poate provoca necesitatea modificărilor altor obiecte.
În Modelul Ancoră Legătura nu poate avea atribute proprii, așa că această abordare nu va funcționa - toate atribut și indicatori trebuie să fie legați de o anumită ancoră. Concluzia este simplă - fiecare fapt are nevoie de propria ancoră.. Pentru o parte din ceea ce obişnuim să percepem ca fapte, aceasta poate părea natural — de exemplu, faptul achiziţiei se reduce la un obiect „comandă” sau „bon”, vizita pe site — la o sesiune etc. Dar există şi fapte pentru care găsirea unui astfel de „obiect-port” nu este atât de simplă — de exemplu, stocurile de produse de la începutul fiecărei zile.
Astfel, problema modularităţii la extinderea cheii faptei în Modelul Ancora nu apare (este suficient să adaugi o nouă Relaţie la Ancora corespunzătoare), dar proiectarea modelului pentru a reflecta faptele este mai puţin clară, pot apărea Ancore „artificiale”, care să reflecte modelul obiectual al afacerii într-un mod nu atât de evident.
Cum se obține flexibilitatea
Construcţia rezultată în ambele cazuri conţine substantially more tables, decât o măsurare tradiţională. Dar poate ocupa substantially less disk space pentru acelaşi set de atribute de versiune, la fel ca o măsurare tradiţională. Nicio magie aici, desigur — totul se bazează pe normalizare. Distribuind atributele în Satelite (în Data Vault) sau în tabele separate (Modelul Ancora), reducem (sau eliminăm complet) duplicarea valorilor anumitor atribute atunci când se schimbă altele.
Pentru Data Vault câştigul va depinde de distribuţia atributelor în Sateliţi, iar pentru Modelul Ancoră — practic direct proporţional cu numărul mediu de versiuni pe obiectul de măsurare.
Cu toate acestea, câştigul în ceea ce priveşte spaţiul ocupat — este un avantaj important, dar nu principalul avantaj al stocării separate a atributelor. Împreună cu stocarea separată a relaţiilor, această abordare face depozitul o construcţie modulară. Aceasta înseamnă că adăugarea atât a atributelor separate, cât şi a unor noi domenii tematice în acest model arată ca o extensie peste setul existent de obiecte fără a le modifica. Şi acesta este exact ceea ce face metodologiile descrise flexibile.
De asemenea, aceasta aminteşte de tranziţia de la producţia unitară la cea de masă — dacă în abordarea tradiţională fiecare tabel al modelului este unic şi necesită atenţie separată, în metodologiile flexibile — acestea sunt deja un set de „piese” standard. Pe de o parte, numărul de tabele creşte, procesele de încărcare şi selectare a datelor trebuie să pară mai complexe. Pe de altă parte — devin standard. Şi asta înseamnă că pot fi sunt automatizate și gestionate cu metadate. Întrebarea „cum vom așeza?” a cărei răspuns putea ocupa o parte semnificativă din lucrările de proiectare a modificărilor, acum pur și simplu nu se pune (la fel ca întrebarea despre influența schimbării modelului asupra proceselor existente).
Acest lucru nu înseamnă că analiștii într-un astfel de sistem nu sunt necesari deloc — cineva totuşi trebuie să lucreze la setul de obiecte cu atribute și să înțeleagă de unde și cum se încarcă toate acestea. Dar volumul lucrărilor, precum și probabilitatea și costul erorii scad considerabil. Atât în etapa de analiză, cât și în dezvoltarea ETL, care într-o mare măsură poate fi redusă la editarea metadatelor.
Latura întunecată
Tot ceea ce a fost menționat mai sus face ca ambele abordări să fie cu adevărat flexibile, tehnologice și potrivite pentru elaborarea iterativă. Bineînțeles, există și „o ladă de murdărie”, despre care cred că deja vă dați seama.
Dezintegrarea datelor, care stă la baza modularității arhitecturilor flexibile, duce la o creștere a numărului de tabele și, în consecință, costuri indirecte la unire în cadrul extragerii. Pentru a obține pur și simplu toate atributele unei măsurători, într-un depozit clasic este suficient un singur select, în timp ce o arhitectură flexibilă va necesita o serie întreagă de uniri. De asemenea, dacă pentru rapoarte toate aceste uniri pot fi scrise dinainte, atunci analiștii, obișnuiți să scrie SQL manual, vor suferi și mai mult.
Există câteva fapte care facilitează această situație:
Atunci când se lucrează cu dimensiuni mari, aproape niciodată nu sunt utilizate simultan toate atributele sale. Aceasta înseamnă că numărul de uniri poate fi mai mic decât pare la prima vedere asupra modelului. În Data Vault se poate, de asemenea, lua în considerare frecvența anticipată a utilizării comune atunci când se distribuie atributele între sateliți. Totuși, Hub-urile sau Ancorele sunt necesare, în primul rând, pentru generarea și maparea înlocuitorilor în etapa de încărcare și sunt rar utilizate în interogări (în special acest lucru se referă la Ancore).
Toate uniri — pe cheie. În plus, o metodă de stocare a datelor mai „compresată” reduce cheltuielile de scanare a tabelelor acolo unde este necesar (de exemplu, atunci când se filtrează după valoarea unui atribut). Aceasta poate duce la rezultate dintr-o bază de date normalizată cu multe join-uri care să fie chiar mai rapide decât scanarea unei dimensiuni grele cu un număr mare de versiuni per rând.
De exemplu, aici în articol există un test comparativ detaliat de performanță al modelului Anchor cu o selecție dintr-un singur tabel.
Foarte multe depinde de motor. Multe dintre platformele moderne au mecanisme interne de optimizare a join-urilor. De exemplu, MS SQL și Oracle pot „sări” peste join-uri pe tabele dacă datele lor nu sunt utilizate nicăieri, în afară de alte join-uri, și nu influențează selecția finală (eliminarea tablelor/join-urilor), iar MPP Vertica și , s-a dovedit a fi un motor excelent pentru modelul Anchor cu o anumită optimizare manuală a planului de interogare. Pe de altă parte, stocarea modelului Anchor, de exemplu, pe Click House, care are suport limitat pentru join-uri, pare să nu fie o idee foarte bună.
În plus, pentru ambele arhitecturi există trucuri speciale, care facilitează accesul la date (atât din perspectiva performanței interogărilor, cât și pentru utilizatorii finali). De exemplu, tabelele Point-In-Time în Data Vault sau funcții tabelare speciale în modelul Anchor.
În concluzie
Esenta arhitecturilor flexibile discutate constă în modularitatea construcției lor.
Această proprietate permite:
- După o pregătire inițială, legată de desfășurarea metadatelor și scrierea algoritmilor ETL de bază, să furnizăm rapid clientului primul rezultat sub forma câtorva rapoarte care conțin datele a doar câtorva obiecte sursă. Nu este necesar să gândim complet (chiar și la un nivel superior) întreaga modelare a obiectului pentru aceasta.
- Modelul de date poate începe să funcționeze (și să aducă beneficii) cu doar 2-3 obiecte, iar apoi să se dezvolte treptat (referitor la modelul Anchor, Nikolai o comparație frumoasă cu o miceliu).
- Majoritatea modificărilor, inclusiv extinderea domeniului de subiect și adăugarea de noi surse nu afectează funcționalitatea existentă și nu prezintă riscul de a rupe ceva care funcționează deja..
- Datorită decompoziției în elemente standard, procesele ETL din aceste sisteme arată uniform, iar scrierea lor este supusă algoritmizării și, în cele din urmă, automatizării.
Prețul acestei flexibilități este performanța. Aceasta nu înseamnă că nu este posibil să atingi o performanță acceptabilă cu astfel de modele. Cel mai adesea, poate fi necesar să depui mai mult efort și atenție la detalii pentru a obține metricile dorite.
Aplicații
Tipurile de entitate Data Vault
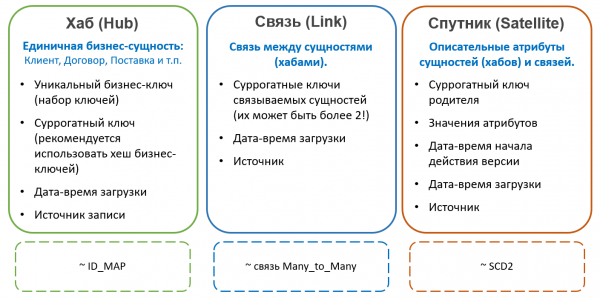
Mai multe despre Data Vault:
Tipurile de entități Modelului Anchor
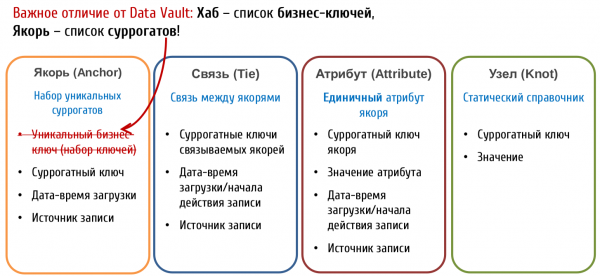
Mai multe despre Anchor Model:
Tabel rezumativ cu caracteristicile comune și diferențele abordărilor discutate:
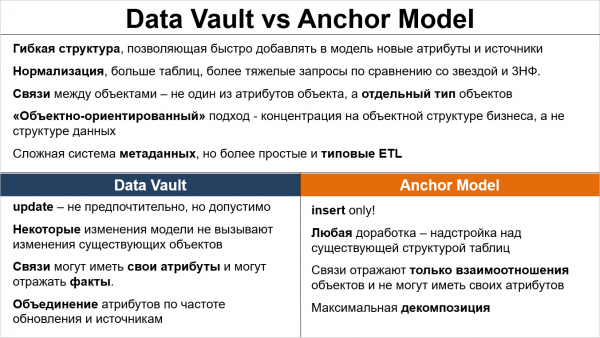
Sursa: habr.com
