

Acum două ani, am publicat deja o postare despre . Acum există anumite dezvoltări ale proiectului, iar eu am publicat sub , așa că am decis să scriu pe Habr acest mic rezumat.
[ ]
Cui ar putea fi interesant acest lucru
Acest lucru ar putea fi interesant pentru tine dacă lucrezi într-o echipă mică sau chiar singur. Nu ai monitorizare și nu ești sigur dacă este necesară. De asemenea, poate ai încercat un monitorizare populară și serioasă „pentru băieții mari”, dar pentru tine nu a funcționat foarte bine sau lucrează în aproape configurația sa implicită și nu ți-a schimbat viața. Și dacă nu intenționezi să dedici un întreg angajat (sau chiar un departament) pentru a monitoriza timp de câteva ore pe zi în tabloul de bord al monitorizării sau pentru a îl configura.
Ce este neobișnuit la okerr
Mai departe voi arăta trăsături interesante ale okerr care îl diferențiază de alte soluții de monitorizare.
Okerr este o soluție de monitorizare hibridă
În cazul monitorizării interne, pe mașinile observate rulează un „agent” care transmite date către serverul de monitorizare (de exemplu, spațiul liber pe discuri). În cazul monitorizării externe, serverul efectuează verificări prin rețea (de exemplu, ping sau accesibilitate site-web). Fiecare abordare are propriile sale limitări. Okerr folosește ambele variante. Verificările din interiorul serverelor sunt efectuate de un agent foarte ușor (30Kb) sau de propriile tale scripturi și aplicații, iar cele de rețea prin senzori okerr din diferite țări.
okerr nu este doar un software, ci și un serviciu
Partea serverului oricărei soluții de monitorizare este complicată și mare, este greu de instalat și configurat, necesită resurse. Cu okerr poți să îți instalezi propriul server de monitorizare (este gratuit și opensource), sau poți folosi doar partea client, beneficiind de serviciul serverului nostru. De asemenea, gratuit.
Dacă monitorizarea permite compensarea lipsei de fiabilitate a serverelor și aplicațiilor, apare o întrebare filosofică — cine supraveghează gardianul? Cum ne va anunța monitorizarea despre o problemă, dacă ea însăși a "murit" dintr-un anumit motiv, separat sau împreună cu alte resurse ale dumneavoastră (de exemplu, căderea canalului către centrul de date)? Folosind serviciul extern okerr — această problemă se rezolvă — veți primi un alert chiar dacă întreg centrul de date cu serverele dumneavoastră va fi lipsit de energie sau va fi atacat de zombii.
Desigur, există riscul ca serverul okerr să fie el însuși inaccesibil, este adevărat (după cum se știe, 90% din fiabilitate se obțin întotdeauna simplu și "gratuit", 99% — cu un efort minim, iar fiecare următoare cifră devine exponențial mai dificil de atins). Dar, pe de o parte, șansele ca acest lucru să se întâmple sunt mai mici, iar pe de altă parte, problema ar putea să nu fie observată decât dacă se corelează în timp cu problemele de pe serverele noastre. Dacă avem o fiabilitate de 99.9%, iar dumneavoastră aveți 99.9% (numere nu chiar atât de mari), atunci șansa unei defecțiuni neobservate este de 0.1% din 0.1% = 0.0001%. Să adăugați încă trei cifre la fiabilitate aproape fără efort și fără costuri — este foarte bine!
O altă avantaje al monitorizării ca serviciu — providerul de hosting sau agenția web poate instala un server okerr și oferi acces clienților ca un serviciu suplimentar plătit sau gratuit. Competiția oferă doar hosting și site-uri — iar dumneavoastră aveți un hosting de încredere cu monitorizare.
Okerr — este despre indicatori
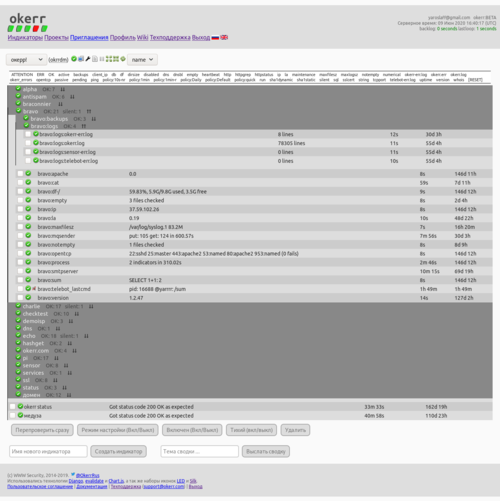
Un indicator este o "lampă". Are două stări principale — verde (OK) sau roșu (ERR). În proiect — există numeroase indicatori grupați (de exemplu, pe servere). Pe pagina principală a proiectului, puteți vedea imediat, fie că aveți totul verde (și puteți închide), fie că ceva s-a aprins în roșu și trebuie să fie corectat. La trecerea între aceste stări — se trimite o notificare. Odată pe zi, în timp ce îl configurați — se trimite un rezumat al proiectului.
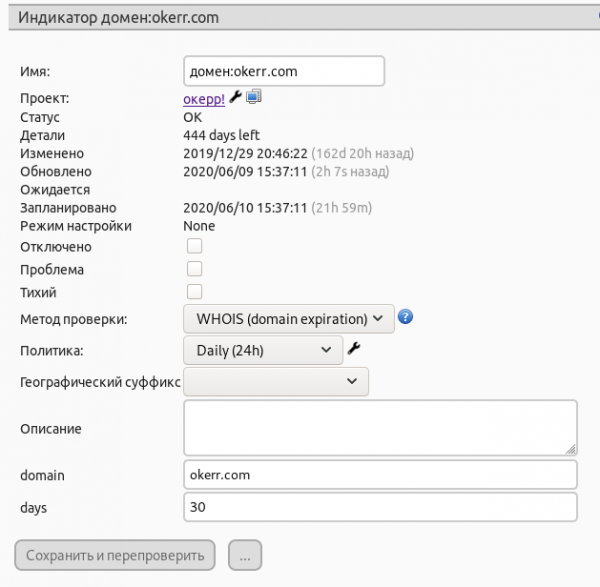
Fiecare indicator okerr are condiții încorporate pe care le schimbă starea (în Zabbix acesta se numește trigger). De exemplu, media de încărcare nu trebuie să fie mai mare de 2 (bineînțeles, acest lucru se configurează). Și pentru fiecare verificare internă (media de încărcare, spațiu liber pe disc, ...) — există un watchdog. Dacă din diferite motive nu am primit o confirmare de succes la timpul stabilit — se înregistrează o eroare și se trimite un alert.
Schema noastră de lucru este simplă — verificăm dimineața email-ul, printre alte scrisori vedem sinteza (timpul acesteia îl stabilim la începutul activității). Dacă totul este în regulă — ne ocupăm de alte chestiuni importante (dar putem, pentru siguranță, să aruncăm rapid o privire în dashboard-ul okerr, să ne asigurăm că și în acel moment totul este verde). Dacă primim un alert — reacționăm.
Desigur, există posibilitatea de a menține pur și simplu „indicatorii informaționali” (pentru a vedea imaginea rețelei din monitorizare), dar totul este creat pentru a face ușor și rapid indicatori pentru monitorizare automată și trimiterea alertelor.
Motivul pentru care configurati okerr este în alerte, pentru a putea crea în mai puțin de un minut un indicator, care ar putea să fi fost „dormant” timp de un an, primind actualizări, iar când ceva se strică, se aprinde și trimite un alert. Minutele pe care le-ați cheltuit o dată pentru crearea indicatorului s-au răsplătit, ați aflat despre problemă imediat, mai devreme decât toți. Este posibil să fi reparat problema înainte ca altcineva să observe. Ce este ridicat rapid nu se consideră că a căzut!
Securitate
Ar fi frustrant dacă setați monitorizarea pentru a crește fiabilitatea, dar în schimb — sunteți atacați prin intermediul acesteia, iar vulnerabilitățile de rețea sunt destul de numeroase în diferitele mijloace de monitorizare (, ).
Agent (okerrmod din pachetul ), care funcționează pe sistem — nu este un server de rețea, ci un client. De aceea, pe serverul monitorizat nu există porturi deschise suplimentare, clientul funcționează ușor în spatele unui firewall sau NAT și este foarte greu (aș spune „imposibil”) de spart prin rețea, deoarece el de fapt nu ascultă un socket de rețea.
Acoperire completă a monitorizării
Acum avem o regulă — aflăm despre toate problemele tehnice prin intermediul okerr. Dacă, dintr-o dată, regula este încălcată (okerr nu ne-a avertizat despre apariția ei iminentă (dacă este posibil) sau că aceasta a apărut deja) — adăugăm verificări în okerr.
Verificări externe
Un set destul de tipic:
- ping
- starea http
- verificarea valabilității și actualității certificatului SSL (va avertiza dacă termenul de valabilitate se apropie de final)
- port TCP deschis și banner-ul său
- http grep (pe pagina [nu] ar trebui să se afle un anumit text)
- hash sha1 pentru a depista modificarea paginii.
- DNS (înregistrarea DNS ar trebui să aibă o anumită valoare)
- WHOIS (va avertiza dacă domeniul va expira în curând)
- Antispam DNSBL (verificarea gazdei imediat pe 50+ liste negre anti-spam)
Verificări interne
De asemenea, un set destul de standard (dar ușor extins).
- df (spațiu liber pe discuri)
- load average
- opentcp (sockets TCP deschise care ascultă — va notifica dacă ceva a fost inițiat sau a căzut)
- uptime — pur și simplu uptime-ul serverului. Va notifica dacă s-a schimbat în jos (de exemplu, serverul a fost repornit)
- client_ip
- dirsize — îl folosim pentru a urmări când rootfs-ul mașinilor virtuale depășește dimensiunea permisă, fără a impune restricții stricte, și pentru dimensiunile directoarelor utilizatorilor
- empty și nonempty — urmăresc fișierele care ar trebui să fie goale (sau nu). De exemplu, error log-ul serverului okerr — ar trebui să fie gol, iar dacă există chiar și o linie în el — voi primi o notificare și voi verifica. În schimb, mail.log-ul de pe serverul de poștă nu ar trebui să fie gol (la N minute după rotație). Și uneori a fost gol, după actualizarea sistemului, când logrotate nu a reușit să repornească corect rsyslog.
- linecount — numărul de linii din fișier (ca wc -l). O folosim ca înlocuire mai blândă pentru empty, atunci când error log-ul poate totuși crește, dar lent (de exemplu, googlebot-ul ne accesează anumite pagini restricționate). Există un limită de 2 linii la fiecare 20 de minute. Dacă va fi mai mult — va exista un alert.
Verificări interne interesante
Dacă până acum ai citit „diagonal”, acum va fi mai interesant să citești cu atenție.
backups
Urmărește backup-urile din director. Fișierele noastre de backup au nume de genul „ServerName-20200530.tar.gz”. Pentru fiecare server, în okerr se creează un indicator ServerName-DATE.tar.gz (data actuală se schimbă în șirul „DATE”). Se urmărește atât existența unui backup recent, cât și dimensiunea acestuia (de exemplu, nu poate fi mai mic decât 90% din backup-ul anterior).
Ce trebuie să faci pentru ca un nou backup să înceapă să fie urmărit, după ce l-am început să-l creăm și să-l plasăm în acest director? Nimic! Este o abordare foarte convenabilă când trebuie să faci „nimic”, deoarece:
- A face „nimic” — este destul de rapid, economisește timp
- Este greu să uiți să faci „nimic”
- Este greu să faci „nimic” greșit, cu o eroare. Nimic — este cea mai fiabilă metodă
Dacă cumva nu mai apar fișiere recente de backup — va exista un alert. Dacă, de exemplu, ai oprit unul dintre servere și nu ar mai trebui să existe backup-uri ale acestuia — va trebui să elimini indicatorul (prin interfața web sau din shell prin API).
maxfilesz
Monitorizează dimensiunea celor mai mari fișiere (de obicei: /var/log/*). Acest lucru permite detectarea problemelor imprevizibile, cum ar fi încercările de forțare a parolelor sau trimiterea de spam prin server.
runstatus/runline
Acestea sunt două module proxy importante pentru a rula alte programe pe server. Runstatus raportează indicatorul codului de ieșire al programului. De exemplu, în okerr nu există (nu este necesar) un modul pentru a verifica dacă serviciile systemd funcționează. Acest lucru se face prin runstatus (vezi mai jos). Runline – raportează serverului linia pe care o oferă programul. De exemplu, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" în configurația Runline de pe serverul nostru se creează un indicator servername:temp cu temperatura procesorului.
sql
Execută o interogare numerică către MySQL și raportează rezultatul în indicator. În cazul simplu, se poate face, de exemplu, „SELECT 1” - acest lucru va verifica dacă baza de date funcționează în general.
Dar o aplicație mult mai interesantă - de exemplu, monitorizarea numărului de comenzi dintr-un magazin online. Dacă știți că aveți între 100 de comenzi pe oră, puteți stabili o limită minimă de 100 sau 80. Atunci, dacă vânzările dvs. scad brusc - veți primi un alert și veți putea investiga.
Observați - nu contează din ce motiv imprevizibil s-a întâmplat acest lucru:
- Serverul este pur și simplu inaccesibil (fără curent sau fără rețea), iar alerta a sosit din cauza că indicatorul a "expirat".
- Serverul este supraîncărcat, funcționează lent sau se pierd pachete, utilizatorii sunt incomod și pleacă fără achiziții
- Serverul a fost adăugat pe listele de spam și emailurile de la el nu sunt acceptate, utilizatorii nu se pot înregistra
- Bugetul campaniei publicitare s-a încheiat, bannerele nu mai sunt afișate.
Cauzele pot fi nenumărate, iar toate nu pot fi prevăzute din timp, și este tehnic dificil de urmărit. Dar este posibil să monitorizăm confortabil parametrul final (comenzile) și pe baza acestora să determinăm că situația este suspectă și merită să o investigăm.
Indicatori logici
Permite utilizarea expresiilor logice (sintaxă Python) prin modulul (). Datele proiectului și indicatorilor săi sunt disponibile pentru expresie. De exemplu, în capitolul despre verificarea SQL de mai sus, poate ați observat o slăbiciune - în timpul zilei putem avea între 100 de vânzări pe oră, dar noaptea - 20, și aceasta este o situație obișnuită, nu o problemă. Ce să facem? Indicatorul va panica constant noaptea.
Puteți crea doi indicatori, unul pentru zi și unul pentru noapte. Amândouă să fie „silente” (nu vor trimite notificări). Și să creați un indicator logic care necesită ca indicatorul de zi să fie OK până la ora 20:00, iar după ora 20:00 este suficient ca indicatorul de noapte să fie OK.
Un alt exemplu de utilizare a indicatorului logic este escaladarea. De exemplu, managerul de proiect se dezabonază de la alerte (nu are nevoie de acestea, administratorii ar trebui să reacționeze la problemele obișnuite), dar se abonează la indicatorul logic care devine roșu dacă orice indicator din proiect nu este reparat în timpul alocat.
De asemenea, există posibilitatea de a stabili un interval de timp permis pentru lucrări, de exemplu, între 3 și 5 dimineața. Nu ne pasă dacă serverele și site-urile „cad” în acest timp. Dar la ora 5:00 ele trebuie să funcționeze. Dacă nu funcționează în orice alt moment — alertă. De asemenea, indicatorul logic permite luarea în considerare a rezervării serverelor. Dacă aveți 5 servere web, administratorii pot opri 1-2 servere în orice moment. Dar dacă în funcțiune sunt mai puțin de 3 din 5 servere — va fi alertă.
Exemplele de mai sus nu sunt funcții ale okerr, nu sunt niște caracteristici care trebuie activate și configurate. Toate aceste funcții nu există în okerr, dar există un modul logic care permite realizarea acestui funcțional (aproximativ ca în limbajul de programare — dacă avem operatori aritmetici, nu avem nevoie de o funcție specială în limbaj pentru a calcula 20% TVA, aceasta poate fi întotdeauna realizată de noi înșine pentru nevoile proprii).
Indicatorul logic este, probabil, unul dintre subiectele relativ complexe din okerr, dar vestea bună este că nu trebuie să le stăpâniți până când nu devine necesar. Însă acestea extind foarte mult capabilitățile, păstrând în același timp sistemul suficient de simplu.
Adăugarea propriilor verificări
Aș dori foarte mult să subliniez că okerr nu este un set de o mie de verificări gata făcute pentru toate cazurile, ci dimpotrivă — în primul rând — un motor simplu cu o posibilitate simplă de a crea propriile verificări. Crearea propriilor verificări în okerr nu este o sarcină pentru hackeri, co-dezvoltatori ai sistemului, sau cel puțin utilizatori avansați ai okerr, ci o sarcină realizabilă pentru orice administrator care acum o lună a instalat pentru prima dată linux.
Verificările pe minim sunt făcute prin modulul :
Această linie din configurare va da o notificare dacă, cumva, /bin/true nu se va lansa sau va returna un rezultat diferit de 0.
true_OK=\/bin\/trueDoar o singură linie — și iată că am extins puțin funcționalitatea okerr. Chiar și o astfel de verificare are deja valoarea ei: dacă serverul dumneavoastră se prăbușește — indicatorul corespunzător de pe serverul okerr nu se va actualiza la timp, iar după un timp va apărea o alertă.
Această verificare va informa că serverul apache2 a căzut (cine știe...):
apache_OK="systemctl is-active --quiet apache2"
Așadar, dacă dețineți orice limbaj de programare și cel puțin știți să scrieți scripturi shell — atunci deja puteți adăuga propriile verificări.Mai complicat — puteți să scrieți (în orice limbaj) un modul propriu pentru okerrmod. În cea mai simplă formă, arată astfel:
Nu-i așa, nu este foarte complicat? Modulul trebuie să efectueze verificarea în sine și să emită rezultatele pe STDOUT. Un modul mai complex oferă, de exemplu, următoarele:
#!/usr/bin/python3

print("STATUS: OK")
$ okerrmod --dump df NAME: pi:df-\/\nTAGS: df METHOD: numerical|maxlim=90 DETAILS: 49.52%, 13.9G\/28.2G utilizat, 13.0G liber STATUS: 49.52NAME: pi:df-\/boot TAGS: df METHOD: numerical|maxlim=90 DETAILS: 84.32%, 53.1M\/62.9M utilizat, 9.9M liber STATUS: 84.32
El actualizează imediat mai mulți indicatori (separate printr-o linie goală), și, dacă este necesar, le creează, indicând detaliile verificării și eticheta, pentru a găsi cu ușurință indicatorii necesari în tablou.Există un bot pe Telegram
Telegram
@OkerrBot Pagini de status
În zilele noastre, paginile de status sunt deja aproape un must-have pentru orice afacere care are IT, o abordare responsabilă față de fiabilitate și care respectă clienții\/utilizatorii.
În zilele noastre, paginile de status sunt aproape un must-have pentru orice afacere care dispune de IT, are un angajament serios față de fiabilitate și respectă clienții/utilizatorii săi.
Imaginați-vă o situație în care utilizatorul dorește să facă ceva, să vizualizeze informații sau să plaseze o comandă, dar ceva nu funcționează. Nu știe care este problema, de partea cui este și când se va rezolva. Poate că site-ul firmei dumneavoastră este pur și simplu defect? Sau s-a stricat acum jumătate de an și se va repara peste doi ani? Dar trebuie să cumpere frigiderul acum, este deja în coș... Și este cu totul altceva când o persoană vede că ceva nu este în regulă la dumneavoastră (macar e clar că problema nu este de partea lui), că problema a fost identificată, că lucrați deja la ea și poate chiar ați scris un timp estimat pentru rezolvare. Utilizatorul poate să se aboneze și să primească o notificare pe e-mail atunci când problema va fi remediată și va putea să facă ceea ce și-a dorit (să cumpere frigiderul).
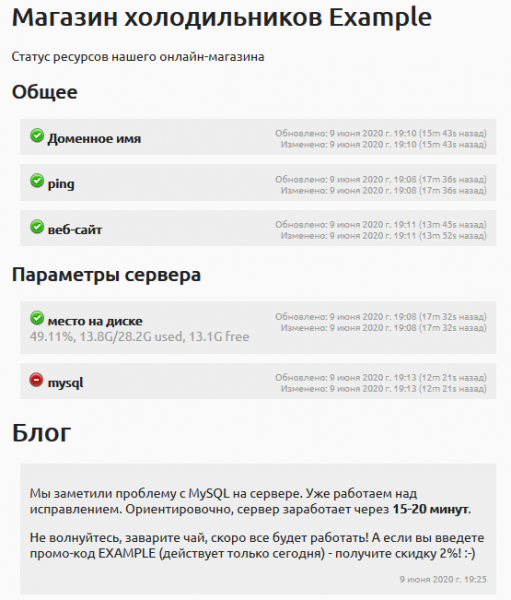
Problemele și downtime-ul - sunt comune tuturor. Însă utilizatorii și partenerii au mai multă încredere în cei care sunt mai transparenți și abordează aceste situații cu responsabilitate.
Iată . Iată exemple de cum arată aceste pagini în proiecte similare și . .
Failover
Pentru a nu extinde prea mult această articol, voi face referire din nou la articolul meu anterior — . Dacă puteți crea un server de rezervă, atunci cu ajutorul failover-ului, în principiu nu veți avea downtime lung — imediat ce problema este identificată, utilizatorii vor fi redirecționați automat către serverul de rezervă funcțional. Și mi se pare că aceasta este o funcție foarte interesantă și remarcabilă, care lipsește în multe locuri.
Cerințe de sistem reduse
Pentru serverele okerr — folosim mașini cu RAM de la 2Gb. Pentru senzori de rețea — chiar și 512Mb sunt suficiente. Partea clientului — aproape că nu consumă nimic. (Pachetul are 26 Kb, dar necesită Python3 și biblioteci standard). Clientul se lansează dintr-un script crontab, astfel încât nu are un consum constant de memorie. Printre mașinile observate avem senzori (VPS-uri super ieftine cu 512Mb RAM) și Raspberry Pi. Se poate chiar fără partea clientului ! (vezi mai jos)
Având în vedere acest lucru — okerr, probabil că este cel mai gratuit Sistemul de monitorizare disponibil, deoarece chiar și pentru a folosi un alt sistem gratuit open-source, cum ar fi Zabbix sau Nagios, trebuie alocat un server (resurse), ceea ce implică o costisire. În plus, este necesară o întreținere a serverului. Cu okerr, această parte poate fi eliminată. De asemenea, se poate păstra și folosi propriul server - depinde de preferințele dumneavoastră.
API și integrarea în aplicația proprie
Arhitectură simplă și deschisă. Okerr are o abordare destul de simplă, , cu care este ușor de lucrat. Trebuie să creați 1000 de indicatoare? Un script shell în 3-4 linii o va face. Trebuie să reconfigurați 1000 de indicatoare? De asemenea, foarte simplu. De exemplu, dorim să re-verificăm toate certificatele noastre HTTPS exact cu senzorul din Rusia:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Un indicatoare poate fi actualizat fie folosind modulul nostru client, fie chiar fără el, pur și simplu prin curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Indicatorii pot fi actualizați direct din propriul program. De exemplu, trimițând semnale heartbeat, astfel încât okerr să știe că a fost lansat și să alarmeze dacă a căzut sau s-a blocat. Apropo, componentele okerr fac exact asta - okerr se monitorizează pe sine, iar problemele din aproape orice modul vor fi detectate și vor genera o notificare de problemă. (Și în cazul acestui 'aproape', ele sunt verificate interactiv dintr-un alt server.)
Iată un astfel de cod (simplificat) în botul nostru Telegram:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Pentru actualizarea indicatorilor din programele Python - există o bibliotecă , pentru alte limbaje nu există biblioteci, dar se poate fie apela scriptul okerrupdate, fie efectua o cerere HTTP către serverul okerr.
Cum ne ajută okerr
Okerr ne-a schimbat viața. Chiar așa. Poate că un alt sistem de monitorizare ar fi putut face la fel, dar este ușor și simplu să lucrăm cu okerr, având toate funcțiile de care aveam nevoie (ce nu era disponibil - am adăugat noi). Apropo, dacă lipsește vreo funcție - întrebați și voi adăuga (nu promet, dar îmi doresc ca okerr să fie cel mai bun sistem de monitorizare pentru proiecte mici și medii). Sau, mai bine, adăugați singuri - este simplu.
Am reușit să trăim conform principiului „să aflăm despre toate problemele din okerr”. Dacă apare o problemă despre care nu am aflat de la okerr — adăugăm o verificare în okerr. (în acest caz, prin „noi” înțeleg utilizatorii sistemului, nu co-developerii). La început s-a întâmplat frecvent, dar acum este foarte rar.
Monitorizare
Prin okerr monitorizăm dimensiunile jurnalelor pe toate serverele. Să citim cu atenție fiecare linie a jurnalului — desigur că este imposibil, dar simpla monitorizare a vitezei de creștere — deja oferă mult. Prin aceasta am descoperit atât spamul, cât și atacurile de tip brute force, și când anumiți aplicativi „se comportă ciudat”, întâmpină probleme și repetă din nou și din nou (de fiecare dată adăugând câteva linii în jurnal).
Certificatul SSL. Aproape imediat după lansare clientul nostru a început să ofere clienților săi certificate SSL gratuite (aproximativ o mie). Și acest lucru s-a dovedit a fi un adevărat coșmar pentru administrare! Problema este că site-urile sunt „active”, clienții cer în mod periodic să li se facă diverse lucruri, programatorii execută. Pot transfera fără ezitare site-ul pe un alt DocumentRoot, de exemplu. Sau adăuga o redirecționare necondiționată în configurația virtuală. Evident, după o astfel de acțiune se strică actualizarea automată a certificatelor. Acum toate host-urile SSL sunt adăugate în okerr automat printr-o altă unealtă utilă din pachetul nostru. . Pur și simplu lansăm a2okerr.py — și dacă pe server au apărut câteva site-uri noi — acestea vor apărea automat în okerr. Dacă dintr-un anumit motiv certificatul nu se actualizează, cu trei săptămâni înainte de expirarea certificatului — suntem la curent și investigăm de ce nu se actualizează, câinele acela. a2certbot.py din același pachet — ajută foarte mult în acest sens (verifică imediat cele mai probabile probleme — și indică ce s-a verificat bine și unde probabil există o problemă).
Monitorizăm expirarea tuturor domeniilor noastre. Toate serverele noastre de mail care trimit mesaje — sunt de asemenea verificate în peste 50 de diverse liste negre. (Și uneori ajung acolo). Apropo, știați că serverele de mail google sunt de asemenea în listele negre? Pur și simplu pentru automonitorizare am adăugat mail-wr1-f54.google.com la serverele monitorizate, și este într-adevăr în lista neagră SORBS! (Aceasta este o întrebare despre valoarea „antispam-urilor”)
Backup-urile — mai sus am scris cât de ușor este să le urmărești cu okerr. Dar noi urmărim și backup-urile recente de pe serverul nostru, și (cu ajutorul unei utilitare separate, care folosește okerr) — backup-urile pe care le urcăm pe Amazon Glacier. Și, da — din când în când apar probleme. Nu ne-am urmărit degeaba.
Folosim un indicator de escaladare. Acesta arată dacă o problemă nu a fost rezolvată de mult timp. Și eu, atunci când rezolv anumite probleme, câteodată pot să uit de ele. Escaladarea este un bun memento, chiar dacă ai grijă de tine.
În general, cred că calitatea muncii noastre s-a îmbunătățit semnificativ. Timpul de nefuncționare este aproape inexistent (sau, cel puțin, clientul nu apucă să-l observe. Doar tsss!), iar volumul de muncă s-a redus și condițiile de lucru sunt mai liniștite. Am trecut de la muncă în viteză, reparând găuri cu bandă adezivă, la o muncă calmă și măsurată, unde multe probleme sunt anticipate din timp și avem timp să le prevenim. Chiar și problemele care deja s-au întâmplat sunt acum mai ușor de corectat: pe de o parte, aflăm despre ele înainte ca clienții să facă panică, pe de altă parte, adesea problema este legată de o muncă recentă (când lucram la una, am stricat alta) — așa că este mai ușor să ne ocupăm de ea pe moment.
A fost și un alt caz…
Știați că în popularul Debian 9 (Stretch) un pachet atât de popular ca phpmyadmin este încă (deja de câteva luni!) în statutul de vulnerabil? (). Când a apărut vulnerabilitatea — am acoperit rapid, prin diferite metode. Dar am setat în okerr monitorizarea paginii security-tracker-ului, pentru a ști când va ieși o soluție 'frumoasă' (prin suma SHA1 a conținutului). De câteva ori indicatorul m-a alertat, pagina s-a schimbat, dar, după cum vedeți — încă din ianuarie 2019! — nu este menționat că problema a fost rezolvată. Poate, de fapt, cineva știe ce problemă este, de ce un pachet atât de important a fost vulnerabil mai bine de un an?
O altă dată într-o situație similară: după o vulnerabilitate în SSH, a trebuit să actualizăm toate serverele. Și atunci când stabilești o sarcină – trebuie să controlezi execuția. (Subordonații au tendința de a nu înțelege corect, de a uita, de a se confunda, de a face greșeli). Așadar, mai întâi am adăugat în okerr o verificare a versiunii SSH pe toate serverele, și prin intermediul okerr am monitorizat pentru a ne asigura că actualizările au fost aplicate pe toate serverele. (Convenabil! Am ales acest tip de indicator și imediat poți vedea pe care server se află ce versiune). Când ne-am asigurat că sarcina a fost finalizată pe toate serverele – am șters indicatorii.
De câteva ori a fost situația în care o anumită problemă apare, iar apoi dispare de la sine. (probabil că este familiar pentru toată lumea?). Până observi, până verifici – și acolo nu mai ai ce verifica – totul funcționează deja bine. Dar apoi se strică din nou. La noi a fost, de exemplu, cu produsele pe care le-am încărcat pe Amazon Marketplace (MWS). La un moment dat, inventarul încărcat era incorect (nu erau aceleași cantități de produse și nu aceleași prețuri). Am reușit să ne dăm seama. Dar pentru a înțelege – era important să aflăm despre problemă imediat. Din păcate, MWS, ca și toate serviciile Amazon, este un pic lent, așa că întotdeauna era o întârziere, dar totuși – am reușit măcar să captezi în mare legătura între problemă și scripturile care o cauzează (am făcut o verificare, am lipit-o la okerr și am verificat imediat la primirea alertelor).
Recentemente, am adăugat un caz interesant în cazul nostru, un provider de hosting european mare și scump, utilizat de clientul nostru. Dintr-o dată, TOATE serverele noastre au dispărut de pe radar! La început, clientul și-a dat seama "pe cont propriu" (mai repede decât Okerr!) că site-ul cu care lucra nu se deschide și a deschis un tichet pentru asta. Dar, de fapt, nu era un singur site, ci toate! (Natasha, am căzut toți!). Aici, Okerr a început să trimită mesaje lungi cu toate indicatorii care s-au aprins. Panic panică, alergăm în cerc (ce altceva să facem?). Apoi, totul a fost restabilit. Se pare că în centrul de date erau lucrări programate (o dată la mulți ani) și, desigur, trebuiau să ne anunțe. Dar s-a întâmplat o problemă la ei și nu ne-au anunțat. Ei bine, infarct mai mult, infarct mai puțin. Dar după ce totul a fost restabilit - trebuie să verifici totul! Nu îmi imaginez cum aș fi făcut asta manual. Okerr a testat totul în câteva minute. S-a dovedit că cea mai mare parte a serverelor au fost temporar indisponibile, dar funcționau. Unele - s-au supraîncărcat, dar și-au revenit corect. Din toate pierderile - am pierdut două backup-uri care, conform cronului, ar fi trebuit să fie create și încărcate în acel moment, în timp ce era acest haos complet. Nici măcar nu le-am creat, pur și simplu după o zi au venit alertele că totul este OK, backup-urile au apărut. Îmi place foarte mult acest exemplu, deoarece Okerr s-a dovedit a fi foarte util într-o situație la care nu ne-am gândit anterior, dar exact asta este sarcina monitorizării - a face față imprevizibilului.
Pentru senzorii Okerr folosim cele mai ieftine servicii de hosting (unde calitatea și fiabilitatea nu contează, se asigură unul pe altul). Așadar, recent am găsit un hosting foarte eficient și super ieftin, benchmark-urile sunt excelente. Dar... uneori se dovedește că conexiunile ieșite de la VPS se efectuează de pe o altă (vecină) adresă IP. Minuni. Modulul client_ip cu primește o adresă IP greșită. De asemenea, din jurnalele serverului indicatorului se poate observa că actualizarea a venit tot de pe această adresă IP vecină. Ne ocupăm acum cu suportul tehnic. E bine că am observat asta într-un timp liniștit. Dar, de exemplu, adesea se întâmplă ca accesul să fie specificat într-o listă albă de IP-uri - și dacă serverul va clipi uneori pentru scurt timp astfel - este foarte greu să identifici această problemă.
Și încă ceva — acum că am vorbit despre găzduirea VPS — întotdeauna folosim opțiuni ieftine (hetzner, ovh, scaleway). Din punct de vedere al benchmark-urilor și al stabilității — ne plac foarte mult. Folosim și Amazon EC2, care este mult mai scump, pentru alte proiecte. Așadar, datorită okerr avem o opinie fundamentată. Căderea — atât ei, cât și ceilalți. Nu aș spune că, pe parcursul observațiilor noastre, găzduirile ieftine precum hetzner s-au dovedit a fi semnificativ mai puțin stabile decât EC2. De aceea, dacă nu sunteți atașați de alte funcționalități ale Amazon — de ce să plătiți mai mult? 🙂
Ce urmează?
Dacă în această etapă nu v-am speriat deja prea tare de Okerr — atunci încercați! Puteți accesa direct prin acest link (Faceți clic acum!). Dar țineți cont că demo-ul este unul pentru toți, așa că, dacă faceți ceva — altcineva în același cont ar putea să vă deranjeze în același timp. Sau (mai bine) înregistrați-vă prin linkul de pe — totul este simplu, fără SMS. Dacă nu doriți să folosiți adresa dvs. reală de email — puteți folosi una temporară, gen mailinator (Vă recomand ). Astfel de conturi pot fi șterse în timp — dar sunt suficiente pentru teste.
După înregistrare, vi se va propune să urmați un antrenament (să finalizați câteva sarcini de învățare nu foarte complexe). Limitele inițiale sunt foarte mici, dar pentru antrenament sau un singur server sunt suficiente. După finalizarea antrenamentului — limitele (de exemplu, numărul maxim de indicatori) vor fi ridicate.
Din documentație — în primul rând pentru partea server și pentru client (). Dar dacă ceva nu este clar — scrieți la support (at) okerr.com sau lăsați un tichet — ne vom strădui să rezolvăm rapid totul.
Dacă doriți să folosiți serios și aceste limite crescute nu sunt suficiente — de asemenea, scrieți la suport, le vom crește (gratuit).
Doriți să instalați serverul okerr pe serverul dvs.? Iată . Vă recomandăm să instalați pe o mașină virtuală curată, atunci va fi ușor să faceți acest lucru cu scriptul de instalare. Pe mașina dvs. virtuală — nu există restricții :-). Și din nou — dacă este ceva — ne vom strădui mereu să ajutăm.
Dorim ca acest proiect să decoleze, pentru ca lumea să devină mai sigură datorită nouă. Datorită software-ului și serviciilor gratuite, lumea a devenit mai prietenoasă și se dezvoltă mai dinamic. Codul sursă poate fi stocat în GitHub gratuit, iar pentru email se poate folosi Gmail gratuit. Noi folosim gratuit pentru suport. Nu este nevoie să plătiți pentru servere, nu trebuie să descărcați și să configurați sau să rezolvați diverse probleme operaționale. Fiecare nou proiect, fiecare echipă – imediat are atât email, cât și repo-uri și CRM. Și toate acestea sunt de foarte bună calitate, gratuite și disponibile instantaneu. Vrem ca monitorizarea să fie la fel – companiile mici și proiectele să poată folosi gratuit Okerr și chiar în etapa de început și creștere să aibă aceeași fiabilitate ca proiectele mari și serioase.
Sursa: habr.com
