

În raport, Andrei Borodin va explica cum au luat în considerare experiența scalării PgBouncer în proiectarea connection pooler-ului , cum l-au implementat în producție. De asemenea, vom discuta despre ce funcții ale connection pooler-ului ne-ar plăcea să vedem în versiunile noi: este important pentru noi să nu ne satisfacem doar nevoile, ci să dezvoltăm comunitatea utilizatorilor .
Video:
Salut tuturor! Mă numesc Andrei.
La Yandex, mă ocup cu dezvoltarea bazelor de date open source. Și astăzi avem un subiect despre connection pooler.
Dacă știți cum se numește connection pooler în română, vă rog să-mi spuneți. Vreau foarte mult să găsesc un termen tehnic bun care să se consolideze în literatura de specialitate.
Tema este destul de complexă, deoarece în multe baze de date connection pooler-ul este încorporat și nu trebuie să-l cunoști. Sigur, există unele setări peste tot, dar în Postgres nu funcționează așa. Și în paralel (la HighLoad++ 2019) are loc raportul lui Nikolai Samohvalov despre configurarea interogărilor în Postgres. Și din câte înțeleg, aici au venit oamenii care au configurat interogările perfect, iar aceștia se confruntă cu probleme sistemice mai rare legate de rețea, utilizarea resurselor. Și pe alocuri a fost destul de complicat pentru că problemele nu sunt evidente.
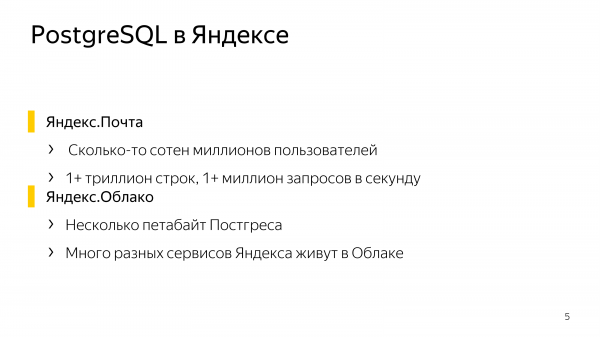
La Yandex există Postgres. În Yandex.Cloud trăiesc multe servicii ale Yandex. Și avem câteva petabytes de date, care generează nu mai puțin de un milion de interogări pe secundă în Postgres.
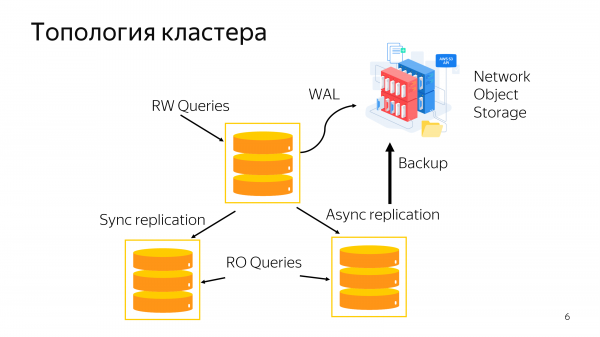
Și oferim un cluster destul de standard pentru toate serviciile – aceasta este nodul principal, cu două replici obișnuite (una sincronă și una asincronă), backup, scalarea interogărilor de citire pe replică.
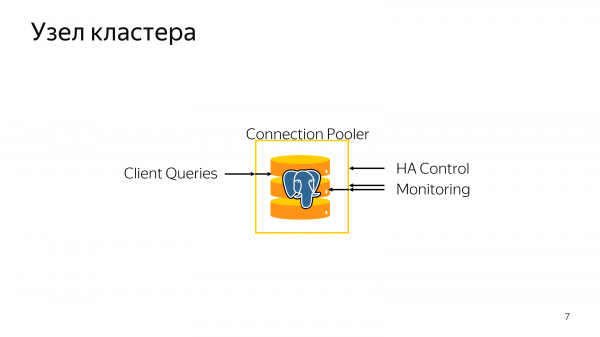
Fiecare nod al cluster-ului este un Postgres, pe care, pe lângă Postgres și sistemele de monitorizare, este instalat și connection pooler. Connection pooler-ul este folosit pentru fencing și pentru scopul său principal.
Care este scopul principal al connection pooler-ului?
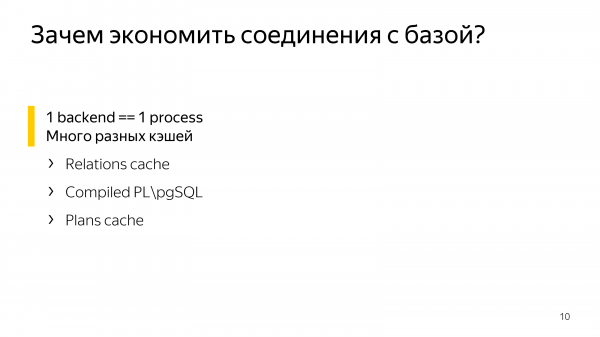
În Postgres, este adoptat un model de proces în lucru cu baza de date. Aceasta înseamnă că o conexiune – este un singur proces, un singur backend Postgres. Și în acest backend există multe tipuri diferite de cache-uri, pe care este costisitor să le faci diferite pentru diverse conexiuni.
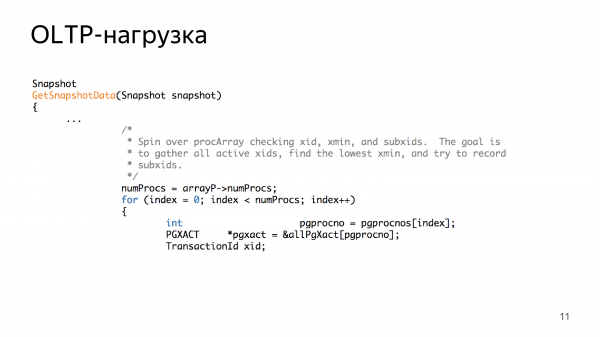
În plus, în codul Postgres există un array numit procArray. Acesta conține date esențiale despre conexiunile de rețea. Aproape toate algoritmii de procesare a procArray-ului au complexitate liniară, parcurgând întregul array al conexiunilor de rețea. Este un ciclu destul de rapid, dar cu un număr mare de conexiuni de rețea în intrare, totul devine puțin mai costisitor. Și, când totul devine puțin mai scump, se poate ajunge la o preț foarte mare pentru un număr mare de conexiuni.
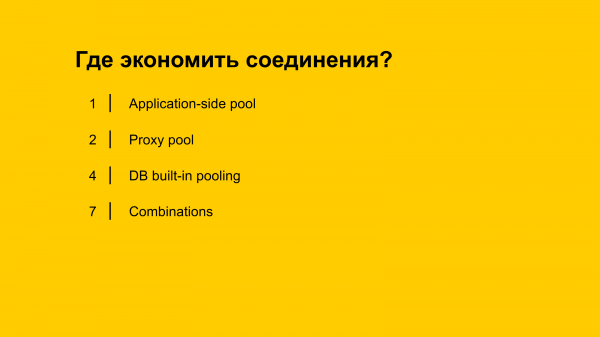
Există 3 abordări posibile:
- Pe partea aplicației.
- Pe partea bazei de date.
- Și între ele, adică toate combinațiile posibile.
Din păcate, pooler-ul încorporat este în prezent în dezvoltare. Prietenii de la PostgreSQL Professional se ocupă în principal de acest lucru. Când va apărea, este greu de prezis. Și, de fapt, alegerea arhitectului nostru are la dispoziție două soluții. Este pool-ul pe partea aplicației și pool-ul proxy.
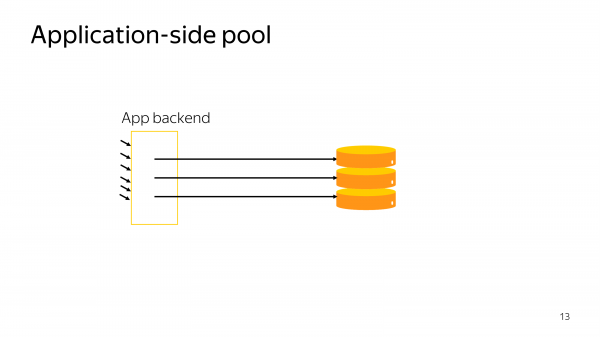
Pool-ul pe partea aplicației este cea mai simplă opțiune. Aproape toate driverele client oferă o modalitate de a reprezenta milioanele de conexiuni din cod drept câteva zeci de conexiuni în baza de date.
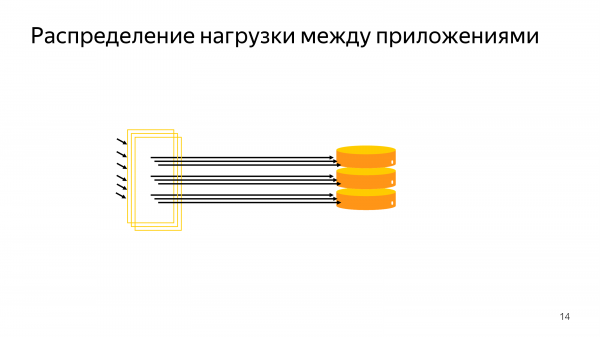
Problema apare atunci când, la un moment dat, vrei să scalaze backend-ul, vrei să-l desfășori pe mai multe mașini virtuale.
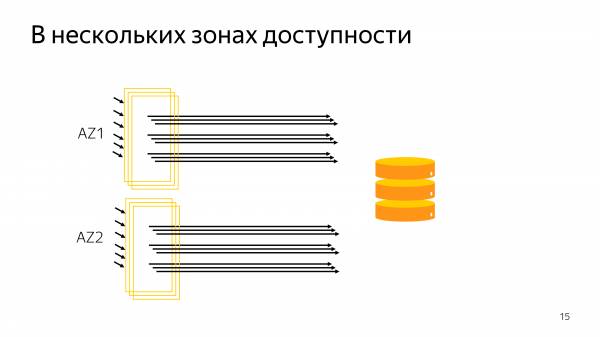
Apoi îți dai seama că mai ai câteva zone de disponibilitate, câteva centre de date. Iar abordarea cu pool-ul pe partea clientului duce la numere mari. Mari - adică aproximativ 10.000 de conexiuni. Acesta este capătul la care poate funcționa normal.
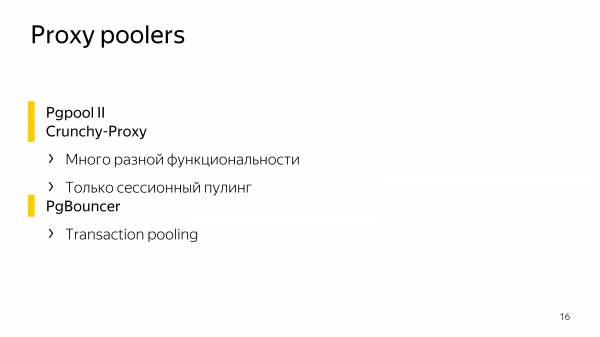
În ceea ce privește proxy poolers, există două poolers care fac multe lucruri. Acestea nu sunt doar poolers. Sunt poolers + o funcționalitate excelentă. Acestea sunt și .
Dar, din păcate, această funcționalitate suplimentară nu este necesară pentru toți. Și duce la faptul că poolers suportă doar pooling de sesiune, deci un client de intrare, un client de ieșire în baza de date.
Pentru nevoile noastre, aceasta nu se potrivește foarte bine, așa că folosim PgBouncer, care implementează pooling de tranzacții, adică conexiunile serverului se potrivesc conexiunilor client doar pe durata tranzacției.
Și sub sarcina noastră - este adevărat. Dar există câteva probleme.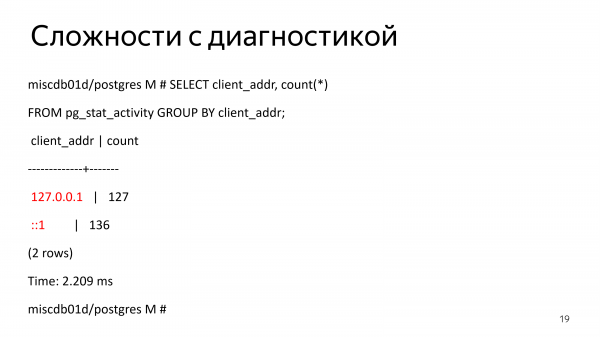
Problemele apar atunci când vrei să diagnostichezi o sesiune, pentru că toate conexiunile de intrare sunt locale. Toate provin din loopback și cumva devine dificil să urmărești sesiunea.
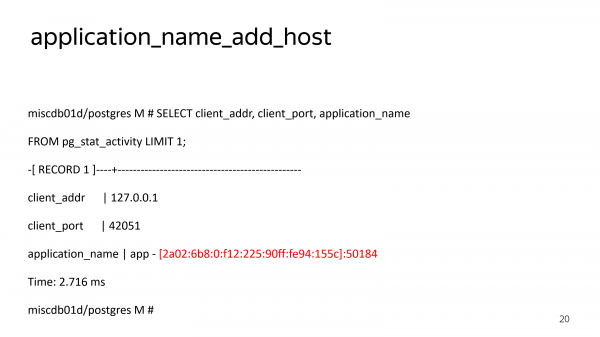
Desigur, puteți utiliza application_name_add_host. Aceasta este metoda de pe partea Bouncer pentru a adăuga o adresă IP în application_name. Dar application_name este setat printr-o conexiune suplimentară.
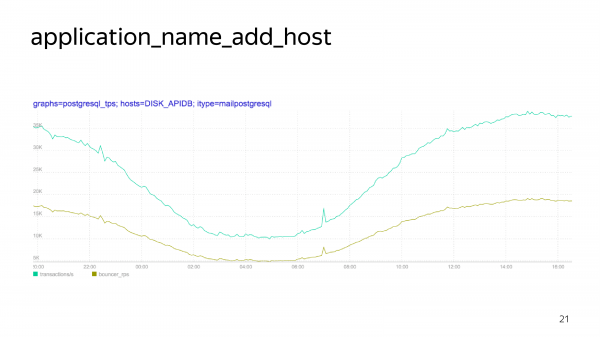
Pe acest grafic, linia galbenă reprezintă cererile reale, iar linia albastră reprezintă cererile care ajung în baza de date. Iar această diferență este exact setarea application_name, care este necesară doar pentru urmărire, dar care nu este deloc gratuită.
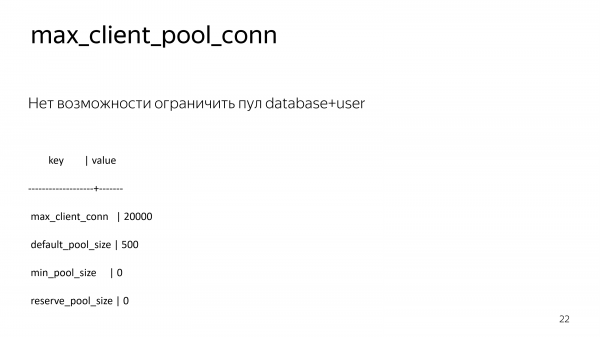
În plus, în Bouncer nu se poate limita un pool, adică numărul de conexiuni la baza de date pentru un anumit utilizator, pentru o anumită bază.
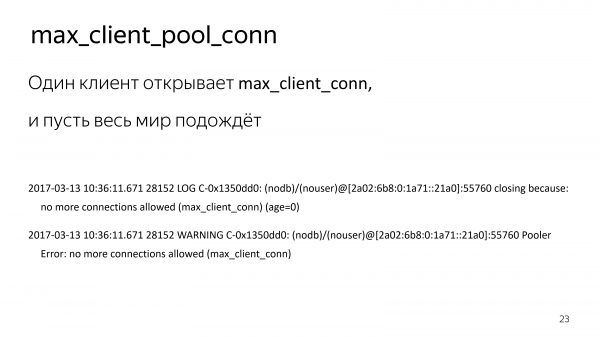
La ce duce asta? Aveți un serviciu suprasolicitat, scris în C++, și undeva în apropiere un serviciu mic pe Node, care nu face nimic grav cu baza, dar driverul său se duce de cap. Deschide 20.000 de conexiuni, iar tot restul așteaptă. Chiar aveți un cod normal.
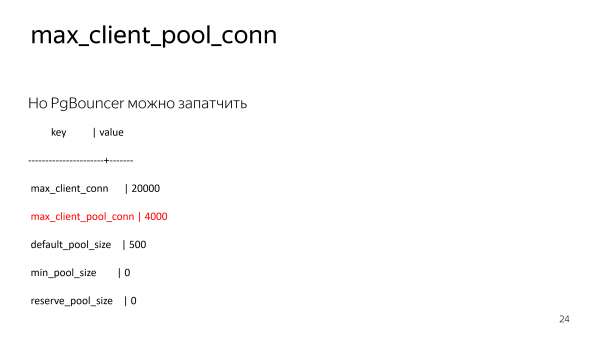
Am scris, desigur, un mic patch pentru Bouncer, care a adăugat această setare, adică limitarea clienților la pool.
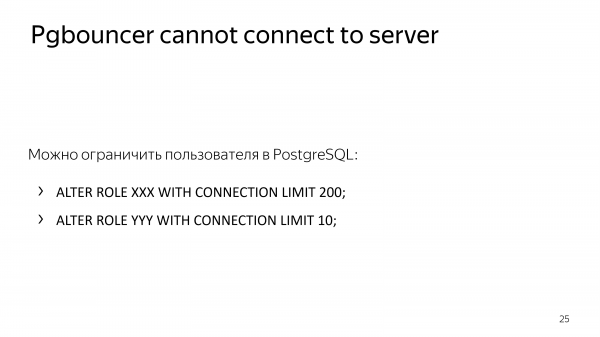
Ar fi putut fi făcut pe partea Postgres, adică rolurile în baza de date limitate în funcție de numărul de conexiuni.
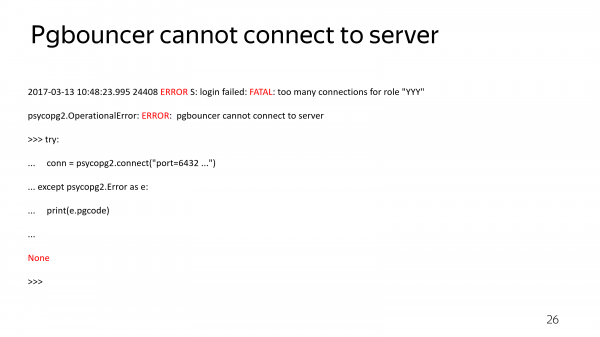
Dar atunci pierdeți capacitatea de a înțelege de ce nu aveți conexiuni cu serverul. PgBouncer nu transmite eroarea de conexiune, el returnează întotdeauna aceeași informație. Și nu puteți înțelege: poate că v-ați schimbat parola, poate că baza a căzut, poate că ceva nu este în regulă. Dar nu există nicio diagnoză. Dacă nu se poate stabili sesiunea, nu veți ști de ce nu se poate face.
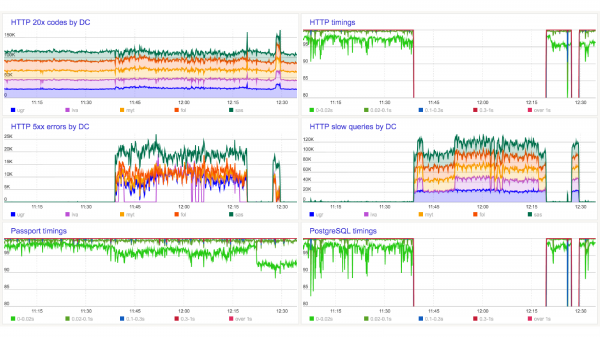
La un moment dat, vă uitați la graficele aplicației și vedeți că aplicația nu funcționează.
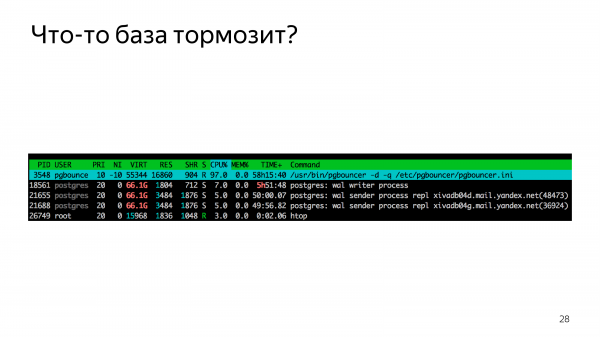
Vedeți în top și observați că Bouncer este uniprodus. Acesta este un moment de cotitură în viața serviciului. Înțelegeți că v-ați pregătit pentru scalarea bazei de date în decurs de un an și jumătate, dar trebuie să scalați pooler-ul.
Am ajuns la concluzia că avem nevoie de mai mulți PgBouncer.
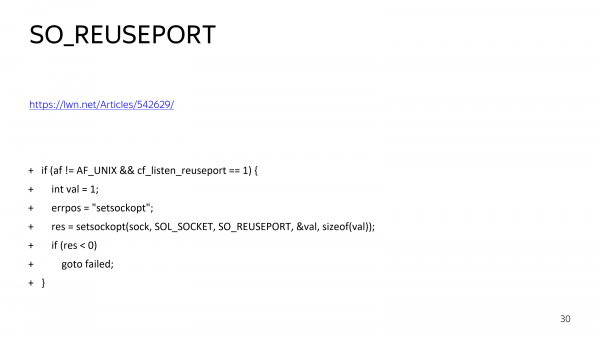
Puțin am patch-uit Bouncer.
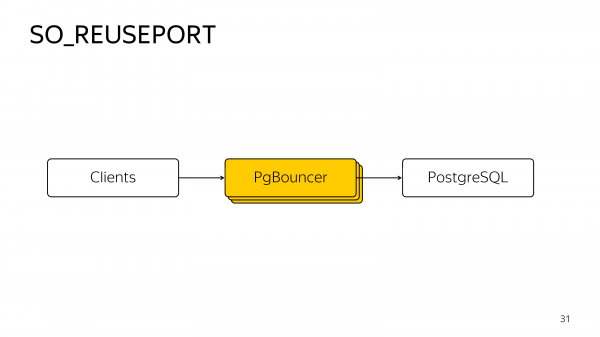
Și am făcut astfel încât să poată fi ridicate mai multe Bouncers cu reutilizarea portului TCP. Iar sistemul de operare redistribuie automat conexiunile TCP de intrare între ele într-un mod round-robin.
Aceasta este transparent pentru clienți, adică totul arată ca și cum ați avea un singur Bouncer, dar aveți o fragmentare a conexiunilor idle între Bouncers-urile în funcțiune.
Și, la un moment dat, s-ar putea să observați că acești 3 Bouncers își consumă fiecare nucleul 100%. Aveți nevoie de o mulțime de Bouncers. De ce?
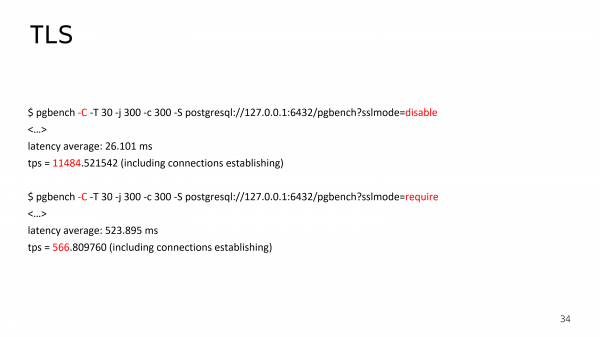
Pentru că aveți TLS. Aveți o conexiune criptată. Și dacă testați Postgres cu TLS și fără TLS, veți observa că numărul de conexiuni stabilite scade cu aproape două ordine de mărime odată cu activarea criptării, deoarece handshake-ul TLS consumă resursele CPU-ului.
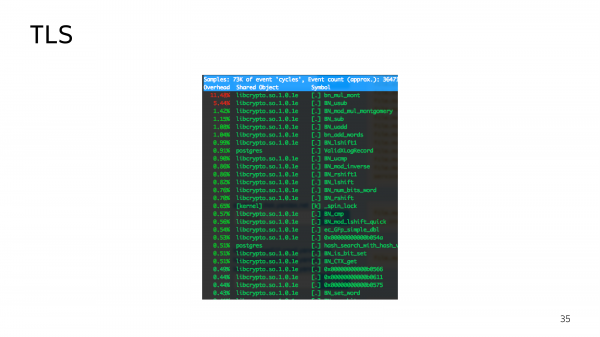
Și în vârf puteți observa o mulțime de funcții criptografice care sunt executate în timpul valului de conexiuni în incoming. Deoarece primary-ul nostru poate comuta între zone de disponibilitate, valul de conexiuni în incoming este o situație destul de tipică. Adică, dintr-un motiv oarecare, vechiul primary a fost inaccesibil, întreaga încărcătură a fost trimisă către un alt centru de date. Toate acestea vor veni simultan să se salute cu TLS.
Și un număr mare de handshake-uri TLS poate să nu se salute deja cu Bouncer, ci să-l strângă de gât. Din cauza timeout-ului, valul de conexiuni în incoming poate deveni persistent. Dacă aveți retry în bază fără exponential backoff, ele nu vor veni din nou și din nou ca un val coerent.
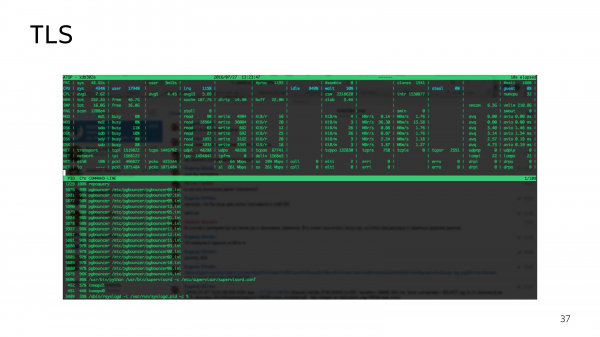
Iată un exemplu de 16 PgBouncer, care încarcă 16 nuclee la 100%.
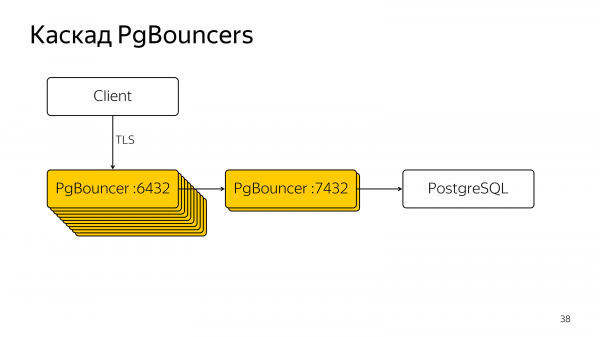
Am ajuns la PgBouncer în cascadă. Aceasta este cea mai bună configurație pe care o putem obține pe sarcina noastră cu Bouncer. Bouncers externe ne servesc pentru handshake-ul TCP, iar Bouncers interne servesc pentru pooling-ul real, astfel încât să nu fragmentăm prea mult conexiunile externe.
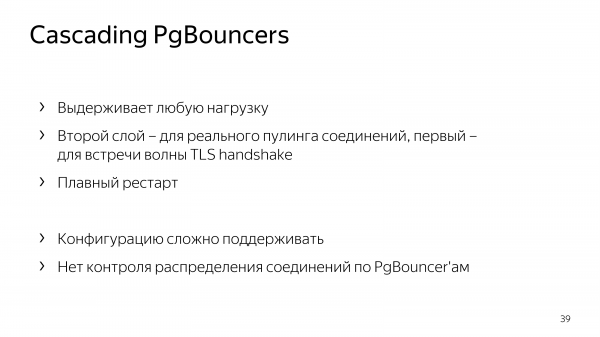
În această configurație, un restart lin este posibil. Puteți reporni toate aceste 18 Bouncers unul câte unul. Dar menținerea unei astfel de configurații este destul de complicată. Administratorii de sistem, DevOps și persoanele care sunt cu adevărat responsabile pentru acest server nu vor fi foarte încântați de această schemă.
S-ar părea că putem promova toate dezvoltările noastre în open source, dar Bouncer nu este bine suportat. De exemplu, posibilitatea de a rula mai multe PgBouncers pe același port a fost angajată acum o lună. Iar pull request-ul pentru această funcție a fost făcut acum câțiva ani.
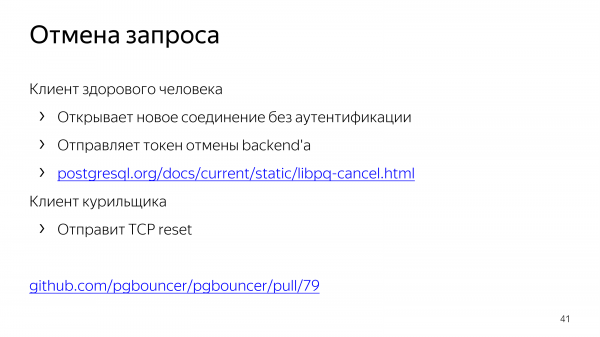
Sau un alt exemplu. În Postgres, puteți anula o interogare în curs de execuție trimițând un secret printr-o altă conexiune fără autentificare suplimentară. Dar unii clienți trimit pur și simplu un TCP-reset, adică rup conexiunea de rețea. Ce va face Bouncer în această situație? Nu va face nimic. Va continua să execute interogarea. Dacă ați primit un număr imens de conexiuni, care prin cereri mici au suprasolicitat baza, atunci doar ruperea conexiunii cu Bouncer nu va fi suficientă; va trebui, de asemenea, să închideți acele interogări care sunt active în bază.
Aceasta a fost corectată, dar această problemă încă nu a fost fuzionată în upstream-ul Bouncer-ului.
Și astfel am ajuns la concluzia că avem nevoie de propriul nostru connection pooler, care va evolua, va fi corectat, în care putem rezolva rapid problemele și care, desigur, trebuie să fie multithread.
Am stabilit multithreading-ul ca o sarcină principală. Trebuie să suportăm bine valul de conexiuni TLS în curs de incoming.
Pentru aceasta, a trebuit să dezvoltăm o bibliotecă separată numită Machinarium, care este destinată descrierii stărilor mașinilor unei conexiuni de rețea ca pe un cod secvențial. Dacă vă uitați în codul sursă libpq, veți vedea apeluri destul de complicate care pot să vă returneze un rezultat și să vă spună: „Sunați-mă puțin mai târziu. Acum am IO, dar, când IO se va termina, voi avea încărcare pentru procesor.” Și aceasta este o schemă multi-nivel. Interacțiunea de rețea este de obicei descrisă printr-o mașină de stări. O mulțime de reguli de tip „Dacă am primit anterior un header de pachet de dimensiune N, atunci acum aștept N octeți”, „Dacă am trimis un pachet SYNC, atunci acum aștept un pachet cu metadatele rezultatului”. Rezultatul este un cod destul de dificil și contraintuitiv, ca și cum un labirint ar fi fost transformat în desfășurare liniară. Am făcut în așa fel încât, în loc de o mașină de stări, programatorul să descrie drumul principal de interacțiune sub formă de cod imperativ obișnuit. Pur și simplu, în acest cod imperativ trebuie să inserați locuri unde secvența de execuție trebuie să fie întreruptă așteptând date de la rețea, transferând contextul de execuție unei alte corutine (fire verzi). Această abordare este similară cu faptul că înregistrăm cel mai așteptat drum în labirint în ordine, iar apoi adăugăm la el ramificații.
În cele din urmă, avem un flux care face TCP accept și transmite prin round-robin mai multor lucrători conexiunile TPC.
În plus, fiecare conexiune a clientului lucrează întotdeauna pe un singur procesor. Acest lucru permite o utilizare prietenoasă a cache-ului.
De asemenea, am îmbunătățit puțin colectarea pachetelor mici într-un singur pachet pentru a descărca stiva TCP a sistemului.
În plus, am îmbunătățit pooling-ul tranzacțiilor, astfel încât Odyssey, în configurația sa, poate trimite CANCEL și ROLLBACK în cazul pierderii conexiunii de rețea, adică dacă nimeni nu așteaptă cererea, Odyssey va spune bazei să nu încerce să execute o cerere care ar putea consuma resurse prețioase.
De asemenea, încercăm să menținem conexiunile pentru același client. Aceasta permite evitarea reinstalării application_name_add_host. Dacă este posibil, nu avem o reinstalare suplimentară a parametrilor necesari pentru diagnosticare.
Acționăm în interesul Yandex.Cloud. Dacă utilizați PostgreSQL gestionat și aveți un connection pooler configurat, puteți crea replicare logică externă, adică puteți părăsi sistemul nostru dacă doriți, folosind replicarea logică. Bouncer nu va transmite fluxul de replicare logică extern.
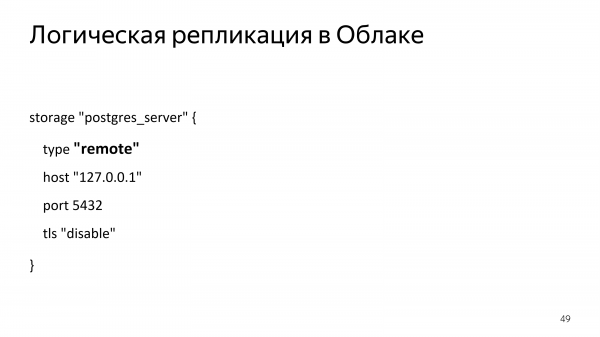
Acesta este un exemplu de configurare a replicării logice.
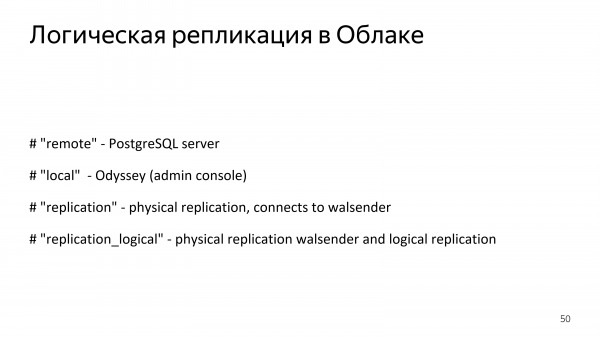
De asemenea, avem suport pentru replicarea fizică extern. În Cloud, acest lucru nu este posibil, deoarece clusterele ar oferi prea multe informații despre ele însele. Dar în instalațiile voastre, dacă aveți nevoie de replicare fizică prin connection pooler în Odyssey, acest lucru este posibil.
Odyssey are o monitorizare complet compatibilă cu PgBouncer. Avem aceeași consolă, care execută aproape toate aceleași comenzi. Dacă lipsește ceva, trimiteți un pull request sau, măcar, o problemă pe GitHub, și vom adăuga comenzile necesare. Dar funcționalitatea de bază a consolei PgBouncer este deja disponibilă.
Și, bineînțeles, avem redirecționarea erorilor. Vom returna eroarea raportată de bază. Veți primi informații despre motivul pentru care nu vă conectați la bază, nu doar că nu reușiți.
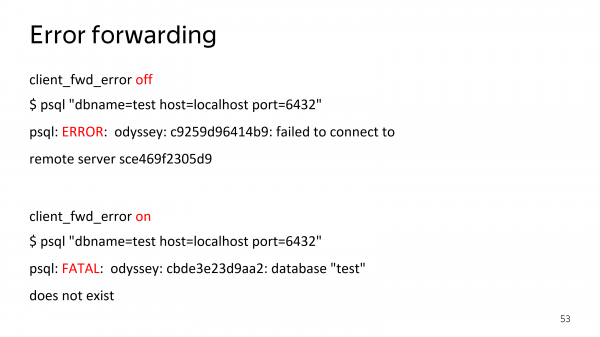
Această opțiune poate fi dezactivată în cazul în care doriți o compatibilitate 100% cu PgBouncer. Ne putem comporta la fel ca Bouncer, doar ca precauție.
Dezvoltare
Câteva cuvinte despre codul sursă Odyssey.
De exemplu, există comenzi de tipul „Pauză /Reluare”. Acestea sunt folosite de obicei pentru a actualiza baza de date. Dacă trebuie să actualizați Postgres, îl puteți pune pe pauză în connection pooler, să faceți pg_upgrade, după care să reluați. Iar din partea clientului, va părea că baza a încetinit pur și simplu. Această funcționalitate ne-a fost adusă de oamenii din comunitate. Deocamdată nu a fost îmbinată, dar în curând totul va fi. (Deja îmbinată)
— deja îmbinată
În plus, una dintre noile funcții din PgBouncer este suportul pentru autentificarea SCRAM, pe care ne-a adus-o de asemenea o persoană care nu lucrează la Yandex.Cloud. Ambele – sunt funcționalități complexe și importante.
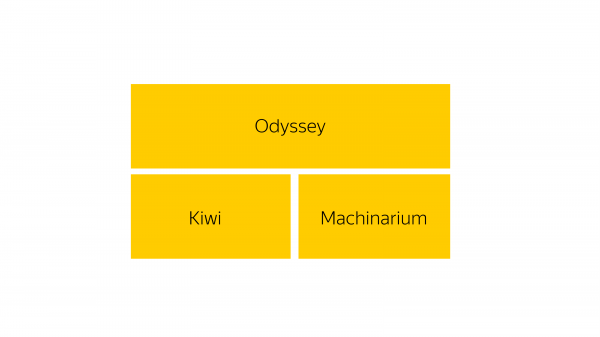
Prin urmare, vreau să vă povestesc din ce este realizat Odyssey, poate că și voi vreți să scrieți un pic de cod.
Aveți baza de cod Odyssey, care se bazează pe două biblioteci principale. Biblioteca Kiwi – este o implementare a protocolului de mesaje Postgres. Adică, proto 3 nativ la Postgres – sunt mesajele standard cu care frontend-urile și backend-urile pot schimba informații. Acestea sunt implementate în biblioteca Kiwi.
Biblioteca Machinarium – este o bibliotecă pentru implementarea firelor de execuție. Un mic fragment din acest Machinarium este scris în assembler. Dar, nu vă speriați, sunt doar 15 linii.
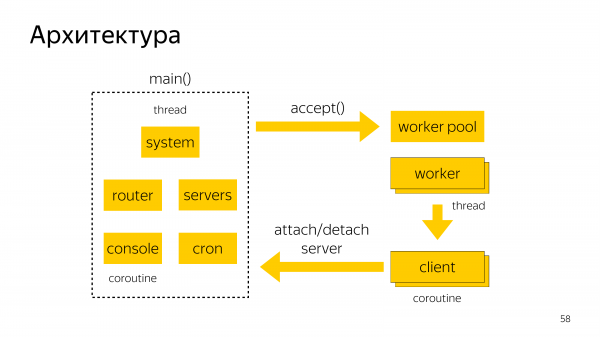
Arhitectura Odyssey. Există o mașină principală în care sunt rulate coroutines. În această mașină se realizează acceptarea conexiunilor TCP în așteptare și distribuirea acestora între workers.
În interiorul unui worker poate funcționa un handler pentru mai mulți clienți. De asemenea, în firul principal rulează consola și gestionarea sarcinilor crone pentru eliminarea conexiunilor care nu mai sunt necesare în pool.
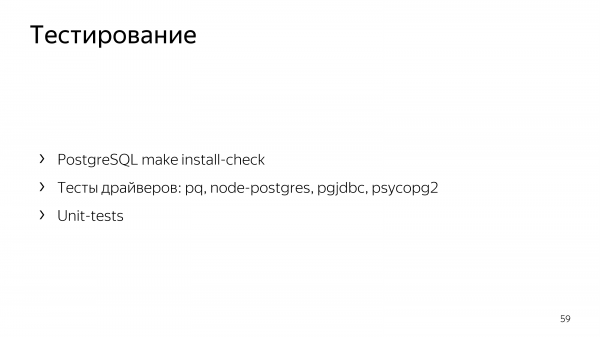
Pentru testarea Odyssey se utilizează setul standard de teste Postgres. Pur și simplu rulăm install-check prin Bouncer și prin Odyssey, obținem un div nul. Există câteva teste legate de formatarea datelor care nu trec deloc la fel în Bouncer și în Odyssey.
În plus, există numeroase drivere care au propriile teste de verificare. Iar aceste teste le folosim pentru testarea Odyssey.
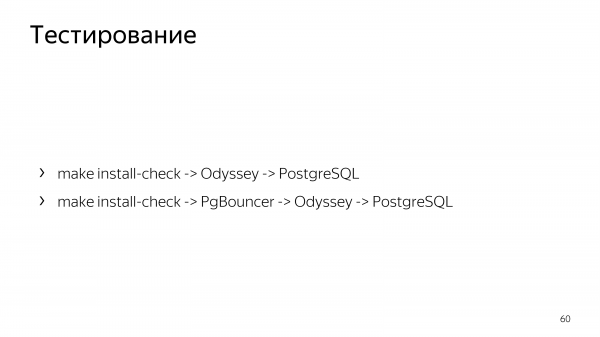
De asemenea, din cauza configurației noastre în cascadă, trebuie să testăm diferite combinații: Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey pentru a ne asigura că, dacă Odyssey se află într-o anumită parte a cascadei, funcționează în continuare așa cum ne așteptăm.
Greble
Folosim Odyssey în producție. Și ar fi fost nedrept să spun că totul funcționează simplu. Nu, adică da, dar nu întotdeauna. De exemplu, în producție totul a funcționat perfect, apoi au venit prietenii noștri de la PostgreSQL Professional și ne-au spus că avem o scurgere de memorie. Au avut dreptate, am rezolvat-o. Dar a fost pur și simplu.
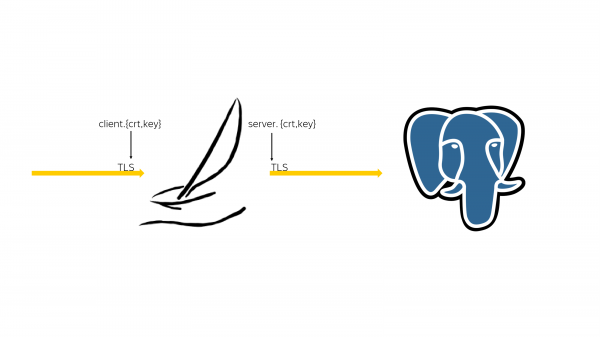
Apoi am descoperit că în connection pooler există conexiuni TLS de intrare și conexiuni TLS de ieșire. Și pentru conexiuni sunt necesare certificate client și certificate server.
Certificatele serverului Bouncer și Odyssey își citesc pcache-ul, dar certificatele client nu trebuie citite din pcache, deoarece Odyssey-ul nostru scalabil se lovește în cele din urmă de performanța de citire a acestui certificat. A fost o surpriză pentru noi, deoarece s-a împotmolit nu de la bun început. La început s-a scalat liniar, iar după 20.000 de conexiuni simultane de intrare, această problemă s-a manifestat.
Metoda de autentificare pluggable este capacitatea de a ne autentifica prin mijloacele încorporate în Linux. În PgBouncer este implementată astfel încât există un fir de execuție separat pentru a aștepta un răspuns de la PAM și un fir principal PgBouncer care se ocupă de conexiunea curentă și poate cere acestora să stea în firul PAM.
Nu am implementat acest lucru dintr-un simplu motiv. Avem multe fire. De ce ne-ar mai trebui asta?
În cele din urmă, acest lucru poate provoca probleme, deoarece, dacă aveți autentificare PAM și ne-PAM, o mare onduire de autentificare PAM poate întârzia semnificativ autentificarea ne-PAM. Aceasta este una dintre acele probleme pe care nu le-am rezolvat. Dar dacă doriți să rezolvați asta, puteți ocupați-vă de această problemă.
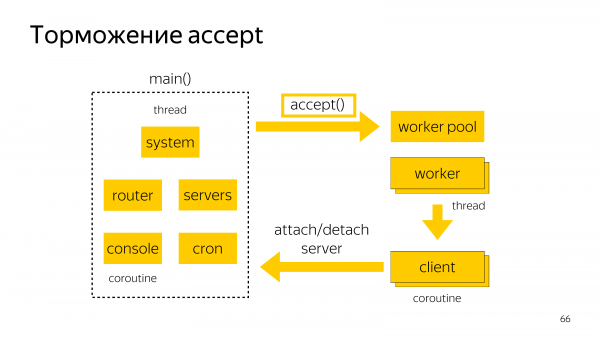
O altă capcană a fost că avem un fir care acceptă toate conexiunile de intrare. Și apoi le transmite la grupul de lucrători, unde va avea loc handshake-ul TLS.
În cele din urmă, dacă aveți o undă coerentă de 20.000 de conexiuni de rețea, toate vor fi acceptate. Și de partea clientului, libpq va începe să numere timpii de așteptare. În mod implicit, se pare că acolo sunt 3 secunde.
Dacă nu pot intra simultan în baza de date, atunci nu pot intra, deoarece totul poate fi acoperit printr-un retry non-exponențial.
Am ajuns la concluzia că am copiat aici schema de la PgBouncer cu ceea ce avem, respectiv throttling-ul numărului de conexiuni TCP pe care le acceptăm.
Dacă observăm că acceptăm conexiuni, dar acestea nu reușesc să finalizeze handshake-ul, le punem în așteptare pentru a nu consuma resursele procesorului central. Acest lucru duce la faptul că handshake-ul simultan poate să nu se realizeze pentru toate conexiunile primite. Dar măcar cineva va accesa baza de date, chiar dacă încărcarea este destul de mare.
Planul de acțiune
Ce ne dorim să vedem în viitorul Odyssey? Ce suntem pregătiți să dezvoltăm noi și ce așteptăm de la comunitate?
În august 2019.
Așa arăta planul de acțiune Odyssey în august:
- Am dori autentificarea SCRAM și PAM.
- Am dori să redirecționăm cererile de citire către standby.
- Ne-ar plăcea un restart online.
- Și posibilitatea de a face o pauză pe server.
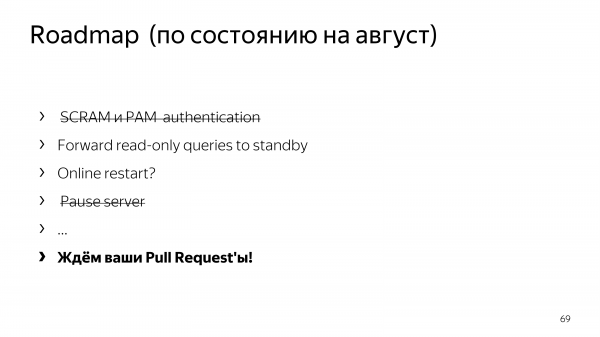
Jumătate din acest plan de acțiune a fost realizat, și nu de noi. Și asta e bine. Așa că haideți să discutăm despre ce a mai rămas și să adăugăm și altele.
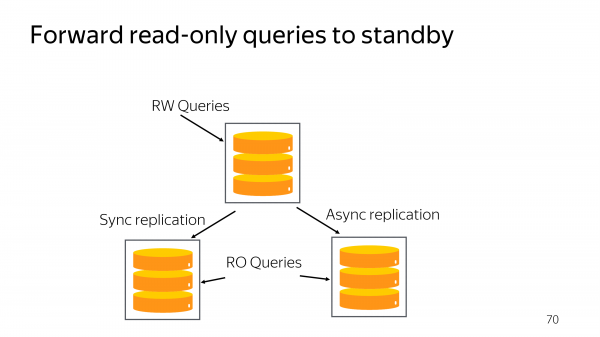
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
În principiu, în Postgres, începând cu versiunea 10, există posibilitatea de a specifica session_attrs la conectare. Puteți enumera toate gazdele bazei de date în conexiune și puteți spune de ce mergeți la baza de date: pentru a scrie sau doar pentru a citi. Iar driverul va alege singur prima gazdă din listă care îi place mai mult și care îndeplinește cerințele session_attrs.
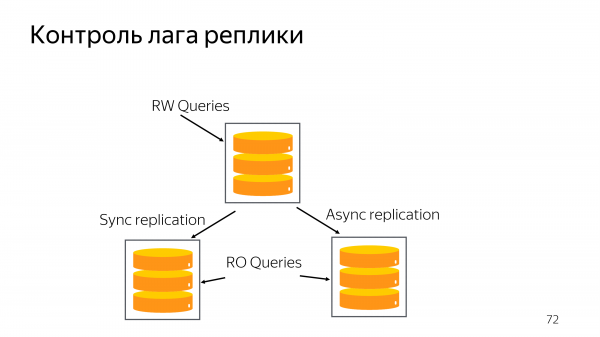
Dar problema acestei abordări este că nu controlează întârzierea replicării. Poate exista o replică care este întârziată cu un timp inacceptabil pentru serviciul dumneavoastră. Pentru a realiza o execuție completă a cererilor de citire pe replică, în esență, trebuie să sprijinim în Odyssey capacitatea de a nu lucra atunci când citirea nu este permisă.
Odyssey ar trebui să solicite din când în când baza de date și să întrebe despre distanța de replicare de la primar. Și dacă aceasta a atins un anumit prag, să blocheze noile cereri către bază, să informeze clientul că trebuie să reinițializeze conexiunile și, posibil, să aleagă o altă gazdă pentru a executa cererile. Aceasta va permite bazei să recupereze mai repede întârzierea replicării și să revină pentru a răspunde cererilor.
Este dificil de stabilit termenele de realizare, deoarece este open source. Dar, sper că nu va dura 2,5 ani ca la colegii noștri de la PgBouncer. Această funcție ne-ar plăcea să o vedem în Odyssey.
. Acum puteți crea un prepared statement în două moduri. În primul rând, puteți executa comanda SQL, și anume „prepared”. Pentru a înțelege această comandă SQL, trebuie să învățăm să înțelegem SQL din partea Bouncer. Ar fi o exagerare, deoarece avem nevoie de un parser complet. Nu putem analiza fiecare comandă SQL.
Dar există un prepared statement la nivelul protocolului de mesaje pe proto3. Și acesta este momentul în care informația că se creează un prepared statement ajunge într-o formă structurată. Am putea susține înțelegerea că pe o anumită conexiune de server, clientul a solicitat să se creeze prepared statements. Chiar dacă tranzacția s-a încheiat, trebuie să menținem în continuare coerența între server și client.
Dar aici apare o discrepanță în dialog, deoarece cineva spune că trebuie să înțelegem ce anume prepared statements a creat clientul și să separăm conexiunea serverului între toți clienții care au creat această conexiune de server, adică care au creat un astfel de prepared statement.
Andres Freund a spus că, dacă a venit un client la voi care a creat deja un astfel de prepared statement în altă conexiune de server, atunci să-l creați pentru el. Dar, se pare, că este puțin greșit să efectuezi interogări în baza de date în locul clientului, dar din perspectiva dezvoltatorului care scrie protocolul de interacțiune cu baza, ar fi convenabil să i se ofere pur și simplu o conexiune de rețea în care există o astfel de interogare pregătită.
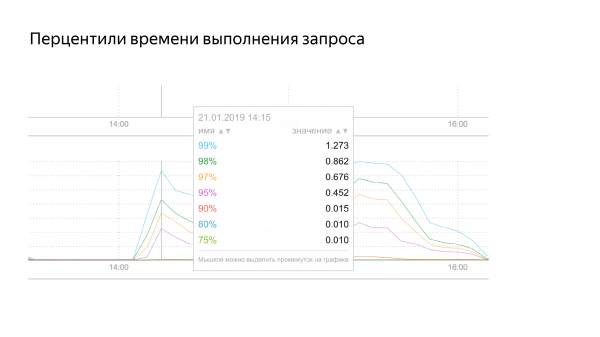
Și încă o caracteristică pe care trebuie să o implementăm. Acum avem monitorizare compatibilă cu PgBouncer. Putem returna timpul mediu de execuție a interogării. Dar timpul mediu este ca o temperatură medie în spital: cineva este rece, cineva cald – în medie, toți sunt sănătoși. Aceasta nu este adevărul.
Trebuie să implementăm suport pentru percentiles care ar indica existența unor interogări lente ce consumă resurse și ar face monitorizarea mai acceptabilă.
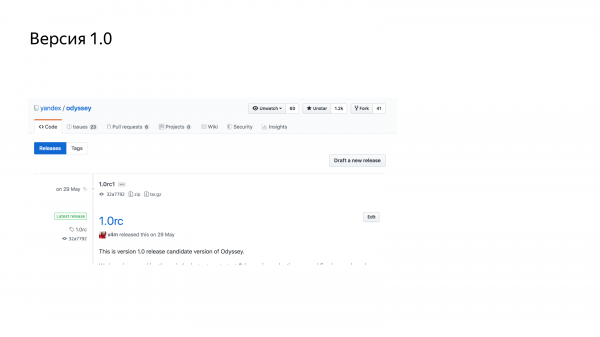
Cel mai important – se dorește versiunea 1.0 (Versiunea 1.1 a fost deja lansată). Problema este că Odyssey se află acum în versiunea 1.0rc, adică release candidate. Și toate problemele pe care le-am enumerat au fost remediate exact cu acea versiune, cu excepția scurgerii de memorie.
Ce va însemna pentru noi versiunea 1.0? Lansăm Odyssey pe baza noastră. Deja funcționează pe serverele noastre, dar când va atinge 1.000.000 de cereri pe secundă, putem spune că aceasta este versiunea de lansare, versiunea pe care o putem numi 1.0.
În comunitate, câțiva oameni au cerut ca versiunea 1.0 să aibă și o suspendare și SCRAM. Dar acest lucru va însemna că va trebui să lansăm deja o versiune următoare în producție, deoarece nici SCRAM, nici suspendarea nu sunt încă integrate. Totuși, este probabil ca această problemă să fie rezolvată destul de repede.
Aștept cererile dvs. de pull. De asemenea, aș dori să aud despre problemele pe care le aveți cu Bouncer. Hai să le discutăm. Poate că putem implementa unele funcții de care aveți nevoie.
Aici se încheie partea mea, aș dori să vă ascult. Mulțumesc!
Întrebări
Dacă îmi setez application_name, va fi gestionat corect, inclusiv în transaction pooling în Odyssey?
În Odyssey sau în Bouncer?
În Odyssey. În Bouncer este gestionat.
Vom face configurația.
Și dacă conexiunea mea reală va sări între alte conexiuni, va fi transmisă?
Vom face setul tuturor parametrilor enumerați în listă. Nu pot spune dacă application_name se află în acea listă. Mi se pare că l-am văzut acolo. Vom seta toți aceiași parametri. Cu o cerere acolo, setarea va face tot ceea ce a fost configurat de client la startup.
Mulțumesc, Andrei, pentru prezentare! O prezentare bună! Mă bucur că Odyssey evoluează din ce în ce mai repede cu fiecare minut. Vă doresc să continuați la fel. Ne-am adresat deja cu rugămintea de a avea o conexiune multi data-source, astfel încât Odyssey să se poată conecta simultan la diferite baze de date, adică master-slave, iar apoi, după failover, să se conecteze automat la noul master.
Da, parcă îmi amintesc această discuție. Acum există câteva stocări. Dar nu există comutări între ele. Trebuie să verificăm serverul de partea noastră, să ne asigurăm că este încă activ și să înțelegem că a avut loc un failover, cine va apela pg_recovery. Am o metodă standard de a înțelege că nu am ajuns pe master. Și trebuie să înțelegem cumva din erori sau cum? Adică, ideea este interesantă, se discută. Scrieți mai multe comentarii. Dacă aveți oameni care știu C, atunci este minunat.
Întrebarea privind scalarea replicilor ne interesează de asemenea, deoarece dorim să facem adoptarea clusterelor replicate cât mai simplă pentru dezvoltatorii de aplicații. Totuși, ne-ar plăcea să avem mai multe comentarii, adică cum anume să procedăm, cum să facem corect.
Întrebarea se referă și la replici. Se pare că aveți un master și mai multe replici. Este clar că la replici se fac mai puține conexiuni decât la master, deoarece acestea pot avea diferențe. Ați menționat că diferența în date poate fi atât de mare încât să nu corespundă afacerii dvs. și nu veți accesa acea replică până când nu va fi complet replicată. Totuși, dacă nu ați accesat-o de mult timp și apoi începeți să o faceți, datele de care aveți nevoie nu vor fi imediat disponibile. Adică, dacă accedem constant la master, acolo cache-ul este încărcat, în timp ce în replică cache-ul întârzie puțin.
Da, este adevărat. În pcache nu vor fi blocurile de date pe care le doriți, în real cache nu va exista informația despre tabelele pe care le doriți, iar în planuri nu vor fi interogările parsate, nu va exista nimic.
Și când aveți un cluster și adăugați o nouă replică, atunci în timp ce aceasta se pornește, în ea totul este prost, adică acumulează cache-ul.
Am înțeles ideea. Abordarea corectă ar fi să rulați un mic procent din interogări inițial pe replică, care să încălzească cache-ul. Practic, avem condiția că nu trebuie să rămânem în urmă cu mai mult de 10 secunde față de master. Și această condiție să fie activată nu dintr-o dată, ci treptat pentru câțiva clienți.
Da, să creștem greutatea.
Este o idee bună. Dar mai întâi trebuie să implementăm această dezactivare. Trebuie să ne oprim mai întâi și abia apoi să ne gândim cum să ne activăm. Este o funcționalitate excelentă pentru a ne activa treptat.
În nginx există această opțiune. slowly start în clusterul pentru server. Și el crește treptat sarcina.
Da, idee excelentă, vom încerca când vom ajunge la asta.
Sursa: habr.com
